
Agentisches Projektmanagement lässt sich leicht verkaufen – und ebenso leicht überverkaufen. Das Verkaufsargument schreibt sich fast von selbst: Arbeit wird an Agenten übergeben, mehrere laufen gleichzeitig, das Board aktualisiert sich von allein, und dein Team liefert mehr. Das meiste davon ist machbar. Die Teile, die nicht machbar sind, sind genau die, die niemand auf die Folie packt – und sie sind konkret genug, um sie einzuplanen.
Das hier ist die ehrliche Version. Was die Praxis tatsächlich bringt, was sie kostet und wo sie aufhört zu funktionieren, egal wie gut das Modell ist. Wer zuerst die Definition und den operativen Ablauf sucht: Unser Leitfaden zu AI-Agenten-Projektmanagement behandelt die Mechanik; dieser Artikel setzt voraus, dass du die Grundzüge kennst und gerade entscheidest, ob du dich darauf einlässt. Sharkly ist für genau diese Praxis gebaut – deshalb ist der Abschnitt zu den Grenzen weiter unten klar formuliert statt beschönigt.
TL;DR
Agentisches Projektmanagement bedeutet, KI-Agenten als verfolgte, zuweisbare Ausführende innerhalb eines echten Arbeitssystems zu betreiben statt als private Tools. Die Vorteile, die Bestand haben, sind paralleler Durchsatz, eine dauerhafte Spur dessen, was passiert ist, und die Umwandlung des Prompt-Könnens einer einzelnen Entwicklerin in eine gemeinsame Fähigkeit. Die Risiken sind ein Review-Engpass, Automatisierung mit größerer Tragweite als beabsichtigt und die Verwechslung eines abgeschlossenen Runs mit einem korrekten Ergebnis. Die Grenze ist das Urteilsvermögen: Richtung, Befugnis und Abnahme bleiben bei Menschen, und keine Automatisierung verschiebt diese Linie.
Die Vorteile, die Bestand haben
Durchsatz, den man tatsächlich sieht. Mehrere Aufgaben laufen gleichzeitig auf verbundenen Rechnern, jede in ihrem eigenen isolierten Verzeichnis, ohne dass Entwickler Terminal-Tabs beaufsichtigen müssen. Unser Leitfaden zu parallelen Agenten in isolierten Worktrees erklärt, warum die Isolation das ist, was die Parallelität sicher macht statt nur spannend.
Eine Spur, die den Run überlebt. Ausführungsprotokolle halten fest, warum ein Run in die Warteschlange kam, wann er begann und endete, welche Tool-Aufrufe erfolgten, woher der Auslöser stammte und was im Fehlerfall passierte. Sechs Wochen später beantwortet dieser Datensatz Fragen, die ein Chat-Transkript auf dem Laptop von irgendwem nicht beantworten kann.
Fähigkeiten, die eine Person überdauern. Ein Agent ist eine gespeicherte Konfiguration: Anweisungen, Runtime, Repositories, Umgebung, Run-Einstellungen und gebundene Skills. Wer herausgefunden hat, wie eine knifflige Migration läuft, hinterlässt etwas, das das Team zuweisen kann – keinen Absatz in Slack.
Status, der sich selbst meldet. Fortschritt, Blocker und Ergebnisse werden der Aufgabe zugeordnet, sobald sie anfallen. Das wiederkehrende Meeting, dessen einziger Zweck das Einsammeln von Status war, wird kürzer, und die Inbox trägt die Ausnahmen, die wirklich einen Menschen brauchen.
Die Risiken, die niemand auf die Folie packt
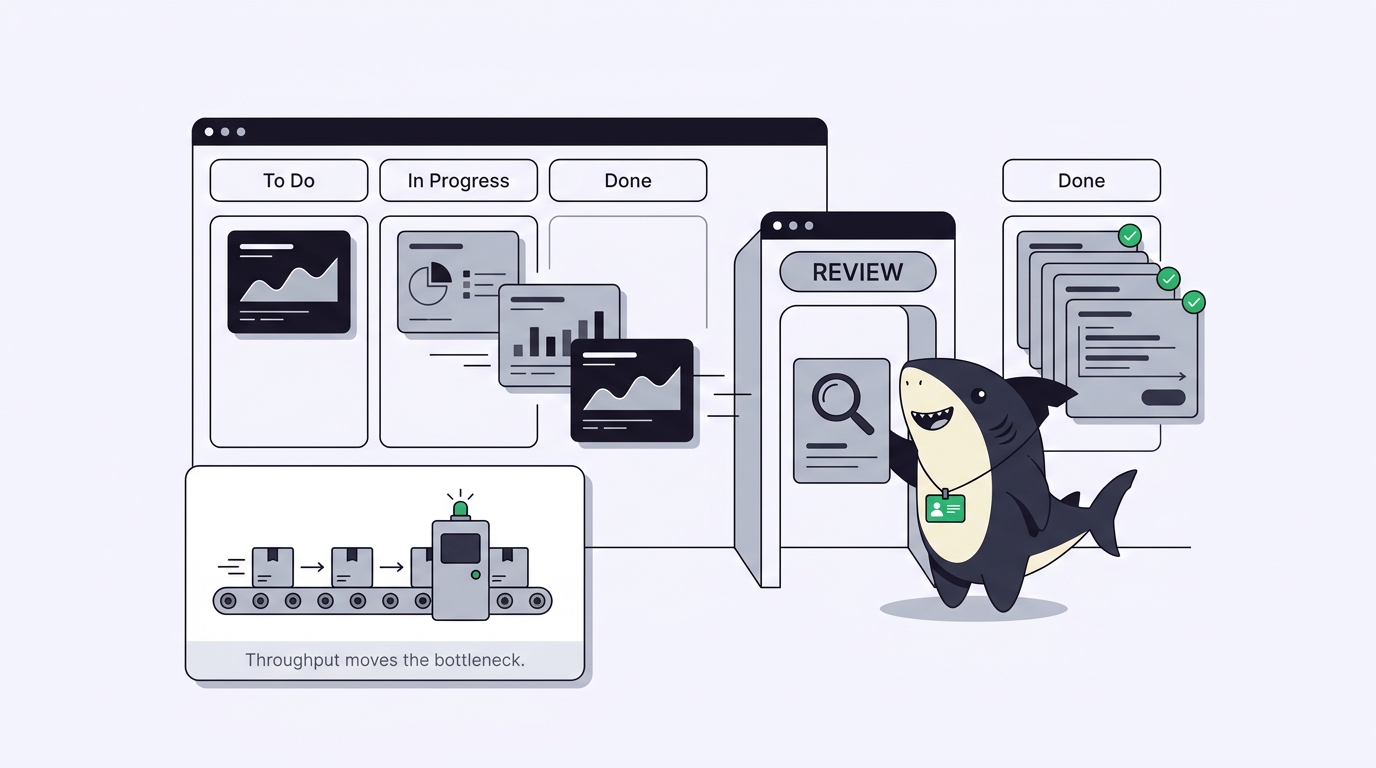
Review wird sofort zum Engpass. Agenten produzieren prüfbare Arbeit schneller, als Menschen sie lesen. Ein Team, das drei Agenten und keine zusätzliche Review-Kapazität hinzufügt, hat keinen Durchsatz gewonnen, sondern nur die Warteschlange verschoben. Miss, wie lange Ergebnisse im Zustand „wartet auf Review“ liegen, bevor du einen vierten Agenten dazunimmst.
Ein abgeschlossener Run ist kein korrektes Ergebnis. Das lohnt sich, aus der Produktdokumentation zu zitieren, denn es ist der Fehlermodus, der Teams am härtesten trifft: Ein Status „abgeschlossen“ beschreibt den Automatisierungs-Run, nicht das Versprechen, dass jedes nachgelagerte Geschäftsergebnis korrekt war. Irgendjemand muss trotzdem die verlinkte Aufgabe öffnen und die Belege lesen.
Automatisierung hat eine größere Tragweite als erwartet. Status- und Kommentar-Trigger können breiter greifen als der Bereich, in dem du sie eingerichtet hast – eine gängige Formulierung wie „bitte erneut versuchen“ oder ein häufig genutzter Status kann Runs starten, die du nicht beabsichtigt hast. Bevorzuge einen unverwechselbaren Slash-Befehl oder einen eng gefassten Status und schreibe Anweisungen, die die auslösende Aufgabe prüfen, bevor Änderungen vorgenommen werden.
Diagnoseschulden summieren sich. Fehlgeschlagene Runs liefern Herstellerfehler, die austauschbar aussehen, es aber nicht sind: Ein 429 kann bedeuten, dass Anfragen zu schnell eintreffen, oder dass das Kontingent erschöpft ist – und die Lösungen sind gegensätzlich. Ein 403 heißt meist, dass Modell, Organisation oder Region nicht zugelassen sind, und nicht, dass ein Schlüssel falsch getippt wurde. Teams, die jeden Fehler mit „einfach erneut versuchen“ behandeln, verlieren eine Woche damit, das herauszufinden.
Schriftlich fixierter Scope wird tragend. Ein Agent bekommt genau den Kontext, den du festgehalten hast. Vage Abnahmekriterien kosteten früher ein Gespräch; heute kosten sie einen Run, ein Review und eine Überarbeitung.
Wildwuchs bei Berechtigungen. Jeder Agent, der auf ein Repository, einen Rechner und eine Reihe von Zugangsdaten zugreifen kann, ist ein Pfad in deine Umgebung. Beschränke Agenten auf die Repositories und Computer, die ihre Arbeit erfordert, und halte Webhook-URLs und Signing Secrets aus der Versionsverwaltung und aus öffentlichen Kanälen heraus.
| Vorteil | Das passende Risiko | Die Kontrolle, die es ehrlich hält |
|---|---|---|
| Paralleler Durchsatz | Review-Warteschlange wächst unbemerkt | Gleichzeitig laufende Agentenarbeit pro Reviewer begrenzen |
| Selbstmeldender Status | Run-Status wird als Projektstatus gelesen | Lebenszyklus-Status und Run-Status getrennt halten |
| Automatisierung von Routinearbeit | Trigger greifen breiter als beabsichtigt | Unverwechselbare Formulierungen, eng gefasste Status, Prüfung in den Anweisungen |
| Dauerhafte Ausführungsspur | Niemand liest sie | Belege im Abnahmeschritt verlangen |
| Wiederverwendbare Agenten-Konfigurationen | Veraltete Anweisungen überleben ihre Verfasserin | Agentendefinitionen regelmäßig überprüfen |
Die Grenzen: wo die Praxis aufhört
Drei Grenzen sind struktureller Natur, nicht vorübergehend.
Verantwortung lässt sich nicht delegieren. Einem Agenten kann die Ausführung zugewiesen und Arbeit gutgeschrieben werden. Für ein Ergebnis geradestehen kann er nicht. Halte bei jeder Aufgabe eine namentlich benannte Person verantwortlich, in einem Feld getrennt von der ausführenden Zuweisung, sonst füllt sich dein Board mit Arbeit, nach der niemand gefragt werden kann.
Mehrdeutigkeit lässt sich nicht automatisieren. Arbeit, bei der man sich zwischen zwei vertretbaren Optionen entscheiden, eine Kundenbeziehung abwägen oder einen Sicherheitskompromiss eingehen muss, ist nicht langsam, weil ein Mensch sie erledigt. Sie ist eine Entscheidung, und sie an einen Agenten abzugeben verwandelt eine Entscheidung in eine Vermutung mit einer plausiblen Begründung.
Endzustände sind keine Rückgängig-Tasten. Eine Aufgabe auf „abgeschlossen“ zu setzen markiert sie als Endzustand, bricht aber keinen bereits aktiven Run ab; die Kategorien „abgebrochen“ und „Duplikat“ stoppen aktive Runs dagegen tatsächlich. Zu wissen, was dein Klick wirklich bewirkt, ist der Unterschied zwischen Arbeit stoppen und sie nur neu zu beschriften.
Wie das auf einem echten Board aussieht
Ein sechsköpfiges Team betreibt einen Space mit vier Agenten. Dependency-Bumps, Triage instabiler Tests und das Zusammenstellen des Changelogs werden standardmäßig Agenten zugewiesen. Feature-Arbeit wird Menschen zugewiesen, die manchmal, sobald das Design steht, einen klar abgegrenzten Ausschnitt an einen Agenten übergeben.
Zwei Regeln erledigen den Großteil der Arbeit. Jede Aufgabe, die ein Agent ausführt, benennt eine menschliche verantwortliche Person, die das Ergebnis abnimmt, und keine von einem Agenten ausgeführte Aufgabe wird abgeschlossen, ohne dass jemand das Ausführungsprotokoll zusammen mit dem Diff liest. Eine wöchentliche Automatisierung postet eine Zusammenfassung fehlgeschlagener Runs – das kommt einem Gesundheitscheck der eigenen Konfiguration am nächsten.
Die sichtbare Veränderung nach einem Monat ist nicht „mehr Code“. Sie besteht darin, dass die langweilige Routinearbeit aufgehört hat, mit der Feature-Arbeit um Aufmerksamkeit zu konkurrieren, und dass das Team beantworten kann, was ein Agent getan hat und wer es abgenommen hat, ohne jemanden fragen zu müssen.
Einführen, ohne die Risiken einzusammeln
Fang mit Arbeit an, die beobachtbar und umkehrbar ist, und prüfe mehrere Runs, bevor du den Scope erweiterst. Wähle eine wiederkehrende Art von Aufgabe, gib ihr ein schriftlich fixiertes Ergebnis und einen Review-Schritt und lass sie eine Woche lang mit zwei Personen laufen. Teste jeden Automatisierungs-Trigger einzeln und führe Automatisierungen manuell aus, bevor du dich auf einen Zeitplan verlässt.
Prüfe dann drei Zahlen, bevor du erweiterst: die Zeit vom Abschluss eines Runs bis zur menschlichen Entscheidung, den Anteil der Runs, die wegen eines zu dünnen Scopes überarbeitet werden mussten, und wie oft ein Fehler beim ersten Versuch korrekt diagnostiziert wurde. Diese drei sagen dir, ob die Praxis besser funktioniert, als es die Anekdoten vermuten lassen. Unser Walkthrough zu Claude Code Projektmanagement zeigt den Ablauf von Anfang bis Ende an einer einzelnen Aufgabe, und Sharkly liefert das fertig verpackt, wenn du es lieber nicht selbst zusammenbauen möchtest.
FAQ
Ist agentisches Projektmanagement einfach Automatisierung unter neuem Namen? Nein. Automatisierung führt vordefinierte Schritte aus. Agentisches Projektmanagement weist Ergebnisse an Ausführende zu, die ihre Schritte selbst festlegen – deshalb wiegen Review und Abnahme hier schwerer als in der klassischen Automatisierung.
Muss man dafür Jira oder Linear ersetzen? Nein. Import- und Sync-Optionen gibt es genau deshalb, damit der Tracker, den deine Organisation ohnehin nutzt, bleiben kann. Unser Artikel zu Jira-Alternativen für Mensch-Agent-Teams behandelt den Fall, in dem der Tracker tatsächlich zur Disposition steht.
Ab welcher Teamgröße lohnt es sich? Zwei Personen und zwei Agenten reichen, um den Unterschied zu spüren, denn das ist der erste Punkt, an dem jemand Arbeit prüft, die er nicht selbst angestoßen hat.
Was kostet der Betrieb? Die Modellnutzung läuft weiter über die Abonnements oder API-Schlüssel, die in euren Coding-Tools konfiguriert sind; das Kontingent hängt also von den Tools, Tarifen und Konten ab, die dein Team verbindet. Plane die Review-Zeit genauso ernst ein wie die Modellkosten.


