
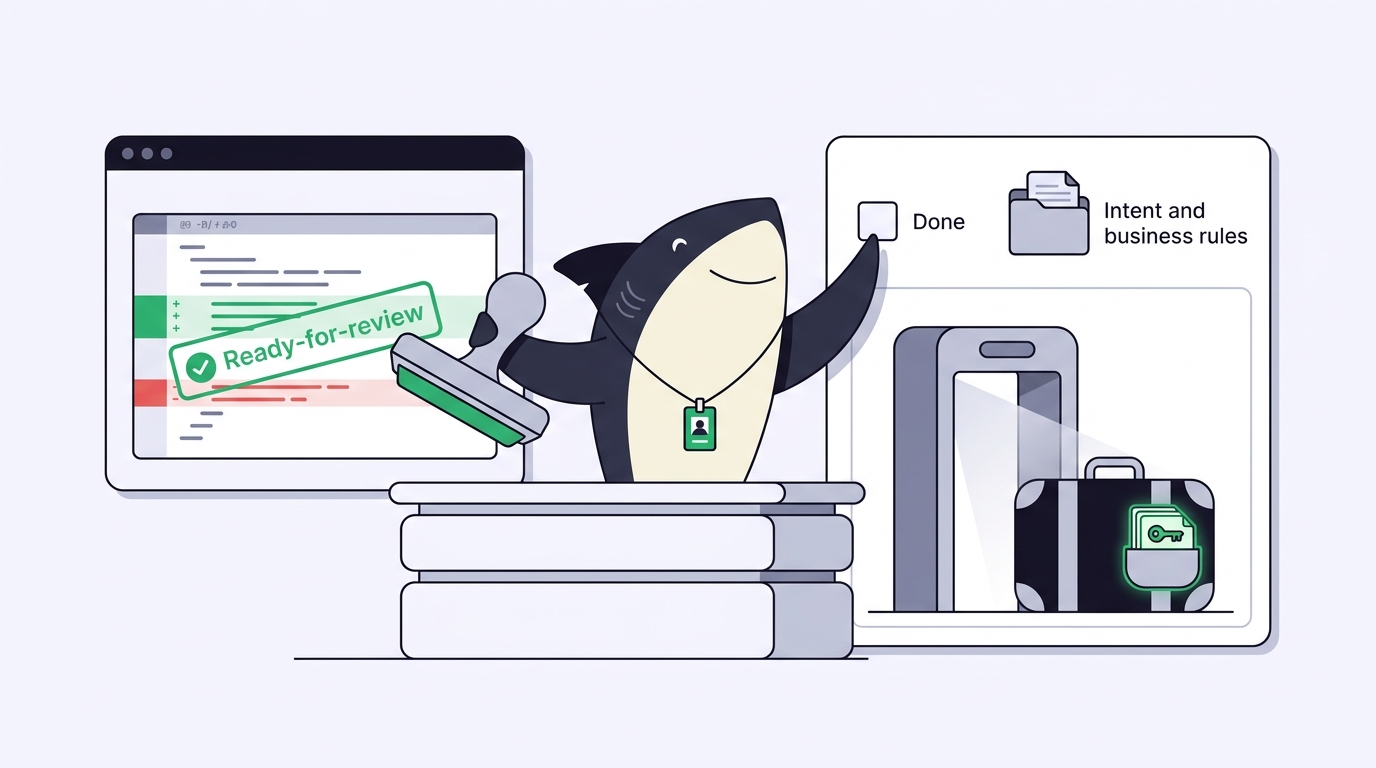
Sie haben einen KI-Code-Review-Agenten in Ihre Pipeline eingebunden, und er hat funktioniert. Er meldete eine fehlende Null-Prüfung, fand einen ungenutzten Import und hinterließ drei ordentliche Kommentare zur Benennung. Sie haben gemergt. Zwei Tage später stieß ein Kunde auf einen Bug, den der Agent schlicht überlesen hatte: Die Änderung war intern sauber und tat das Falsche. Der Review-Agent hatte den Code verifiziert. Die Absicht konnte er nicht verifizieren.
Genau diese Lücke ist die ganze Geschichte der KI-Code-Review-Agenten. Sie sind gut bei einer bestimmten, überprüfbaren Klasse von Problemen und blind für eine andere Klasse, die im Diff identisch aussieht. Halten Sie ihre Freigabe für eine Abnahme, liefern Sie die blinde Klasse aus. Wissen Sie, wo die Grenze verläuft, bekommen Sie einen schnellen ersten Durchlauf, der Ihre Reviewer für das Urteilsvermögen freimacht, das nur Menschen haben.
Dieser Artikel zeichnet diese Grenze nach: was ein KI-Code-Review-Agent verifizieren kann, was nicht, und das Betriebsmodell, das beides auseinanderhält. Sharkly ist die Ebene, die wir dabei durchgehen – der gemeinsame Arbeitsbereich, in dem Agenten-Review und menschliche Abnahme zwei verschiedene Status auf derselben Task sind und nicht ein einziger Stempel. Coding-Agenten haben Sie bereits; hier geht es darum, deren Output zu prüfen, ohne so zu tun, als würde ein zweiter Agent den Kreis schließen.
Was ein KI-Code-Review-Agent verifizieren kann
Ein KI-Code-Review-Agent ist ein Programm, das einen Diff liest, Prüfungen darauf anwendet und Befunde meldet, so wie ein menschlicher Reviewer Kommentare hinterlässt. Seine verlässliche Zone ist alles, was ein sorgfältiger Reviewer durch Lesen der Änderung und ihrer unmittelbaren Nachbarschaft bestätigen könnte:
- Mechanische Korrektheit: Syntax, Typen, offensichtliche Null- und Grenzwertbehandlung, unbehandelte Promise-Rejections, im Diff sichtbare Ressourcenlecks.
- Lokale Logik: Off-by-one-Fehler, invertierte Bedingungen, tote Zweige, eine Variable, die vor ihrer Zuweisung gelesen wird.
- Konventionen: Benennung, Formatierung, Import-Hygiene, ob neben einer neuen Funktion ein Test steht.
- Bekannte Anti-Patterns: SQL, das per String-Konkatenation zusammengebaut wird, im Klartext committete Secrets, eine öffentliche Methode ohne Eingabevalidierung.
All diese Punkte haben eines gemeinsam: Die Belege stecken im Diff. Der Agent muss Ihr Geschäft nicht kennen, um sie zu finden, und er findet sie schneller und konsistenter als ein müder Mensch um 18 Uhr. Das ist echter Mehrwert, und deshalb greifen Teams zu solchen Tools. Googles Code-Review-Leitfaden betrachtet diesen mechanischen Durchlauf als Grundvoraussetzung, damit menschliche Aufmerksamkeit auf das Design fallen kann. Ein KI-Reviewer ist ein geduldiger Weg, diesen Durchlauf jedes Mal zu schaffen.
Was er nicht verifizieren kann
Hier ist die Grenze, klar formuliert: Ein KI-Code-Review-Agent kann nicht verifizieren, dass die Änderung die richtige Änderung ist. Alles Folgende braucht Kontext, der im Diff nicht enthalten ist.
- Absicht versus Spezifikation. Der Code kann fehlerfrei sein und das falsche Problem lösen. Das entscheiden allein die Abnahmekriterien des Tickets, und die hat der Agent selten im Blick.
- Fachliche Korrektheit. Ob eine Rabattregel, eine Steuerberechnung oder eine Berechtigungsgrenze dazu passt, wie das Unternehmen arbeitet, ist eine Ermessensfrage, keine Lint-Regel.
- Systemübergreifendes Verhalten. Eine Änderung, die in einer Datei unauffällig aussieht, kann einen Aufrufer drei Services weiter brechen. Die OWASP Top Ten sind voll von Fehlern wie Broken Access Control, die erst zutage treten, wenn man den gesamten Request-Pfad nachverfolgt statt nur den Diff.
- Ob die Tests ehrlich sind. Ein Agent kann bestätigen, dass ein Test existiert und durchläuft. Er kann Ihnen nicht sagen, ob der Test das prüft, worauf es ankommt, oder ob der Agent, der den Code geschrieben hat, auch einen Test geschrieben hat, der genau darauf zugeschnitten ist, zu bestehen.
Der letzte Punkt ist die Falle, die speziell bei KI-geschriebenem Code lauert. Wenn dieselbe Art von System die Änderung und das Review erzeugt, können ein sauberer Diff und ein grüner Haken beide zutreffen und beide am Wesentlichen vorbeigehen. Eine Freigabe durch einen Review-Agenten ist also ein Signal, keine Entscheidung. Der Agent berichtet; ein Mensch nimmt ab.
Das Betriebsmodell, das die Lücke schließt
Die Lösung ist kein besserer Review-Agent. Es ist ein Betriebsmodell, in dem die Aufgabe des Review-Agenten und die des Menschen zwei verschiedene Zustände sind und keiner von beiden übersprungen wird.
Sharkly macht diese Zustände als Task-Status explizit. Eine Task durchläuft In Bearbeitung, Bereit zum Review und Erledigt. Die Regel ist einfach und tragend: Agenten verschieben Arbeit nach Bereit zum Review; Menschen verschieben sie nach Erledigt. Ein Agent – ob er den Code geschrieben oder reviewed hat – kann seine eigene Arbeit niemals als abgenommen markieren. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist.
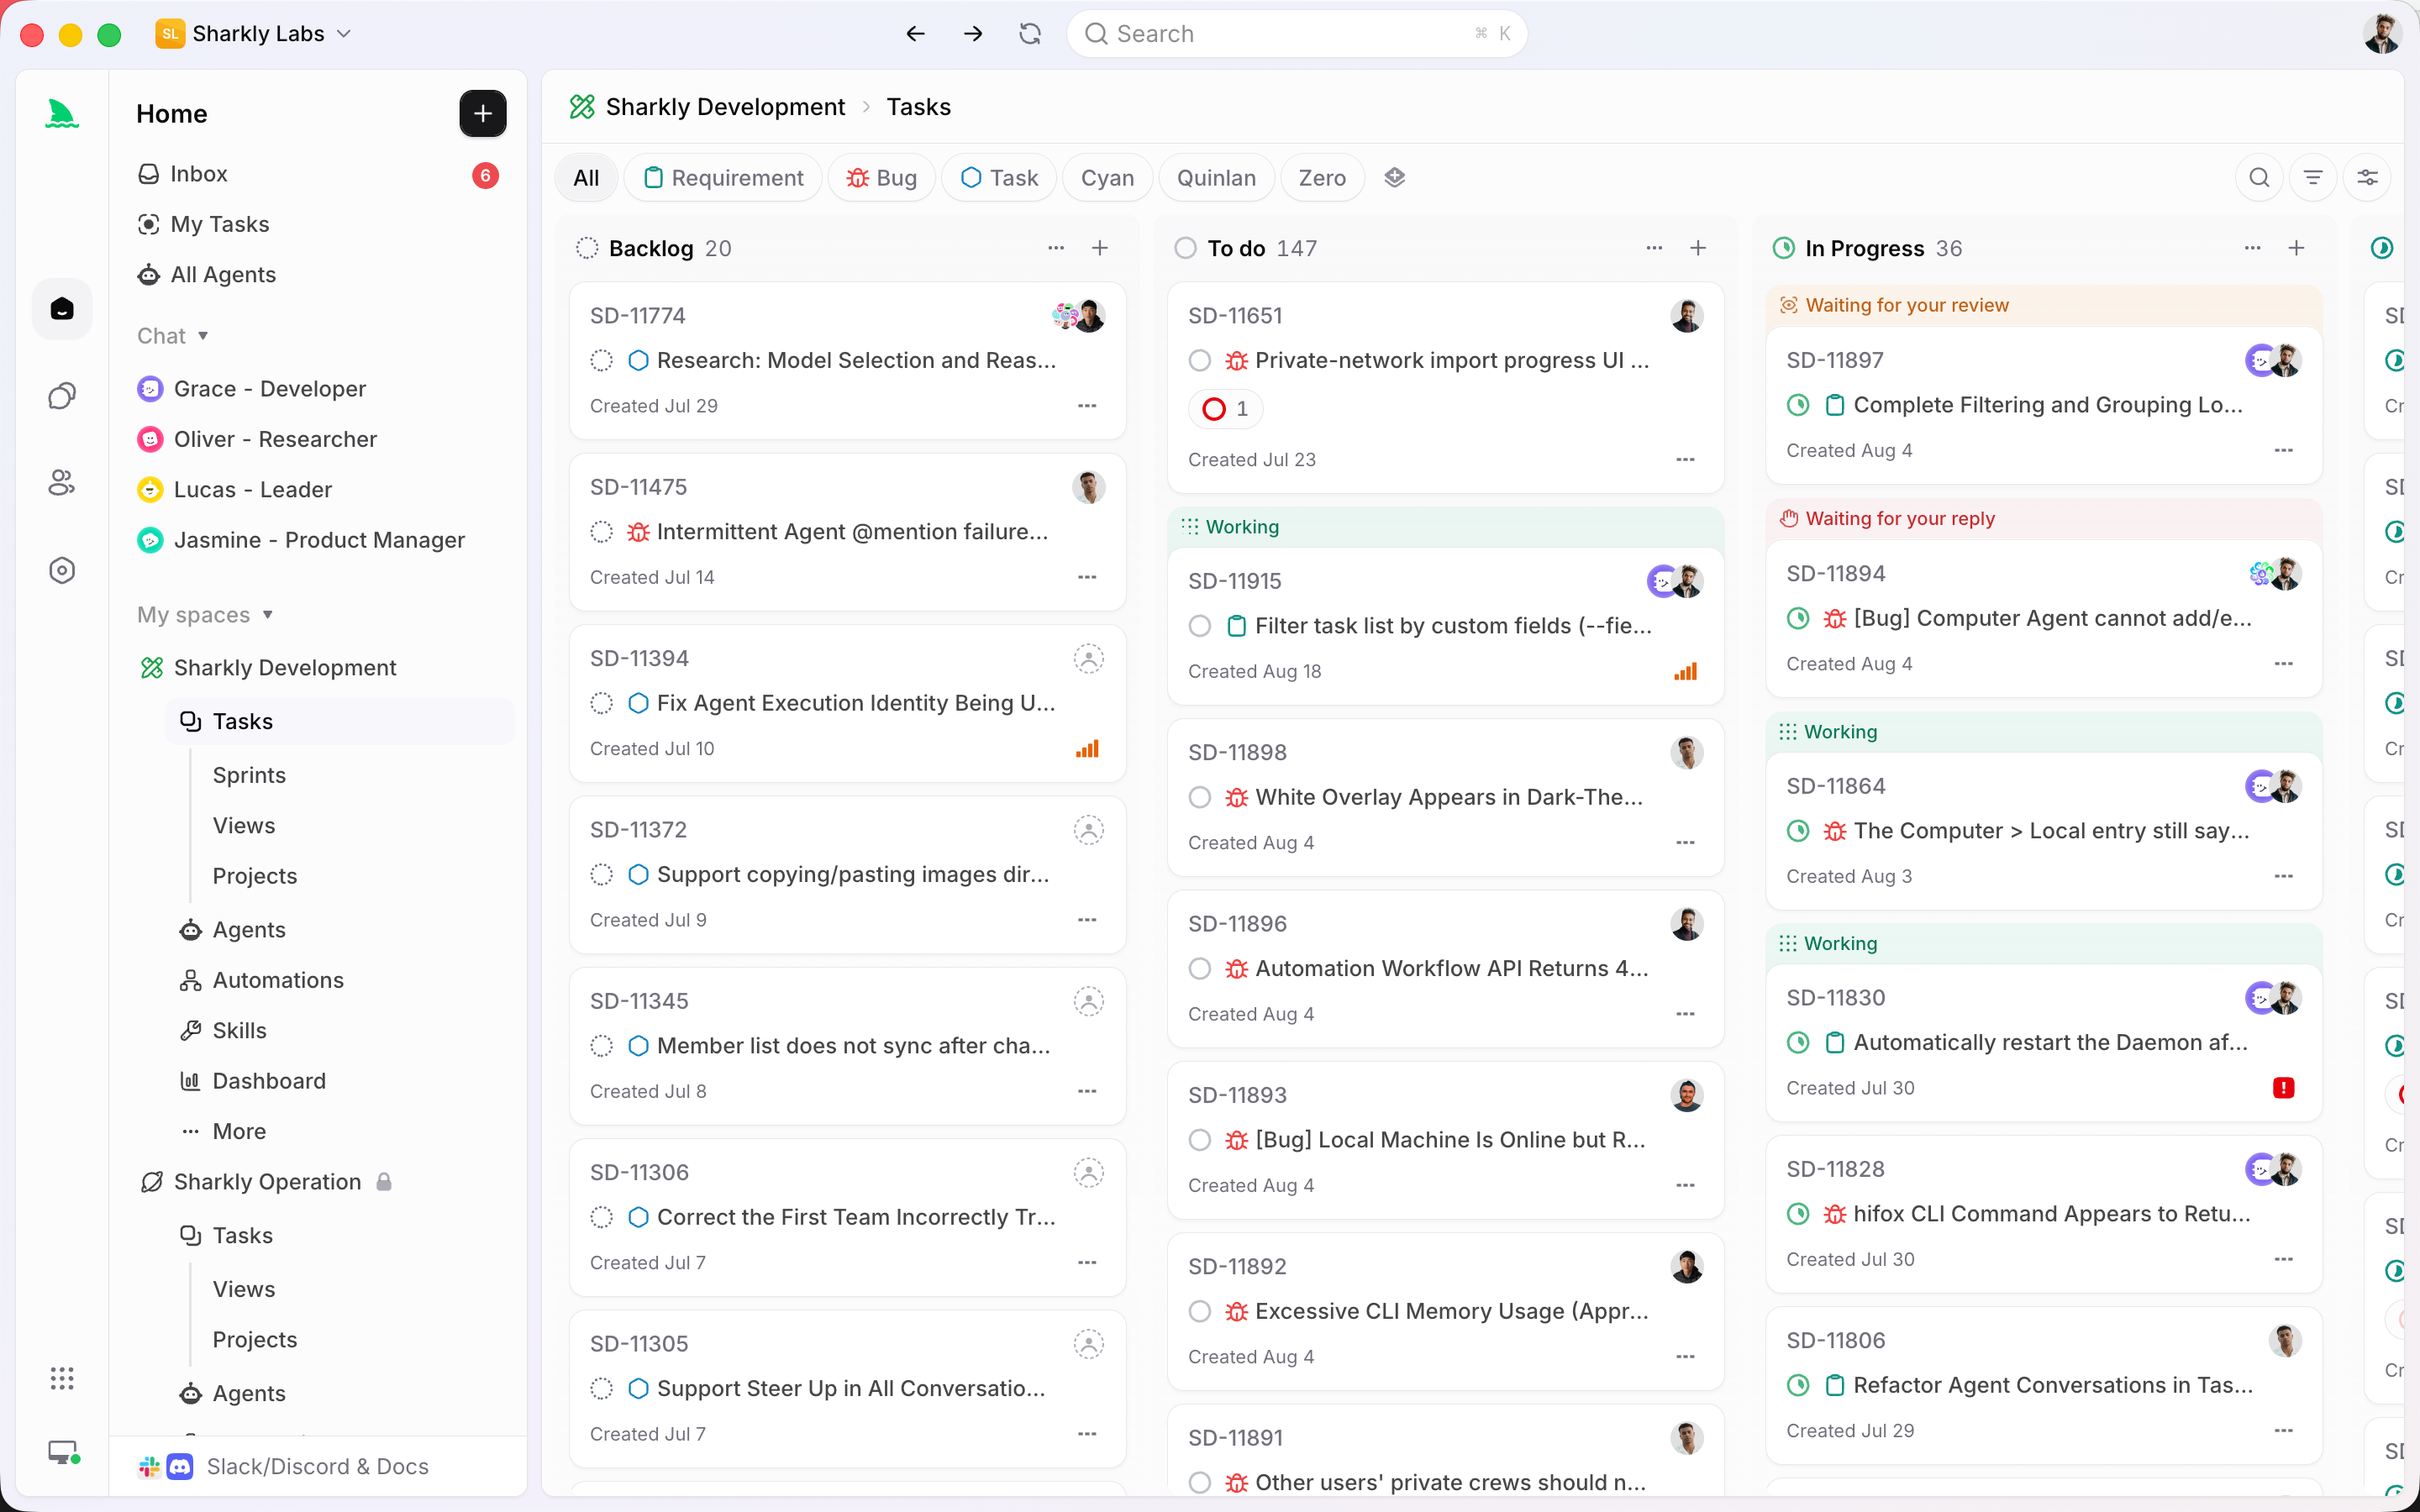
Jede Rolle hat genau eine Aufgabe. Der Coding-Agent erzeugt die Änderung. Der Review-Agent führt den mechanischen Durchlauf aus und hängt seine Befunde an. Der menschliche Reviewer liest diese Befunde, prüft die Änderung gegen die Absicht des Tickets und entscheidet. Alles fließt zurück in die Task: der Diff, die Kommentare des Review-Agenten, die Testausgabe und die menschliche Entscheidung liegen auf einer einzigen Timeline, statt über einen PR, einen Chat und das Gedächtnis von irgendjemandem verstreut zu sein.
Setzen Sie einen Review-Agenten als erstes Gate ein, wenn die Änderung mechanisch und in sich abgeschlossen ist – ein Refactoring, ein Dependency-Update, ein klar umrissener Bugfix; lassen Sie ihn das Rauschen beseitigen, damit der menschliche Durchlauf schnell geht. Verlassen Sie sich nicht auf ihn als einziges Gate, wenn die Änderung Geld, Auth, Datenmigrationen oder öffentliche Verträge berührt; dort liest zuerst der Mensch, und der Durchlauf des Agenten ist eine Checkliste, kein Urteil.
Ein Praxisbeispiel: vom Ticket zum gemergten PR
Nehmen wir SH-312: „Abgelaufene Coupon-Codes beim Checkout ablehnen.“ Eine Person schreibt die Abnahmekriterien und weist die Task zu. Ein Coding-Agent übernimmt sie, arbeitet in einem isolierten Worktree und liefert einen Diff plus einen erfolgreich durchlaufenden Test an die Task zurück, wodurch sie nach Bereit zum Review wandert.
Jetzt läuft der Review-Agent. Er bestätigt die Typen, meldet eine fehlende Null-Prüfung und merkt an, dass der Test den abgelaufenen Fall abdeckt. Sauberer Durchlauf. Nach alter Gewohnheit würde diese Freigabe gemergt.
Stattdessen öffnet der menschliche Reviewer die Task und liest gegen die Absicht. Der Code lehnt abgelaufene Coupons ab, genau wie geschrieben. Doch die Abnahmekriterien implizierten auch, dass bereits eingelöste Coupons abgelehnt werden sollten, und weder der Coding-Agent noch der Review-Agent wusste davon, denn das steht im Kopf des Reviewers und in der Produktspezifikation, nicht im Diff. Der Reviewer fordert eine Änderung an. SH-312 geht mit einer konkreten Notiz zurück auf In Bearbeitung, der Agent erweitert sie, und erst dann verschiebt ein Mensch sie nach Erledigt und mergt den Pull Request.
Der Review-Agent hat seine Arbeit gut gemacht und hätte trotzdem eine Lücke ausgeliefert. Das Betriebsmodell hat sie abgefangen, weil die Abnahme ein separater Akt einer Person mit dem nötigen Kontext war. Dieselbe Disziplin steckt hinter dem Review von KI-generiertem Code mit Belegen auf Task-Ebene: Die Einheit des Reviews ist die Task und ihre Absicht, nicht der Diff für sich allein.
Wo Sie Ihre Review-Gates platzieren sollten
Die praktische Frage ist nicht, ob Sie KI-Code-Review-Agenten einsetzen sollten, sondern wo ihr Durchlauf zählt und wo zuerst ein Mensch lesen muss. Ein paar Regeln, die sich bewähren:
- Lassen Sie den Agenten bei jeder Änderung über Stil, Formatierung und mechanische Bugs wachen. Das ist der Durchlauf, den er am besten beherrscht – und den Menschen am schlechtesten hinbekommen, wenn sie müde sind.
- Verlangen Sie ein menschliches Gate bei allem, was Auth, Abrechnung, Datenmigrationen oder eine öffentliche API berührt. Dort konzentriert sich die blinde Zone.
- Bemessen Sie Ihre Gates an Ihrer Review-Kapazität. Agenten produzieren schneller, als Menschen abnehmen können, also investieren Sie den menschlichen Durchlauf dort, wo der Agent blind ist.
- Machen Sie das Gate zu einem Status, nicht zu einer Gewohnheit. Ein dokumentiertes Approval-Gate, das Erledigt blockiert, ist durchsetzbar; eine Norm, dass „jemand mal draufschauen sollte“, ist es nicht. Einen Human in the Loop zu halten, funktioniert nur, wenn der Loop ein Schritt ist, den der Workflow verlangt.
Ein KI-Code-Review-Agent ersetzt keinen menschlichen Reviewer. Er ist der erste Durchlauf, der den menschlichen Durchlauf schneller und schärfer macht. Wenn Sie bereits mehrere Coding-Agenten laufen lassen und deren Output an einem Ort statt in fünf PR-Tabs reviewen und abnehmen möchten, dann ist das genau das Problem, um das Sharkly herum gebaut ist: Agentenarbeit auf gemeinsamen Tasks zuweisen, verfolgen und reviewen, wobei die Befunde des Review-Agenten und die menschliche Entscheidung beide im selben Datensatz landen. Behalten Sie die Coding-Agenten und den Review-Agenten, die Sie bereits nutzen, und ergänzen Sie dann die Ebene, die entscheidet, wann ihr Durchlauf ausreicht.


