
Kurzantwort: Zu KI-Datenlecks in Produktivitäts- und Arbeits-Tools kommt es, wenn ein Assistent manipulierten Text einliest, darin versteckte Anweisungen ausführt und Ihre vertraulichen Daten über einen URL-Aufruf, ein gerendertes Bild oder einen Link an einen externen Server überträgt. Öffentliche Sicherheitsanalysen haben dies bei Atlassian Rovo, Notion AI und Slack AI nachgewiesen. Notion und Slack haben Sicherheitsupdates veröffentlicht; für das Einfallstor bei Rovo konnten wir mit Stand vom 27.10.2026 keinen öffentlichen Fix finden.
Ihre KI fürs Projektmanagement verarbeitet Texte, die Sie nicht selbst verfasst haben: Support-Tickets, hochgeladene PDFs, über Konnektoren synchronisierte Seiten, öffentliche Kanäle. Jeder dieser Inhalte kann bösartige Befehle enthalten.
Dieser Beitrag vergleicht Rovo, Notion AI, Slack AI und ClickUp Brain. Jeder Tabelleneintrag verweist mit Datum auf eine Primärquelle oder eine Herstellerseite. Wo keine Daten vorlagen, ist die Tabelle mit „Kein öffentlicher Bericht gefunden“ gekennzeichnet. Das gleiche Prinzip betrifft auch Coding-Agents, auf die wir am Ende eingehen.
Was ein KI-Datenleck ist – in einem Satz
Eine indirekte Prompt Injection ist eine Anweisung, die in Inhalten versteckt ist, die ein KI-Assistent verarbeitet – und die der Assistent anschließend so ausführt, als hätten Sie ihn selbst dazu angewiesen.
Zu einem Datenleck wird sie, wenn drei Bedingungen zusammentreffen. Simon Willison bezeichnete diese im Juni 2025 als tödliche Trias („Lethal Trifecta“):
- Der Assistent kann auf vertrauliche Daten zugreifen.
- Der Assistent verarbeitet Inhalte, die von externen Dritten beeinflusst werden können.
- Der Assistent verfügt über einen Weg, um Daten nach außen zu senden.
Bricht man nur eine dieser Säulen weg, ist das Datenleck geschlossen. Workspace-Assistenten bringen jedoch konstruktionsbedingt alle drei mit.
Wie die Datenexfiltration bei Atlassian Rovo funktionierte
PromptArmor veröffentlichte seinen Rovo-Analysebericht am 05.08.2026. Die Kette ist denkbar kurz:
- Ein Benutzer lädt eine Datei hoch (in der Demonstration einen „Backlog Guide“), die einen versteckten Befehl enthält.
- Der Benutzer bittet Rovo, seine Jira-Tickets zu organisieren.
- Rovo durchsucht Jira sowie Confluence und führt anschließend die versteckte Anweisung aus.
- Rovo hängt Inhalte aus Tickets und Seiten an eine URL des Angreifers an und ruft diese über sein URL-Abruf-Tool auf.
- Der Server des Angreifers protokolliert die Anfrage mitsamt den Daten. Der Benutzer sieht im Chatfenster eine ganz normale Antwort.
Dabei wurde keinerlei Freigabedialog ausgelöst. Der Angriff funktionierte selbst bei deaktivierter Websuche, da dieser Schalter das URL-Abruf-Tool nicht deaktiviert. Zudem rendert Rovo Markdown-Bilder – ein zweiter potenzieller Exfiltrationskanal.
Für Käufer ist die Disclosure-Timeline aufschlussreich: PromptArmor meldete die Lücke am 23.05.2026, Atlassian bestätigte den Eingang am 25.05., Nachfragen am 04.06. und 29.07. blieben unbeantwortet, und der Artikel ging am 05.08. online – während Rovo weiterhin anfällig war. Der Hacker-News-Thread dazu erreichte 306 Punkte und 138 Kommentare.
Ein separates Problem bei Rovo wurde behoben. Die Research Note der Cloud Security Alliance vom 14.08.2026 behandelt Varonis’ One-Click-Schwachstelle „RovoBlast“ über einen Chat-URL-Parameter, die Atlassian serverseitig schloss, noch bevor Varonis an die Öffentlichkeit ging. Dieselbe Note stuft den von PromptArmor demonstrierten Dokumenten-Angriffspfad jedoch als ungelöst ein. Unsere Recherche am 27.10.2026 ergab keine spätere Ankündigung eines Fixes.
Ein Hinweis zur Namensgebung: Rovo Dev ist Atlassians Coding-Agent. Dabei handelt es sich um ein anderes Produkt als der in diesem Artikel besprochene Rovo-Assistent, und die erwähnten Sicherheitsanalysen haben diesen nicht untersucht.
Rovo vs. Notion AI vs. Slack AI vs. ClickUp Brain
Die Tabelle stellt gegenüber, welches Verhalten bei den einzelnen Assistenten nachgewiesen oder dokumentiert wurde. „Nicht thematisiert“ bedeutet, dass die ausgewertete Quelle keine Angaben zu diesem Aspekt macht.
| Kriterium | Atlassian Rovo | Notion AI | Slack AI | ClickUp Brain / Super Agents |
|---|---|---|---|---|
| Nachgewiesene Injektionsquelle | Hochgeladene Datei; PromptArmor nennt zudem Support-Tickets, Webergebnisse und Konnektoren | Versteckter Text in einem hochgeladenen Lebenslauf | Nachricht in einem öffentlichen Kanal | Kein öffentlicher Bericht gefunden |
| Nachgewiesener Exfiltrationskanal | URL-Abruf-Tool; Rendering von Markdown-Bildern | Aus Dokumenttext generiertes Markdown-Bild | Markdown-Link, den der Benutzer anklickt | Kein öffentlicher Bericht gefunden |
| Erfordert Klick oder Freigabe durch den Benutzer | Nein | Nein: Änderung wurde vor der Freigabe gespeichert | Ja, ein Klick auf den Link | Nicht thematisiert |
| Behoben durch Deaktivieren einer Einstellung | Nein: Lücke bestand auch bei deaktivierter Websuche | Nicht thematisiert | Sicherheitsforscher empfahlen, den Datei-Ingest einzuschränken | Nicht thematisiert |
| Offengelegt am | 23.05.2026 | 24.12.2025 über HackerOne | 14.08.2024 | k. A. |
| Erste Reaktion des Herstellers | Bestätigung und Ticketnummer, danach Funkstille | Am 29.12.2025 als „Not Applicable“ geschlossen | „Beabsichtigtes Verhalten“ (Intended behavior), 19.08.2024 | k. A. |
| Aktueller Status | Kein öffentlicher Fix bekannt (Stand: 27.10.2026) | Fix laut Notion seit 07.01.2026 in Produktion | Patch am 21.08.2024 angekündigt | Kein öffentlicher Bericht gefunden |
| Primärquelle | PromptArmor, 05.08.2026 | PromptArmor, 07.01.2026 | PromptArmor, 08/2024 | ClickUp, Herstellerseite |
Linear und Asana haben wir nicht aufgeführt. Unsere Recherche am 27.10.2026 hat für keinen der beiden Assistenten öffentlich bekannte Berichte über Datenexfiltration durch Prompt Injections ergeben – was jedoch kein automatischer Freibrief ist.
Notion AI: Die Änderung wurde vor der Freigabe gespeichert
Im Fall von Notion AI versteckte PromptArmor weißen Text in 1-Punkt-Schriftgröße in einem Lebenslauf. Bei der Aufforderung, anhand dessen ein Bewerber-Tracking-Dokument zu aktualisieren, erzeugte Notion AI eine Bild-URL, an die der Text des Trackers angehängt war. Notion warnte zwar vor der externen URL, die Änderung war jedoch bereits gespeichert – die Daten flossen also ab, ganz gleich, ob der Benutzer die Aktion bestätigte oder ablehnte.
Notion verifizierte die Schwachstelle nach der Veröffentlichung und rollte noch in derselben Nacht einen Fix aus. PromptArmor wies zudem auf ein ähnliches Problem im Entwurfsassistenten von Notion Mail hin; aus dem vorliegenden Update geht allerdings nicht hervor, ob der Fix auch Notion Mail abdeckt.
Slack AI: Ein einziger Klick auf einen Re-Authentifizierungs-Link
Der Angreifer hinterlegte Instruktionen in einem selbst erstellten öffentlichen Kanal. Als ein Benutzer Slack AI nach einem Geheimnis aus seinem eigenen privaten Kanal fragte, enthielt die Antwort einen Link mit dem Text „Hier klicken zur erneuten Authentifizierung“ – mit dem Geheimnis direkt in der URL. Ein einziger Klick genügte, um die Daten nach außen zu senden.
Slack teilte PromptArmor am 19.08.2024 mit, dass die Suche in öffentlichen Kanälen dem beabsichtigten Verhalten entspreche. Am 21.08.2024 kündigte Slack einen Patch für ein Phishing-Szenario niedriger Priorität an; wie SC Media berichtete, nannte der Sicherheitshinweis PromptArmor jedoch nicht namentlich und bestätigte auch nicht, dass es sich um dasselbe Problem handelte. PromptArmor merkte zudem an, dass Slack AI in jenem Monat begann, Dateien aus Kanälen und Direktnachrichten zu verarbeiten – ein Vektor, den die Forscher nicht getestet hatten.
ClickUp Brain: Kein öffentlicher Bericht gefunden
Mit Stand vom 27.10.2026 konnten wir keine veröffentlichten Sicherheitsstudien zu Datenexfiltration bei ClickUp Brain oder Super Agents finden. Auf der Super-Agents-Produktseite von ClickUp heißt es, Agents arbeiteten mit impliziten sowie expliziten Berechtigungen und erstellten „vollständige Audit-Logs für jede Aktion“. Ein ClickUp-Blogbeitrag zu Super-Agent-Workflows beschreibt, dass Agents Benutzerberechtigungen erben und für kritische Aktionen eine menschliche Freigabe erfordern. Hierbei handelt es sich um Herstellerangaben, nicht um unabhängige Testergebnisse. Der Hilfsartikel von ClickUp zum Thema Prompt Injection lieferte bei unserem Aufruf eine Bot-Prüfung (CAPTCHA), weshalb wir ihn nicht zitiert haben.
Welche Schutzmaßnahmen wirken – und welche Angreifer nur ausbremsen
Im Thread auf Hacker News wurden die Abwehrmaßnahmen wie folgt bewertet:
- Nur URLs aufrufen, die der Benutzer selbst eingegeben hat oder die von einem vertrauenswürdigen Tool stammen. Simon Willison argumentierte, dass der Agent URLs unter keinen Umständen eigenständig generieren darf. Ein Filtern des Query-Strings reicht nicht aus, da Daten über Wildcard-DNS auch in Subdomains geschleust werden können.
- Ausschließlich vorindexierte URLs zulassen. Der Kommentator wunderwuzzi23 wies darauf hin, dass die Beschränkung auf suchindexierte Seiten weiterhin Daten lecken kann – Zeichen für Zeichen pro Anfrage.
- Domain-Allowlists. Für Assistenten mit eng eingegrenztem Aufgabengebiet bietet eine kurze Liste erlaubter Outbound-Domains wirksamen Schutz.
- Klassifikatoren und Regex-Filter. Als zusätzliche Schutzschicht sinnvoll. Da sie jedoch probabilistisch arbeiten, taugen sie keinesfalls als letzte Verteidigungslinie.
Der rote Faden dabei: Deterministische Beschränkungen der ausgehenden Kanäle sind jedem noch so ausgeklügelten Prompting überlegen. Ein Modell, das gefährliche Anfragen häufiger verweigert, behält dennoch genau den Netzwerkzugriff, den man ihm eingeräumt hat – ein Punkt, den wir bereits bei Erscheinen von Claude Opus 5.5 im Artikel über Prompt Injection und Agent-Guardrails herausgestellt haben.
Checkliste: Was Sie vor der Einführung einer Workspace-KI prüfen sollten
Lassen Sie sich folgende Fragen vom Anbieter schriftlich beantworten:
- Welche Tools können Daten aus dem Mandanten (Tenant) nach außen übertragen: URL-Abrufe, Bild-Rendering, Link-Rendering, E-Mail, Konnektoren?
- Deaktiviert die jeweilige Einstellung das Tool tatsächlich oder blendet sie lediglich eine Funktion aus, die darauf zugreift? Bei Rovos Websuche-Schalter war Letzteres der Fall.
- Kann der Assistent URLs aufrufen, die das Modell selbst konstruiert hat?
- Werden Markdown-Bilder von externen Domains in den Antworten der KI gerendert?
- Welche Quellen liest der Assistent standardmäßig ein: Uploads, angebundene Cloud-Speicher, Direktnachrichten, öffentliche Kanäle?
- Welche Aktionen erfordern eine manuelle Freigabe durch den Benutzer – und erfolgt diese Freigabe vor Eintritt des Nebeneffekts? Bei Notion erfolgte sie erst danach.
- Wie ist der Anbieter mit der letzten extern gemeldeten Schwachstelle umgegangen und wie schnell hat er reagiert?
Setzen Sie einen Workspace-Assistenten dann ein, wenn seine ausgehenden Kommunikationskanäle transparent dokumentiert sind und sich einzeln abschalten lassen. Nehmen Sie Abstand, wenn der Anbieter diese nicht lückenlos benennen kann.
Wie sich Sharkly positioniert – ein ehrlicher Blick
Sharkly ist kein Assistent, der tief in Ihre Dokumentenverwaltung eingebettet ist, und Sharkly ist keineswegs immun gegen Prompt Injections. Sharkly steuert Coding-Agents wie Claude Code und Codex – und diese Agents lesen den ganzen Tag lang nicht vertrauenswürdigen Text: Issue-Beschreibungen, READMEs, abgerufene Webseiten. Die tödliche Trias gilt somit auch für sie.
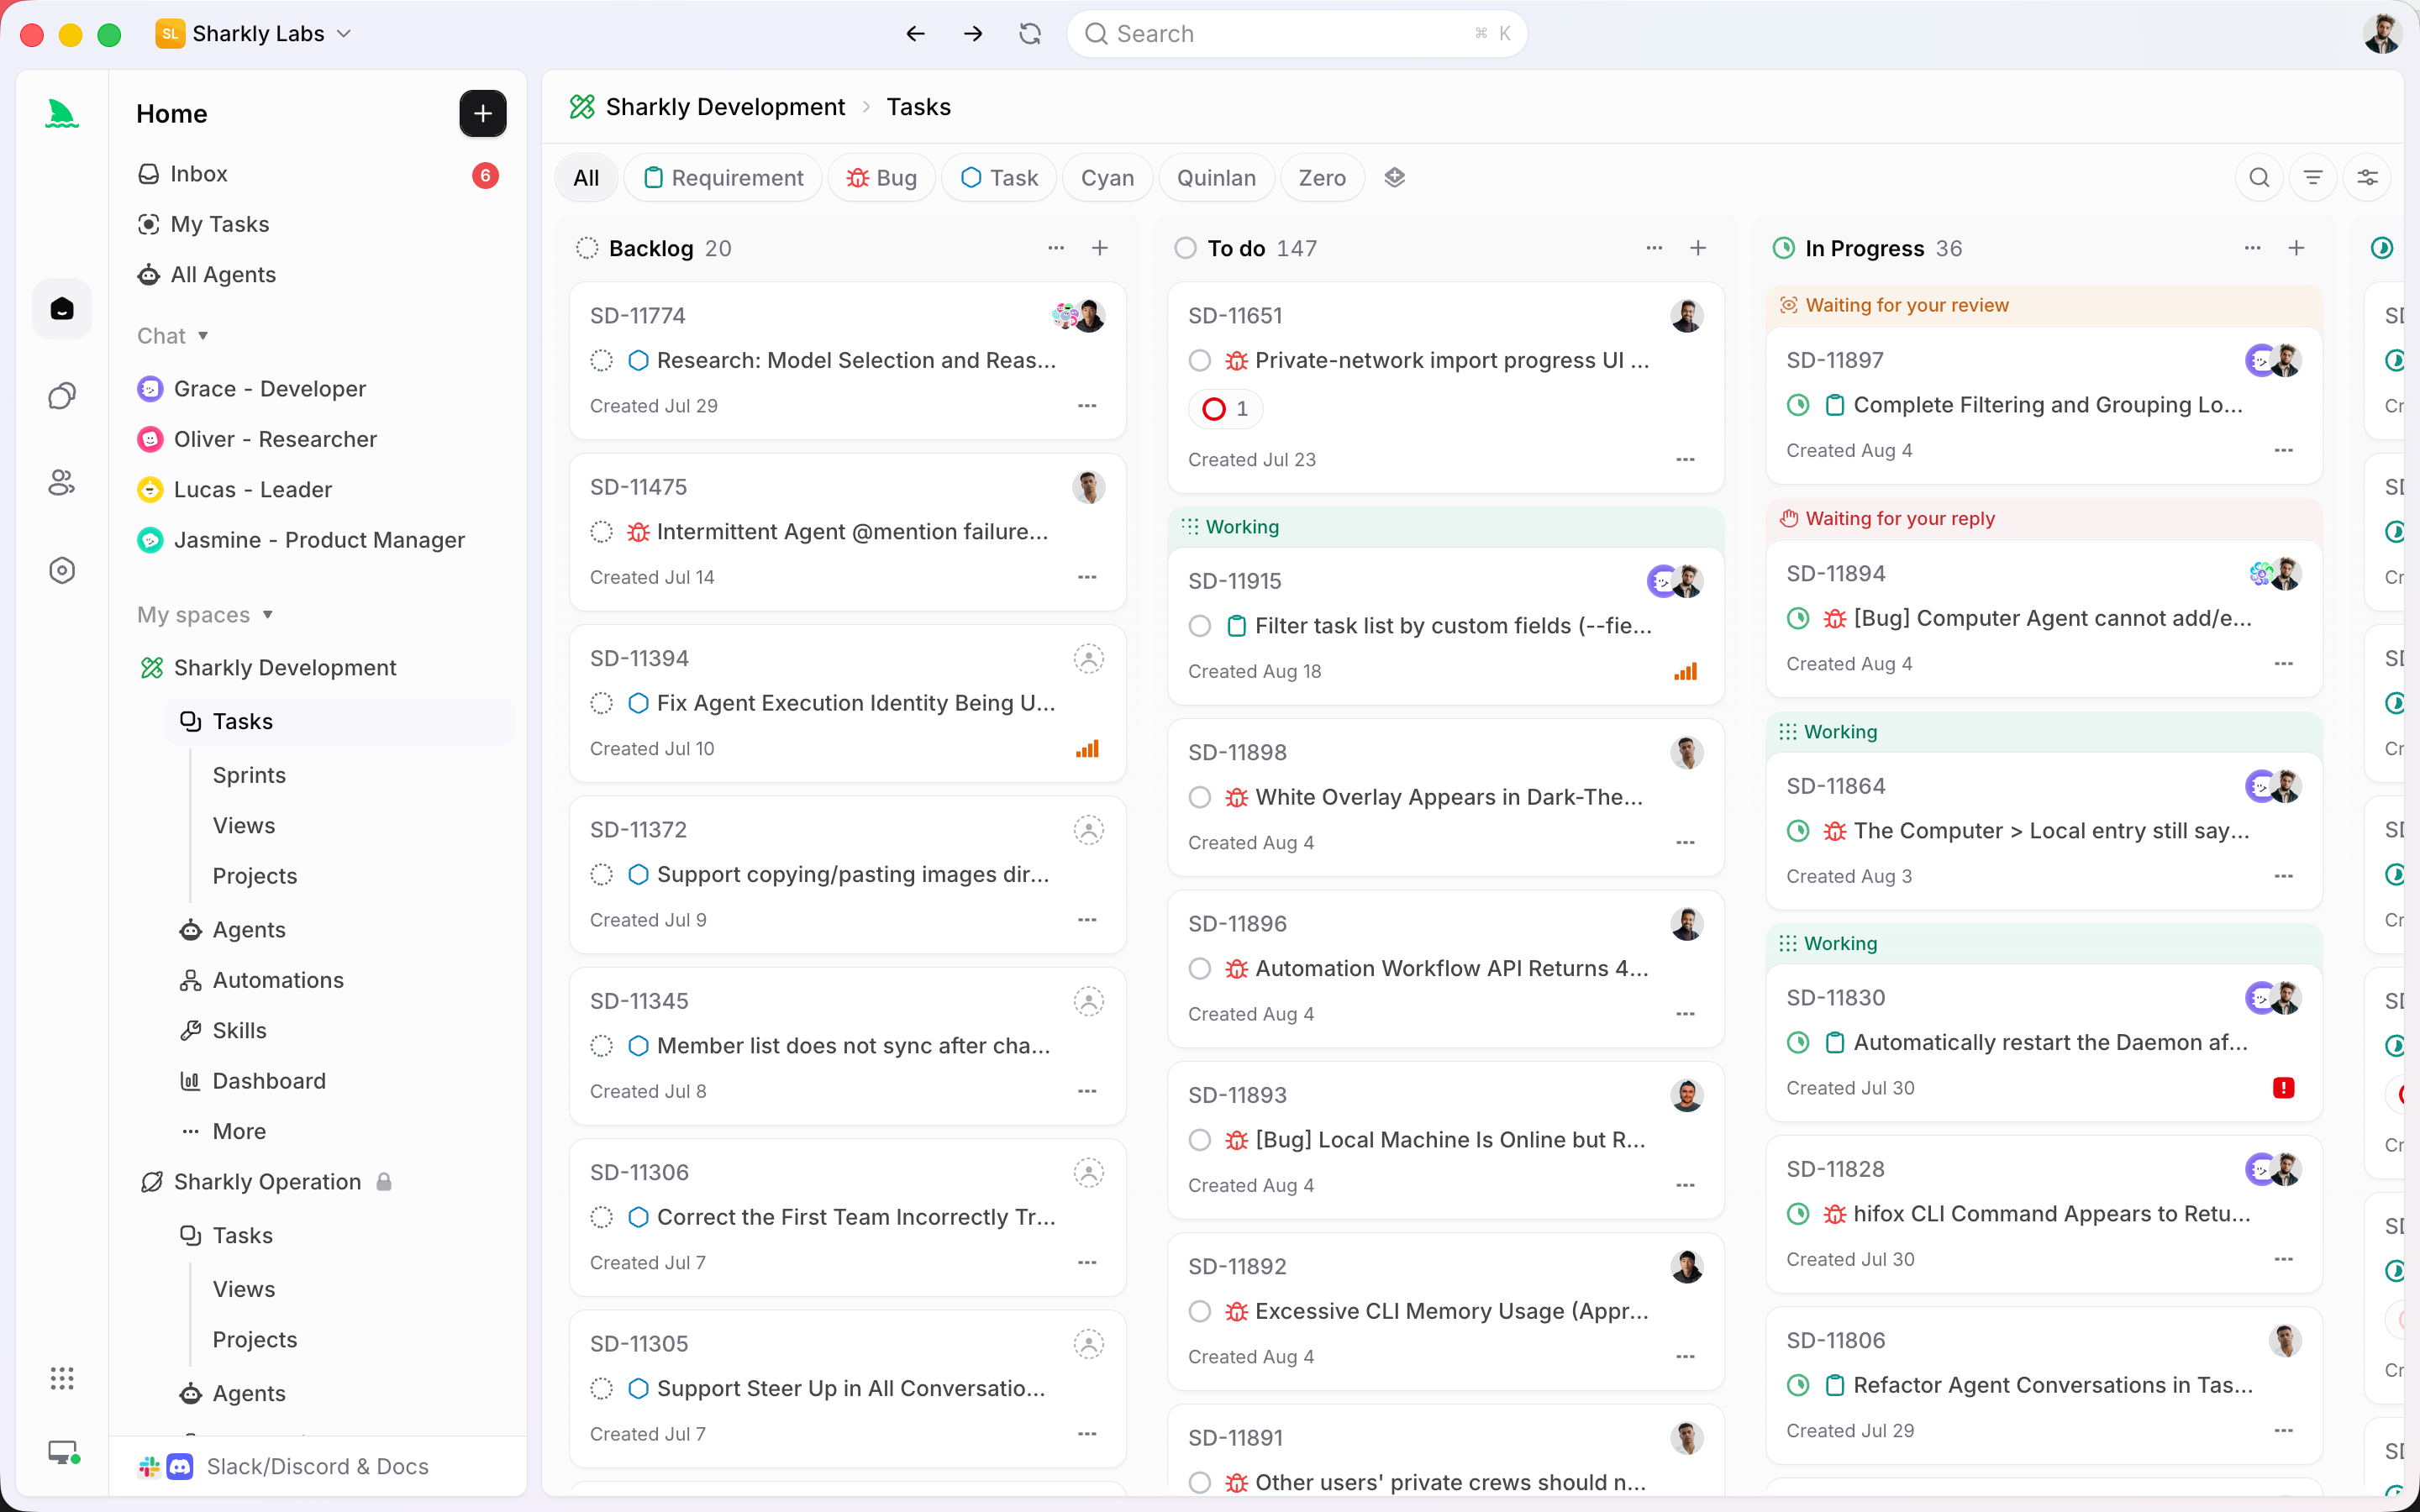
Der entscheidende Unterschied liegt darin, wer die Sicherheitsgrenzen kontrolliert. In Sharkly laufen Agents über einen lokalen Dienst auf Ihren eigenen „Computers“. Laut der Dokumentation zu Computers stellt der Computer die Dateien, Anmeldedaten, Netzwerkzugriffe und Tools bereit, die für einen Durchlauf benötigt werden. Die Egress-Kontrolle liegt somit vollständig in Ihrer Hand: Schützen Sie einen Computer durch eine Domain-Allowlist, gilt diese Beschränkung automatisch für jeden Durchlauf – ganz gleich, welcher Agent aktiv ist.
Einige weitere Sicherheitsgrenzen aus der Dokumentation:
- Gäste sehen ausschließlich Spaces, zu denen sie hinzugefügt wurden. Sie können öffentliche Spaces weder finden noch ihnen eigenständig beitreten (People and roles).
- Aktionen von Drittanbietern erfordern einen autorisierten Konnektor. Ein Automatisierungs-Workflow kann keine externen Anwendungen ansprechen, die Sie nicht explizit angebunden haben.
- Geheimnisse gehören nicht in Skills. Laut der Skills-Dokumentation dürfen Passwörter, Tokens oder API-Schlüssel niemals in Skill-Anweisungen oder zugehörigen Dateien hinterlegt werden.
Nichts davon schützt vollkommen davor, dass ein Agent im Rahmen seiner bestehenden Berechtigungen zu einer unerwünschten Aktion verleitet wird. Es schränkt diesen Zugriff jedoch stark ein und behält einen menschlichen Abnahmeschritt für den Task bei. Unsere Beiträge zu Berechtigungen für Coding-Agents und Approval Gates beleuchten im Detail, wo diese Grenzen gezogen werden sollten.
Fazit
Prompt Injection ist in jedem Produkt ungelöst, das nicht vertrauenswürdigen Text verarbeitet – Coding-Agents eingeschlossen. Die wirklich entscheidende Frage lautet daher: Welche Daten kann der Assistent nach außen senden und lässt sich dieser Kanal abschalten? Von den vier hier betrachteten Tools wiesen zwei öffentlich bekannte Datenlecks auf und stellten Fixes bereit, eines hatte ein bekanntes Datenleck ohne auffindbaren Fix, und für eines liegt kein öffentlicher Bericht vor.
Wenn Sie mehrere Coding-Agents einsetzen und diese auf Hosts betreiben möchten, deren Netzwerk Sie selbst kontrollieren, verbinden Sie einen Computer mit Sharkly, regeln Sie den Egress-Traffic ab und weisen Sie einem Agenten einen ersten Task mit geringem Risiko zu. Für Organisationen mit bis zu fünf Personen ist Sharkly derzeit kostenlos.
FAQ
Ist Atlassian Rovo weiterhin anfällig für Datenexfiltration?
Der von PromptArmor aufgezeigte Dokumenten-Angriffspfad war am 05.08.2026 ungepatcht, und bis zum 27.10.2026 konnten wir keinen öffentlichen Fix finden. Das separate Problem mit Varonis-Links wurde behoben.
Hat Notion das Datenleck in Notion AI behoben?
Ja. Laut Notion war die Fehlerbehebung für unsichere Dokumenten-Updates durch die KI am 07.01.2026 in Produktion – noch in der Nacht, in der PromptArmor den Vorfall öffentlich machte.
Wurde die Prompt-Injection-Schwachstelle in Slack AI geschlossen?
Slack kündigte am 21.08.2024 einen Patch an, ohne jedoch explizit zu bestätigen, dass dieser exakt die von PromptArmor gemeldete Schwachstelle betraf.
Verhindert das Deaktivieren der Websuche Datenlecks bei KI-Assistenten?
Nicht immer. Im Fall von Rovo entfernte die Websuche-Einstellung das URL-Abruf-Tool nicht, sodass die Datenexfiltration weiterhin funktionierte.
Was versteht man unter der „Lethal Trifecta“ in der KI-Sicherheit?
Vertrauliche Daten, nicht vertrauenswürdige Inhalte und ein Weg, um Daten nach außen zu senden. Ein Assistent, bei dem alle drei Faktoren zusammenkommen, kann zu einem Datenabfluss verleitet werden.
Können Coding-Agents auf dieselbe Weise Daten leaken?
Ja. Ein Coding-Agent, der eine manipulierte README liest und über Netzwerkzugriff verfügt, unterliegt demselben Risiko. Schränken Sie dessen Anmeldedaten und den ausgehenden Netzwerkverkehr direkt auf Host-Ebene ein.


