
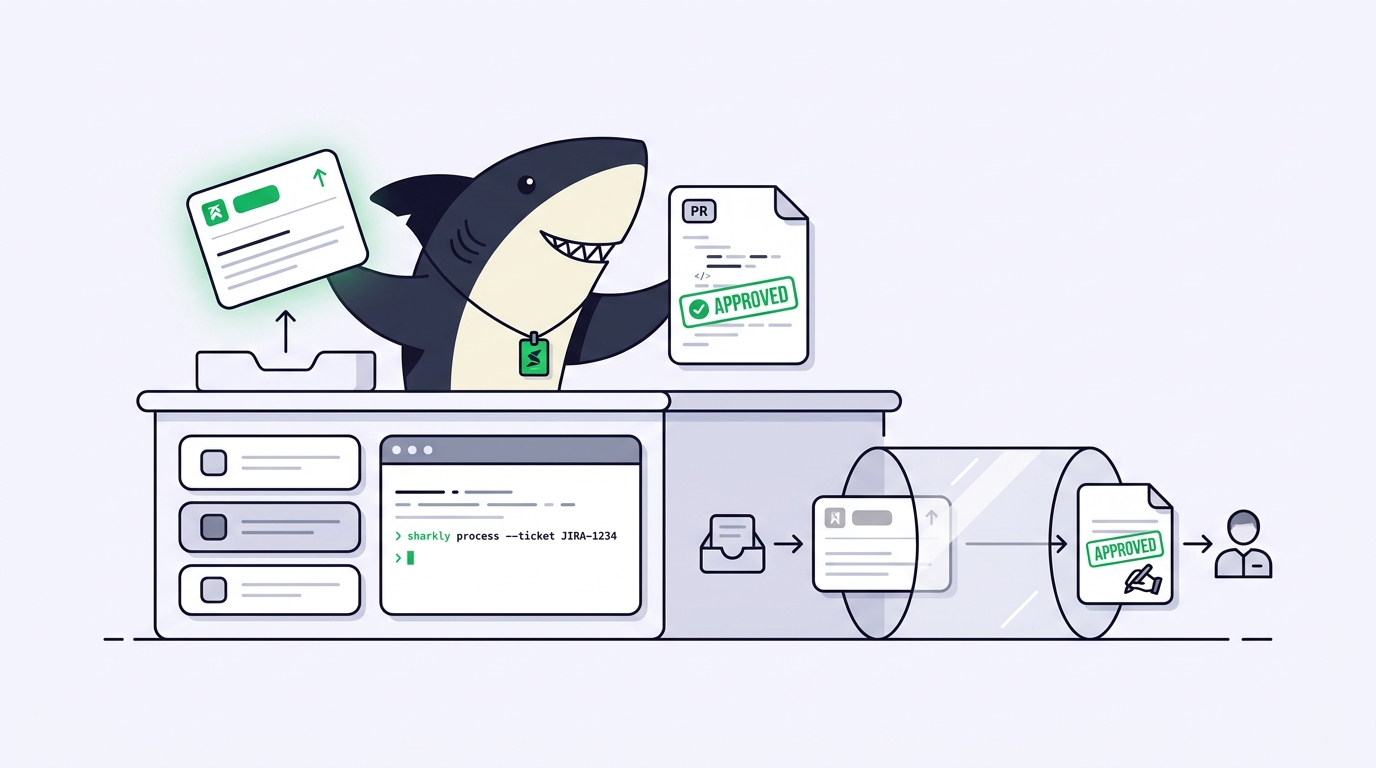
Das Ticket ist bereits geschrieben. Es hat einen Titel, eine Beschreibung, Akzeptanzkriterien und einen Platz im Sprint. Das Einzige, was zwischen ihm und einem Diff steht, ist eine Person, die ein Terminal öffnet, das Ticket in einen Coding-Agenten einfügt, den Lauf beobachtet und das Ergebnis anschließend von Hand zurück in Jira kopiert. Die Arbeit und die Aufzeichnung der Arbeit leben in zwei verschiedenen Fenstern, und sie synchron zu halten, kostet jemanden einen ganzen Nachmittag.
Ein Jira-Ticket einem KI-Agenten zuzuweisen heißt, genau diese Lücke zu schließen: Das Issue wird zu einer Arbeitseinheit, die ein Agent aufgreifen, gegen dein Repository ausführen und als überprüfbare Änderung zurückgeben kann – ohne den Tracker zu verlassen, auf dem dein Team ohnehin arbeitet. Du nimmst dein Team nicht von Jira weg. Du fügst eine Ebene hinzu, auf der das Ticket tatsächlich bearbeitet werden kann.
Diese Ebene ist Sharkly, eine All-in-One-Plattform für Agenten-Steuerung und -Management. Sie verbindet sich mit Jira, macht aus Issues zuweisbare Tasks, leitet sie an deine Coding-Agenten weiter (Claude Code, Codex, Gemini und andere Kommandozeilen-Tools), führt jeden davon isoliert aus und gibt das Ergebnis an den Task zurück. Dieser Leitfaden beschreibt den kompletten Kreislauf: Ticket rein, Agent zugewiesen, Arbeit in einem isolierten Worktree, Pull Request und Diskussion zurück in der Aufzeichnung.
Der Kreislauf in einem Satz
Ein Sharkly-Task ist die gemeinsame Aufzeichnung für ein Stück Arbeit, und wenn du Jira verbindest, wird jedes Jira-Issue zu einem solchen Task. Ab da ist der Vertrag einfach: Agenten recherchieren, führen aus, testen und berichten; Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Der Rest dieses Artikels beschreibt nur die Mechanik dieses Satzes.
Jira behalten, die Ausführungsebene ergänzen
Sharkly ist kein Ersatz für Jira. Es ergänzt die Ebene aus gemeinsamem Task, verbundenem Computer, Ausführung und Review rund um den Tracker, den dein Team ohnehin nutzt. Niemand muss ein neues Board lernen oder ein Backlog migrieren, um loszulegen.
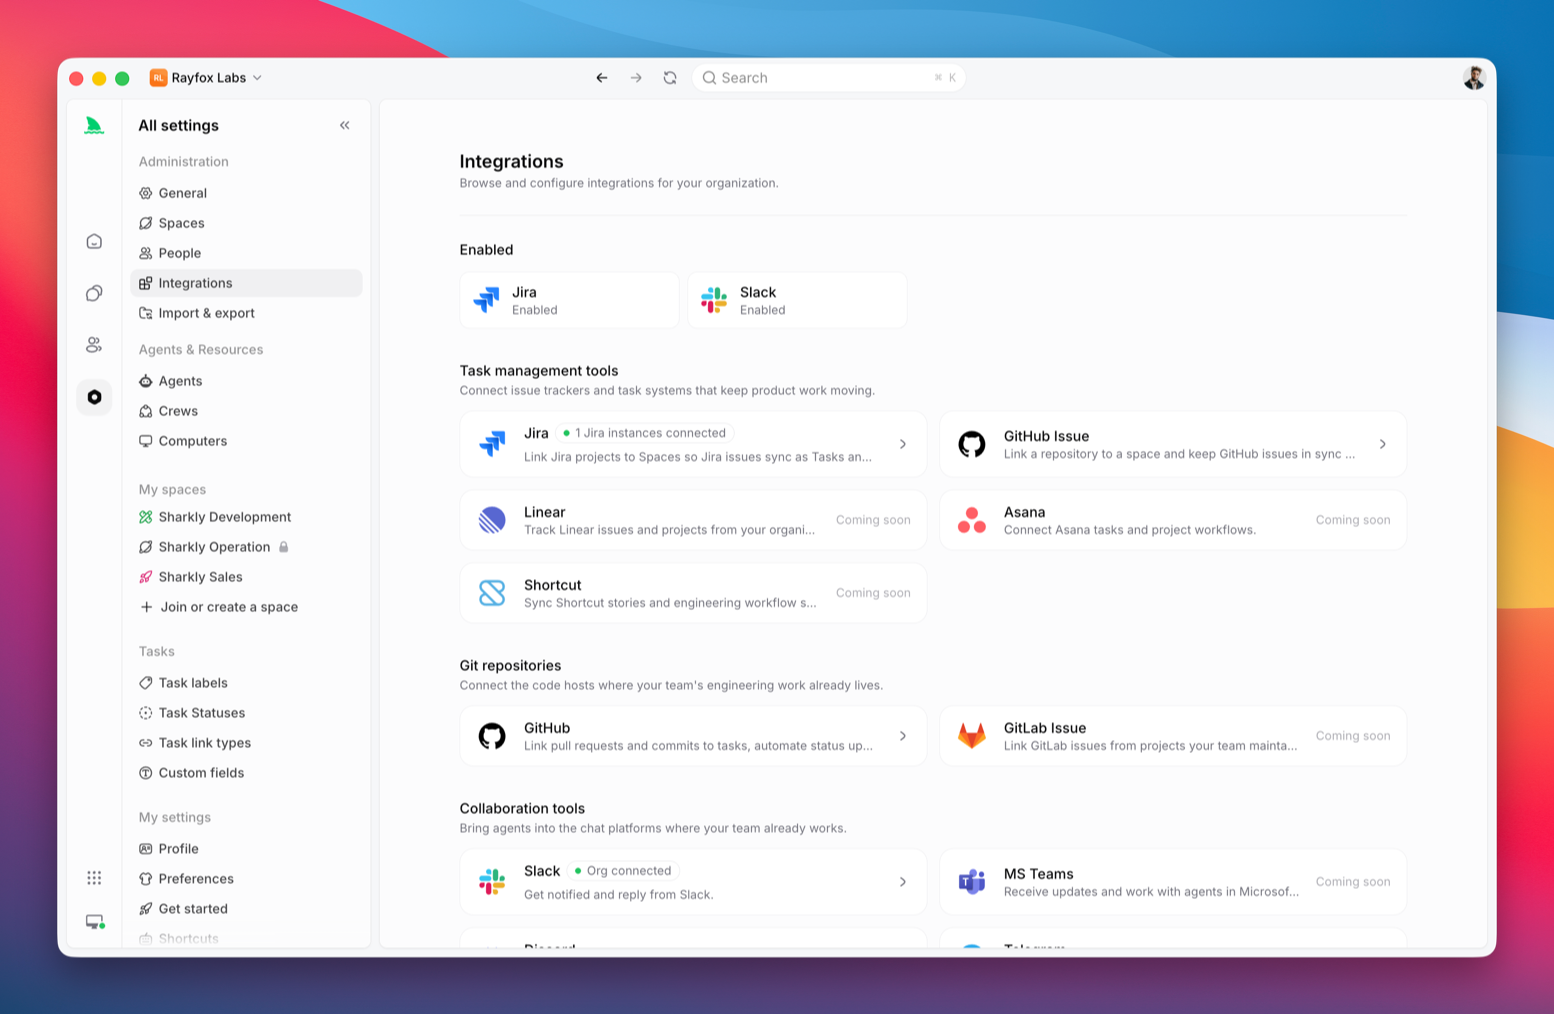
Du verbindest die beiden mit einem Sync-Link. Öffne die Jira-Integration, verbinde das Konto (Jira Cloud verwendet deinen *.atlassian.net-Host, die Konto-E-Mail und ein Atlassian API token; Server und Data Center verwenden die Basis-URL, den Benutzernamen und ein persönliches Zugriffstoken) und ordne dann einem Jira-Projekt einen Sharkly Space zu. Die zentralen Zuordnungen sind genau die, die du erwartest:
- Aus einem Jira-Issue wird ein Sharkly-Task
- Aus einem Jira-Epic wird ein Sharkly-Projekt
- Zugewiesene Person, Status, Kommentare und Anhänge werden übernommen
Hier ist das ehrliche Entscheidungspaar. Nutze Sync, wenn ein laufendes Projekt verbunden bleiben soll, sodass Änderungen ab jetzt zwischen Jira und Sharkly fließen. Nutze Import, wenn du historische Issues für eine kontrollierte Migration übernehmen möchtest; Sync allein füllt die Vergangenheit eines Projekts nicht nach. Die meisten Teams, die gerade anfangen, wollen einen bidirektionalen Sync-Link für ein aktives Projekt – und mehr nicht. Das komplette Setup, inklusive des Webhook-Schritts, den ein Jira-Admin einmal übernimmt, steht in der Sharkly-Dokumentation.
Das Ticket einem Agenten zuweisen
Sobald das Projekt verknüpft ist, erscheint das Issue als Task im Space. Ihn einem Agenten zuzuweisen funktioniert genauso wie die Zuweisung an eine Kollegin: Du wählst den Agenten statt einer Person.
Ein Agent ist mehr als die Wahl eines Modells. Seine Instruktionen, Runtime, Repositories und Lauf-Einstellungen bestimmen, wie er Arbeit erledigt – so wie eine Rollenbeschreibung prägt, was eine neue Mitarbeiterin tut. Die Runtime ist die darunterliegende Engine: Claude Code, Codex oder welcher CLI-Agent auch immer in deinem Team läuft. Die Modellnutzung läuft weiterhin über die Abos oder API-Schlüssel, die in diesen Tools konfiguriert sind, sodass dein Agent-Zugang und dein Code auf deiner eigenen Hardware bleiben. Sharkly koordiniert die Zuweisung; es übernimmt nicht die Verwahrung deiner Zugangsdaten.
Wenn das dein erster Lauf ist, halte den Umfang klein und die Grenzen klar. Eine Aufgabe zu schreiben, die ein Agent tatsächlich ausführen kann, ist eine eigene Fähigkeit, und es lohnt sich, sie zu beherrschen, bevor du einen Agenten auf etwas wirklich Tragendes loslässt. Ein präzises Ticket mit klarer Definition of Done erzeugt einen präzisen Diff; ein vages erzeugt einen vagen.
Ausführung in einem isolierten Worktree
Wenn der Agent startet, läuft der Lauf auf einem verbundenen Computer in einem eigenen isolierten Worktree ab. Diese Isolation ist der Teil, der das Ganze sicher wiederholbar macht. Jeder Lauf bekommt ein frisches Arbeitsverzeichnis, sodass zwei Agenten, die an zwei Tickets gegen dasselbe Repository arbeiten, niemals gegenseitig ihre Dateien überschreiben oder sich um einen Branch streiten. Es ist dieselbe Disziplin, die du mit Git-Worktrees für KI-Coding-Agenten von Hand anwenden würdest – hier für dich erledigt und über jeden Task hinweg wiederholbar.
Das ist auch der Grund, warum der Workflow über ein einzelnes Ticket hinaus skalieren kann. Sobald die Isolation automatisch ist, wird das parallele Ausführen mehrerer Agenten zu keiner Jongliernummer mehr, weil das, was normalerweise kaputtgeht (gemeinsamer Zustand auf der Festplatte), konstruktiv ausgeschlossen ist. Wenn dir das ganze Modell neu ist, ist deine erste Aufgabe einem KI-Agenten zuzuweisen der sanftere Einstieg, bevor du Jira anbindest.
Den PR zurück in die Aufzeichnung holen
Die Arbeit des Agenten kehrt zum Task zurück: die Konversation, die Ausführungsprotokolle, Blocker und die daraus resultierende Änderung landen alle an einem Ort, statt sich über ein Terminal und einen Chat-Thread zu verteilen. Wenn der Agent einen Pull Request öffnet, verbindest du ihn mit dem Task, indem du die Task-ID in den Branch-Namen, den PR-Titel oder den PR-Text schreibst. Die GitHub-Integration von Sharkly erkennt die ID, verknüpft den Pull Request mit dem Task und kann einen Rückverweis-Kommentar hinterlassen, damit alle am Ticket direkt zum Code springen können.
Da der Jira-Sync-Link bidirektional ist, fließt diese Aktivität auch weiter zum ursprünglichen Issue. Die Person, die das Ticket erstellt hat, sieht die Arbeit vorankommen, ohne auch nur ein Terminal zu öffnen. Das ist der Lohn dafür, Arbeit über einen gemeinsamen Task statt über einen privaten Prompt zu leiten: Kontext, Fortschritt, Blocker, Ergebnisse und Review bleiben von der Anfrage bis zum Release sichtbar.
Die ehrliche Grenze: Ein Mensch nimmt ab
Nichts wird von selbst gemergt. Das ist Absicht, und es lohnt sich, es klar zu sagen, weil ein Leser vielleicht etwas anderes annimmt: Das Mergen eines Pull Requests ändert den Task-Status nicht, und es passiert niemals automatisch. Die Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist.
Die Arbeitsteilung gilt bis zum Schluss. Der Agent erledigt die Arbeit, öffnet den PR und berichtet, was er getan, was er verifiziert hat und wo er unsicher ist. Ein Mensch liest den Diff gegen die ursprünglichen Akzeptanzkriterien, fordert Änderungen an oder nimmt ab und trifft die Entscheidung über Merge und Release. Ein Agent füllt Stille nur allzu gern mit Eigeninitiative, deshalb ist der Review-Schritt keine Zeremonie; er ist die Kontrolle, die den automatischen Teil vertrauenswürdig macht. Die endgültige Abnahme und die Release-Entscheidungen bleiben bei Menschen.
Das ist der komplette Kreislauf. Ein Jira-Ticket geht rein, ein Agent greift es auf, die Arbeit läuft isoliert ab und kehrt als lesbarer Pull Request in die Aufzeichnung zurück, und du entscheidest, ob er ausgeliefert wird. Für einen breiteren Blick darauf, wie das zu einem Team aus Agenten statt zu einem einzelnen Lauf passt, siehe was KI-Agenten-Orchestrierung für Dev-Teams bedeutet oder die Sharkly-Übersicht zur gesamten Plattform.
Um es an einem echten Ticket auszuprobieren: Lade Sharkly herunter, melde dich unter app.sharkly.ai an, verbinde einen Computer und verknüpfe ein Jira-Projekt mit geringem Risiko.
Häufig gestellte Fragen
Ersetzt Sharkly Jira? Nein. Sharkly ergänzt die Ausführungs- und Review-Ebene rund um Jira. Deine Issues, Epics, Status und Workflows bleiben, wo sie sind; der Sync-Link hält sie verbunden, während Agenten die Arbeit vorantreiben.
Welche Jira-Versionen funktionieren? Beide. Jira Cloud wird über deinen Host, die Konto-E-Mail und ein Atlassian API token verbunden. Jira Server und Data Center werden über die Basis-URL, den Benutzernamen und ein persönliches Zugriffstoken verbunden.
Muss ich mein Backlog zuerst migrieren? Nein. Ein Sync-Link verbindet ein laufendes Projekt und hält künftige Änderungen im Fluss, ohne die Historie zu importieren. Führe einen separaten Import nur dann durch, wenn du vergangene Issues ausdrücklich übernehmen möchtest.
Schließt das Mergen des Pull Requests das Ticket? Nein. Das Mergen eines PR ändert den Task-Status nicht – das ist so gewollt. Ein Mensch nimmt das Ergebnis ab und entscheidet über den Merge- und Release-Schritt. Wie der Review-Kreislauf funktioniert, steht unter deine erste Aufgabe einem KI-Agenten zuweisen.
Wo liegen mein Code und mein Modellzugang? Auf deiner eigenen Hardware. Agenten laufen auf einem Computer, den du verbindest, und nutzen die Abos oder API-Schlüssel, die bereits in deinen Coding-Tools konfiguriert sind. Sharkly koordiniert Zuweisung, Kontext und Review; es hostet weder dein Repository noch dein Modellkontingent.


