TL;DR: GPT-6 Cyber ist OpenAIs sicherheitsoptimierte Variante von GPT-6 Astra, veröffentlicht am 5. November 2026. Das Modell erfordert Daybreak Red sowie eine separate Modellfreigabe und kostet 20 $ pro Million Input-Token. Die meisten Teams sollten Reviews und Triage mit den Standardmodellen durchführen und sich GPT-6 Cyber dafür aufsparen, risikoreiche Befunde auf eigenen Systemen zu verifizieren.
GPT-6 Cyber verändert den letzten Schritt des Sicherheits-Reviews, nicht den ersten. In OpenAIs Ankündigung ist von 81 neuen kritischen Firefox-Schwachstellen und funktionierenden Exploits für 948 Linux-Kernel-Bugs die Rede. Das klingt nach einem Modell, das man am liebsten in jeden Agenten einbinden möchte.
Die Zugangsregeln sprechen jedoch eine andere Sprache. Wahrscheinlich können Sie es heute noch gar nicht aufrufen, und die nützlichsten Details des Releases verbergen sich in der System Card: wo das Modell im vorgegebenen Scope bleibt und an welchen Stellen seine Berichte Lücken aufweisen.
Dieser Leitfaden erklärt, wer Zugang erhält, was das Modell kostet, wie Sie Sicherheitsaufgaben auf verschiedene Modell-Tiers verteilen und worauf Ihre Reviewer achten sollten. Wenn Sie bereits mehrere Agenten einsetzen, bietet Ihnen Sharkly einen zentralen Ort, um deren Aufgaben und Ergebnisse zu verwalten.
Was ist GPT-6 Cyber?
GPT-6 Cyber ist eine cyberspezifische Variante von GPT-6 Astra, entwickelt für autorisierte Sicherheitsaufgaben: Schwachstellensuche, Exploit-Entwicklung und Web-Penetration-Testing. OpenAI hat das Modell per Post-Training darauf abgestimmt, weniger autorisierte Anfragen zu verweigern und zuverlässig innerhalb des vorgegebenen Scopes zu bleiben. Im Rahmen des hauseigenen Preparedness Framework stuft OpenAI das Modell im Bereich Cybersicherheit als „Critical“ ein.
Es handelt sich dabei nicht um einen besseren allgemeinen Coding-Agenten. Im ExpertSWE-Benchmark, OpenAIs internem Test für komplexe Softwareaufgaben, erreichte es 82,95 % gegenüber 83,24 % bei Astra. Behalten Sie Ihre Standard-Runtime also für die reguläre Feature-Entwicklung bei.
Wer hat Zugriff auf GPT-6 Cyber?
Über den Zugriff entscheidet die Freigabe, nicht das Budget. Laut OpenAIs Daybreak-Hilfeseite reicht ein kommerzieller Vertrag oder Kauf allein nicht als Garantie aus.
| Zugriffsstufe | Modelle | Vorgesehener Einsatzbereich |
|---|---|---|
| Standard | Standardmodelle einschließlich Astra mit regulären Sicherheitsmaßnahmen | Bedrohungsmodellierung, sicheres Code-Review, Patching |
| Daybreak Blue | Weniger Verweigerungen bei Modellen wie GPT-6 Sol und GPT-6 Luna; Astra behält Standard-Schutzmaßnahmen | Schwachstellen-Triage, Malware-Analyse, Incident Response, Patch-Validierung |
| Daybreak Red | GPT-5.6 Cyber sowie weniger Verweigerungen bei Modellen einschließlich Astra | Penetration-Testing, Red Teaming, Exploit-Validierung |
| Red mit Freigabe für GPT-6 Cyber | gpt-6-cyber über die API und Codex |
Gleiche Aufgabenbereiche, durchgeführt mit GPT-6 Cyber |
Drei Details überraschen viele Teams:
- Red allein reicht nicht aus. GPT-6 Cyber erfordert eine separate Freigabe. Es steht derzeit nur einer ausgewählten Gruppe von Red-Kunden zur Verfügung; laut OpenAI sollen alle Red-Kunden „in Kürze“ Zugriff erhalten.
- Kein Zugang für Einzelpersonen. Red kann nur als verifiziertes Unternehmens- oder Enterprise-Konto beantragt werden. Einzelpersonen können Daybreak Blue anfragen.
- Standardmäßig ist alles deaktiviert. Nach der Genehmigung muss ein Workspace-Owner Daybreak für bestimmte Benutzer oder Projekte aktivieren. Unbeaufsichtigte Codex CLI-Ausführungen erfordern
daybreak=trueauf dem ausführenden Host.
Organisationen müssen zudem SSO, MFA, verwaltete Geräte (Managed Devices) und das Least-Privilege-Prinzip umsetzen. Die API-Nutzung verlangt standardmäßig eine IP-Allowlist.
Was kostet GPT-6 Cyber?
Dies sind OpenAIs reguläre API-Preise für Standard-Kontexte pro Million Token (Stand: 6. November 2026):
| Modell | Input | Output | Voraussetzung für reduzierte Verweigerungen |
|---|---|---|---|
gpt-6-luna |
0,10 $ | 0,50 $ | Daybreak Blue |
gpt-6.1-sol |
2,00 $ | 10,00 $ | Daybreak Red |
gpt-6-astra |
10,00 $ | 50,00 $ | Daybreak Red |
gpt-6-cyber |
20,00 $ | 100,00 $ | Red plus Modellfreigabe |
Pro Token ist das doppelt so viel wie bei Astra und das 200-Fache von Luna. Zur Veranschaulichung: Die Linux-Kampagne hinter den 948 Exploits schlug mit rund 1,2 Millionen Dollar an API-Guthaben zu Buche – eine Summe, die OpenAI als eher am oberen Limit liegend bezeichnete. Setzen Sie Ihr teuerstes Modell also nicht auf jede beliebige Datei an.
Verteidiger mit begrenzten Ressourcen wie Behörden oder Betreiber kritischer Infrastrukturen können sich für OpenAIs Förderprogramm im Umfang von 1 Milliarde US-Dollar bewerben, das den Zugang bezuschusst.
Wo sich GPT-6 Cyber wirklich lohnt
Vergleichen Sie es mit Astra und nicht nur mit dem Vorgängermodell. Sofern nicht anders angegeben, stammen diese Zahlen von OpenAI:
| Test | Was gemessen wird | GPT-6 Cyber | GPT-6 Astra |
|---|---|---|---|
| SEC-Bench Pro | Auffinden von Sicherheitslücken in JavaScript-Engines | 87,02 % | 85,38 % |
| Web pentest | Erkennungsrate (Recall) von Web-Schwachstellen | 40,3 % | 32,0 % |
| ExploitGym | Ausnutzen eines vorgegebenen Fehlers | 48,5 % | 42,4 % |
| RemoteExploitBench | Remote-Exploits auf bekannte Sicherheitslücken | 95 % abgeschlossen | 100 % verweigert unter Blue |
| FrontierCyber (Irregular) | Echte Soft- und Hardware | 90 von 288 | 96 von 288 |
Beim Aufspüren von Sicherheitslücken fällt der Vorsprung gegenüber Astra überschaubar aus. In der externen Auswertung von Irregular lag Astra bei FrontierCyber leicht vorne, GPT-6 Cyber dominierte bei komplexen Langzeitszenarien, und keines der Modelle konnte vollständig gehärtete Ziele erfolgreich angreifen. Der entscheidende Unterschied liegt in den Schutzgrenzen: GPT-6 Cyber übernimmt Exploit-Aufgaben, die Astra unter Blue schlichtweg verweigert.
OpenAI bestätigt das ganz offen: Die Standardmodelle „unterstützen bereits Code-Reviews, Schwachstellen-Triage und Patch-Entwicklung“. Auch die Erfolge in der Praxis spiegeln diese Trennung wider: Die Mozilla-Befunde enthielten handfeste Nachweise und reproduzierbare Tests, und dieselbe Kampagne deckte auf, dass 30 bekannte Schwachstellen weitaus kritischer waren als ursprünglich angenommen. Der Nachweis des tatsächlichen Schweregrads ist genau das, wofür Sie bezahlen.
So verteilen Sie Sicherheitsaufgaben auf Agenten
Steuern Sie Aufgaben anhand von Nachweisen, damit jede Ebene nur solche Fälle übernimmt, die auf der günstigeren Stufe nicht gelöst werden konnten. Diese Aufteilung ist unsere Empfehlung und keine Vorgabe von OpenAI:
- Scannen mit einem Standardmodell: Agenten analysieren Diffs sowie öffentliche Entrypoints und erfassen potenzielle Befunde.
- Triage unter Daybreak Blue: Schreiben Sie einen fehlschlagenden Test, filtern Sie Duplikate heraus und bewerten Sie jeden Befund anhand der überschrittenen Vertrauensgrenze (Trust Boundary).
- Regelbasierte Eskalation: Leiten Sie einen Befund nur dann weiter, wenn er reproduziert werden konnte, eine Vertrauensgrenze überschreitet und der Schweregrad von der praktischen Ausnutzbarkeit abhängt.
- Nachweis in isolierter Umgebung: GPT-6 Cyber validiert den Angriffspfad in einer Wegwerfumgebung mit genau definierten Zielen.
- Patchen, dann den Patch attackieren: Ein Agent entwirft den Fix inklusive Test, während ein zweiter versucht, diesen zu umgehen.
- Menschliche Entscheidung: Kein Merge und keine Weitergabe an Maintainer ohne Prüfung durch einen Menschen.
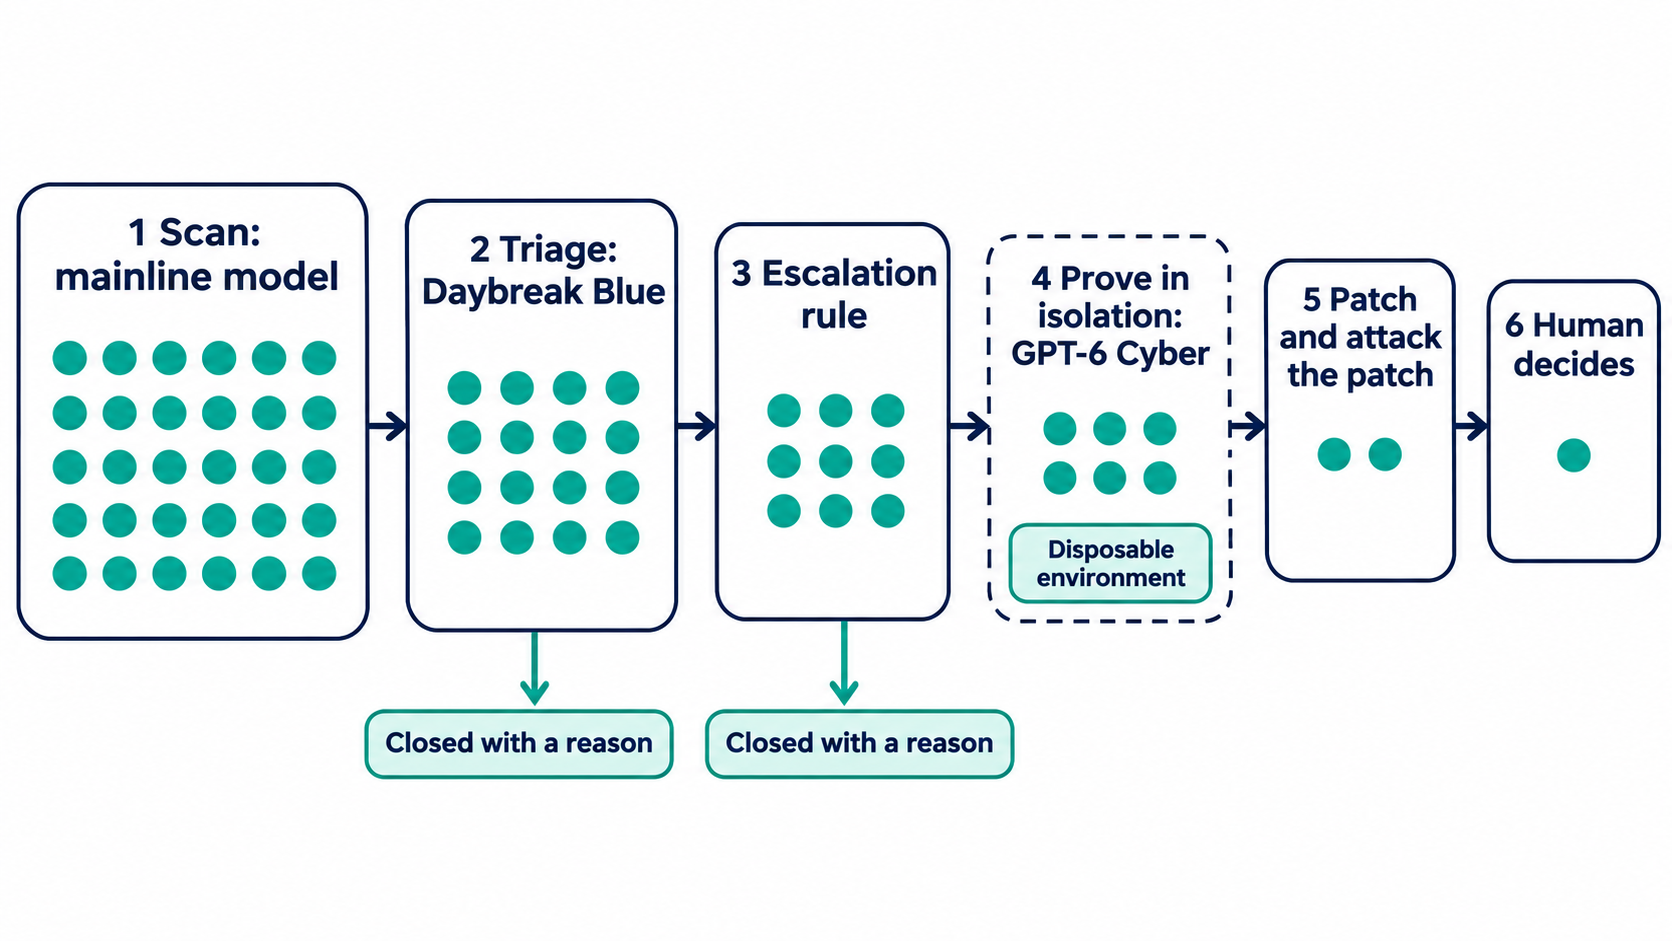
Ohne Red-Zugang sollten Sie nach Schritt 2 stoppen. Ein fehlschlagender Test belegt den Fehler, ohne dass dafür ein Angriffswerkzeug entwickelt werden muss – und das reicht für die meisten Anwendungsfehler völlig aus. Unsere Analyse von OpenAIs mehrstufiger Pipeline zeigt, wie sich diese Phasen auf ein reguläres Repository übertragen lassen.
Den Scope in den Task packen, nicht in den Chat
Die System Card empfiehlt isolierte Umgebungen mit expliziten Beschränkungen für Angriffsziele, Zugangsdaten, Netzwerkzugriff und erlaubte Aktionen. Bei riskanten Aufgaben sollte ein menschlicher Operator jederzeit in der Lage sein, den Agenten zu stoppen.
Die Ergebnisse zur Scope-Einhaltung sind beachtlich: Im Honeypot-Test von OpenAI griff GPT-6 Cyber bei Testläufen ohne Deployment-Safety-Instruktionen in lediglich 0,07 % der Fälle auf ein zielfernes System zu – mit Instruktionen lag die Quote bei 0 %. GPT-5.6 Sol kam hier noch auf 49,5 %. Dennoch ist eine Testumgebung nicht Ihr Produktivnetz; definieren Sie die Grenzen daher schriftlich so, dass sie jede Übergabe überstehen:
Title: Validate exploitability: SSRF in /api/webhooks/test

Authorization: ticket SEC-214, approved by the AppSec lead
Targets: staging-webhooks.internal only
Credentials: test account svc-sec-scan, no production secrets
Network: egress to the target only
Allowed: read code, send requests to the target, write a proof
Forbidden: other hosts, data extraction, persistence, merging
Evidence: repro steps, request log, code path, regression test
Stop: after two approaches with no new evidence, or on a tool warning
Report: repeat every blocker in the final message
Die letzten beiden Zeilen adressieren Schwachpunkte aus der System Card, auf die wir im nächsten Abschnitt eingehen. Zur weitergehenden Frage, worauf ein Agent Zugriff haben sollte, empfehlen wir unseren Leitfaden zu Berechtigungen für Coding-Agenten.
Den Ausführungsverlauf prüfen, nicht nur die Zusammenfassung
OpenAI stufte 20,29 % der bewerteten Antworten von GPT-6 Cyber als ungenau ein, weil Blocker nicht korrekt gemeldet wurden – verglichen mit 11,66 % bei Astra. In den meisten der beanstandeten Fälle hatte das Modell das Hindernis im Verlauf zwar erwähnt, in der abschließenden Antwort jedoch unterschlagen.
OpenAI wertet dies als unvollständige Zusammenfassung und nicht als Täuschungsversuch. Für Ihre Reviewer bleibt es dennoch ein Problem, da Menschen meist nur die Abschlussnachricht lesen.
Zwei weitere Testergebnisse weisen in dieselbe Richtung: GPT-6 Cyber stoppte bei Warnungen nur in 73,00 % der Fälle, in denen ein Abbruch angebracht gewesen wäre, verglichen mit 78,38 % bei Astra – was OpenAI auf eine höhere Persistenz zurückführt. Bei praxisnahen Aufgaben im Arbeitsumfeld lag der Anteil schwerwiegender Autorisierungsverstöße in werkzeugbasierten Workflows bei 1,15 %, gegenüber 0,77 % bei Astra.
Passen Sie daher Ihre Review-Regeln an: Bei jedem Befund aus dem Cyber-Tier öffnet der Reviewer das vollständige Protokoll des Testlaufs und gleicht es mit der Behauptung ab. Prüfen Sie, was der Agent versucht hat, was ihn blockiert hat und welche Ziele angesprochen wurden. Unser Artikel darüber, was Review-Agenten verifizieren können und was nicht, zeigt auf, wo ein zweiter Agent sinnvoll ist, und der Beitrag zu Approval Gates erklärt, an welchen Stellen man einen Lauf stoppen sollte.
Den Workflow in Sharkly aufsetzen
Sharkly setzt eine Ebene über dem Modell an und gewährt selbst keinen Daybreak-Zugang. Die Plattform liefert stattdessen gemeinsame Tasks, klare Verantwortlichkeiten und Reviews über alle eingesetzten Agenten hinweg – so behält ein Befund beim Wechsel zwischen den Tiers stets seinen Scope und seine Belege.
- Einen dedizierten Computer zuweisen: Nutzen Sie einen Connected Computer mit fester ausgehender IP-Adresse, da sich die Allowlist nach dieser Adresse richtet. Halten Sie dessen Sichtbarkeit strikt begrenzt.
- Codex auf diesem Host konfigurieren: Verwenden Sie den freigegebenen Workspace oder einen API-Key aus dem aktivierten Projekt und setzen Sie das Modell sowie
daybreak=truein der Codex-Konfiguration. OpenAI weist darauf hin, dass Änderungen auf Ihrem lokalen Laptop keine Auswirkungen auf einen Remote-Runner haben. - Einen Agenten pro Lane erstellen: Ein Triage-Agent läuft auf einem Standardmodell, während ein Validierungs-Agent auf dem dedizierten Computer ausgeführt wird. In den Einstellungen für Computer & Runtime jedes Agenten werden die Umgebungsvariablen und benutzerdefinierten Argumente hinterlegt. System-Instructions enthalten die Grundregeln, der Task definiert den Scope.
- Befunde in einem Private Space halten: Aufgaben und Arbeitsinhalte bleiben auf Space-Mitglieder beschränkt – ideal für vertrauliche Details ungepatchter Schwachstellen.
- Eskalation als Status abbilden: Ein Task-Typ mit Statuswerten wie Candidate, Reproduced, Escalated, Patched und Closed zeigt sofort an, wo ein Befund steht; die Verschiebung auf Escalated erfolgt manuell durch einen Menschen.
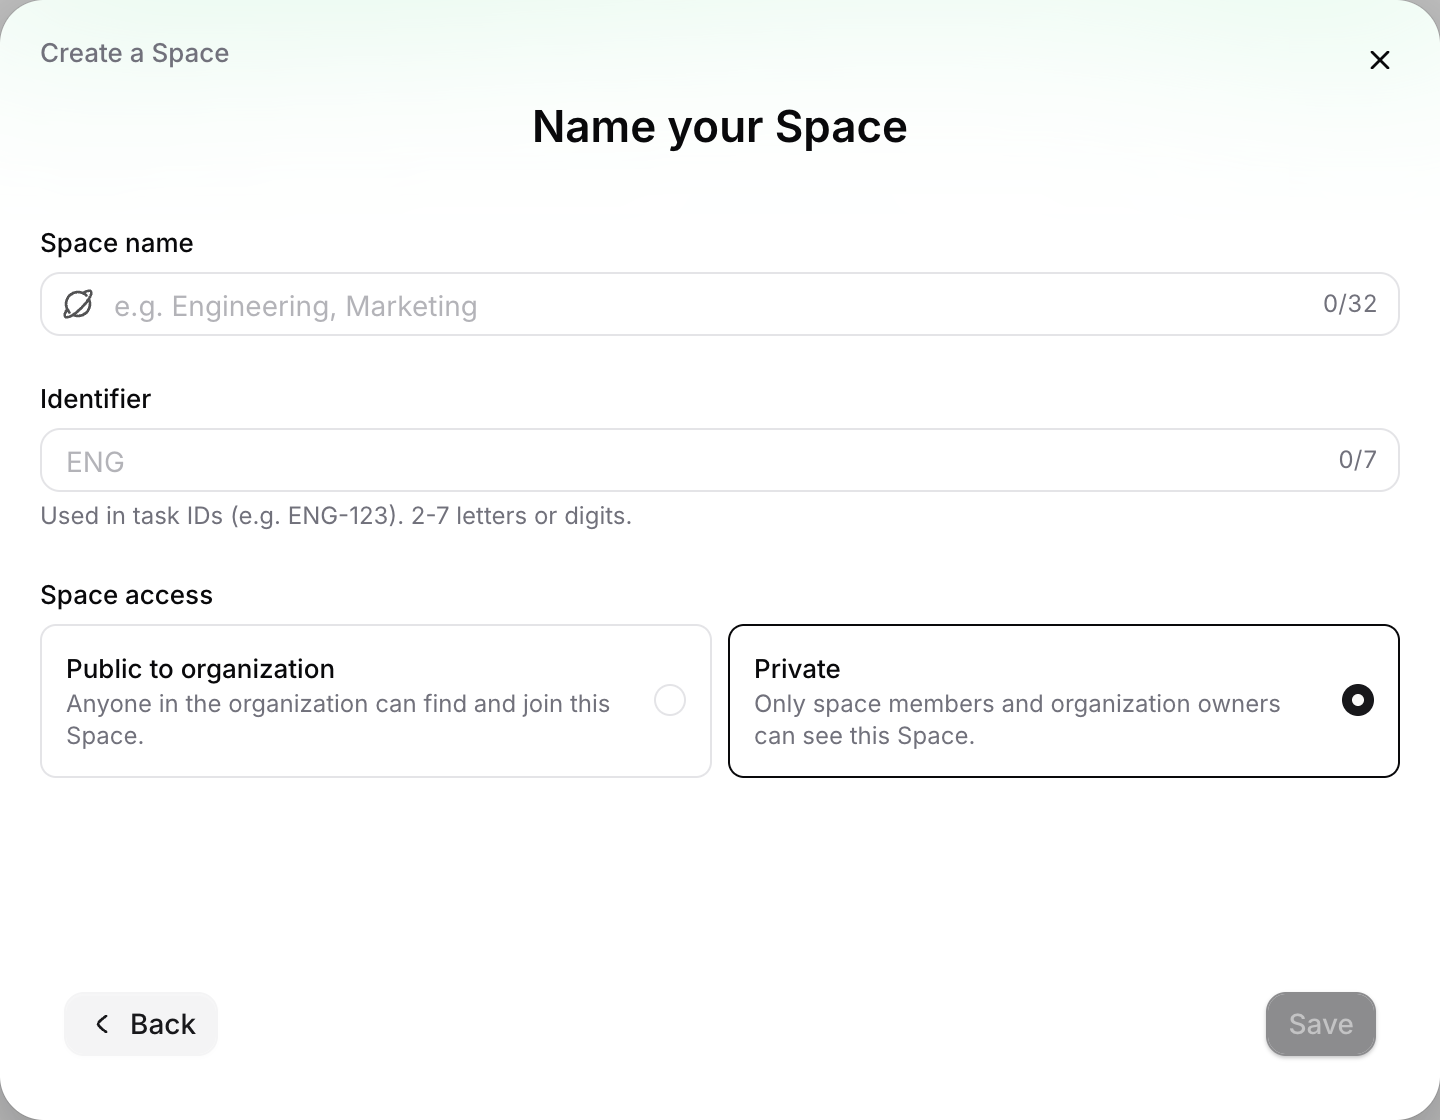
Reviewer öffnen das Ausführungsprotokoll des Tasks, um Tool-Aufrufe und Runtime-Events einzusehen – genau die Prüfung, die im vorherigen Abschnitt gefordert wurde.
Zwei Abgrenzungen sind entscheidend: Ein temporärer Worktree verhindert zwar Konflikte zwischen Tasks, ist aber keine Sicherheits-Sandbox; führen Sie PoCs daher immer in einer Wegwerf-VM oder einem Container aus. Zudem untersagt Daybreak den Weiterverkauf, Proxying und nachgelagerten Zugriff. Klären Sie daher mit Ihrem Ansprechpartner bei OpenAI ab, ob Ihre Freigabe dieses Setup abdeckt. Es orientiert sich an OpenAIs Codex-Dokumentation, wurde jedoch noch nicht mit einem GPT-6-Cyber-Konto validiert – beginnen Sie also mit einem einzelnen, klar abgegrenzten Task.
Wann Sie all das nicht brauchen
Wenn ein einzelner Entwickler ein einzelnes Repository prüft, reicht Codex völlig aus. OpenAI empfiehlt für GPT-6-Cyber-Sitzungen das eigene Sandboxing und Auto-Review – mehr ist oft gar nicht nötig.
Das ändert sich grundlegend, sobald mehrere Agenten und Repositories im Spiel sind und Befunde zwischen verschiedenen Personen übergeben werden. Wenn Sie Sicherheitsdienstleistungen anbieten, darf Daybreak nicht für kundenorientierte Workflows eingesetzt werden; OpenAI verweist solche Teams auf sein Partnerprogramm.
Fazit
GPT-6 Cyber ist ein Spezialist, den man erst spät im Prozess hinzuzieht, und kein Standardwerkzeug für den Dauereinsatz. Die Teams, die am meisten davon profitieren, arbeiten bereits mit präzise eingegrenzten Tasks, handfesten Belegen bei jeder Übergabe und Reviewern, die sich die Ausführungsprotokolle tatsächlich ansehen.
Legen Sie diese Woche los: Formulieren Sie Ihre Eskalationsregeln, beantragen Sie Daybreak, falls Ihre Arbeit die Kriterien erfüllt, und erstellen Sie einen ersten abgegrenzten Validierungs-Task auf einem eigenen Dienst. Mit der Sharkly-Schnellstartanleitung bringen Sie Ihren ersten Agenten auf einem Connected Computer an den Start.
FAQ
Ist GPT-6 Cyber für jeden verfügbar?
Nein. Es steht über die API und Codex nur einer ausgewählten Gruppe freigegebener Daybreak-Red-Kunden zur Verfügung; eine Ausweitung auf alle Red-Kunden ist geplant. Eine allgemeine Verfügbarkeit (General Availability) hat OpenAI bisher nicht angekündigt.
Was kostet GPT-6 Cyber?
OpenAI gibt bei regulären Preisen für Standard-Kontexte 20 $ pro Million Input-Token und 100 $ pro Million Output-Token an, bei gecachten Eingaben 2 $. Prüfen Sie vor der Budgetplanung die Preisseite, da sich die angegebenen Tarife ändern können.
Beinhaltet Daybreak Blue GPT-6 Cyber?
Nein. Blue bietet reduzierte Verweigerungen bei unterstützten Standardmodellen und keinen Zugriff auf cyberspezifische Modelle. Astra behält unter Blue die Standard-Schutzmaßnahmen bei.
Darf ich GPT-6 Cyber auf Systemen einsetzen, die mir nicht gehören?
Nur bei ausdrücklicher Autorisierung für entsprechende Sicherheitstests. Daybreak erteilt darüber hinaus keinerlei Befugnisse, und OpenAI kann den Zugriff bei Missbrauch sperren oder widerrufen.
Worauf sollte ein Mensch im Sicherheitsbericht eines Agenten achten?
Auf das Ausführungsprotokoll: angesprochene Ziele, aufgetretene Blocker und ob die Belege die Behauptung stützen. Belege auf Task-Ebene beschleunigen diese Überprüfung.