
Anthropic gibt an, dass Claude Opus 5.5 40 % günstiger im Betrieb ist als Opus 5. Irgendjemand in deinem Team hat die naheliegende Rechnung schon aufgestellt: gleiches Budget, also etwa 1,7-mal so viele Agent-Durchläufe, also grob 1,7-mal so viel fertiggestellte Arbeit. Diese Rechnung ist arithmetisch korrekt und operativ falsch, und in der Woche, in der sie in die Tat umgesetzt wird, füllt sich dein Board mit abgeschlossenen Runs, die niemand gelesen hat.
Die Begrenzung dafür, mehr Agents parallel laufen zu lassen, war nie die Modellrechnung. Sie war die Kapazität einer Person, einen Diff zu lesen, zu verstehen, was ein Agent entschieden hat, und das Ergebnis abzunehmen. Ein Preisnachlass ändert an dieser Zahl nichts. Er erhöht nur die Geschwindigkeit, mit der Arbeit dort ankommt.
TL;DR
Ein Review-Ceiling ist die Anzahl abgeschlossener Agent-Runs, die ein Team an einem Tag tatsächlich lesen, beurteilen und abnehmen kann, und sie wird von Menschen bestimmt, nicht von Tokens. Günstigere Modelle erhöhen die Ankunftsrate an diesem Ceiling und lassen das Ceiling selbst unverändert, sodass der erste sichtbare Effekt eines Preisnachlasses eine längere Warteschlange ist – nicht ein schnelleres Release. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, übertragen Befugnisse und nehmen das Ergebnis ab. Die sinnvolle Reaktion besteht darin, die Parallelität an den Reviewern auszurichten statt am Budget, und Agent-Arbeit, die zu einem einzigen prüfbaren Ergebnis konvergiert, von Agent-Arbeit zu trennen, die in viele Ergebnisse auffächert. Sharkly hält Kontext, Fortschritt, Blocker, Ergebnisse und die menschliche Prüfung auf der Task sichtbar – von der Anfrage bis zum Release. Genau das macht die Warteschlange überhaupt erst zählbar.
Was tatsächlich günstiger geworden ist
Zwei Labs haben am 22.09.2026 ausgeliefert. Hier ist der Teil davon, der deine Rechnung betrifft.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| API-ID | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input pro 1 Mio. Tokens | $5 | $4 | $2 | $0.10 |
| Output pro 1 Mio. Tokens | $25 | $20 | $10 | $0.50 |
| Gecachter Input | k. A. | $0.20 Lesevorgang, $5 Schreibvorgang | 90 % Rabatt auf Lesevorgänge | 90 % Rabatt auf Lesevorgänge |
Anthropic gibt an, dass Opus 5.5 40 % günstiger im Betrieb ist als Opus 5 und etwa 30 % schnelleren Output liefert. Die oben genannten Listenpreise liegen 20 % unter dem Token-Preis von Opus 5 – das ist unsere eigene Rechnung aus zwei veröffentlichten Zahlen und eine separate Aussage gegenüber den 40 %. OpenAI gibt an, dass Sol und Luna jeweils 50 % günstiger sind als die Aktionspreise von GPT-5.6, und „Aktionspreis" ist OpenAIs eigenes Wort, sodass diese Schlagzeile an einem rabattierten Preis gemessen wird, nicht an einem Listenpreis.
Die Kosten pro abgeschlossener Aufgabe haben sich stärker bewegt als die Kosten pro Token. Auf AutomationBench 1.0.6 meldet OpenAI für GPT-6 Sol mit sehr hohem Reasoning 33,2 % bei $0,27 pro Aufgabe, gegenüber Claude Opus 5 mit maximalem Reasoning bei 26,9 % und dem 11,1-Fachen der Kosten von Sol. Auf DeepSWE 1.1 gibt OpenAI für GPT-6 Luna mit maximalem Reasoning 66,6 % an und 93 % günstiger pro Aufgabe als Opus 5.
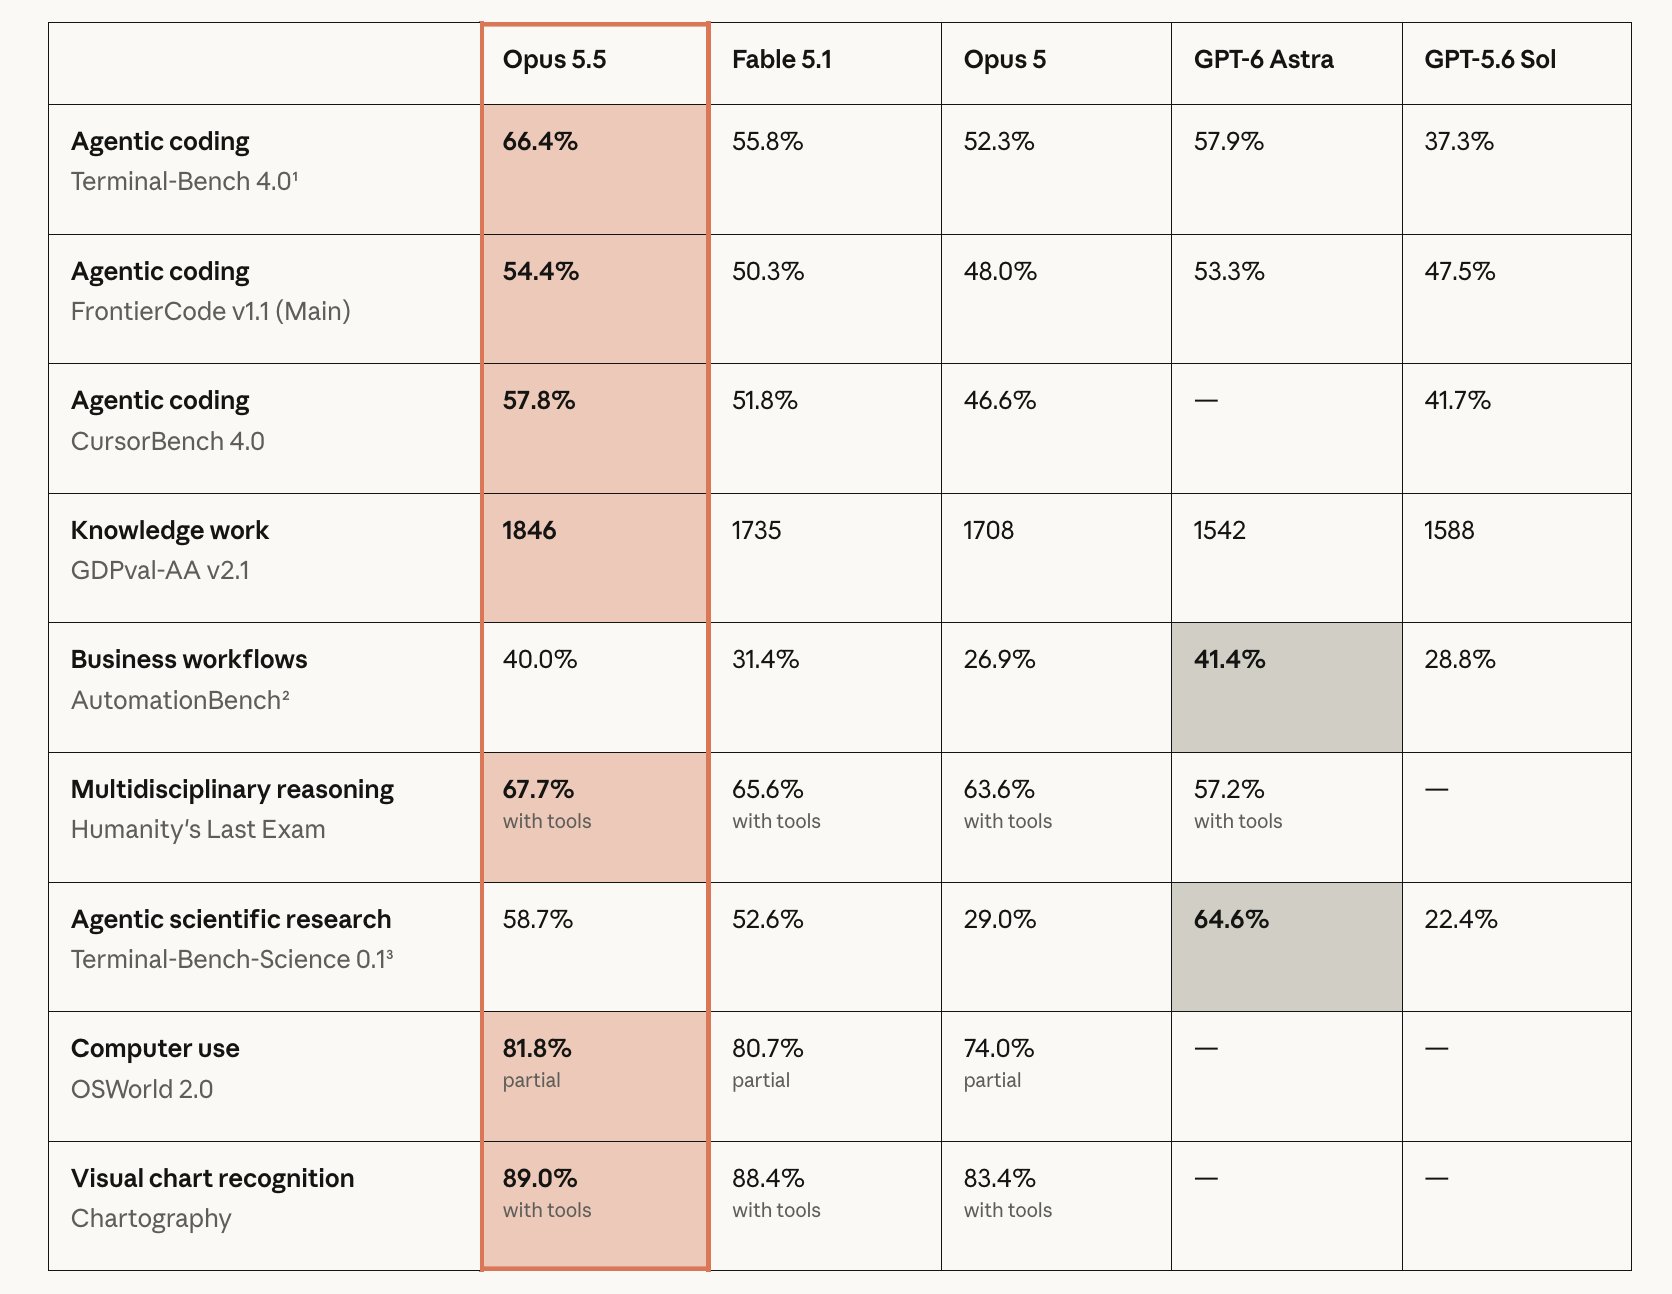
Der Preis eines Versuchs ist also stark gefallen – bei zwei Anbietern an einem einzigen Tag. Sonst hat sich an deiner Woche nichts geändert.
Die Rechnung, die diese Woche alle aufgestellt haben
Halte die Ausgaben konstant und teile. Bei 40 % geringerem Betriebsaufwand kauft derselbe Monatsbetrag etwa 1,67-mal so viele Opus-5.5-Runs wie zuvor Opus-5-Runs. Leite die Routine-Hälfte der Arbeit stattdessen an Luna weiter, verliert der Multiplikator seinen Reiz, denn bei $0,10 und $0,50 pro Million Tokens ist die Modell-Zeile nicht mehr das, worauf du budgetierst.
Jetzt mach die zweite Rechnung, die darüber entscheidet, ob überhaupt etwas davon ausgeliefert wird. Nimm die Anzahl abgeschlossener Runs, die einer deiner Entwickler an einem Tag ordentlich lesen kann. Nicht überfliegen, nicht bei grünem Häkchen abnicken: den Diff lesen, verstehen, was der Agent entschieden hat, und die Verantwortung dafür übernehmen. Was diese Zahl auch ist – sie war am 21.09.2026 dieselbe und sie wird auch im nächsten Quartal dieselbe sein. Die Arithmetik der Review-Kapazität geht schon ohne Preisnachlass schlecht aus, und ein Preisnachlass verändert nur die Input-Seite.
Ein Preisnachlass ist keine Kapazitätssteigerung. Er verändert nur, wie günstig es ist, etwas zu erzeugen, das trotzdem einen Menschen erfordert.
Der Hinweis: Die Kosten waren nicht das, was dich gebremst hat
Wären die Modellkosten die bindende Einschränkung, hätten Teams längst die günstigste Konfiguration gefahren, die funktioniert. Haben sie aber nicht. OpenAIs eigene Zahlen sagen, dass der Median-Forscher in seiner Organisation mehr als $600 pro Tag an Inferenz zu API-Preisen verbraucht und das 90. Perzentil $7.000 pro Tag. Die veröffentlichte Benchmark-Tabelle zeigt Teams, die bewusst eine 11,1-mal teurere Konfiguration pro Aufgabe nutzen, um eine niedrigere Punktzahl zu bekommen, weil ein Ergebnis, dem du traust, mehr wert ist als eines, das du zweimal prüfen musst.
Das ist die Form der eigentlichen Einschränkung. Menschen zahlen einen großen Aufpreis für Output, der pro Einheit weniger menschliche Prüfung braucht. Die knappe Ressource, die gekauft wird, ist Aufmerksamkeit, nicht Compute – und sie wurde schon immer zu einem steilen Aufpreis gekauft.
Was bedeutet, dass ein Preisnachlass asymmetrisch wirkt. Er macht die erzeugende Seite günstiger und lässt die abnehmende Seite genau dort, wo sie war.
Fan-out, das konvergiert, und Fan-out, das auf dem Board landet
Hier ist die Unterscheidung, die günstige Modelle wirklich nützlich statt still teuer macht – und es ist die, die die meisten Teams überspringen.
Manche Parallelität konvergiert. Drei Agents versuchen dieselbe Migration in isolierten Worktrees, eine Test-Suite und ein leitender Agent wählen die, die durchläuft, und ein einziges Ergebnis erreicht einen Menschen. Die Kosten haben sich verdreifacht und die Review-Last hat sich nicht bewegt. Hier kauft dir ein Preisnachlass echten Durchsatz, und hier lohnt es sich, dein Setup wegen der neuen Ökonomie umzustellen.
Manche Parallelität divergiert. Zehn Agents übernehmen zehn unzusammenhängende Tasks und produzieren zehn Diffs, zehn Änderungszusammenfassungen und zehn Abnahmeentscheidungen. Die Kosten sind dieselben zehn Runs. Die Review-Last ist zehnmal die Aufmerksamkeitseinheit einer Person.
| Konvergierendes Fan-out | Divergierendes Fan-out | |
|---|---|---|
| Beispiel | 3 Versuche für eine Migration, der beste gewinnt | 10 Tasks, 10 Assignees, 10 Diffs |
| Was günstigere Modelle bringen | Mehr Versuche, höhere Chance, dass einer gut ist | Mehr fertige Arbeit, die wartet |
| Erzeugte Review-Elemente | 1 | 10 |
| Allein aufgrund des Preises sicher skalierbar | Ja | Nein |
Nutze günstige Modelle, um konvergierendes Fan-out so weit auszudehnen, wie deine Geduld für Wiederholungsversuche reicht. Nutze sie nicht, um divergierendes Fan-out über deine Reviewer hinaus auszudehnen, egal wie erschwinglich die Runs geworden sind. Das ist das ehrliche Entscheidungspaar, und die zweite Hälfte davon ist die, die Geld kostet, wenn man sie ignoriert.
Was du stattdessen ändern solltest – nicht das Budget
Begrenze die Parallelität an den Reviewern, nicht an den Ausgaben. Schreib die Regel dort auf, wo die Crew sie sehen kann: Offene Tasks, die auf menschliche Abnahme warten, dürfen die Anzahl der Reviewer in der Schicht multipliziert mit der Anzahl der Reviews, die eine von ihnen pro Schicht schafft, nicht überschreiten. Deine zwei Zahlen, nicht unsere. Wenn die Grenze erreicht ist, beanspruchen Agents keine neuen Tasks mehr, obwohl das Budget es erlauben würde. Eine schriftliche Routing-Regel schlägt hier jede Präferenz, denn eine Präferenz verliert still gegen einen günstigeren Preis.
Mach „wartet auf einen Menschen" zu einem sichtbaren Zustand. Ein Run, der fertig wurde, und ein Run, der angehalten hat, um etwas zu fragen, sehen von außen identisch aus, und beide sind unsichtbar, wenn die einzige Aufzeichnung ein Terminal ist. Ausführung, Blocker, Ergebnisse und Folge-Diskussionen sollten auf die Task-Timeline zurückfließen, damit die Warteschlange etwas ist, das du zählen kannst, statt ein Gefühl, das dich freitags beschleicht.
Kalkuliere das Review, nicht die Tokens. Kosten-Tracking über Agents hinweg, das Dollar pro Run ausweist, beantwortet eine Frage, die nicht mehr bindet. Die Zahl, die auf ein Dashboard gehört, sind menschliche Minuten pro abgenommener Änderung. Ist sie gestiegen, nachdem du auf ein günstigeres Modell umgestiegen bist, dann ist das günstigere Modell teurer.
Gib einen Teil der Ersparnis für Nachweise aus. Ein Run, der Typecheck, Testergebnisse, Änderungszusammenfassung und bekannte Grenzen mitliefert, kostet mehr Tokens und weniger Aufmerksamkeit. Bei $0,20 pro Million gecachter Input-Lesevorgänge auf Opus 5.5 und 90 % Rabatt auf gecachte Lesevorgänge bei GPT-6 ist der zusätzliche Verifizierungsdurchlauf nahezu kostenlos – und er kauft dir die Ressource zurück, die tatsächlich knapp war.
Wo das die Woche hinterlässt
Zwei Labs haben am selben Tag den Preis eines Versuchs gesenkt, und eines davon hat gegen ein Modell gebenchmarkt, das Stunden später abgelöst wurde. Keines von beiden hat etwas ausgeliefert, das dir einen Diff liest. Menschliche Verantwortung für die Arbeit ist der Teil, der nicht 40 % günstiger geworden ist, und er ist der Teil, der entscheidet, was in Produktion geht.
Wenn du bereits mehrere Coding-Agents laufen lässt, ist der sinnvolle Schritt diese Woche nicht, die Parallelität zu erhöhen. Er besteht darin, herauszufinden, wo dein Review-Ceiling tatsächlich liegt, und die Parallelität dann daran anzupassen. Sharkly gibt dir einen Ort, an dem du die Runs, die Blocker, die Ergebnisse und die Warteschlange der Arbeit siehst, die darauf wartet, dass ein Mensch sie abnimmt.


