
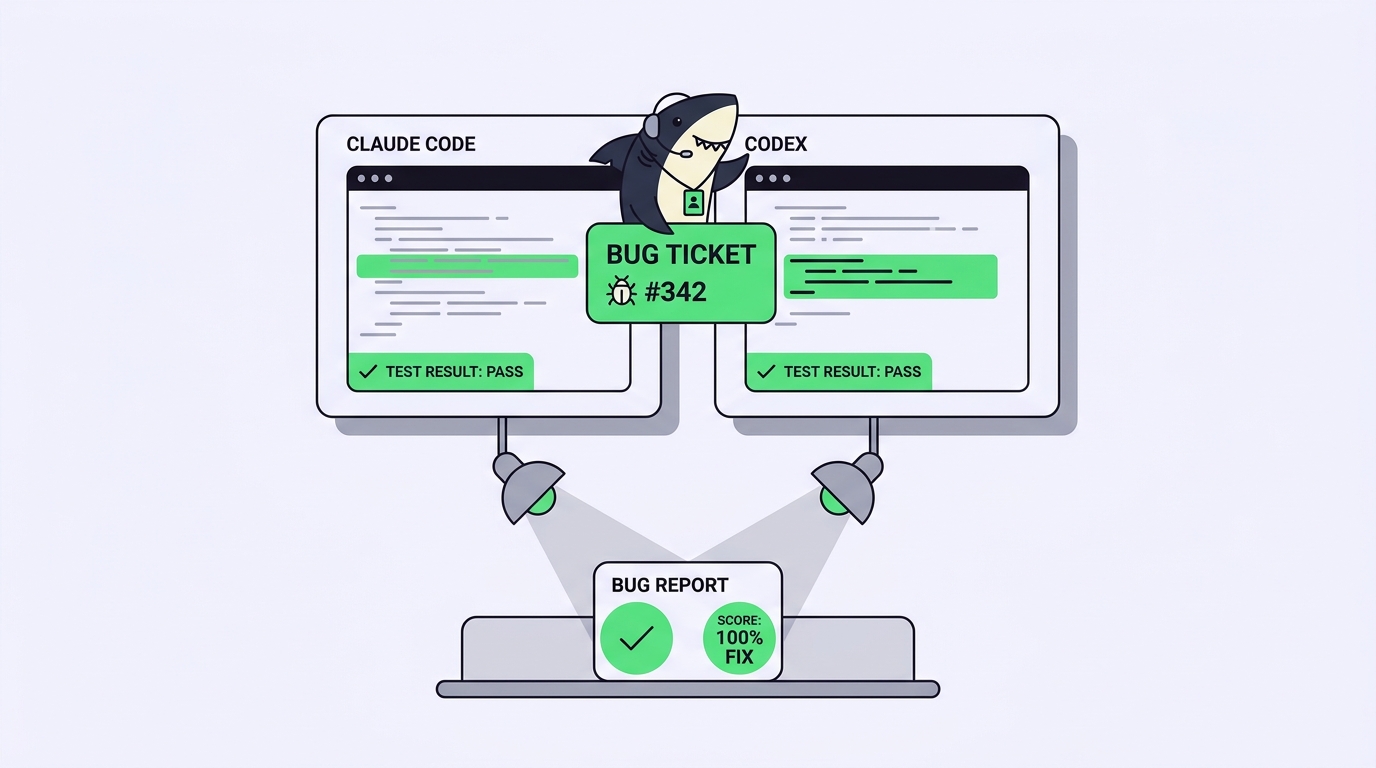
Du hast einen echten Bug offen und zwei Agents, die ihn beheben könnten: Claude Code und Codex. Die Tabs sind voll mit Meinungen darüber, welcher der beiden schlauer ist, und keine davon sagt dir, welchen du heute auf diesen Bug in diesem Repository ansetzen sollst. Öffentliche Benchmark-Zahlen tun das auch nicht. Ein Leaderboard misst eine feste Menge von Open-Source-Problemen mit einem abgestimmten Harness. Dein Bug ist ein privates Problem: deine Konventionen, dein flakiger Test, das Modul, das nur eine Person versteht.
Die ehrliche Antwort auf die Frage „Claude Code oder Codex“ lautet: Setze beide unter denselben Bedingungen auf denselben Bug an und lies, was jeder zurückliefert. Das klingt einfach und wird schnell zum Chaos: zwei Agents, die dieselben Dateien bearbeiten, zwei Terminals, zwei Sätze Testergebnisse und keine saubere Möglichkeit, sie direkt nebeneinander zu vergleichen. Der Vergleich, den du willst, dreht sich um die Agents. Die Arbeit, die vor dir liegt, besteht darin, sie daran zu hindern, sich gegenseitig ins Gehege zu kommen.
Genau diese Kollision beseitigt Sharkly. Sharkly ist eine All-in-One-Plattform für Agent-Steuerung und -Management: Du weist dieselbe Task zwei verschiedenen Agents zu, jeder läuft auf einem verbundenen Computer in seinem eigenen isolierten Worktree, und jeder Run liefert seinen Diff, seine Testergebnisse und sein Review an einen Ort zurück. Sharkly ist kein Ersatz für Claude Code oder Codex und kein Benchmark-Harness. Es ist die Ebene, die ein faires Head-to-Head möglich macht, ohne ein zweites Terminal zu öffnen. Dieser Leitfaden führt dich durch die Methode, eine Bewertungsrubrik für einen einzelnen Bug und die Frage, wo welcher Agent tendenziell gewinnt.
Die kurze Antwort
Um Claude Code und Codex ehrlich zu vergleichen, gib beiden denselben Bug, denselben Start-Commit und denselben Abnahmetest – jeweils in ihrer besten Konfiguration. Dann bewerte, was zurückkommt: Besteht der Fix, bleibt der Diff im Rahmen, und wie lange brauchst du, um die Änderung zu reviewen? Der Agent, der einen Bug gewinnt, hat einen Bug gewonnen. Wende die Methode auf mehrere Bugs an, bevor du dem Urteil vertraust.
Warum „Welcher ist besser?“ die falsche Frage ist
Claude Code und Codex sind beide terminal-zentrierte Coding-Agents. Sie lesen dein Repository, bearbeiten Dateien, führen Befehle aus und melden sich zurück. Sie unterscheiden sich darin, wie du sie konfigurierst und wie sie sich unter Druck verhalten, aber keiner von beiden ist bei der Arbeit, die einen normalen Sprint füllt, durchgängig vorn.
Ein einzelnes globales Ranking verdeckt genau den Teil, der dich interessiert. „Welcher ist besser“ presst alles in eine Zahl, die den Kontakt mit deiner Codebasis nicht übersteht. „Welcher ist bei dieser Art von Bug, in meinem Repo, zum Zeitpunkt des Reviews besser?“ lässt sich beantworten und ist die einzige Variante, die den Aufwand wert ist. Wenn du noch entscheidest, welches Modell jeder Agent ausführen soll, ist die Zuordnung von Modellen zu Agent-Rollen eine bessere erste Frage als jedes Leaderboard.
Beide auf denselben Bug ansetzen: eine Methode, der du vertrauen kannst
Ein fairer Vergleich hält alles konstant außer dem Agenten. Vier Regeln sorgen dafür.
- Nimm einen echten Bug, nicht einen Spielzeug-Prompt. Wähle einen überschaubaren Defekt aus deinem Backlog, für den es einen Abnahmetest gibt, den du ausführen kannst, und einen Diff, den du in ein paar Minuten liest. Formuliere ihn so, wie es dein Tracker tun würde: eine Task wie
SH-312: fix the timezone drift in the invoice export. „Bau eine Todo-App“ sagt dir nichts über deinen Code. - Gib beiden dieselbe Eingabe. Gleiche Task-Beschreibung, gleicher Start-Commit, gleiche Abnahmekriterien. Wenn Claude Code einen reicheren Prompt bekommt als Codex, misst du deinen Prompt, nicht den Agenten.
- Setze jeden in seiner besten Konfiguration ein. Gib Claude Code seine
CLAUDE.md, gib Codex seineAGENTS.mdund seine Config, und gib jedem die Berechtigungen und das Modell, die die eigene Dokumentation empfiehlt. Einen gut eingerichteten Agenten mit einem nackten zu vergleichen, misst nur, welchen du dir die Mühe gemacht hast zu konfigurieren. - Trenne die beiden Runs voneinander. Jeder Agent braucht seine eigene Arbeitskopie. Zwei Agents in einem Checkout überschreiben sich gegenseitig, und du verbringst den Nachmittag damit, einen Merge zu entwirren, statt zwei saubere Versuche zu lesen. Genau dafür sind isolierte Worktrees da.
Führe die beiden Versuche aus und wirf anschließend den Verlierer-Branch weg. Du behältst den Fix, dem du vertraust, und den Beleg dafür, warum.
Eine Bewertungsrubrik für einen einzelnen Bugfix
„Hat es bestanden“ ist genau ein Bit an Information. Ob ein Fix wirklich taugt, entscheidet sich an mehr als daran – und wenn du die Rubrik aufschreibst, bevor du hinschaust, bleibt der Vergleich ehrlich.
| Was du bewertest | Die Frage, die es beantwortet | Warum es zählt |
|---|---|---|
| Korrektheit | Besteht der Abnahmetest, und bricht nichts anderes? | Der Mindeststandard. Ein Agent, der „fertig“ ausgibt, hat nichts bestanden. |
| Scope-Disziplin | Hat der Diff nur das angefasst, was der Bug erforderte? | Ein Fix, der vier unbeteiligte Dateien umschreibt, kostet beim Review mehr, als er einbringt. |
| Testqualität | Hat der Agent einen Test hinzugefügt oder aktualisiert, der die Regression abfangen würde? | Ein Fix ohne Test ist ein Fix, den du erneut machen wirst. |
| Review-Zeit | Wie lange hast du gebraucht, um der Änderung zu vertrauen? | Oft der eigentliche Engpass – und leicht zu ignorieren, bis er deinen Nachmittag frisst. |
| Ehrlichkeit | Hat der Agent seine eigenen Grenzen und Annahmen benannt? | Vertrauen kannst du dem Run, der dir sagt, was er nicht überprüft hat. |
Bewerte beide Versuche nach denselben fünf Kriterien, am selben Bug, und der Gewinner ist keine Geschmacksfrage mehr. Die Review-Zeit verdient dabei besonderes Gewicht: Zwei Agents können beide in zwanzig Minuten fertig sein und trotzdem je eine Stunde zum Prüfen kosten. Diese Stunde ist oft die eigentliche Grenze dafür, wie viel Agent-Arbeit ein Team aufnehmen kann.
Wo jeweils welcher tendenziell gewinnt
Hier stehen keine erfundenen Zahlen, nur worauf du achten solltest. Claude Code stützt sich auf seinen Projekt-Speicher CLAUDE.md und bleibt bei Änderungen über mehrere Dateien eher innerhalb der Repository-Konventionen, was sich bei Refactorings über mehrere Module zeigt. Codex fühlt sich in einem sandboxed, konfigurationsgetriebenen Setup wohl und strukturiert neuen Code samt Tests oft sauber, was sich bei überschaubaren Fixes zeigt. Beide schweifen stärker ab, je größer das Repo wird, und beide überreichen dir selbstbewusst eine Änderung, die nicht besteht. Teste deinen eigenen Bug, bevor du irgendetwas davon als geklärt betrachtest.
Und hier kommt der ehrliche Teil, den die meisten Vergleiche auslassen. Wenn du nur einen Agenten nutzt und in einem einzigen Terminal lebst, brauchst du dafür keine Plattform. Eine gut eingestellte Claude-Code-Session in einem Worktree oder ein einzelner Codex-Run genügt, und du kannst den Diff selbst überfliegen. Die Rechnung ändert sich in dem Moment, in dem du zwei Agents vergleichst, und das bei mehr als einem Bug, und die Ergebnisse in einer Form haben willst, die auch jemand anderes lesen kann.
Das Head-to-Head in Sharkly durchführen
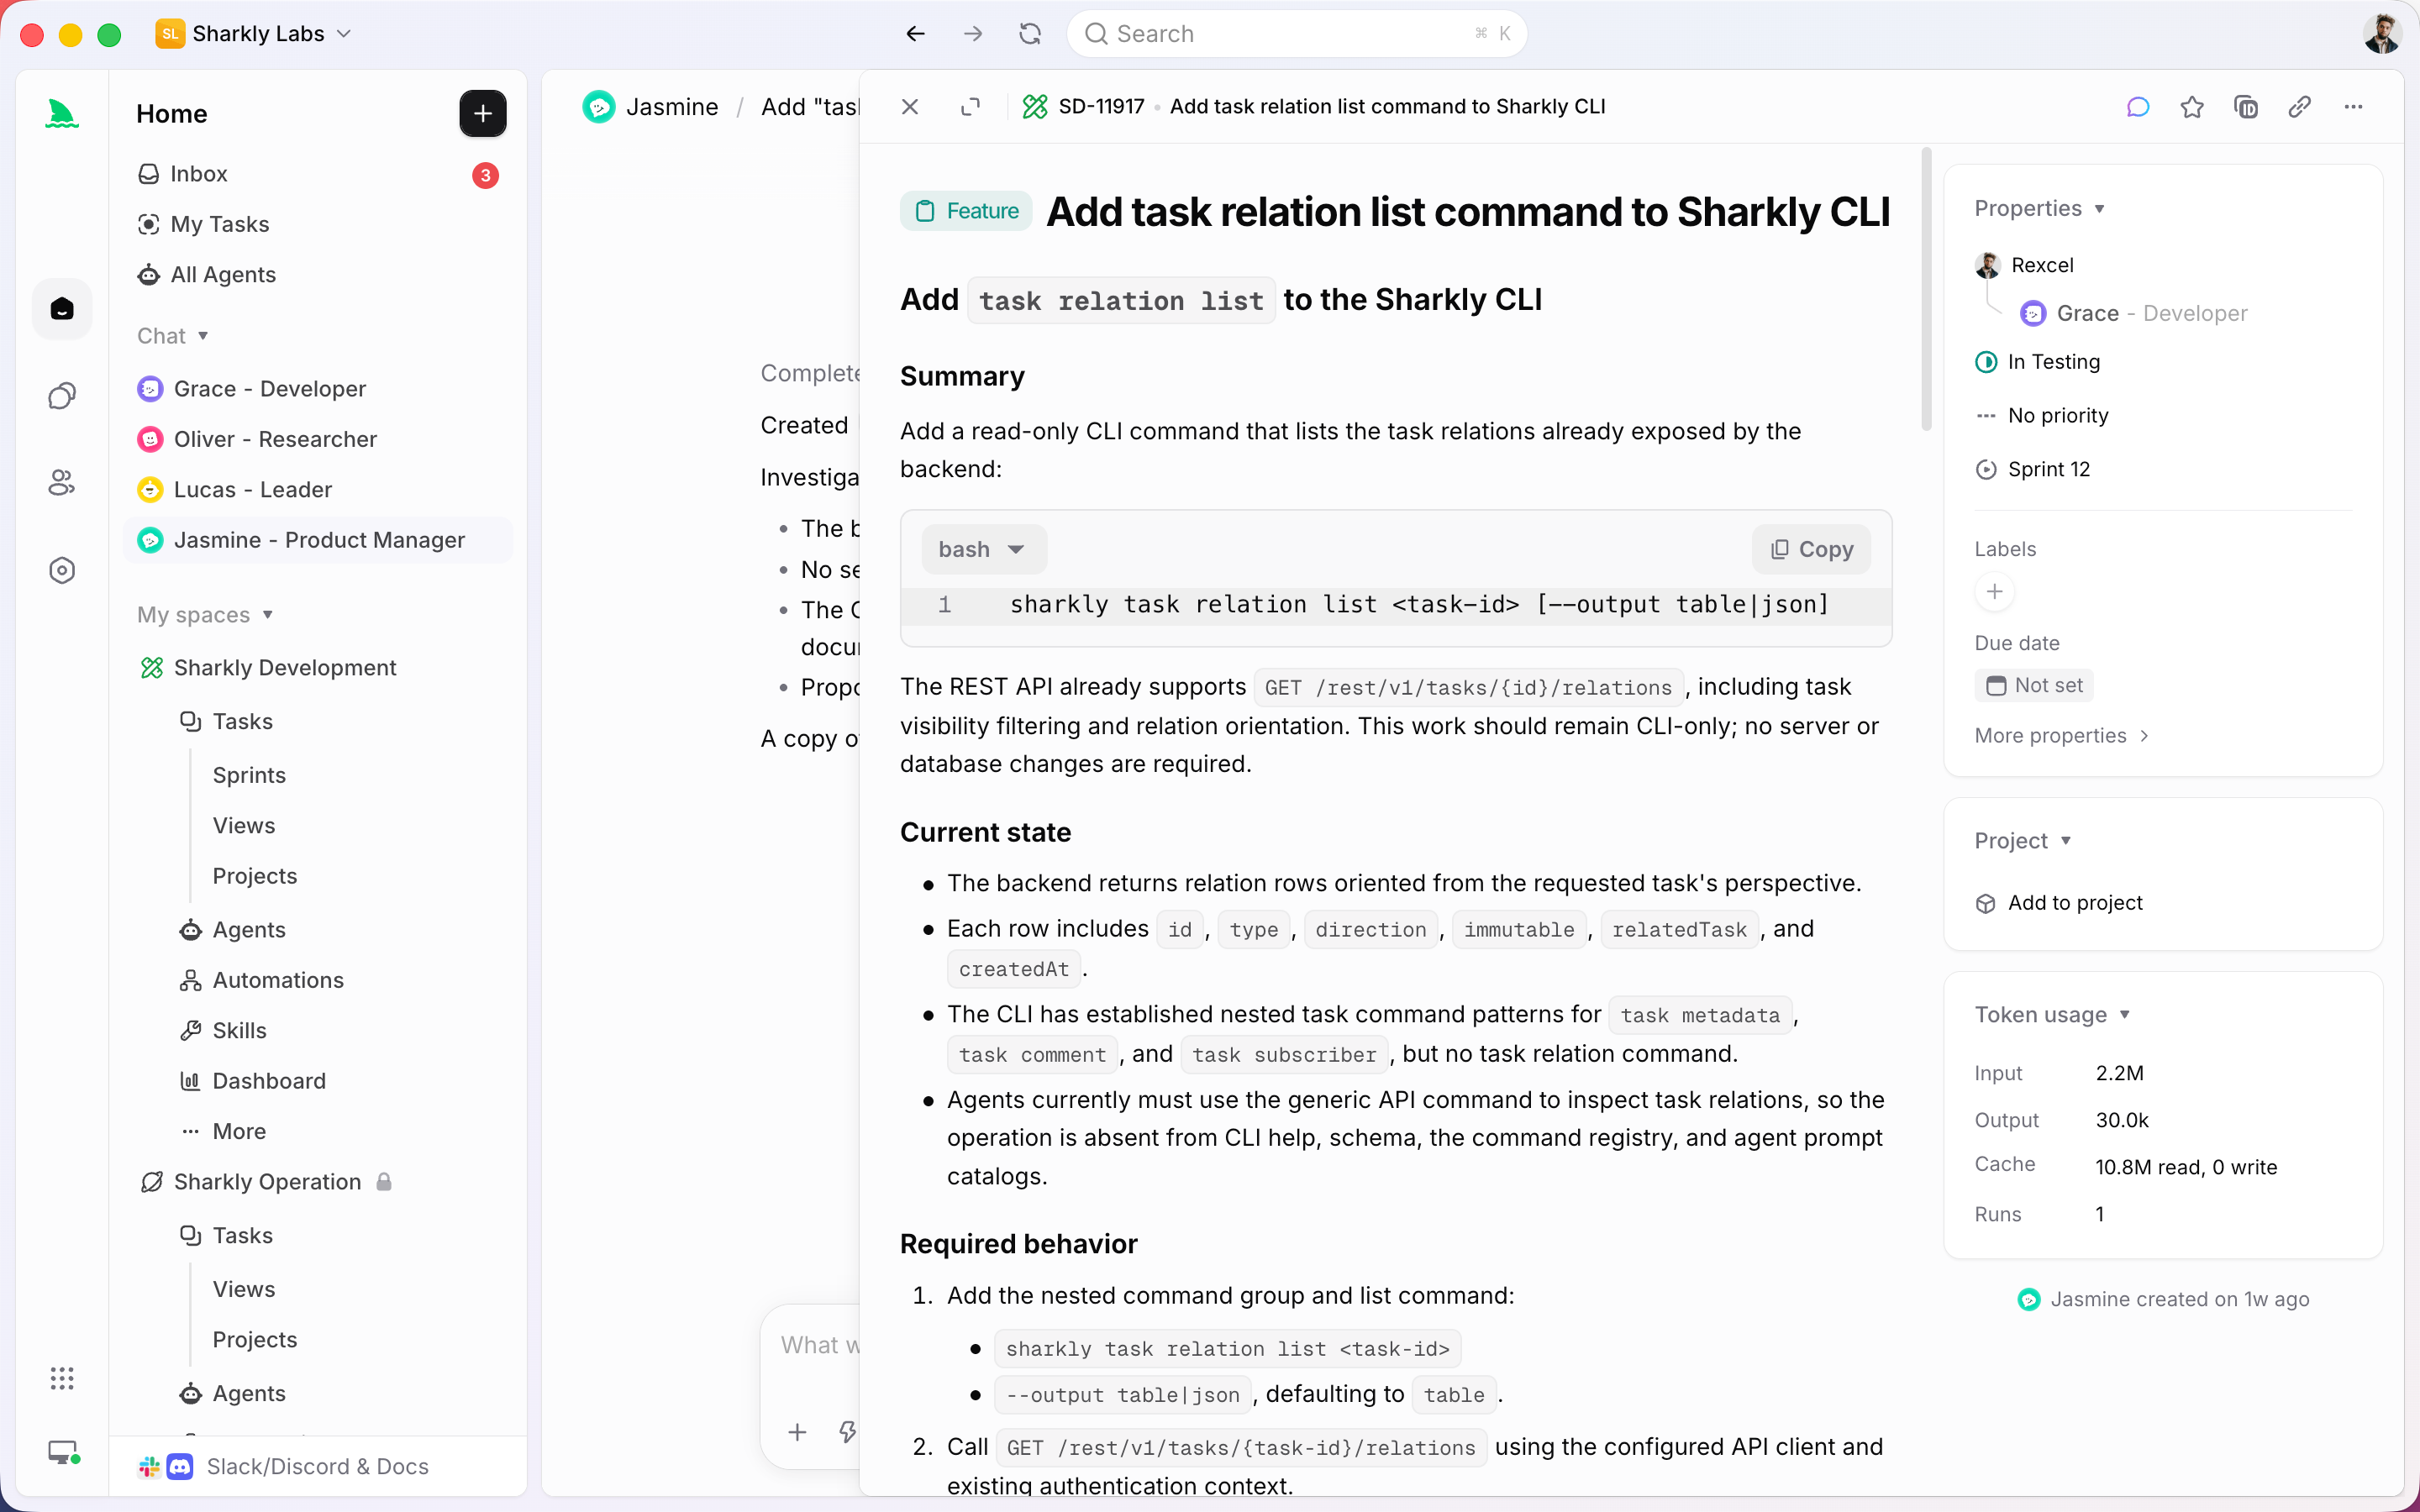
Hier spielt Sharkly seine Stärke aus. Du erstellst eine Task für den Bug und weist sie dann sowohl einem Claude-Code-Agent als auch einem Codex-Agent zu. Jeder Agent läuft auf einem verbundenen Computer in seinem eigenen Worktree, sodass die beiden Versuche nie dieselben Dateien berühren. Ausführung, Blocker, Ergebnisse und die Änderungszusammenfassung landen in der Task-Timeline, und du liest die zwei Diffs und zwei Testläufe in einer Ansicht gegeneinander, statt dich daran erinnern zu müssen, welches Terminal was enthielt.
Die Arbeitsteilung bleibt klar. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor und nehmen das Ergebnis ab. Die Automatisierung endet dort, wo dein Urteilsvermögen gefragt ist, und Sharkly hält Kontext, Fortschritt, Blocker, Ergebnisse und menschliches Review von der Anfrage bis zum Release sichtbar. Du übergibst die Entscheidung nicht an ein Tool; du bekommst beide Versuche so aufbereitet, dass die Prüfung nur Minuten dauert. Wenn du beide Agents für die tägliche Arbeit behalten willst statt für einen einmaligen Test, ist Claude Code und Codex gemeinsam auf einer Codebasis zu betreiben derselbe Workflow – nur zur Routine gemacht.
Zu welchem Agent du je nach Teamgröße greifst
Die richtige Wahl hängt davon ab, wer sie trifft und was der Vergleich überstehen muss.
| Teamgröße | Worauf du das größte Gewicht legst | Wozu du greifst |
|---|---|---|
| Einzelentwickler | Review-Zeit und Ausführung auf dem eigenen Rechner | Der Agent, den du schneller reviewst; du bist der einzige Leser |
| Kleines Team | Parallele Runs und gemeinsame Sichtbarkeit | Beide, über eine Task zugewiesen, damit alle dieselben Belege sehen |
| Plattform-Team | Integrationen und Anbieterneutralität | Beide behalten; der Workflow muss überleben, welcher Agent auch im nächsten Quartal führt |
Die letzte Zeile ist der eigentliche Grund, den Vergleich durchzuführen, statt einen Favoriten zu küren und ihn zu verteidigen. Der beste Agent dieses Quartal muss nicht der beste im nächsten sein, und den eigenen Prozess jedes Mal neu aufzubauen, wenn die Führung wechselt, ist eine eigene Steuer. Wenn du auf deinen eigenen Bugs vergleichst, in einem Workflow, der jeden Agent ausführen kann, bleibst du frei zu wechseln, sobald sich die Antwort ändert.
Wenn du weiterhin mehrere Coding-Agents nutzen willst, statt dich auf ein Ökosystem festzulegen, ist das genau das Problem, für das Sharkly gebaut ist. Lade Sharkly herunter, verbinde einen Computer und weise denselben echten Bug beiden Agents zu. Das Urteil, das du zurückbekommst, dreht sich um deine Codebasis – und nur sie sagt deine Woche voraus.
FAQ
Ist Claude Code oder Codex besser darin, Bugs zu beheben? Generell gewinnt keiner. Beim selben Bug und in ihrer jeweils besten Konfiguration liegt einer meist leicht vorn, und wer das ist, wechselt mit der Art des Bugs und der Größe des Repos. Setze beide auf einen echten Defekt aus deinem Backlog an und bewerte Korrektheit, Scope, Tests und Review-Zeit.
Kann ich Claude Code und Codex gleichzeitig auf denselben Bug ansetzen? Ja, wenn jeder seine eigene Arbeitskopie hat. Zwei Agents in einem Checkout überschreiben sich gegenseitig. Gib jedem einen isolierten Worktree oder weise die Task in Sharkly beiden zu und lass jeden Agent auf seinem eigenen Computer laufen.
Sagen mir Benchmark-Ergebnisse, welchen Agent ich verwenden soll? Sie sagen dir, welche Agents einen Test wert sind, nicht, wie sich einer in deinem Repository verhält. Ein öffentlicher Datensatz kann deine internen Bibliotheken, deine Lint-Config oder dein ungetestetes Modul niemals enthalten. Behandle das Leaderboard als Filter und führe dann den Vergleich durch, der wirklich zählt – auf deinem eigenen Code.
Ersetzt Sharkly Claude Code oder Codex? Nein. Sharkly ist die Ebene für Zuweisung, Kontext und Review rund um die Coding-Agents, die dein Team bereits einsetzt. Die Agents führen aus; Sharkly verwaltet die Task, hält die Runs sichtbar und überlässt die Abnahme den Menschen.
Wie viele Bugs sollte ich vergleichen, bevor ich mich entscheide? Ein Bug sagt dir etwas über einen Bug. Wende die Methode auf eine Handvoll verschiedener Defekttypen an, bevor du einem Muster vertraust, und halte die Rubrik jedes Mal identisch, damit die Ergebnisse sich stapeln lassen.


