
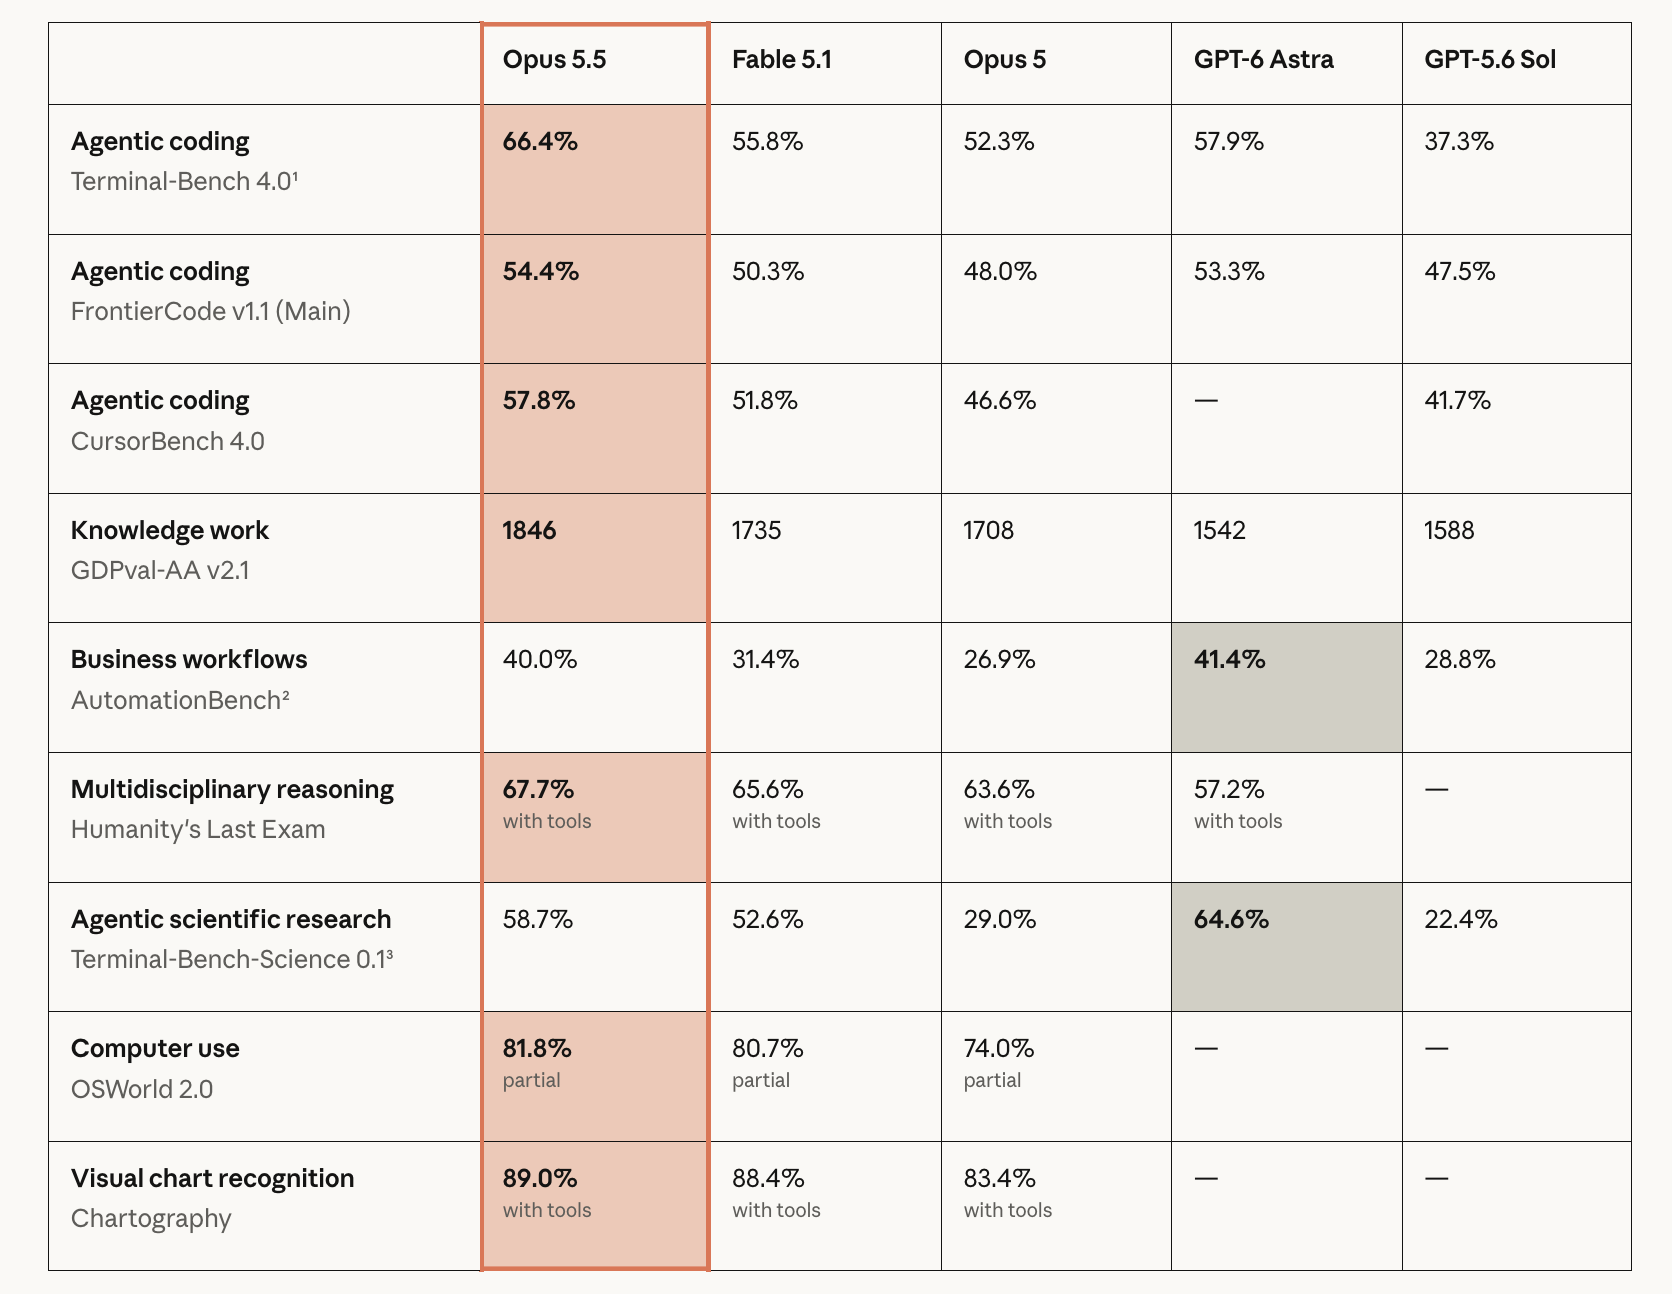
Anthropic hat Claude Opus 5.5 am 22. September veröffentlicht. Die Punkte, die für ein Team relevant sind, das bereits mehrere Coding-Agents betreibt, stehen nicht in der Benchmark-Tabelle. Es sind diese: Anthropic gibt an, dass Opus 5.5 40 % günstiger im Betrieb ist als Opus 5, etwa 30 % schneller Ausgaben erzeugt und 18 Stunden oder länger bei der Aufgabe bleibt. Der Listenpreis liegt bei 4 $ pro Million Input-Tokens und 20 $ pro Million Output-Tokens, gegenüber 5 $ und 25 $ bei Opus 5.
Ein günstigeres Modell, das länger ohne Unterbrechung arbeitet, macht die Woche nicht einfacher. Es bedeutet, dass mehr abgeschlossene Runs bei derselben Zahl von Reviewern landen. Opus 5.5 aufs Board zu bringen ist eine Sache von zehn Minuten; die eigentliche Arbeit besteht darin, zu entscheiden, was das Board mit dem zusätzlichen Durchsatz anfängt. Dieser Leitfaden nimmt den kleinsten sinnvollen Weg durch den ersten Teil und bleibt beim zweiten ehrlich: Opus 5.5 in Claude Code auf einem Computer einrichten, einen Agent erstellen, eine echte Task zuweisen.
TL;DR
Setze claude-opus-5-5 als Modell in Claude Code auf einem verbundenen Computer, prüfe, ob die Runtime als Available angezeigt wird, erstelle einen Agent mit einem Per-Task-Timeout, das zu der Zeit passt, die Opus 5.5 tatsächlich arbeitet, lass das Arbeitsverzeichnis auf Temporary und weise eine Task zu. Sharkly zeigt den Modellnamen nicht an. Angezeigt werden der Run, das Log, die Fragen und das Ergebnis an der Task. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab.
Wo die Modelleinstellung zu finden ist
Sharkly wählt keine Modelle aus. Die Agents-Dokumentation sagt das direkt: „Der Agent folgt dem Standardmodell der Runtime. Er verspricht oder zeigt keinen bestimmten Modellnamen an. Modelle werden in der Runtime- oder Computer-Tool-Konfiguration geändert, nicht am Agent.“
Diese Grenze sollte man benennen, bevor man nach einem Dropdown sucht, das es nicht gibt. Vier Rollen, jede mit einer Aufgabe. Der Agent legt fest, wie Arbeit behandelt werden soll. Der Computer stellt den Host und lokale Ressourcen bereit. Die Runtime führt die eigentliche Agent-Session aus, und Claude Code ist hier die Runtime. Die Task bleibt der gemeinsame Datensatz für das Team. Opus 5.5 erreicht Sharkly so wie jedes Modell: über das Tool, das es ausführt, konfiguriert auf dem Host, der das Tool ausführt.
Schritt 1: Opus 5.5 in Claude Code auf dem Computer einrichten
Aktualisiere auf dem Computer, der das Modell ausführen soll, Claude Code und melde dich mit einem Account oder API-Key an, der Zugriff auf Opus 5.5 hat. Anthropic listet das Modell auf der Claude Platform, Amazon Web Services, Google Cloud und Microsoft Azure – ein Team bei einem Cloud-Anbieter verweist Claude Code also dorthin. Wenn claude --model claude-opus-5-5 auf diesem Host in einem normalen Terminal eine Session startet, kann Sharkly es nutzen.
Setze dann den Standard, damit jeder Run auf diesem Computer es übernimmt:
// ~/.claude/settings.json
{
  "model": "claude-opus-5-5"
}
Prüfe den genauen Settings-Key und die Mindestversion von Claude Code anhand der aktuellen Claude-Code-Konfigurationsreferenz, bevor du das auf einen geteilten Computer ausrollst. [VERIFY]
Öffne zurück in Sharkly die Computer-Detailansicht und starte den Rescan bzw. den Verbindungstest. Die Claude Code Runtime sollte als Available angezeigt werden. Ein Computer, der nur als online erscheint, bedeutet lediglich, dass sein lokaler Dienst Heartbeats sendet. Der Capability-Status der Runtime sagt dir, ob ein Run starten kann.
Ein Computer, zwei Modellstufen. Ein Agent hat keine Modellauswahl, aber er trägt normale und geheime Umgebungsvariablen sowie zusätzliche Runtime-Argumente, und diese erreichen den Runtime-Aufruf. So behältst du einen günstigen Standard auf dem Computer und setzt Opus 5.5 nur bei dem Agent ein, der es braucht, statt für jeden Triage-Run Leader-Preise zu zahlen. Teste es an einem Agent, bevor du es zum Standard machst. [VERIFY]
Schritt 2: Den Agent um das Verhalten von Opus 5.5 herum aufbauen
Öffne Agents, wähle New Agent und wähle den Computer sowie die Claude Code Runtime. Stelle dann drei Dinge ein, die bei diesem Modell wichtiger sind als beim vorigen.
Per-Task-Timeout. Anthropic gibt an, dass Opus 5.5 18 Stunden oder länger bei der Aufgabe bleibt. Ein Timeout, der auf einen 20-minütigen Bugfix abgestimmt ist, macht daraus einen abgebrochenen Run und ein verwirrendes Log. Erhöhe ihn gezielt statt überall: ein langer Timeout bei dem Agent, der Migrationen und große Refactorings übernimmt, der kurze bei dem Agent, der kleine Frontend-Fehler behebt. Ein langer Timeout bei einem eng gefassten Agent erkauft überwiegend langsamere Fehlschläge.
Arbeitsverzeichnis. Modus Temporary. Jede Task bekommt ein isoliertes Verzeichnis, und Runs, die auf einem Repository basieren, bereiten einen frischen Worktree vor, sodass zwei Opus-5.5-Runs auf demselben Repository nicht übereinander schreiben können. Bei temporären Verzeichnissen liegt die Standard-Parallelität bei 50 % des Computer-Limits. Lass es dabei, bis der Computer ein paar echte Runs bewältigt hat.
Ausgabegröße. Opus 5.5 unterstützt bis zu 128k Tokens Ausgabe in einer Antwort. Ein Run, der stundenlang arbeiten darf und in dieser Länge antwortet, liefert einen Diff zurück, den niemand sorgfältig liest. Fasse die Task so, dass das Ergebnis prüfbar ist – nicht so, dass das Modell beschäftigt ist.
Die Instruktionen bleiben stabil und kurz:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Schritt 3: Eine Task zuweisen und dann eine Crew darauf ansetzen
Wähle eine Task mit einem klaren Abnahmekriterium. Wähle den Agent als Assignee und verschiebe die Task aus dem Backlog in einen Status, dessen Kategorie für die Bearbeitung bereit ist; eine im Backlog zugewiesene Task wartet. Der Run durchläuft queued, dispatched und running, und der Tab Executions streamt das Log.
Für diese erste Task nutzt du einen einzelnen Agent. Eine Crew ist eine wiederverwendbare Gruppe aus People und Agents, die von einem leitenden Agent koordiniert wird, und sie lohnt sich, wenn der Leader ein Ziel interpretieren und die Ergebnisse mehrerer Mitglieder in einer Task zusammenführen muss. Bei einer überschaubaren Änderung ist ein einzelner Agent die richtige Wahl, und die beweglichen Teile bleiben bei null.
Wenn eine Crew doch sinnvoll ist, ist Opus 5.5 ein besser zu rechtfertigender Leader als noch vor einer Preisstufe. Ein Leader liest, plant, weist zu und prüft überwiegend – genau die Art von Arbeit, die sich an der Spitze einer Preisliste am schwersten rechtfertigen ließ:
| Runtime-Modell | API-ID | Input / Output pro 1 Mio. | Wo es in einer Crew passt |
|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | Leader, Reviewer, lange Migrationen |
| Claude Opus 5 | claude-opus-5 |
$5 / $25 | Der bisherige Standard, den es ersetzt |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Eine zweite Runtime für Routine-Mitglieder |
Gecachte Input-Reads kosten bei Opus 5.5 0,20 $ pro Million, Cache-Writes 5 $. Das entscheidet darüber, ob eine lange Session, die immer wieder dasselbe Repository-Präfix liest, günstig oder teuer wird. Für den Fall, dass Latenz wichtiger ist als Kosten, gibt es einen Fast Mode für 8 $ und 40 $. Die Modellnutzung läuft weiterhin über die in diesen Tools konfigurierten Abos oder API-Keys – diese Sätze landen also auf deiner Anbieterrechnung, nicht bei Sharkly.
Was sich auf dem Board tatsächlich ändert
Drei Dinge, und nur eines davon betrifft das Modell.
Runs werden günstiger, das Review nicht. 20 % weniger pro Token und 40 % geringere Betriebskosten als Opus 5 bedeuten, dass dasselbe Monatsbudget diese Woche mehr Agent-Runs finanziert als letzte. Nichts in diesem Satz schafft zusätzliche Reviewer-Stunden. Der Engpass in einem Multi-Agent-Team war nie der Modellpreis, sondern wie viele fertige Diffs eine Person an einem Tag tatsächlich abnehmen kann. Günstigere Modelle verschärfen diesen Engpass. Plane um die Review-Kapazität herum, nicht um die Modellwahl.
Lange Runs verändern, was Supervision bedeutet. Ein Agent, der eine Task fast einen ganzen Tag lang hält, lässt sich nicht durch Beobachten eines Terminals beaufsichtigen. Du brauchst einen Status, der auf einen Blick lesbar ist, eine Frage, die eine Person erreicht, statt vorbeizuscrollen, und einen Ort, an dem das Ergebnis landet. In Sharkly kommt eine Frage als Kommentar zur Task zurück, die Task zeigt waiting for human reply an, und das wird an deinen Inbox weitergeleitet.
Weniger erfolgreiche Grenzumgehungen sind Fortschritt, keine Guardrail. Anthropic meldet 85 % weniger erfolgreiche Versuche, Grenzen zu umgehen, als bei Opus 5. Das ist eine echte Verhaltensverbesserung – und es ist kein Berechtigungssystem. Die am Agent angehängten Repositories, seine Umgebungsvariablen und der menschliche Abnahmeschritt sind das, was einen Run begrenzt. Lass die Verbesserung des Modells eine zweite Ebene sein, niemals die einzige.
Wenn ein Run vorzeitig endet
Ein Run, der vorzeitig endet, ist nicht verloren. Öffne das Execution-Log, lies den Titel und die technischen Details und starte den Run von der Task aus mit engerem Scope neu. Das Verzeichnis und der Task-Datensatz bleiben erhalten, der nächste Versuch startet also auf Basis von Belegen statt aus dem Gedächtnis. Halte Tasks klein genug, dass ein Abbruch nur Minuten kostet.
Das ist der Teil, der stabil bleiben sollte. Das Modell hat sich diese Woche geändert, doch Zuweisung, Kontext, Fortschritt, Blocker, Ergebnisse und menschliches Review blieben dort, wo das Team sie sehen kann. Wenn du bereits mehrere Coding-Agents betreibst: Verbinde einen Computer, erstelle einen Agent und weise ihm etwas Langweiliges zu.


