
Anthropic hat Claude Sonnet 5.5 am 28. September veröffentlicht – zu einem Preis von 2 $ pro Million Input-Token und 10 $ pro Million Output-Token. Das entspricht dem Listenpreis von Sonnet 5 und der Hälfte von Opus 5.5. Laut Anthropic arbeitet das Modell über 30 % schneller als Sonnet 5 und verursacht bis zu 30 % geringere Kosten pro Aufgabe. Für Teams, die mehrere Coding-Agents einsetzen, bedeutet das: Das Modell, das man für alltägliche Agents wählen würde, liegt in den meisten Zeilen von Anthropics Vergleichstabelle zum Launch nur noch wenige Punkte hinter dem Flaggschiff.
Das Modell aufs Board zu bringen, funktioniert allerdings weniger automatisch, als es klingt. Das default-Modell von Claude Code verweist bei Pro, Max, Team, Enterprise und der Anthropic-API auf Opus 5.5. Ein Computer, auf dem Claude Code läuft, bleibt also beim Flaggschiff, bis die Konfiguration angepasst wird. Der Alias sonnet steht zudem nur bei der Anthropic-API für Sonnet 5.5 – auf Bedrock, Google Cloud und Microsoft Foundry verweist er nach wie vor auf Sonnet 4.5. Ein Team, das „auf Sonnet umgestellt“ hat, nutzt am Ende womöglich drei verschiedene Modelle auf drei Computern, ohne nachvollziehen zu können, welcher Durchlauf welches Modell verwendet hat. Dieser Leitfaden wählt den kleinstmöglichen pragmatischen Weg: ein Computer, ein Agent, ein realer Task – und anschließend die Entscheidung, wo Opus 5.5 seinen Preis weiterhin rechtfertigt.
TL;DR
Aktualisieren Sie Claude Code auf dem Computer auf Version 2.1.284 oder höher, pinnen Sie die vollständige ID claude-sonnet-5-5 anstelle des Alias sonnet und führen Sie einen erneuten Scan durch, bis die Claude Code Runtime den Status „Available“ anzeigt. Formulieren Sie Agent-Instruktionen so, dass vorzeitige Zwischenfragen und ungefragte Ergänzungen von Sonnet 5.5 unterbunden werden, belassen Sie das Arbeitsverzeichnis auf „Temporary“, passen Sie das Timeout an klar abgegrenzte Aufgaben an und weisen Sie einen Task zu. In einer Crew weisen Sie Routine-Mitgliedern Sonnet 5.5 zu und behalten Opus 5.5 als Lead und Reviewer bei. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Freigaben und nehmen die Ergebnisse ab.
Wo die Modellkonfiguration vorgenommen wird
Sharkly wählt keine Modelle aus. In der Agents-Dokumentation heißt es dazu unmissverständlich: „The Agent follows the Runtime’s default model. It does not promise or display a specific model name. Change models in the Runtime or Computer tool configuration, not on the Agent.“ Weiter wird auf derselben Seite erklärt, dass der Agent weder eine Modellauswahl noch eine Steuerung für die Denktiefe (Thinking Depth) bietet.
Für Sonnet 5.5 ist das entscheidend, denn das Verhalten dieses Modells ändert sich vor allem über die Effort-Stufe – und der Effort wird dort festgelegt, wo auch das Modell konfiguriert wird: in Claude Code auf dem Computer. Der Agent legt fest, wie die Arbeit abgewickelt wird, der Computer stellt den Host bereit, die Runtime (in diesem Fall Claude Code) führt die Sitzung aus und der Task fungiert als gemeinsames Protokoll.
Schritt 1: Sonnet 5.5 in Claude Code auf dem Computer einrichten
Sonnet 5.5 erfordert laut der Modellkonfigurations-Dokumentation von Claude Code mindestens Version 2.1.284. Aktualisieren Sie Claude Code auf dem Computer und melden Sie sich mit einem kostenpflichtigen Tarif oder einem API-Schlüssel an, der Zugriff hat; Claude Code ist nicht im kostenlosen Tarif von Claude verfügbar (was ein Chat-Seat ausführen kann und was nicht). Führen Sie anschließend claude --model claude-sonnet-5-5 in einem normalen Terminal auf diesem Host aus. Wenn eine Sitzung startet, kann Sharkly darauf zugreifen.
Pinnen Sie die vollständige ID und nicht den Alias. Darauf verweist sonnet in Claude Code aktuell:
| Woher Claude Code das Modell bezieht | Worauf der Alias sonnet verweist |
|---|---|
| Anthropic-API | Sonnet 5.5 |
| Claude Platform auf AWS | Sonnet 4.6 |
| Amazon Bedrock | Sonnet 4.5 |
| Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
Die ID lautet überall claude-sonnet-5-5, außer auf Bedrock, wo das Modell über das globale regionsübergreifende Profil global.anthropic.claude-sonnet-5-5 läuft. Auch opusplan erbt das Alias-Problem: Es plant mit Opus und führt Aufgaben mit dem aus, worauf sonnet gerade verweist.
Sorgen Sie anschließend dafür, dass die Einstellung dauerhaft greift: Konfigurieren Sie das Modell in den Claude-Code-Einstellungen auf diesem Computer so, dass jeder vom lokalen Dienst gestartete Durchlauf Sonnet 5.5 anstelle des Standardmodells Opus 5.5 verwendet, und wiederholen Sie die Überprüfung im Terminal.
Öffnen Sie anschließend in Sharkly die Detailansicht des Computers und führen Sie einen erneuten Scan oder Verbindungstest durch. Die Claude Code Runtime sollte nun den Status „Available“ anzeigen. Ein Computer mit dem Status „Online“ bedeutet lediglich, dass der lokale Dienst Heartbeats sendet; erst der Status der Runtime bestätigt, dass ein Durchlauf tatsächlich starten kann.
Schritt 2: Den Agent auf das Verhalten von Sonnet 5.5 abstimmen
Öffnen Sie „Agents“, wählen Sie „New Agent“ und bestimmen Sie den Computer sowie die Claude Code Runtime. Anthropics Prompting-Leitfaden für Sonnet 5.5 beschreibt Verhaltensweisen, die sonst direkt in einer Review-Warteschlange landen.
Die Effort-Stufe entscheidet darüber, welches Modell Sie tatsächlich nutzen. Claude Code führt Sonnet 5.5 standardmäßig mit medium Effort aus, und das Denken (Thinking) lässt sich dort nicht deaktivieren. Die meisten in den Ankündigungen hervorgehobenen Benchmark-Werte wurden jedoch mit der Stufe „max“ ermittelt. Den Diagrammen von Anthropic zufolge erreicht Sonnet 5.5 auf CursorBench 4.0 bei „medium“ 39,2 % und bei „max“ 55,5 % – bei geschätzten Kosten von 0,70 $ gegenüber 9,67 $ pro Task. Dabei handelt es sich nicht um eine richtige oder falsche Einstellung, sondern um völlig unterschiedliche Budgets. Der Leitfaden empfiehlt „medium“ für agentenbasiertes Coding bei klar definierten Aufgaben; „xhigh“ und „max“ sollten gezielten, messbaren Leistungssteigerungen vorbehalten bleiben.
Es stellt vorzeitig Rückfragen. Bei den Stufen „low“ und „medium“ neigt Sonnet 5.5 dazu, bei längeren Agenten-Aufgaben innezuhalten und Rückfragen zu stellen. In Sharkly wird eine solche Rückfrage als Kommentar im Task hinterlegt, der Task wechselt in den Status „Warten auf menschliche Antwort“ und verbleibt im Posteingang einer Person, bis diese reagiert. Weisen Sie den Agenten an, auf Basis explizit formulierter Annahmen eigenständig fortzufahren. Bei „low“ Effort meldet das Modell Code mitunter auch als fertiggestellt, ohne Tests ausgeführt zu haben – schreiben Sie Prüfungen daher zwingend vor.
Es fügt ungefragte Änderungen hinzu. Der Leitfaden weist darauf hin, dass das Modell auf jeder Effort-Stufe ungefragt Tests, Dokumentationen und kleinere Dateien erstellt – bei „xhigh“ und „max“ kommen zusätzliche Review-Runden oder Reviewer-Subagents hinzu. Eine Fußnote in Anthropics Launch-Ankündigung verdeutlicht die Folgen: Sonnet 5.5 schnitt bei FrontierCode auf Stufe „max“ schlechter ab als auf „xhigh“, weil es häufiger die Code-Review-Funktion von Claude Code aufrief. Diese verteilt die Aufgaben auf zahlreiche Subagents, was in zwei von Cognition untersuchten Fällen zu einem Timeout oder zu Änderungen außerhalb des Aufgabenbereichs führte. Für Reviewer bedeutet das einen größeren Diff mit Änderungen, die am eigentlichen Task vorbeigehen.
Timeout und Arbeitsverzeichnis. Anthropic positioniert Sonnet 5.5 für „klar umrissene Alltagsaufgaben“. Dimensionieren Sie das Timeout pro Task entsprechend; wird das Limit erreicht, teilen Sie den Task auf, anstatt sofort das Timeout zu erhöhen. Belassen Sie das Arbeitsverzeichnis auf „Temporary“: Jeder Task erhält ein isoliertes Verzeichnis, und Repository-gestützte Durchläufe richten einen frischen Worktree ein, sodass parallele Durchläufe einander nicht überschreiben können. Behalten Sie die Standard-Parallelität von 50 % des Computer-Limits bei, bis das System unter realer Last getestet wurde.
Anzupassende Instruktionen:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior. Do not add tests,
docs, or new files unless the Task asks for them; list any you
think are missing in your report instead.
Do not stop to ask whether to continue. When a detail is ambiguous,
proceed with a stated assumption and record it in your report.
Ask only when different interpretations would materially change
the result.
Run the closest relevant checks before reporting done, and report
failures without hiding them.
Do not start extra review rounds or reviewer subagents.
If a safeguard notice or refusal appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
Schritt 3: Einen Task zuweisen und eine zweistufige Crew aufbauen
Wählen Sie einen Task mit klaren Akzeptanzkriterien, weisen Sie ihn dem Agenten als Assignee zu und verschieben Sie ihn aus dem Backlog (wo zugewiesene Tasks warten) in einen bearbeitungsbereiten Status. Der Durchlauf durchläuft die Status „queued“, „dispatched“ und „running“, während der Reiter „Executions“ das Log live streamt.
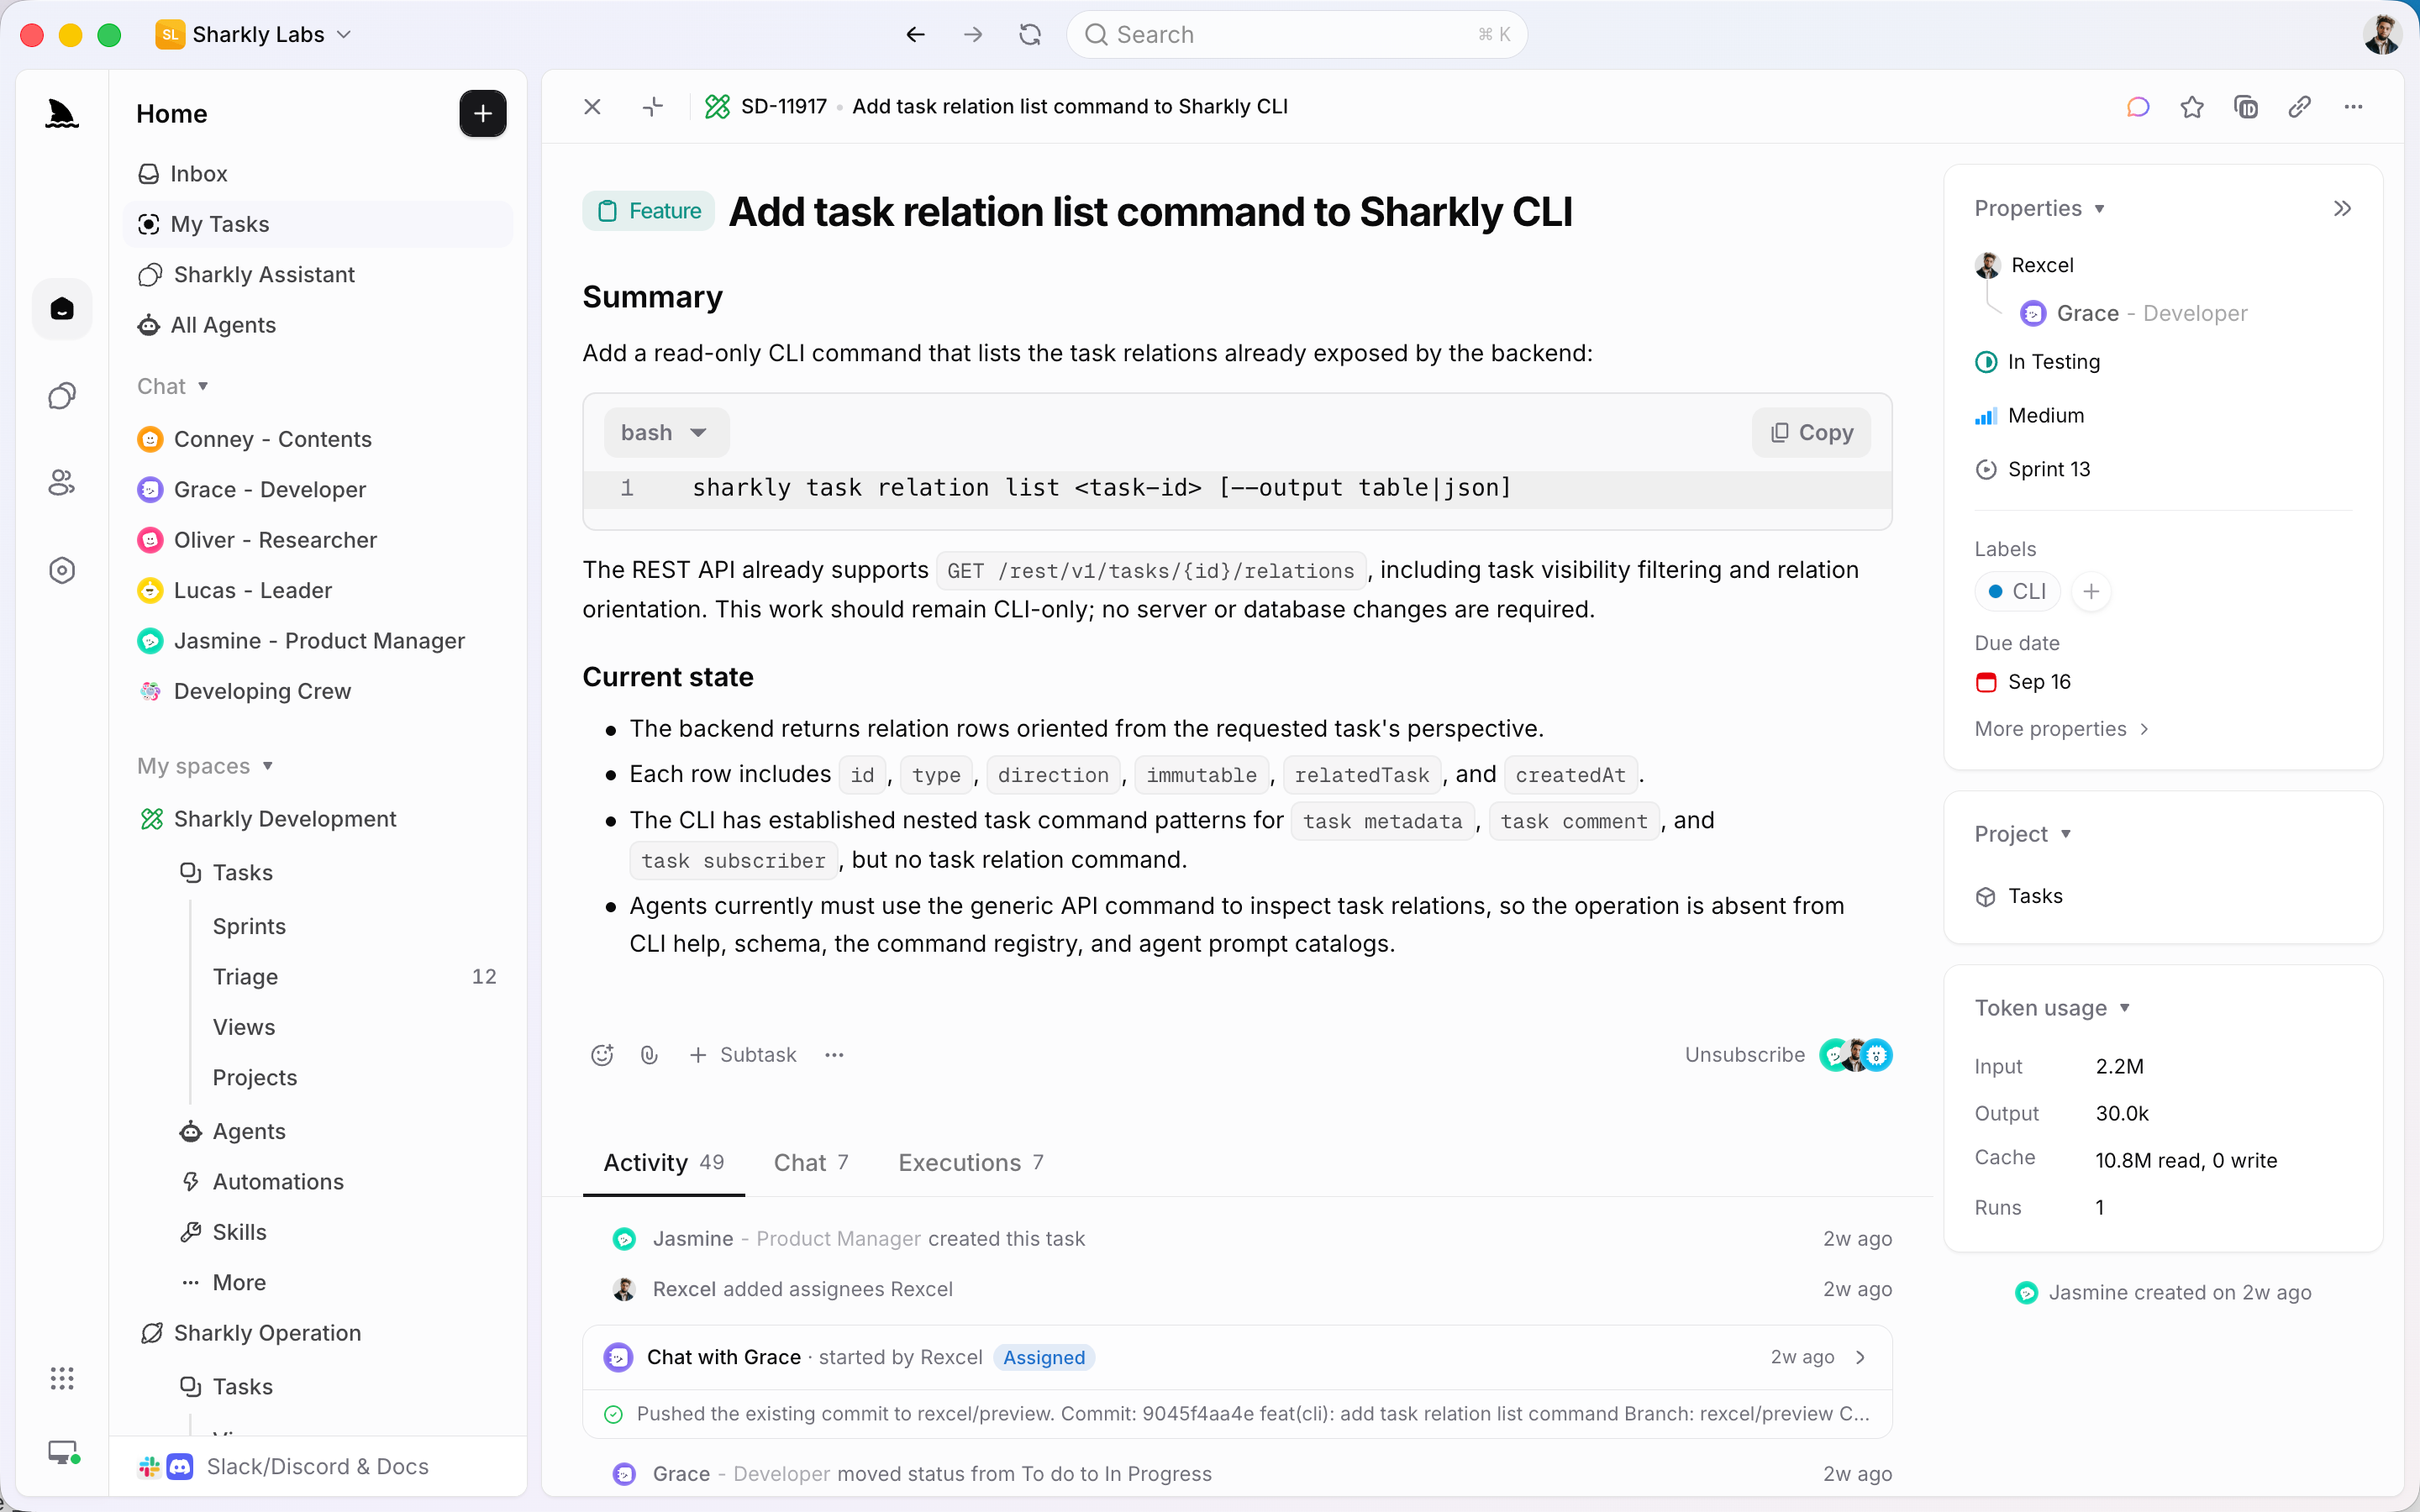
Belassen Sie diesen ersten Task bei einem einzelnen Agenten. Eine Crew ist eine wiederverwendbare Gruppe aus Menschen und Agents, die von einem leitenden Agenten koordiniert wird. Ihr Einsatz lohnt sich dann, wenn der Lead ein Ziel interpretieren und die Ergebnisse mehrerer Mitglieder in einem einzigen Task zusammenführen muss. Für einen klar umrissenen Bugfix reicht ein einzelner Agent vollkommen aus.
Innerhalb einer Crew orientiert sich die Aufgabenteilung an Anthropics eigener Positionierung: Opus 5.5 „bleibt bei komplexen, ergebnisoffenen Aufgaben deutlich stärker“ – was exakt die Rolle des Leads beschreibt: planen, zuweisen, überprüfen. Die Arbeit der Mitglieder umfasst genau die klar abgegrenzten Aufgaben, für die Sonnet 5.5 konzipiert wurde. Ein auf der Launch-Seite zitierter früher Tester beschreibt dieselbe Aufteilung: Sonnet 5.5 implementiert die Architektur, die Opus 5.5 vorgegeben hat.
| Runtime-Modell | API-ID | Input / Output pro 1 Mio. | Einsatzbereich |
|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
2 $ / 10 $ | Routine-Mitglieder: Bugfixes, abgegrenzte Features, Dokumentation |
| Claude Opus 5.5 | claude-opus-5-5 |
4 $ / 20 $ | Lead, Reviewer, ergebnisoffene Aufgaben |
| Claude Sonnet 5 | claude-sonnet-5 |
2 $ / 10 $ | Das Vorgänger-Sonnet; Fallback bei markierten Cyber-Anfragen |
| GPT-6 Sol | gpt-6-sol |
2 $ / 10 $ | Eine zweite Runtime auf Codex-Basis zum gleichen Preis |
Da das Modell laut Dokumentation in der Tool-Konfiguration des Computers festgelegt wird, besteht das einfachste zweistufige Setup aus zwei Computern: einem, auf dem Claude Code den Standard Opus 5.5 für den Lead beibehält, und einem, der für die Mitglieder fest auf claude-sonnet-5-5 gepinnt ist. Wo genau die Trennlinie verläuft, ist eine Routing-Regel, die klar definiert werden sollte; der Artikel Sonnet 5.5 oder Opus 5.5 erläutert dies im Detail, während Sonnet 5.5 im Vergleich zu GPT-6 Sol die alternative Runtime in derselben Preisklasse beleuchtet. Die Modellnutzung läuft weiterhin über die in diesen Tools hinterlegten Abonnements oder API-Schlüssel, sodass diese Kosten auf der Rechnung Ihres jeweiligen Providers erscheinen und nicht bei Sharkly.
Was sich auf dem Board ändert
Schnellere Durchläufe treffen auf dieselben Reviewer. Mehr erledigte Arbeit pro Tag bei gleichem Budget bringt keine zusätzlichen Reviewer-Stunden mit sich – und die Angewohnheit des Modells, ungefragt Tests und Dokumentation hinzuzufügen, vergrößert jeden Diff. Planen Sie Ihre Prozesse daher rund um die Review-Kapazitäten, nicht anhand des Modellpreises.
Ein markierter Durchlauf ist unter Umständen kein Durchlauf mit Sonnet 5.5. Dies ist das erste Sonnet-Modell mit Cyber-Schutzmechanismen (Safeguards). Laut Anthropic greift bei risikoreicheren Cyber-Aufgaben ein „sichtbarer Fallback auf Sonnet 5“, und die Model Card warnt vor einer höheren Ablehnungsrate selbst bei unbedenklichen Sicherheitsanalysen. Was in der Terminalsitzung sichtbar ist, ist auf dem Board jedoch nicht erkennbar: Sharkly blendet keinen Modellnamen ein, sodass am Task selbst nichts darauf hinweist, welches Modell die Antwort generiert hat – es sei denn, der Agent vermerkt es explizit. Genau aus diesem Grund fordern die obigen Instruktionen diesen Hinweis ein.
Das Reasoning verbleibt bei dem Modell, das es erzeugt hat. Sonnet 5.5 kann die Thinking-Blöcke von Opus 5.5 nicht lesen, kein anderes Modell kann die von Sonnet 5.5 lesen, und nicht lesbare Blöcke werden fehlerlos verworfen. Selbst innerhalb einer einzelnen Claude-Code-Sitzung führt der Wechsel zwischen beiden Modellen dazu, dass zwar der sichtbare Text erhalten bleibt, das dahinterliegende Reasoning jedoch verloren geht. Zwischen Agents innerhalb einer Crew wurde das Reasoning ohnehin nie übertragen: Der Reviewer erhält nur das, was das Mitglied im Task dokumentiert hat. Der Beitrag Model Handoffs verlieren das Reasoning erläutert die Lösung, und Übergabe-Templates geben ihr eine feste Struktur.
Das Modell hat sich diese Woche geändert. Zuweisung, Kontext, Fortschritt, Blocker, Ergebnisse und das menschliche Review sind an ihrem gewohnten Platz geblieben – gut sichtbar für das gesamte Team. Sie können diesen Ablauf manuell über Worktrees abbilden oder Sharkly nutzen, um den Workflow zu verwalten.


