
TL;DR: Ein Team am MIT CSAIL ließ ein Frontier-Modell die Gewichte von Qwen3.5-0.8B in einer Python-Sandbox lesen und bearbeiten – mit einem festen Budget an Forward-Passes und einem vollständigen Protokoll jedes Schritts. Die Autoren berichten, dass MATH-500 von 7,9 % auf 48,1 % gestiegen ist. Genauso können Sie einen Coding-Agenten Modellgewichte bearbeiten lassen: fünf Aufgaben auf einem Board, das Budget in jeder Aufgabe festgeschrieben, ein zweiter Agent für die Evaluation und ein Mensch, der die bearbeitete Datei freigibt.
Am 2. November 2026 veröffentlichten Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab Sparks of Weight-Space Programming. Das Modell ihrer Studie, GPT-6 Astra, öffnete Gewichts-Tensoren, schrieb numpy- und PyTorch-Code darauf, bildete eine Hypothese und veränderte 131.072 Zahlen in einem Modell mit 0,8B Parametern.
Wer sich das Setup ansieht, erkennt es wieder: eine Sandbox, ein Tool-Budget, ein Protokoll jedes Prompts und jeder ausgeführten Zelle. Das ist ein Coding-Agent mit einem Harness – und genau der Harness ist der Teil, den Ihr Team heute nachbauen kann.
Was das MIT-Team gemacht hat – in Zahlen
Weight-Space-Programming bedeutet, dass ein LLM die Parameter eines Netzwerks als Daten liest und sie direkt bearbeitet – ohne Gradientenabstieg und ohne Trainingslauf. Der MIT-Beitrag beschreibt das an kleinen Modellen, unter strengen Tool-Limits und mit protokolliertem Verlauf jeder Runde.
Das Schlagzeilenergebnis ist die Bearbeitung von Qwen3.5-0.8B:
| Kennzahl (Angaben der Autoren) | Basismodell | Bearbeitetes Modell |
|---|---|---|
| MATH-500 | 7,9 % | 48,1 % |
| GSM8K | 13,8 % | 67,1 % |
| IFEval | 21,0 % | 62,3 % |
| Läufe, die das Limit von 32.768 Token erreichten | 93,0 % | 33,1 % |
Astra führte die Angewohnheit des Modells, in Schleifen zu geraten, bis ihm die Token ausgingen, auf eine Richtung zurück, die von den MLPs der Layer 15 und 19 geschrieben wurde, und subtrahierte sie anschließend aus jeweils 64 Ausgabespalten: 131.072 Gewichte oder 0,016 % des Modells. Der veröffentlichte Checkpoint steht unter Apache-2.0, und seine Model Card gibt an, dass sich nur zwei Tensoren vom Basismodell unterscheiden: die down_proj.weight-Matrizen in diesen beiden Layern.
Warum der Harness das Ergebnis entscheidet
Zwei Erkenntnisse aus dem Beitrag sind für ein Team wichtiger als das Schlagzeilenergebnis.
Das Budget hat das Ergebnis verändert. Jeder Forward-Pass mittelte über einen Batch von 64 Sequenzen. Mit 10 Passes erreichte MATH-500 12,3 %. Mit 25 waren es 14,1 %. Mit 50 dann 48,1 %. Dasselbe Modell, dieselbe Aufgabe – aber eine andere Obergrenze dafür, wie oft der Agent eine Idee testen konnte.
Die Tools haben das Ergebnis verändert. Bekam Astra nur die Gewichte zweier Gemma-3-270M-Varianten, konnte es in keinem von vier Versuchen sagen, welche davon sycophantisch war. Bekam es ein Tool, das Attention-Gewichte zu bis zu 16 selbst verfassten Texten zurückgab, benannte es den Sycophanten in allen drei Paaren.
Also zwei Stellschrauben: was der Agent ausgeben darf und was er sich ansehen darf. Beides gehört schriftlich festgehalten, bevor der Lauf startet.
Die Grenzen sind ebenso klar. Astra konnte Gemma 3 270M bei MATH-500 nicht verbessern: Von einer Basis von 6,8 % erreichte die beste Bearbeitung 7,7 %. Die Autoren lesen das als eine Bearbeitung, die ein Hindernis entfernt, und nicht als neu hinzugefügte Fähigkeit, die dem Modell fehlte. Sie bezeichnen die Ergebnisse als früh, und mehrere davon sind Einzelläufe. Planen Sie Ihr eigenes Experiment als Test, nicht als Lösung.
Wie Sie einen Coding-Agenten sicher Modellgewichte bearbeiten lassen
Ein sicheres Weight-Space-Experiment hat fünf Eigenschaften:
- Die Originalgewichte sind für jeden Agenten schreibgeschützt.
- Das Forward-Pass-Budget steht als Zahl in der Aufgabe und wird von der Sandbox durchgesetzt.
- Das Evaluationsset, das der Editor sieht, ist getrennt vom Regressionsset, das der Reviewer ausführt.
- Das Protokoll jedes Laufs bleibt an der Stage hängen, zu der es gehört.
- Ein Mensch gibt die bearbeitete Datei frei, bevor irgendetwas sie außerhalb der Sandbox lädt.
Sharkly zählt keine Forward-Passes und inspiziert keine Tensoren. Das übernimmt Ihr Sandbox-Skript, und Ihre Runtime (Claude Code, Codex oder ein anderer Agent, den Sie bereits betreiben) übernimmt das Lesen und Bearbeiten. Sharkly hält die Arbeit zusammen: wer welche Stage verantwortet, was ausgegeben werden darf, was zurückkam und wer abgenommen hat. Das Log-Repository des MIT-Teams enthält einen Ordner harness/ mit einer Codex-Konfiguration und einem Sandbox-Skript – eine nützliche Referenz für die Sandbox-Seite.
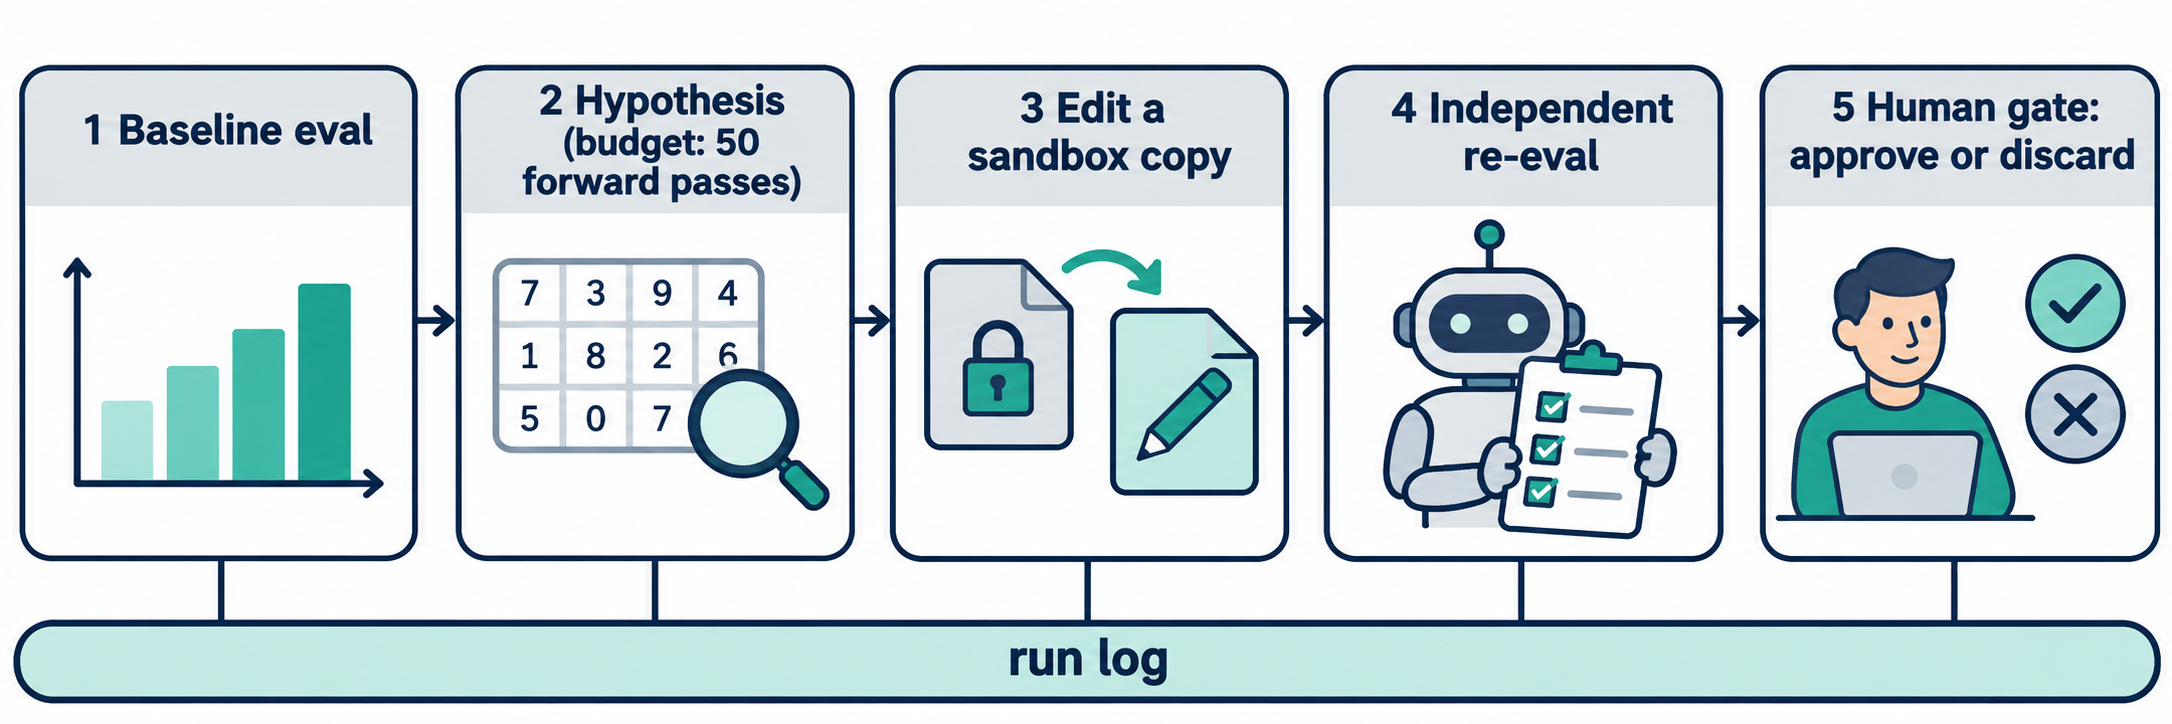
Stage 1: Baseline-Evaluation des unveränderten Modells
Die erste Aufgabe führt Ihre Evaluation auf dem ursprünglichen Checkpoint aus und hält die Scores sowie die Stellen fest, an denen das Modell scheitert. Bei Qwen3.5-0.8B erreichten 93,0 % der Läufe das Token-Limit. Die Hypothesenaufgabe braucht genau diese Fehlerbeschreibung.
Stage 2: Gewichte lesen und eine Hypothese formulieren
Das ist die Aufgabe mit dem Budget. Schreiben Sie die Zahl in den Aufgabentext, in einer Form, die der Agent nicht falsch verstehen kann:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
Das Budget in der Aufgabe ist ein Versprechen; das Budget im Sandbox-Wrapper ist die Garantie. Schreiben Sie beides, und lassen Sie den Wrapper die verbrauchten Passes ausgeben, damit die Zahl im Laufprotokoll landet.
Stage 3: Die Bearbeitung in einer Sandbox-Kopie vornehmen
Der bearbeitende Agent ändert eine Kopie des Checkpoints und meldet den Diff. Schreibzugriff auf das Original erhält er nie. Bei Sharkly bekommt jeder Aufgabenlauf sein eigenes isoliertes Verzeichnis, und Repository-Arbeit kann pro Lauf einen separaten Worktree pro Lauf nutzen, sodass Stage 3 nicht anrühren kann, was Stage 1 gemessen hat.
Stage 4: Unabhängige erneute Evaluation durch einen Reviewer-Agenten
Weisen Sie diese Stage einem anderen Agenten zu als dem, der die Bearbeitung vorgenommen hat. Er wiederholt die Evaluation aus Stage 1 und ergänzt ein Regressionsset, das der Editor nie gesehen hat. Wenn Sie eine Crew betreiben, kann der Leader die Bearbeitung an ein Mitglied und die erneute Evaluation an ein anderes übergeben. Das Muster entspricht einer Mixed-Model-Crew mit separatem Reviewer: Der Agent, der die Änderung geschrieben hat, ist nicht der Agent, der sie bewertet.
Der Editor hat auf das hin optimiert, was er sehen konnte – ein Zugewinn, der nur bei genau diesen Aufgaben auftritt, sagt daher wenig aus.
Stage 5: Menschliches Gate für den Diff
Die letzte Aufgabe erreicht einen Menschen mit drei Anhängen: der Liste der geänderten Tensoren, der Vorher-Nachher-Tabelle und den Regressionsergebnissen des Reviewers. Nichts lädt den bearbeiteten Checkpoint außerhalb der Sandbox, solange diese Aufgabe nicht weiterbewegt wird.
Dieses kurze Skript erzeugt den ersten Anhang. Es vergleicht zwei safetensors-Checkpoints und listet jeden Tensor auf, der sich geändert hat:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
Beim veröffentlichten Checkpoint sollten laut Model Card genau zwei down_proj.weight-Tensoren zu sehen sein. Wenn Ihre eigene Bearbeitung Tensoren berührt, die die Hypothese nie genannt hat, ist das ein Grund, sie zu verwerfen.
Das Board in Sharkly betreiben
Hier ist das Board für ein Experiment. Jede Zeile ist eine Aufgabe mit eigener Zuweisung, eigenem Status und eigener Laufhistorie.
| Aufgabe | Zugewiesen an | Budget oder Gate | Fertig, wenn |
|---|---|---|---|
| 1. Baseline-Evaluation | Eval-Agent | Nur Evaluationsset | Scores und Fehlernotizen sind gepostet |
| 2. Hypothese aus den Gewichten | Editor-Agent | 50 Forward-Passes | Hypothese gepostet, verbrauchte Passes protokolliert |
| 3. Bearbeitung in der Sandbox | Editor-Agent | Nur Kopie, Original schreibgeschützt | Diff und bearbeitete Datei liegen in der Sandbox |
| 4. Erneute Evaluation und Regression | Reviewer-Agent | Zurückgehaltenes Regressionsset | Vorher-Nachher-Tabelle ist gepostet |
| 5. Freigeben oder verwerfen | Ein Mensch | Menschliches Gate | Entscheidung ist in der Aufgabe festgehalten |
Verknüpfen Sie die Stages mit blocks-Beziehungen, damit das Board die Kette zeigt. Sharklys Task-Relations sind ehrlich, was ihren Umfang angeht: Eine Beziehung zeigt Abhängigkeit und Fortschritt auf der Karte, aber sie verschiebt keine Aufgabe und startet auch keinen Lauf von selbst. Lassen Sie jede Stage in Backlog, bis die vorherige abgeschlossen ist. Eine einem Agenten zugewiesene Aufgabe startet keinen Lauf, solange sie in Backlog liegt – das Verschieben daraus ist der Auslöser.
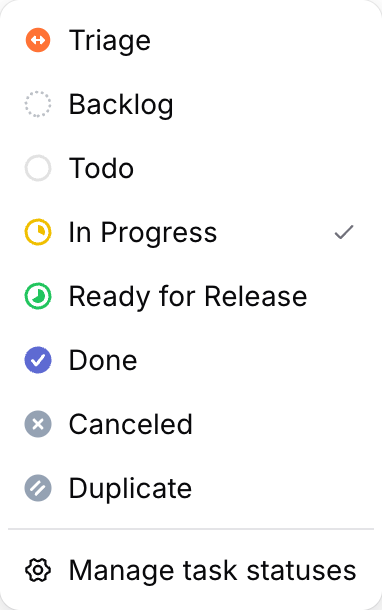
Wenn Stage 4 abgeschlossen ist, kann der Agent die Aufgabe auf menschliche Prüfung warten lassen, und die Person sieht sie im Inbox. Das Execution Log hält Start, Ende, Tool-Aufrufe und Auslöser jedes Laufs fest: Ihr Audit-Trail, direkt an der Stage, zu der er gehört. Mehr dazu, wo Sie Agenten stoppen sollten, finden Sie unter Approval Gates für Coding-Agenten.
Praktische Grenzen, bevor Sie starten
- Klein anfangen. Die Studie nutzte 0,8B- und 270M-Modelle mit CPU-Tensorzugriff. Wählen Sie ein Modell, das Sie in Minuten evaluieren können.
- Erwarten Sie keinen Zugewinn bei fehlenden Fähigkeiten. Das Gemma-Ergebnis zeigt, dass eine Bearbeitung ein Modell entblockieren kann, es aber nichts lehrt.
- Behandeln Sie einen einzelnen Lauf als Anekdote. Wiederholen Sie das Experiment mit einem frischen Agenten, bevor Sie der Bearbeitung vertrauen.
Fazit
Die übertragbare Lehre aus dem MIT-Beitrag ist der Harness: ein schriftlich festgelegtes Budget, begrenzte Tools, ein vollständiges Protokoll und Ergebnisse, die jemand anderes überprüfen kann. Genau diese Kontrollen wollen Sie ohnehin rund um einen Coding-Agenten haben, der Code bearbeitet.
Um es auszuprobieren, legen Sie die fünf Aufgaben in einem Sharkly Space an, weisen Sie die Stages 1 bis 4 Agenten auf Ihrem verbundenen Computer zu und behalten Sie Stage 5 selbst. Sharkly ist kostenlos – starten Sie auf sharkly.ai.
FAQ
Kann ein Coding-Agent Modellgewichte bearbeiten?
In der Studie des MIT CSAIL: ja. GPT-6 Astra las die Tensoren von Qwen3.5-0.8B in einer Python-Sandbox und veränderte 131.072 Gewichte. Die Autoren berichten, dass MATH-500 von 7,9 % auf 48,1 % gestiegen ist. Die Arbeit steht noch am Anfang, betrifft kleine Modelle, und mehrere Ergebnisse sind Einzelläufe.
Was ist Weight-Space-Programming?
Ein LLM liest die Parameter eines Netzwerks als Daten und bearbeitet sie direkt, ohne Training. Es analysiert Tensoren mit Code, bildet eine Hypothese, ändert die Gewichte und misst die Wirkung mit einer begrenzten Zahl von Forward-Passes.
Warum ist das Forward-Pass-Budget wichtig?
In der Qwen-Ablation der Autoren erreichten 10 Passes 12,3 % bei MATH-500, 25 Passes 14,1 % und 50 Passes 48,1 %. Das Budget legt fest, wie viele Ideen der Agent testen kann. Schreiben Sie es in die Aufgabe und setzen Sie es in der Sandbox durch.
Kann das Bearbeiten von Gewichten einem Modell neue Fähigkeiten hinzufügen?
Die Studie deutet darauf hin, dass nicht. Die beste Bearbeitung von Astra hob Gemma 3 270M bei MATH-500 von 6,8 % auf 7,7 %. Die Autoren schließen daraus, dass die Bearbeitung bei Qwen ein Hindernis entfernt hat, statt eine Fähigkeit hinzuzufügen.
Wie verhindere ich, dass bearbeitete Gewichte in die Produktion gelangen?
Binden Sie das Original schreibgeschützt ein, bearbeiten Sie eine Kopie, führen Sie eine unabhängige erneute Evaluation durch und lassen Sie den Tensor-Diff von einem Menschen freigeben, bevor irgendetwas die Datei außerhalb der Sandbox lädt.


