
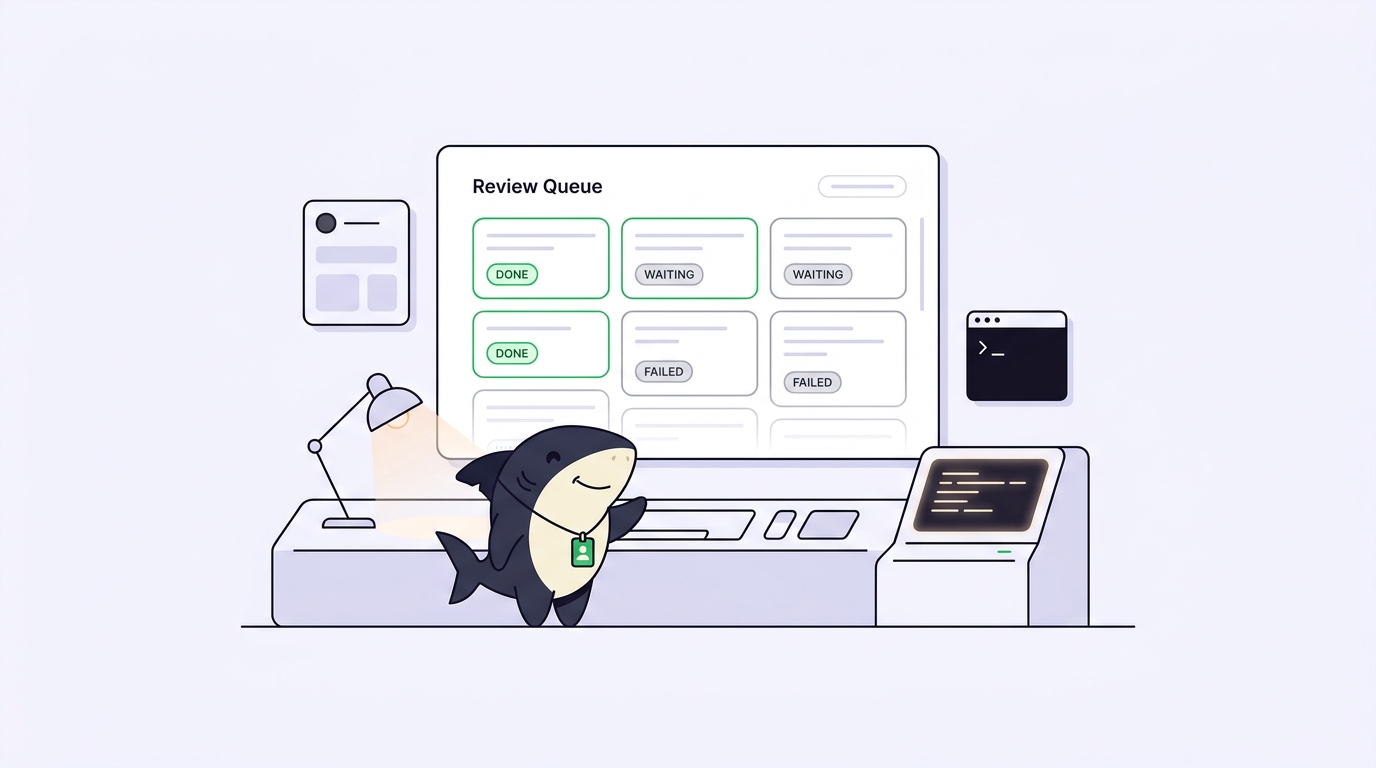
Du startest einen Coding-Agenten mit einer echten Aufgabe, klappst den Laptop zu und gehst Mittagessen. Das ist der einfache Teil. Der schwierige Teil ist das, was du bei deiner Rückkehr vorfindest: ein Terminal, dessen Ausgabe oben herausgescrollt ist, ein Diff, das du nicht hast entstehen sehen, und keine klare Antwort auf die einzige Frage, die zählt – nämlich, ob die Arbeit gut genug ist, um sie zu behalten.
Einen Agenten unbeaufsichtigt laufen zu lassen, hat zwei Hälften, und die meisten Setups lösen nur die erste. Die erste Hälfte besteht darin, den Prozess am Leben und produktiv zu halten, während niemand hinsieht. Die zweite Hälfte ist die Review-Queue: der Stapel fertiger, halbfertiger und fehlgeschlagener Runs, die auf eine menschliche Entscheidung warten, wenn du zurückkommst. Wer die zweite Hälfte auslässt, verschiebt mit unbeaufsichtigten Agenten nur den Engpass – vom Schreiben von Code hin zum Rekonstruieren dessen, was passiert ist.
Dieser Artikel behandelt beide Hälften: wie du selbst einen unbeaufsichtigten Run aufsetzt, den Failure Mode bei jedem Schritt und wo dieses Do-it-yourself-Setup aufhört zu skalieren. Wenn aus einem Terminal fünf werden, sitzt ein Task-Board wie Sharkly über deinen Coding-Agenten. Claude Code, Codex oder Gemini CLI erledigen weiterhin die Arbeit, und Sharkly hält Task, Run und Review an einem Ort – statt verstreut über Terminals, die du längst geschlossen hast.
Was es wirklich bedeutet, einen Agenten unbeaufsichtigt laufen zu lassen
Ein unbeaufsichtigter Run bedeutet, dass ein Coding-Agent eine Aufgabe auf einem Host ausführt, den du nicht aktiv beobachtest, während seine Ausgabe für die spätere Prüfung aufgezeichnet wird. Diese Definition hat drei tragende Teile: eine Aufgabe, die der Agent ohne dich abschließen kann, einen Host, der weiterläuft, wenn du die Verbindung trennst, und eine Aufzeichnung, die du danach lesen kannst.
Die Aufzeichnung ist der Teil, den die meisten unterschätzen. Wenn du einem Agenten live zusiehst, bist du das Log: Du siehst, dass er die falsche Datei auswählt, du unterbrichst, du korrigierst den Kurs. Unbeaufsichtigt passiert nichts davon. Alles, was der Agent getan hat, muss in einer Form überleben, die du dir Stunden später kalt ansehen kannst, ohne jede Erinnerung daran, was du beauftragt hast. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Vollmacht und nehmen das Ergebnis ab. Dieser Vertrag hält nur, wenn der Bericht echt und vollständig ist, wenn du zurückkommst.
Das Ziel ist also nicht „der Agent soll ohne mich laufen“, sondern „der Agent soll ohne mich laufen und mir etwas zurückgeben, das ich prüfen kann“. Das sind zwei verschiedene Probleme, und beim zweiten brechen unbeaufsichtigte Workflows meist zusammen.
Einen unbeaufsichtigten Run selbst aufsetzen
Hier ist die minimale manuelle Version, samt des Failure Mode, der bei jedem Schritt zuschlägt.
Schritt 1: Arbeit isolieren. Gib dem Run einen eigenen Checkout, damit er nicht mit deinem Editor oder einem anderen Agenten kollidiert.
git worktree add ../task-auth-refactor -b task/auth-refactor
cd ../task-auth-refactor
Failure Mode: Überspringst du das, überschreiben sich zwei Runs im selben Verzeichnis gegenseitig ihre nicht committeten Änderungen. Warum Worktrees – und nicht Branches allein – die Isolationsgrenze sind, steht unter ein Checkout pro Task.
Schritt 2: Prozess abkoppeln. Deine SSH-Session oder dein Terminal wird geschlossen, und ein Vordergrundprozess stirbt mit ihr (SIGHUP). Halte ihn mit nohup oder einer tmux-Session am Leben:
nohup claude -p "Refactor auth to use the new token service; run the tests" \
  > run.log 2>&1 &
Failure Mode: Lässt du ihn in einer einfachen Vordergrund-Shell laufen, beendet das Zuklappen des Laptops den Agenten mitten in einer Änderung über mehrere Dateien und hinterlässt einen kaputten Tree. nohup löst das Laufzeitproblem, bietet aber keinen Weg zurück hinein; tmux lässt dich wieder verbinden und sehen, was gerade passiert.
Schritt 3: Alles aufzeichnen. Das > run.log 2>&1 oben ist nicht optional. Es ist die Review-Queue in ihrer rohesten Form.
Failure Mode: Ohne aufgezeichnetes Log kannst du nicht beantworten, warum er gestoppt hat. Der häufigste stille Stillstand ist ein Agent, der ewig auf einen interaktiven Prompt wartet, den niemand beantwortet – denn unbeaufsichtigt heißt: niemand ist da, der „yes“ tippt. Lauf im nicht-interaktiven Modus und genehmige vorab die schmale Menge an Aktionen, die die Aufgabe braucht.
Schritt 4: Blast Radius begrenzen. Entscheide, bevor du weggehst, was der Agent allein tun darf und wofür er dich braucht. Begrenze den Datei-Scope, verbiete Force-Push und lass einen unbeaufsichtigten Run niemals in einen geschützten Branch mergen.
Failure Mode: Ein Run mit zu vielen Rechten, der direkt nach main pusht, ist kein Produktivitätsgewinn, sondern ein Incident. Approval Gates gibt es, damit der Agent am letzten sicheren Punkt anhält und wartet.
Schritt 5: Wissen, wann er fertig ist – und wie. Prüfe den Exit-Code und schick dir selbst ein Signal, damit du nicht von Hand ein Log pollen musst:
claude -p "..." > run.log 2>&1; echo "exit $?" | mail -s "auth run done" [email protected]
Failure Mode: Ohne Abschluss-Signal wird aus „unbeaufsichtigt“ schnell „ich schaue alle zwanzig Minuten ins Terminal“ – also betreut, nur mit extra Latenz.
Wo das Do-it-yourself-Setup aufhört zu skalieren
Ein Agent, ein Worktree, eine Logdatei: Das funktioniert, und für einen einzelnen Run brauchst du nichts Schwereres. Das Setup bricht in dem Moment auseinander, in dem es mehr als einen gibt.
Lässt du drei Agenten an drei Aufgaben laufen, hast du drei Worktrees, drei Logdateien, drei Exit-Codes und drei Abschluss-Mails, die du beim flüchtigen Draufschauen falsch liest. Die Isolation hält weiterhin. Was auseinanderfällt, ist die Review-Queue. Nichts sagt dir, welcher Run sauber durchgelaufen ist, welcher an den Tests gescheitert ist und welcher still auf einen Prompt wartet. Das rekonstruierst du von Hand, indem du Logs nacheinander liest – genau die Arbeit, die du eigentlich abgeben wolltest.
Das ist der eigentliche Preis, und er ist leicht zu übersehen, weil jedes Einzelteil für sich genommen in Ordnung aussieht. Mehrere parallele Runs zu überwachen wird zu einem echten Problem, sobald die Anzahl das überschreitet, was auf einen Bildschirm passt. Eine Logdatei beantwortet „was hat dieser Run ausgegeben“, nicht „welche drei meiner sechs Runs brauchen mich gerade jetzt“. Die Status- und Fehlersignale, die es sich zu erfassen lohnt, sortieren sich nicht von selbst in eine Queue. Und die Queue ist der ganze Sinn der Arbeit in Abwesenheit: Du willst eine nach Priorität sortierte Liste von Entscheidungen, kein Verzeichnis mit Rohausgabe.
Was ein Task-Board verändert
Ein Task-Board ist der Ort, an dem die zweite Hälfte des Problems gelöst wird. Der unbeaufsichtigte Run findet weiterhin auf einem Computer statt, mit dem du dich verbindest, und deine bestehende Runtime erledigt das Coden. Was sich ändert, ist, wo das Ergebnis landet.
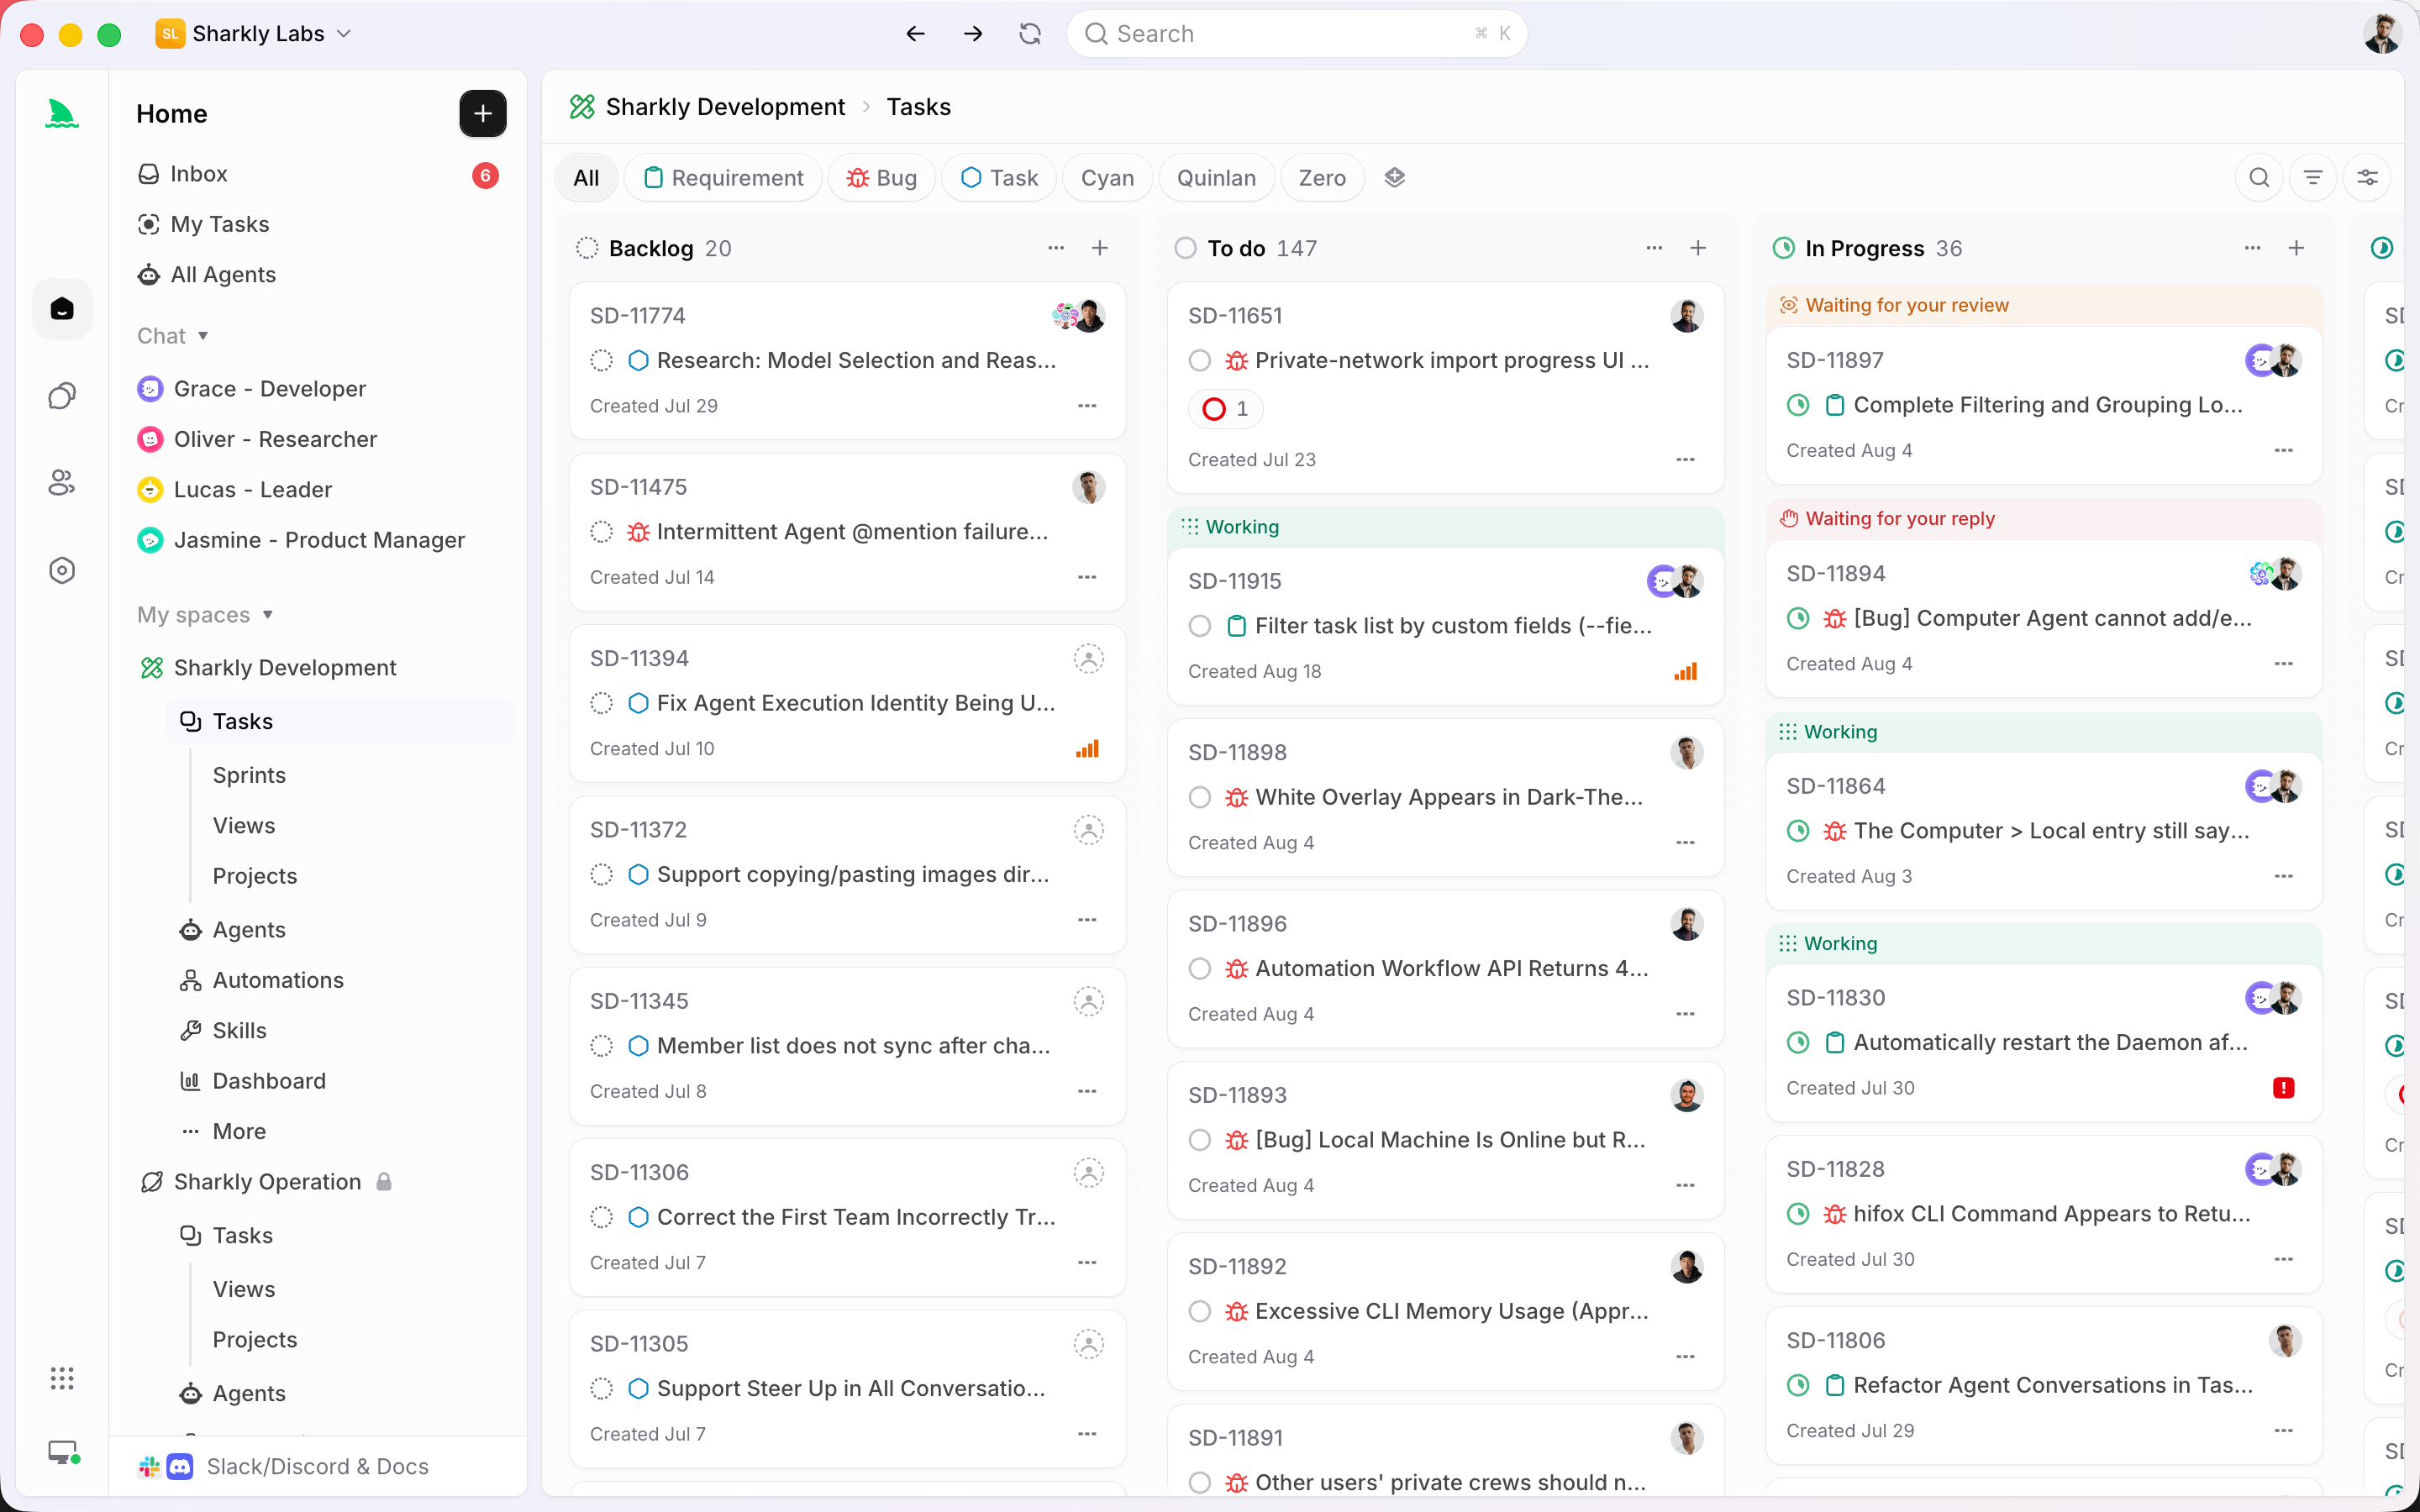
In Sharkly leben die Arbeit, der Run und das Review auf einer einzigen Task. Du weist die Task einem Agent zu – einer gespeicherten Konfiguration aus Instruktionen, Runtime und Repositories, nicht einem einmaligen Prompt, den du jedes Mal neu eintippst. Der Agent beansprucht die Task, läuft in einem isolierten Worktree, und seine Ausführung, Blocker und Ergebnisse landen in der Task-Timeline. Wenn du zurückkommst, greppst du nicht sechs Logdateien. Du öffnest das Board und liest die Queue: was fertig ist, was fehlgeschlagen ist, was auf dich wartet.
Diese Grenze sollte man klar benennen. Sharkly ersetzt nicht Claude Code, Codex oder andere Ausführungstools. Es ergänzt die gemeinsame Task-, Computer-, Kontext- und Review-Ebene um die Tools herum, die dein Team bereits nutzt. Der Agent schreibt weiterhin den Code. Sharkly sorgt dafür, dass der Code, während du weg warst, an einer Stelle gelandet ist, an der du ihn sehen kannst – mit Änderungszusammenfassung und Testergebnissen im Anhang – und dass die endgültige Abnahme eine menschliche Entscheidung bleibt. Automatisierung endet dort, wo Urteilsvermögen gefragt ist.
Du kannst das alles von Hand bauen, mit Worktrees, nohup und einem Mail-Befehl. Die ehrliche Entscheidungsregel: Wenn du nur gelegentlich einen Agenten laufen lässt, ist das manuelle Setup völlig in Ordnung und Sharkly ein Overhead, den du nicht brauchst. Die Gleichung ändert sich, wenn mehrere Agenten über Aufgaben und Repositories hinweg laufen und die Review-Queue zum Ding wird, mit dem du deinen Morgen verbringst. Wenn du weiterhin mehrere Coding-Agenten nutzen willst, statt dich auf ein Ökosystem festzulegen, dann ist genau diese Queue das Problem, um das Sharkly herum entworfen ist.
Die Review-Queue ist der eigentliche Engpass
Hier ist die Annahme, die es zu hinterfragen lohnt: Man optimiert den unbeaufsichtigten Run und behandelt das Review als Nachgedanken. Das ist verkehrt herum. Agenten parallel laufen zu lassen, während du schläfst, ist nur dann ein Gewinn, wenn das Review ihres Outputs am nächsten Morgen schneller geht, als die Arbeit selbst zu erledigen gewesen wäre. Wenn fünf Agenten über Nacht fertig werden und das Review aller fünf Diffs länger dauert als das Schreiben von zwei davon, hat die Parallelität nichts gebracht.
Deshalb: Entwirf die Review-Queue zuerst. Leg fest, was „fertig“ enthalten muss, bevor ein Run dich erreicht: bestandene Tests, einen Typecheck, eine Änderungszusammenfassung und einen Hinweis auf bekannte Grenzen. Sortiere die Queue nach Risiko, nicht nach Fertigstellungszeit, damit der Run, der die Auth angefasst hat, deine Aufmerksamkeit vor dem bekommt, der einen Tippfehler korrigiert hat. Mach „Änderungen anfordern“ genauso günstig wie „Genehmigen“, denn die Hälfte der unbeaufsichtigten Runs ist fast, aber nicht ganz richtig. Review ist der Engpass in jedem Parallel-Agenten-Workflow, und wo die Agenten physisch laufen – dein Server, dein Laptop oder beides – spielt eine weit geringere Rolle, als ob ihr Output als eine Queue ankommt, die du abarbeiten kannst.
Eine Checkliste, die du heute durchgehen kannst
Bevor du von einem Agenten weggehst, prüfe Folgendes:
- Isolation: Der Run hat seinen eigenen Worktree, nicht deinen Arbeits-Checkout.
- Laufzeit: Der Prozess übersteht eine Trennung der Verbindung (
nohup,tmuxoder ein verwalteter Computer), sodass das Zuklappen des Laptops ihn nicht mitten in der Bearbeitung killt. - Aufzeichnung: stdout und stderr landen in einem dauerhaften Log oder einer Task-Timeline, die du kalt lesen kannst.
- Nicht interaktiv: Der Agent bleibt nicht an einem Prompt hängen, den niemand beantworten kann.
- Blast Radius: Der Datei-Scope ist begrenzt, Force-Push ist aus, und kein unbeaufsichtigter Run mergt in einen geschützten Branch.
- Abschluss-Signal: Du erfährst, wann er fertig ist und ob er bestanden hat, ohne selbst nachzufragen.
- Review-Vertrag: Jeder fertige Run kommt mit Tests, einer Änderungszusammenfassung und bekannten Grenzen an, und die Abnahme bleibt bei dir.
Die ersten sechs machen den Run unbeaufsichtigt. Der letzte macht ihn lohnenswert. Wenn du bereits mehrere Agenten laufen lässt und deine Zeit morgens ins Review fließt, lass deine bestehenden Coding-Agenten über Sharkly laufen, damit die Queue organisiert bei dir ankommt statt verstreut.


