
Kostenloses Web Scraping für KI-Agenten läuft jetzt auf deiner eigenen Hardware. Firecrawl Local ist ein einzelnes Rust-Binary, das Websites scrapt, crawlt und mappt und Ergebnisse als Markdown liefert, sich als MCP-Server in Claude Code, Codex, Cursor oder Gemini CLI einklinkt und die Firecrawl-v2-API auf localhost bedient. Setze FIRECRAWL_CLOUD=off, und keine Seite, Abfrage oder URL verlässt deinen Rechner.
Kurzfassung
- Installation:
cargo install firecrawl-local(Rust plus ein C-Compiler). Unser Build dauerte 5 Minuten 55 Sekunden und erzeugte ein 19-MB-Binary. - Einbinden:
firecrawl-local initfügt den MCP-Server zu jedem unterstützten Agenten-Tool hinzu, das es findet. - Kosten: 0 $ für Scrape, Crawl, Map und Batch-Scrape. Suche, blockierte Seiten und Alexandria-Datenanbieter gehen an Firecrawl Cloud, sofern du das nicht abschaltest.
- Datenschutz-Schalter:
FIRECRAWL_CLOUD=offhält alles lokal. - Team-Setup: Installiere es einmal pro Computer, auf dem deine Agenten laufen, und jeder Agent auf diesem Computer erhält denselben Scraper.
Was Firecrawl Local ist
Firecrawl Local ist ein einzelnes Binary vom Firecrawl-Team, das Webseiten abruft, sie zu sauberem Markdown bereinigt und dasselbe JSON zurückgibt, das die gehostete Firecrawl-API liefert. Es braucht keine Datenbank, keine Queue und keinen Container. Firecrawl hat es am 18. November 2026 angekündigt, und das Crate auf crates.io war eine Woche zuvor als Version 0.1.0 erschienen.
Die README beschreibt drei Nutzungsarten: eine CLI, einen MCP-Server für Agenten und eine lokale Kopie der v2-API. Der Code zur Bereinigung wird aus derselben Quelle kompiliert, die die gehostete API verwendet; eine Markdown-Seite von deinem Laptop entspricht daher dem, was die Cloud für eine Seite zurückgeben würde, die beide erreichen können.
Firecrawls Launch-Post behauptet eine Scrape-Primitive, die 37-mal schneller als selbst gehostetes Firecrawl sein und 230-mal weniger Speicher benötigen soll, bei 11 MB im Leerlauf. Das sind Firecrawls Zahlen; die README veröffentlicht keine Methode. Den Speicherteil haben wir unten selbst gemessen.
Wenn du bereits mehrere Coding-Agenten betreibst, ist dies der erste Scraper, den du allen gemeinsam geben kannst, ohne pro Aufruf zu zahlen. Der Rest dieses Leitfadens behandelt die Einrichtung, den Datenschutz-Schalter und wie du einem ganzen Agenten-Team dasselbe Tool in Sharkly gibst.
Warum Agenten einen lokalen Scraper brauchen
Ein Agent, der das Web nicht lesen kann, arbeitet mit veralteten Trainingsdaten. Er rät bei einer API, die er noch nicht gesehen hat, oder bittet dich, Dokumentation in den Chat einzufügen.
Gehostete Scraping-APIs lösen das, verursachen aber zwei Kosten. Jede Seite ist ein abgerechneter Aufruf, ein Crawl einer 400-seitigen Doku-Website ist also eine Rechnungsposition. Und jede URL, die dein Agent öffnet, läuft über fremde Server – das zählt, wenn der Agent die Domain eines Kunden oder eine noch nicht veröffentlichte Wettbewerberseite recherchiert.
Ein lokaler Scraper beseitigt beides. Seiten werden über dein eigenes Netzwerk abgerufen und auf deiner eigenen CPU bereinigt. Der Preis dafür: Du kümmerst dich um Installation und die Einschränkungen, die ein Laptop mit sich bringt.
Firecrawl Local installieren
Du brauchst Rust und einen C-Compiler. Unter macOS deckt xcode-select --install den Compiler ab; unter Debian oder Ubuntu installierst du build-essential. Rust bekommst du über rustup.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Zwei Extras sind optional. Chrome oder Chromium ermöglicht das Rendern von Seiten, die JavaScript benötigen; ohne Browser funktionieren statische Seiten weiterhin, und eine stark skriptlastige Seite kommt mit einer Warnung zurück. Node.js 22 oder neuer wird für den MCP-Server benötigt, weil firecrawl-local mcp das npm-Paket firecrawl-mcp über npx ausführt.
Scrape, Crawl und Map über die CLI
Drei Befehle decken die meiste Agentenarbeit ab.
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
Wir haben jeden Befehl am 19. November 2026 mit ausgeschalteter Cloud ausgeführt. Ein einzelner Scrape von example.com war in 1,6 Sekunden fertig. Ein Crawl von 10 Seiten in Firecrawls eigener Dokumentation dauerte 4,2 Sekunden und schrieb 144 KB Markdown. map lieferte die Liste der Docs-URLs in 3,9 Sekunden.
| Befehl | Nützliche Flags |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (Standard: 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Jeder Befehl | --browser auto|never|always |
Eine Stolperfalle aus unserem Test: In einem Netzwerk, das das Web nur über einen Proxy erreicht, schlug der erste Scrape mit einem TLS-Fehler fehl. Das Setzen von HTTPS_PROXY behob das Problem; das Binary respektiert also die Standard-Proxy-Variablen.
Über MCP in deinen KI-Agenten einbinden
MCP (Model Context Protocol) ist der Standard, über den ein Agenten-Tool externe Tools lädt. Firecrawl Local registriert sich als solches.
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
Der Dry Run auf unserem Mac listete fünf Ziele auf: Claude Code in ~/.claude.json, Claude Desktop, Cursor in ~/.cursor/mcp.json, Gemini CLI in ~/.gemini/settings.json und Codex in ~/.codex/config.toml. Windsurf wird ebenfalls unterstützt, wenn es installiert ist. Starte jedes Tool nach init neu, damit es den Server lädt. Mit --agent cursor richtest du nur ein Tool ein.
Um es manuell hinzuzufügen, registriere das Binary als stdio-Server:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
Der Agent erhält die standardmäßigen Firecrawl-MCP-Tools. Scrape, Crawl, Map und Batch-Scrape laufen lokal; der Rest geht an Firecrawl Cloud. Das Flag --public-only ist unsere Ergänzung und wird unten im Abschnitt zur Sicherheit erklärt.
Cloud für den Datenschutz ausschalten
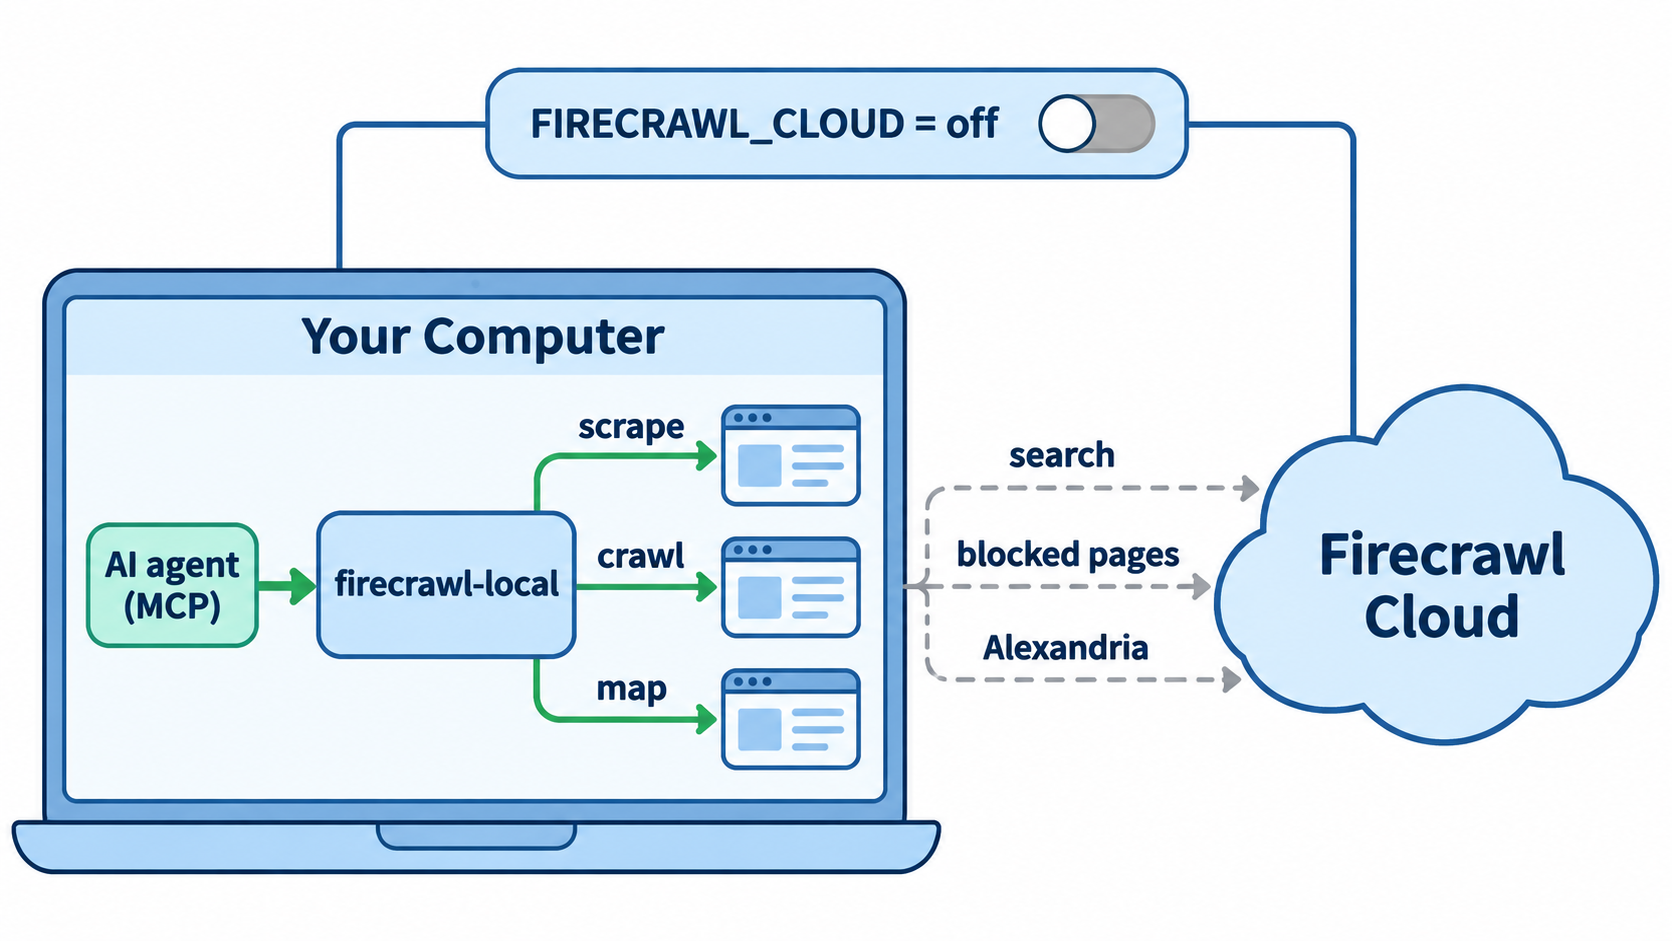
Drei Aufgaben benötigen Firecrawl Cloud, denn ein Laptop hat keinen Suchindex und keine Möglichkeit, eine Website zu umgehen, die ihn blockiert.
| An Firecrawl Cloud gesendet | Warum | Konto |
|---|---|---|
| Suchanfragen | Kein lokaler Suchindex | Nein; die Suche ohne Schlüssel ist begrenzt |
| URL einer Seite, die dich blockiert hat | Die Cloud ruft sie für dich ab | Nein |
| Alexandria-Datenanbieter | Anbieter laufen in der Cloud | Ja, ein kostenloses Konto über firecrawl-local login |
| Eine zufällige Installations-ID und der Name deines Tools | Installationszählung | Nein |
Die Variable FIRECRAWL_CLOUD steuert die Übergabe. auto (Standard) erlaubt alles oben Genannte. search sendet nur Suchanfragen. off sendet nichts, und ein unbekannter Wert gilt ebenfalls als off. Eine aus der Cloud abgerufene Seite wird mit "source": "firecrawl-cloud" gekennzeichnet, sodass du nachvollziehen kannst, was deinen Rechner verlassen hat.
Für Agentenarbeit auf Kundenseiten oder interne Recherche beginne mit off. Dein Agent verliert die Websuche; kombiniere ihn daher mit dem Suchtool, dem du bereits vertraust.
Die Firecrawl-API lokal betreiben
firecrawl-local serve bedient die Firecrawl-v2-API auf Port 3002 ohne API-Schlüssel für lokale Routen. Vorhandener SDK-Code wechselt, indem du eine URL änderst.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Lokale Routen sind POST /v2/scrape, POST /v2/map, Crawl und Batch-Scrape mit ihren Status- und Cancel-Endpunkten sowie GET /health. Andere /v2-Routen wie /v2/search werden an die Cloud weitergeleitet; v0 und v1 werden nicht bedient.
Wir haben den Speicherverbrauch im Betrieb gemessen: Der serve-Prozess lag im Leerlauf bei 10 MB residentem Speicher und nach einem Scrape bei 16 MB. Das kommt Firecrawls Angabe von 11 MB nahe. Ein Scrape über die API gab "creditsUsed": 0 und "engine": "local-fetch" zurück.
Sicherheitsvoreinstellungen, die für Agenten zählen
Ein Agent, der eine Seite mit versteckten Anweisungen liest, kann dazu gebracht werden, eine interne URL abzurufen. OWASP führt diese Angriffsklasse als Prompt Injection; ein Scraper ist der offensichtliche Weg dafür.
servebindet an127.0.0.1und lehnt localhost- und private Adressen ab, sofern du nicht--allow-privateübergibst. Wir haben es gebeten,127.0.0.1:22zu scrapen, undBLOCKED_TARGETerhalten.- Das Binden an einen anderen Host mit
--hosterfordert--token. - Link-Local- und Cloud-Metadaten-Adressen werden in jedem Modus blockiert, auch nach Weiterleitungen.
scrape,crawlundmcperreichen das private Netzwerk standardmäßig, weil sie für die Person an der Tastatur laufen. Füge--public-onlyhinzu, wenn ein Agent Websites besucht, denen du nicht vertraust.- Crawls lesen
robots.txt(Standard RFC 9309), und Website-Betreiber können den Crawler alsFirecrawlLocalansprechen.
Einschränkungen, die du einplanen solltest
- Lokal gibt es keine
json- odersummary-Formate und keine Browser-actions. Unseresummary-Anfrage gab Metadaten plus eine Warnung zurück, dass das Format übersprungen wurde. - Screenshots benötigen Chrome.
- Crawl- und Batch-Jobs liegen im Speicher, laufen eine Stunde nach ihrem Start ab und enden, wenn
servestoppt. - Lizenz: Das Repository ist unter AGPL-3.0 lizenziert. Kläre das mit deinem Rechtsteam, bevor du eine modifizierte Kopie in einem gehosteten Produkt auslieferst.
Für Warteschlangen, Worker und alle Formate beschreibt Firecrawls Anleitung zum Selbst-Hosting den vollständigen Server.
So bekommt jeder Agent im Team denselben Scraper
Wer mit einem Agenten arbeitet, kann hier aufhören. Ein Team mit mehreren Agenten stößt auf ein anderes Problem: Die Tools jedes Agenten liegen in der Konfiguration des Computers, auf dem er läuft, und niemand verfolgt, welcher Agent das Web lesen kann.
In Sharkly läuft ein Agent über eine Runtime auf einem Computer (ein Laptop, Server oder Container, den du verbindest); die Runtime ist das dort installierte Agenten-Tool, etwa Claude Code oder Codex. Du installierst Tools auf dem Computer genauso wie für die direkte Nutzung. Die Einstellungen Tools, Knowledge & MCP eines Agenten listen dann die MCP-Server auf, die er von Claude Code auf diesem Computer erbt, einschließlich stdio-Servern aus der Benutzerkonfiguration – dem Bereich, in den init schreibt.
Die Einrichtung ist also: Installiere Firecrawl Local auf dem Computer, führe init aus, öffne die Einstellungen des Agenten und klicke auf Check. Wir haben bestätigt, dass das Panel stdio-Server aus der Benutzerkonfiguration auflistet; wir haben noch keinen Firecrawl-Scrape in einer Sharkly-Task ausgeführt, teste daher zuerst eine schreibgeschützte Task.
Setze den Scraper auf einen dauerhaft laufenden Computer
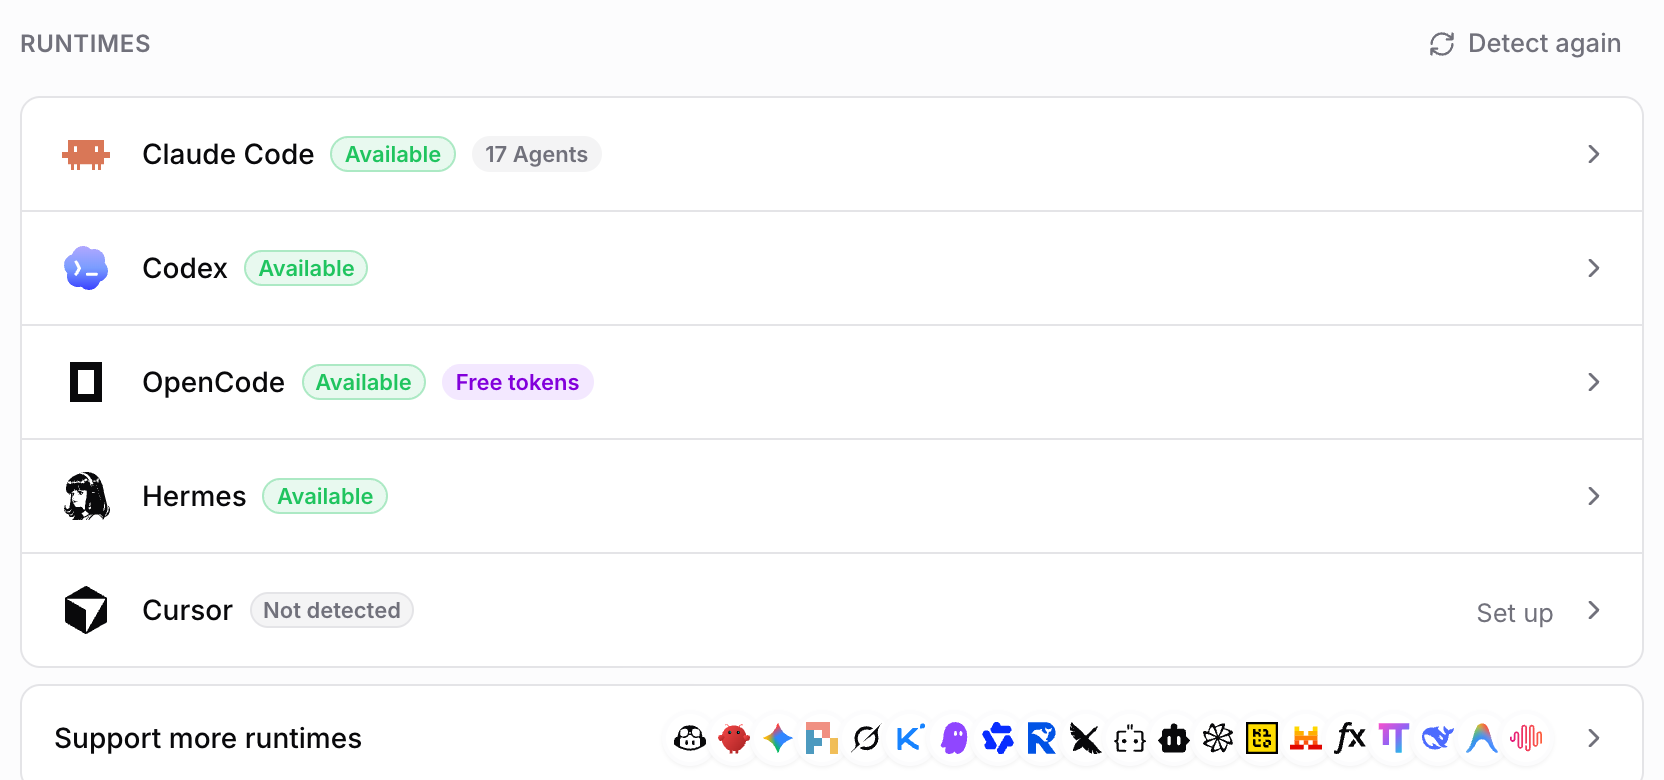
Ein Laptop geht in den Ruhezustand. Ein kleiner Linux-Server, der als Computer registriert ist (sharkly computer register mit einem sit_-Installationstoken, laut Computers-Dokumentation), bleibt online; jeder Agent, der auf ihn zeigt, teilt sich dann einen Scraper und eine FIRECRAWL_CLOUD-Richtlinie. Setze die Variable in der Runtime-Umgebung des Agenten, damit die Richtlinie mit dem Agenten wandert und nicht mit der Person, die sich zuletzt angemeldet hat.
Von dort aus wird Recherche zu delegierbarer Arbeit. Eine Crew-Leiterin oder ein Crew-Leiter zerlegt „die Docs dieser fünf Anbieter mappen“ in Tasks, jeder Agent crawlt seinen Anteil lokal, und die Ergebnisse landen zur menschlichen Prüfung auf dem Board. Sharkly ist heute für Organisationen mit bis zu 5 Personen kostenlos, und Agents und Computers belegen keine Sitze; Modelle laufen weiterhin über deine eigenen Abos.
Praxisbeispiele
- Doku-Ingestion: Crawle die Dokumentation einer Bibliothek in Markdown, bevor ein Agent eine Abhängigkeit aktualisiert.
- Lead-Recherche: Kombiniere lokales Scraping mit Alexandria-Anbietern, wie in unserer Anleitung zum Erstellen einer Lead-Liste.
- Changelog-Beobachtung: Eine geplante Task erstellt täglich eine URL-Map der Website eines Anbieters und markiert neue URLs.
- Vertrauliche Recherche: Scrape Kunden- oder Pre-Launch-Seiten mit ausgeschalteter Cloud, damit nichts dein Netzwerk verlässt. Unser Artikel darüber, warum das Abschalten der Websuche Datenlecks bei KI-Agenten nicht verhindert, behandelt die übrigen Abflüsse.
Fazit
Firecrawl Local macht kostenloses Web Scraping für KI-Agenten zu einem Build von sechs Minuten und einem einzigen init-Befehl. Lass FIRECRAWL_CLOUD=off für vertrauliche Arbeit, füge --public-only für nicht vertrauenswürdige Websites hinzu und behandle die Geschwindigkeitsangaben als Firecrawls Aussage, bis du sie selbst gemessen hast.
Dein nächster Schritt: Installiere es auf dem Computer, den deine Agenten bereits nutzen, und verbinde diesen Computer dann mit Sharkly, damit jeder Agent im Team denselben Scraper und dieselben Regeln erhält. Weitere 0-$-Setups findest du unter kostenlose KI-Agenten für Teams.
FAQ
Ist Firecrawl Local kostenlos? Ja. Scrape, Crawl, Map und Batch-Scrape laufen lokal ohne API-Schlüssel, und unser Test-Scrape meldete 0 verbrauchte Credits. Suche und Alexandria nutzen Firecrawl Cloud.
Benötigt Firecrawl Local Docker? Nein. Es ist ein einzelnes Binary ohne Datenbank, Queue oder Container. Docker ist nur eine Option; JavaScript-Rendering in einem Container benötigt ein seccomp-Profil, das Chromes Sandbox erlaubt.
Welche Agenten unterstützt firecrawl-local init? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI und Codex. Jeder andere MCP-Client kann firecrawl-local mcp als stdio-Server registrieren.
Kann ich alles Scraping von Firecrawls Servern fernhalten? Ja. Setze FIRECRAWL_CLOUD=off. Dann entfallen Suche, der Fallback für blockierte Seiten und Alexandria.
Ist Firecrawl Local schneller als selbst gehostetes Firecrawl? Firecrawl sagt 37-mal schneller und 230-mal weniger Speicher. Wir haben 10 MB Speicher im Leerlauf gemessen, was der Speicherangabe entspricht; die Geschwindigkeit haben wir nicht gegen einen selbst gehosteten Server gebencht.
Ist Firecrawl Local Open Source? Das Repository ist unter AGPL-3.0 lizenziert. Lies die Lizenz, bevor du eine modifizierte Kopie als Teil eines gehosteten Dienstes auslieferst.


