

GPT-6.2 Astra vs. Fable 5.2 ist knapper, als die Schlagzeilen vermuten lassen. Beide sind mit 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens gelistet. Anthropic veröffentlicht höhere Agentic-Coding-Werte für Fable 5.2; OpenAI veröffentlicht für Astra keinen Coding-Benchmark. Cache-Preise, Long-Context-Zuschläge und deine eigene Rate akzeptierter Änderungen entscheiden, wer für dein Team gewinnt.
OpenAI hat GPT-6.2 Astra am 17. November 2026 veröffentlicht, acht Tage nachdem Anthropic Claude Fable 5.2 ausgeliefert hat. Beide sind Frontier-Modelle für lange, anspruchsvolle Agentenarbeit. Wenn du Coding-Agenten betreibst, hast du jetzt zwei Flaggschiff-Optionen zum gleichen Listenpreis.
Ein Leaderboard kann das für dich nicht klären. Deine Abhängigkeiten, deine Test-Suite und deine Reviewer können es. Dieser Leitfaden vergleicht die veröffentlichten Zahlen, zeigt, wo die Rechnungen auseinandergehen, und gibt dir einen direkten Vergleichstest, den du in deinem eigenen Repository ausführen kannst. Wenn du Codex und Claude Code bereits parallel betreibst, ist Sharkly der Ort, an dem du beiden dieselbe Aufgabe zuweist und die Ergebnisse zusammenführst.
GPT-6.2 Astra vs. Fable 5.2: die Specs im direkten Vergleich
GPT-6.2 Astra ist OpenAIs Frontier-Modell aus der GPT-6.2-Familie; GPT-6.2 Sol ist das günstigere Alltagsmodell. Claude Fable 5.2 ist Anthropics bestes allgemein verfügbares Modell, während Mythos 5.2 als Release mit begrenztem Zugang zurückgehalten wird. Hier ist, was jeder Anbieter veröffentlicht – Stand 20. November 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Veröffentlicht | 17. November 2026 | 9. November 2026 |
| API-Modell-ID | gpt-6.2-astra |
claude-fable-5-2 |
| Input, pro 1 Mio. Tokens | 8 $ | 8 $ |
| Output, pro 1 Mio. Tokens | 40 $ | 40 $ |
| Gecachter Input (Cache-Hit) | 0,40 $ | 0,20 $ |
| Cache-Schreiben | 10 $ (30 Minuten) | 10 $ (5 Minuten), 16 $ (1 Stunde) |
| Batch | 50 % des Standardpreises | 4 $ Input, 20 $ Output |
| Fast-Modus | 2x Standard | 16 $ Input, 80 $ Output |
| Kontextfenster | 1.050.000 Tokens (max. 922.000 Input) | 1 Mio. Tokens zum Standardpreis |
| Max. Output | 128.000 Tokens | 128.000 Tokens |
| Long-Input-Zuschlag | Über 272K Input: Input- und Cache-Preise verdoppeln sich, Output 1,5x | Keiner angegeben |
| Üblicher Coding-Agent | Codex | Claude Code |
Quellen: OpenAIs GPT-6.2 Astra Modellseite, Anthropics Preisdokumentation und Modellübersicht.
Zwei Zeilen sind für Agenten am wichtigsten. Ein Coding-Agent sendet seinen Kontext in jedem Turn erneut, daher bestimmt der Cache-Hit-Preis den Großteil der Rechnung. Und ein Agent, der ein großes Repository gelesen hat, kann 272K Input-Tokens überschreiten – dort ändern sich Astrias Preise.
Was die Coding-Benchmarks sagen – und was sie nicht sagen
Anthropics Fable 5.2-Ankündigung berichtet 69,9 % auf FrontierSWE v2 und 49,1 % auf FrontierCode 2.0 bei Xhigh-Beanspruchung. In derselben Tabelle ist die OpenAI-Vergleichsspalte als GPT-6 Astra, die vorherige Generation, with 65,5 % und 42,8 % gekennzeichnet.
Diese Tabelle enthält GPT-6.2 Astra nicht. Auch OpenAIs Modellseite listet keinen SWE-artigen Coding-Wert dafür auf. Simon Willsons Launch-Artikel merkt an, dass „Astra 6.2 in verschiedenen Benchmarks nicht ganz so hoch punktet wie Fable 5.2" und dass einige Nutzer seinen Kommunikationsstil „verwirrend" finden können.
Die ehrliche Lesart hat also drei Teile:
- Fable 5.2 hat veröffentlichte, anbieterseitig durchgeführte Agentic-Coding-Werte, die vor dem letzten Astra liegen.
- Kein Anbieter hat einen direkten Coding-Vergleich gegen GPT-6.2 Astra veröffentlicht.
- Jede Zahl oben wurde vom jeweiligen Anbieter des Modells auf seinem eigenen Harness mit gewählten Effort-Leveln ermittelt.
Behandle Benchmarks als Filter für die Vorauswahl. Dieser Artikel enthält keine unabhängigen Testergebnisse für eines der beiden Modelle.
Wo die Rechnungen auseinandergehen
Gleiche Listenpreise bedeuten nicht gleiche Rechnungen. Drei Mechanismen spalten sie.
Cache-Hits
Fable 5.2 berechnet 0,20 $ pro Million Tokens bei einem Cache-Hit. Astra berechnet 0,40 $. Für einen Agenten, der ein gecachtes Prefix von 100.000 Tokens in einer Sitzung 50-mal erneut sendet, kostet dieses Prefix 1,00 $ bei Fable und 2,00 $ bei Astra – noch bevor neuer Input und Output hinzukommen. Simon Willison nennt Astrias gecachten Preis weiterhin „großartige Neuigkeiten für länger laufende agentische Sitzungen"; er liegt weit unter dem ungecachten Preis von 8 $.
Long Context
Astrias Preise steigen, sobald eine Anfrage über 272K Input-Tokens geht. Anthropic listet den vollen 1M-Kontext für Fable zum Standardpreis. Wenn deine Agenten routinemäßig ein halbes Monorepo laden, rechne diese Schwelle durch, bevor du dich festlegst.
Effort und Tokens pro Aufgabe
Beide Modelle bieten Effort-Level, und höherer Effort verbraucht mehr Tokens. Simons informeller SVG-Test zeigt die Spanne bei einem Prompt: GPT-6.2 Astra kostete 11,55 Cent bei High-Effort und 88,71 Cent bei Max. Das ist ein Spielzeug-Prompt, kein Coding-Benchmark, aber die 7-fache Differenz zeigt, warum du das Effort-Level festlegen solltest, bevor du Kosten vergleichst.
Unsere Fable 5.2-Preisanalyse arbeitet Retries und Review-Zeit durch; der GPT-6.2 Rate-Limits-Leitfaden behandelt das Tokens-pro-Minute-Limit, an das Astra-Agenten zuerst stoßen.
So führst du einen GPT-6.2 Astra vs. Fable 5.2-Test in deinem eigenen Repo aus
Ein direkter Vergleich in deinem eigenen Code schlägt jede veröffentlichte Tabelle. Die folgende Methode folgt unserem ausführlicheren Leitfaden zur Evaluierung von Fable 5.2 in deiner Codebasis; hier läuft sie als Duell zwischen zwei Modellen.
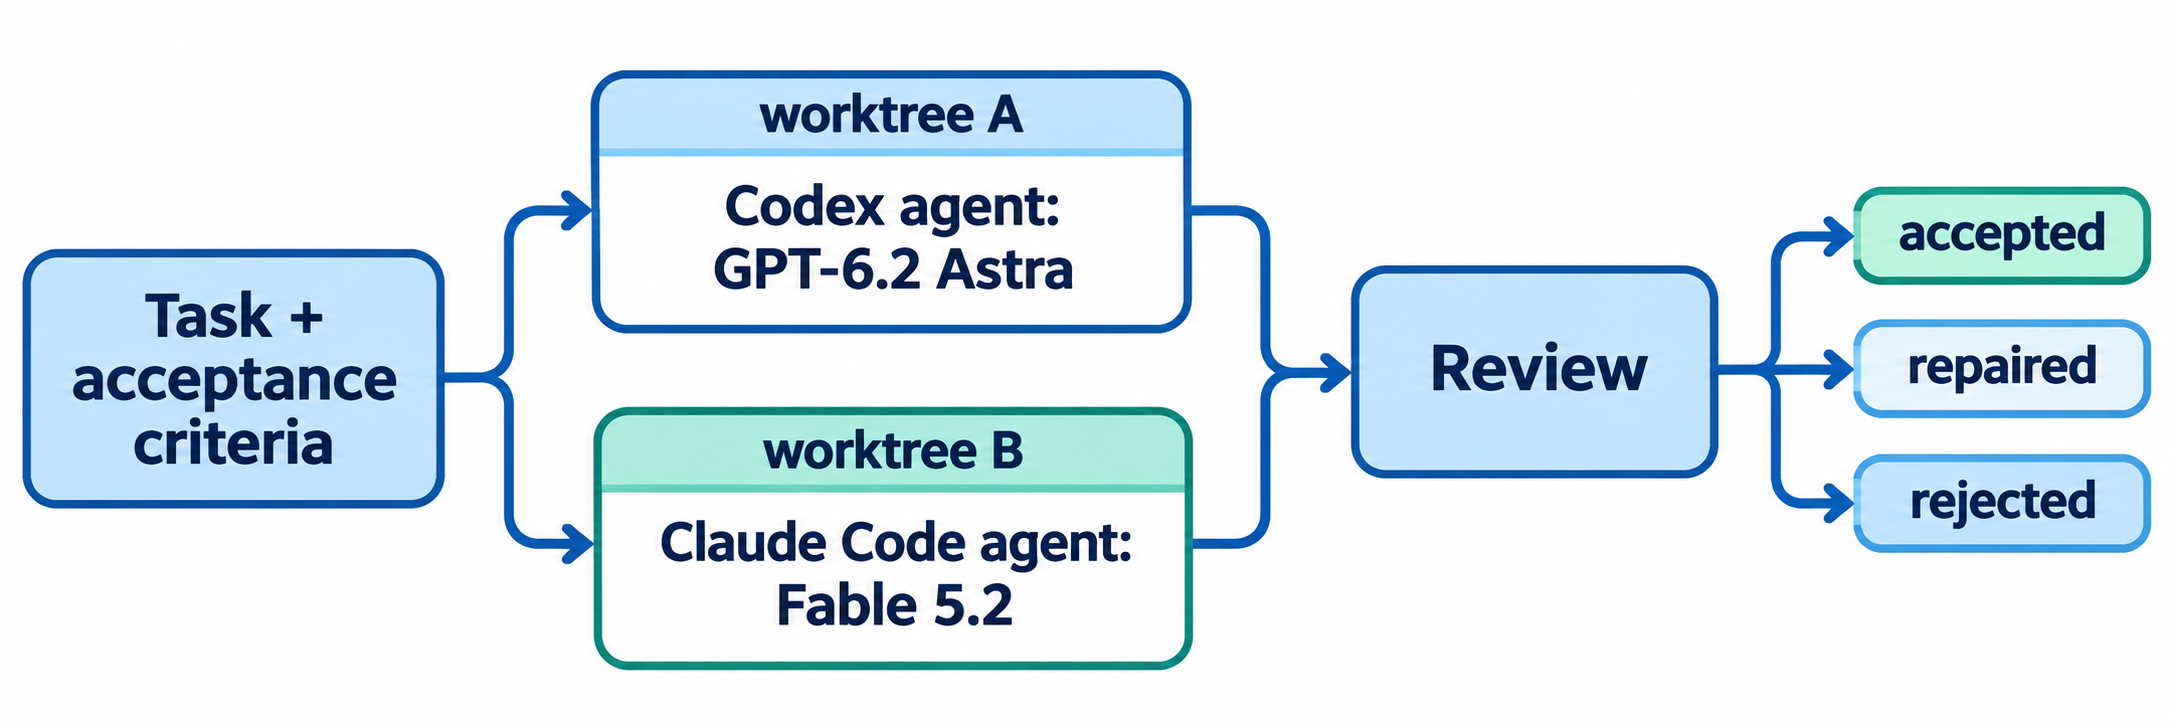
- Wähle 10 bis 12 aktuelle Aufgaben aus deinem Backlog: Bugfixes, kleine Erweiterungen, ein Refactoring und eine Investigation.
- Schreibe zuerst die Akzeptanzkriterien, bevor ein Agent läuft, damit kein Ergebnis die Messlatte beeinflusst.
- Lege das Harness fest. Astra läuft am besten in Codex und Fable in Claude Code, also vergleichst du zwei vollständige Workflows. Schreibe das in deinem Bericht.
- Lege das Effort-Level fest. Wähle bei beiden High oder benenne die exakten Einstellungen, die du verwendet hast.
- Isoliere jeden Versuch in einem frischen Git-Worktree, damit kein Agent die Änderungen des anderen übernimmt.
- Führe jede Aufgabe auf beiden Modellen aus und wechsle ab, welches zuerst läuft.
- Bewerte nach Möglichkeit blind und bewerte jedes Ergebnis als akzeptiert, nach Reparatur akzeptiert oder abgelehnt.
- Teile die Gesamtkosten durch die akzeptierten Änderungen, fehlgeschlagene Versuche eingeschlossen.
Kosten pro akzeptierter Änderung sind die Zahl, die entscheidet. Ein Modell, das pro Token 20 % günstiger ist, aber einen zusätzlichen Reparaturzyklus pro Aufgabe braucht, ist für dein Team das teurere Modell.
Führe beide Modelle als Agents in Sharkly aus
Sharkly führt die Coding-Agenten aus, die du bereits nutzt; es ersetzt sie nicht. Ein Agent in Sharkly ist ein konfigurierter KI-Teamkollege, der Tasks über eine Runtime wie Codex oder Claude Code auf einem Computer ausführt, den du verbindest.
Richte das Duell mit zwei Agents ein:
- Astra Agent: eine Codex-Runtime, konfiguriert für
gpt-6.2-astra. - Fable Agent: eine Claude-Code-Runtime, konfiguriert für
claude-fable-5-2.
Jeder Agent hat ein Standardmodell, das unter Computer, Runtime und Working directory aus den Modellen gewählt wird, die seine Runtime meldet. Prüfe das Sharkly Help Center für die aktuellen Agent-Einstellungen.
Setze auf beiden Agents die gleichen Ausführungslimits, damit keiner mehr parallele Läufe oder ein längeres Zeitbudget bekommt als der andere.

Nutze den Modus Temporary working directory, damit jede Task ein isoliertes Verzeichnis erhält und repository-basierte Läufe einen frischen Worktree vorbereiten können. Setze die Akzeptanzkriterien in die Task-Beschreibung. Jeder Agent meldet seinen Patch und seine Checks an seine eigene Task zurück, sodass jeder Versuch direkt neben dem Urteil des Reviewers liegt.
Die Modellnutzung läuft über deine eigenen Abonnements und API-Keys. Sharkly verkauft keine Tokens, und das Modellkontingent hängt von den Tools, Tarifen und API-Konten ab, die dein Team verbindet.
Alternativen zur direkten Entscheidung Astra vs. Fable
Du musst nicht ein einziges Modell krönen.
- Nach Aufgabentyp aufteilen. Nutze Fable 5.2 für Kategorien, in denen es deinen Test gewinnt, Astra für den Rest.
- Mit einem vorangehen, mit dem anderen besetzen. Ein Frontier-Modell plant und reviewt; ein günstigeres Modell erledigt die Routineanteile – das Muster aus GPT-6 Astra als dein Crew-Leader.
- Eine Stufe heruntergehen. GPT-6.2 Sol ist mit 2 $ Input und 10 $ Output pro Million Tokens gelistet. Für routinemäßige Wartung könnte es deine Messlatte zu einem Viertel des Preises erfüllen.
- Beide aktiv halten. Anbieterneutralität ist der Punkt: Kein einzelnes Modell bleibt lange das beste, wie Argon, Astra und Opus argumentierten.
Praxisnahe Anwendungsfälle
- Große Migrationen. Anthropic berichtet von einem Team aus Fable 5.2-Agenten, das einen Produktionsdienst von Python nach Rust migriert hat. Teste diese Art von Arbeit mit deinem eigenen Ausschnitt, bevor du einem der Modelle so etwas anvertraust.
- Investigations in großen Repos. Überschreite 272K Input-Tokens, und Astrias Preise ändern sich. Rechne das Kostenmodell mit deiner realen Kontextgröße durch.
- Parallele Bug-Queues. Zehn kleine Fixes, aufgeteilt auf beide Agents, liefern dir innerhalb einer Woche eine Rate akzeptierter Änderungen pro Modell.
Fazit
GPT-6.2 Astra und Fable 5.2 kosten auf dem Papier gleich viel pro Token. Fable hat die stärkeren veröffentlichten Coding-Werte und günstigere Cache-Hits; Astra hat ein etwas größeres Kontextfenster, aber steilere Preise über 272K Input. Keine dieser Tatsachen sagt dir, welches Modell mehr akzeptierten Code in deinem Repository abliefert.
Führe das Duell durch. Verbinde einen Computer mit Sharkly, erstelle einen Codex-Agenten auf GPT-6.2 Astra und einen Claude-Code-Agenten auf Fable 5.2 und weise beiden diese Woche dieselben fünf Aufgaben zu. Behalte das Modell, das bei den Kosten pro akzeptierter Änderung gewinnt.
FAQ
Ist GPT-6.2 Astra günstiger als Claude Fable 5.2?
Nein. Beide sind mit 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens gelistet. Fables Cache-Hits sind günstiger (0,20 $ vs. 0,40 $), und Astrias Preise steigen über 272K Input-Tokens.
Welches ist besser zum Programmieren, GPT-6.2 Astra oder Fable 5.2?
Anthropic berichtet höhere Agentic-Coding-Werte für Fable 5.2 als für den vorherigen GPT-6 Astra. Kein veröffentlichter Benchmark vergleicht Fable 5.2 direkt mit GPT-6.2 Astra, teste also beide mit deinen eigenen Aufgaben.
Wie groß ist das Kontextfenster von GPT-6.2 Astra und Fable 5.2?
GPT-6.2 Astra listet 1.050.000 Tokens mit einer Input-Obergrenze von 922.000 Tokens. Fable 5.2 enthält einen 1 Mio. Token-Kontext zum Standardpreis. Beide begrenzen den Output auf 128.000 Tokens.
Kann ich GPT-6.2 Astra in Claude Code oder Fable 5.2 in Codex nutzen?
Jedes Modell wird üblicherweise im Coding-Agenten seines eigenen Anbieters ausgeführt: Astra in Codex, Fable in Claude Code. Ein Vergleich bedeutet daher meist den Vergleich zweier vollständiger Workflows – Modell plus Harness.
Wie vergleiche ich zwei Coding-Modelle fair?
Nutze dieselben Aufgaben, vorab geschriebene Akzeptanzkriterien, feste Effort-Level und isolierte Worktrees. Bewerte akzeptierte, reparierte und abgelehnte Ergebnisse und teile die Gesamtkosten durch die akzeptierten Änderungen.
Wählt Sharkly das Modell für meinen Agent aus?
Nein. Du wählst das Standardmodell jedes Agents aus den Modellen, die seine Runtime meldet. Sharkly routet Aufgaben nicht automatisch zwischen Modellen.


