
Die Kosten von Gemini 4 Neon pro Aufgabe hängen von mehr ab als dem Listenpreis von 3 / 15 Dollar pro Million Tokens. Google sagt, dass Neon auf der Standard-Denkstufe high 32 % weniger pro Aufgabe kostet als Gemini 4 Carbon. Pro Token ist Neon 50 % teurer als Carbons Einführungspreis und 25 % günstiger als Carbons Preis ab dem 1. Dezember 2026. Welches Modell für Ihre Agents günstiger ist, hängt davon ab, wie viele Tokens pro Aufgabe anfallen und wie viele Versuche Ihr Team akzeptiert.
TL;DR
- Neon-Listenpreis: 3 $ pro 1 Mio. Eingabe-Tokens, 15 $ pro 1 Mio. Ausgabe-Tokens (inkl. Thinking), 0,15 $ pro 1 Mio. gecachten Eingabe-Tokens. Nur bezahlter Tarif.
- Carbon-Listenpreis: 2 / 10 $ bis zum 30. November 2026, danach 4 / 20 $ ab dem 1. Dezember.
- Googles Behauptung: 32 % niedrigere Kosten pro Aufgabe als Carbon bei
high, basierend auf einem Diagramm des Artificial Analysis Intelligence Index. Der Beitrag sagt nicht, welcher Carbon-Preis im Diagramm verwendet wurde. - Was das bedeutet: Neon schlägt Carbons Einführungspreis nur, wenn es dieselbe Aufgabe mit weniger als zwei Dritteln der Tokens von Carbon abschließt. Ab dem 1. Dezember gewinnt Neon, außer es verbraucht ein Drittel mehr Tokens als Carbon.
- Was Sie messen sollten: Kosten pro akzeptierter Änderung, nicht Kosten pro Versuch.
Die Preise von Gemini 4 Neon im Vergleich zu Carbon und Hydrogen
Gemini 4 Neon ist das mittlere Modell von Googles Gemini-4-Familie, veröffentlicht am 18. November 2026 als gemini-4-neon. Die Modellkarte beschreibt es als aus Carbon abgeleitet und darauf ausgelegt, „Tiefe und Effizienz“ auszubalancieren. Hier sind die Standardpreise des bezahlten Tarifs pro 1 Mio. Tokens laut Preisseite der Gemini API:
| Modell | Eingabe | Ausgabe (inkl. Thinking) | Gecachte Eingabe | Batch-Eingabe / -Ausgabe | Free-Tarif |
|---|---|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | 0,15 $ | 1,50 $ / 7,50 $ | Nein |
| Gemini 4 Carbon, bis 30. Nov. | 2,00 $ | 10,00 $ | 0,10 $ | 1,00 $ / 5,00 $ | Nein |
| Gemini 4 Carbon, ab 1. Dez. | 4,00 $ | 20,00 $ | 0,20 $ | 2,00 $ / 10,00 $ | Nein |
| Gemini 4 Hydrogen (bezahlter Tarif) | 1,50 $ | 7,50 $ | 0,075 $ | 0,75 $ / 3,75 $ | Ja |
Alle drei Modelle unterstützen ausschließlich implizites Caching. Neons AI-Studio-Leitfaden sagt, dass implizites Caching ab Prompts mit mindestens 4.096 Tokens greift und 95 % auf gecachte Eingaben spart. Neon hat kein explizites Caching – entfernen Sie daher alle cached_content-Felder, wenn Sie ein Carbon-Setup migrieren.
Google berechnet „jedes Token, das das Modell verarbeitet, einschließlich Thinking-Tokens sowie interner Grounding-Systemanweisungen und Funktionsdeklarationen“. Bei einem Agent mit vielen Tools entstehen diese Deklarationen bei jedem Durchlauf.
Wie Google Neons Kosten pro Aufgabe misst
Die Kosten pro Aufgabe sind die Gesamtausgaben eines Modells, um eine Benchmark-Aufgabe abzuschließen: die verbrauchten Tokens multipliziert mit seinem Preis. In Googles Launch-Beitrag heißt es, dass Neon bei high „einen hohen Artificial Analysis Intelligence Index Score mit 32 % niedrigeren Kosten pro Aufgabe als Carbon“ verbindet. Das Diagramm ist mit „AA Index v5.01 cost per task“ beschriftet.
Artificial Analysis ist ein Drittanbieter, nicht Google. Der Beitrag nennt zwei weitere Kostenaussagen, die sich beide nicht auf Carbon beziehen:
- Neon arbeitet mit „grob 50 % bis 80 % niedrigeren Kosten pro Aufgabe als die besten konkurrierenden Frontier-Modelle“, ohne die Konkurrenten zu nennen.
- Bei
xhighkostet Neon immer noch „36 %+ weniger pro Aufgabe als konkurrierende Modelle auf ihrer höchsten Stufe“.
Der Beitrag veröffentlicht weder die Token-Zahlen noch den Carbon-Preis hinter den 32 %. Diese Lücke wiegt diesmal besonders schwer, weil Carbons Preis weniger als zwei Wochen nach Neons Launch doppelt so hoch wird.
Ist Gemini 4 Neon günstiger als Carbon? Das hängt vom Datum ab
Pro Token liegt Neon zwischen den beiden Carbon-Preisen: das 1,5-Fache von Carbons Einführungsrate und das 0,75-Fache seiner Dezember-Rate. Die 32 % können also nur daher kommen, dass Neon pro Aufgabe weniger Tokens verbraucht. Rechnen wir die Behauptung in beide Richtungen durch:
| Wenn Googles Diagramm Carbonpreisete mit | Implizierte Neon-Tokens vs. Carbon | Neon vs. Carbon bis 30. Nov. | Neon vs. Carbon ab 1. Dez. |
|---|---|---|---|
| 2 / 10 $ (Einführung) | etwa 45 % | 32 % günstiger | etwa 66 % günstiger |
| 4 / 20 $ (Dezember) | etwa 91 % | etwa 36 % teurer | 32 % günstiger |
Beide Zeilen setzen voraus, dass beide Modelle Eingabe- und Ausgabe-Tokens im gleichen Verhältnis aufteilen – eine Vereinfachung. So oder so ist Neon ab dem 1. Dezember laut Googles eigenen Zahlen pro Aufgabe günstiger. Bis zum 30. November hängt die Antwort an einem Detail, das Google nicht veröffentlicht hat.
Was eine einzelne Agent-Aufgabe zum Listenpreis kostet
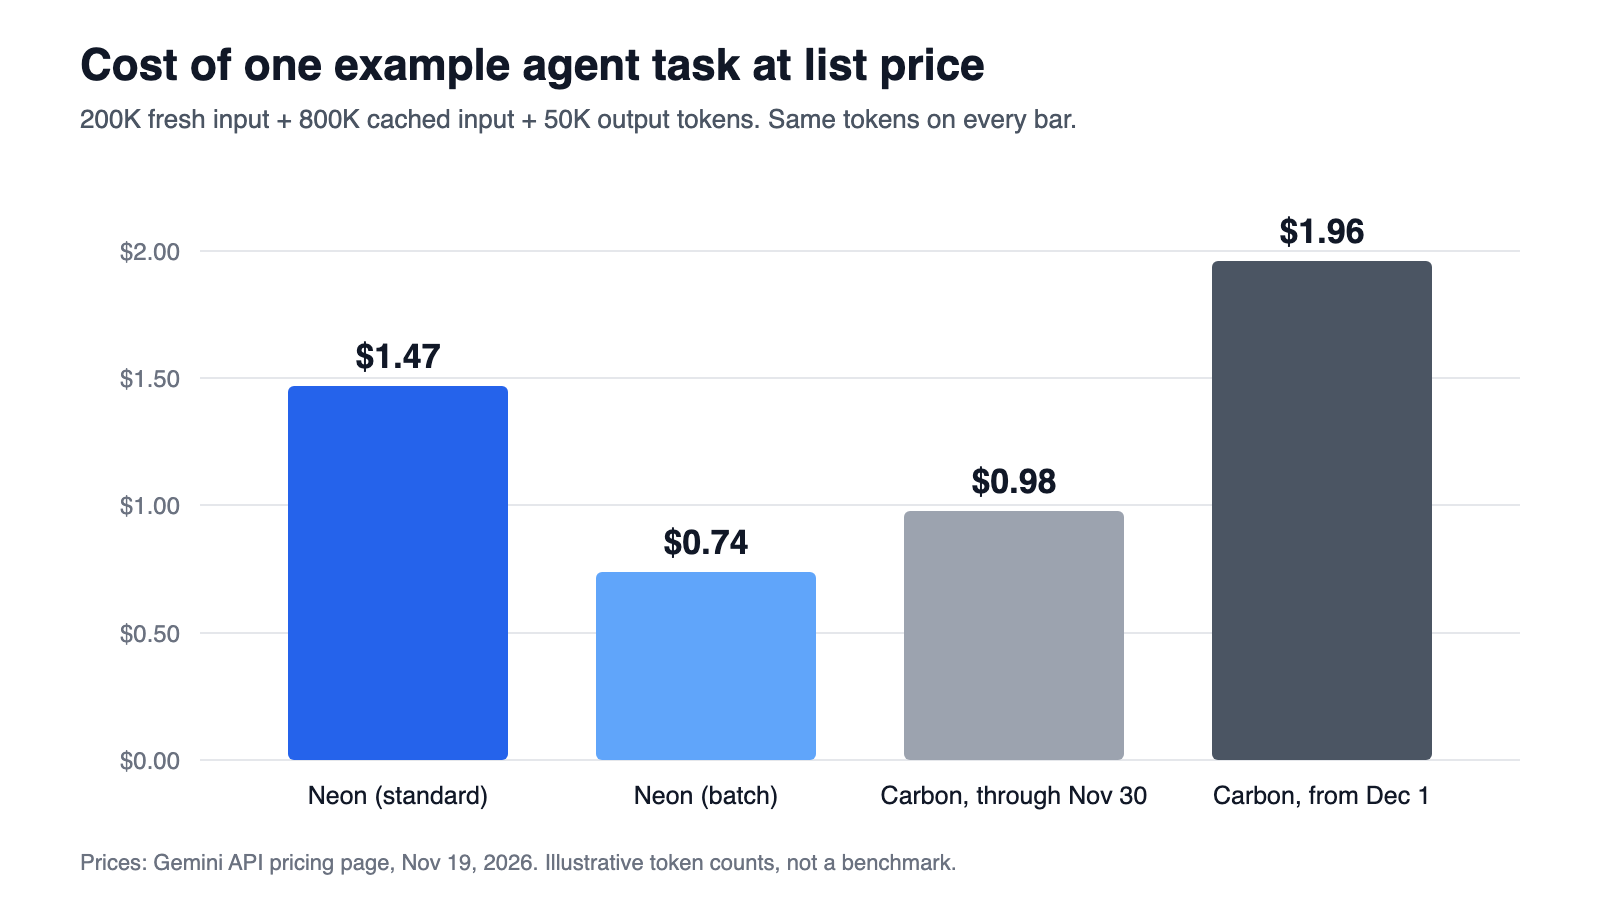
Hier ein durchgerechnetes Beispiel mit glatten Zahlen – kein Benchmark. Stellen Sie sich eine Coding-Agent-Sitzung vor, die 200K neue Eingabe-Tokens sendet, beim erneuten Einlesen des Repositorys 800K Tokens an Cache-Treffern erhält und 50K Ausgabe-Tokens inklusive Thinking produziert.
| Modell | Neue Eingabe | Gecachte Eingabe | Ausgabe | Gesamt |
|---|---|---|---|---|
| Neon (standard) | 0,60 $ | 0,12 $ | 0,75 $ | 1,47 $ |
| Neon (Batch) | 0,30 $ | 0,06 $ | 0,375 $ | 0,74 $ |
| Carbon, bis 30. Nov. | 0,40 $ | 0,08 $ | 0,50 $ | 0,98 $ |
| Carbon, ab 1. Dez. | 0,80 $ | 0,16 $ | 1,00 $ | 1,96 $ |
Bei identischen Token-Zahlen verliert Neon gegen Carbons Einführungspreis und gewinnt gegen seinen Dezember-Preis. Die Break-even-Regel ist einfach: Gegen den Einführungspreis muss Neon die Aufgabe mit weniger als 67 % der Carbon-Tokens abschließen. Gegen den Dezember-Preis bleibt Neon günstiger, außer es benötigt mehr als 133 % der Carbon-Tokens.
Die Ausgabe macht in diesem Beispiel die Hälfte von Neons Rechnung aus, und Thinking-Tokens werden als Ausgabe abgerechnet. Deshalb bewegt die gewählte Denkstufe die Kosten stärker als der Listenpreis.
Denkstufen: der Regler hinter Neons Kosten pro Aufgabe
Neon unterstützt vier Denkstufen: low, medium, high (Standard) und xhigh. Googles Leitfaden ist bei diesem Trade-off deutlich: xhigh „erhöht Latenz und Token-Verbrauch“, und Sie sollten „die niedrigste thinking_level wählen, die Ihrer Qualitätsanforderung genügt“.
Eine praxisnahe Routing-Logik für Agent-Arbeiten sieht so aus:
low: Codebase-Fragen, Diff-Zusammenfassungen, Triage-Notizen.medium: umrissene Fixes, bei denen die Testsuite der eigentliche Richter ist.high: Refactorings, Debugging und lange Tool-Call-Sitzungen. Hier gilt Googles 32-%-Behauptung.xhigh: nur für Aufgaben, die beihighbereits im Review durchgefallen sind.
Pro Anfrage lässt sie sich im Code so setzen:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon lehnt die alte Stufe minimal mit einer Fehlermeldung ab und ignoriert temperature, top_p und top_k. Google empfiehlt außerdem Client-Timeouts von mindestens 15 Minuten für anspruchsvolle Prompts – lange Agent-Läufe stoßen zuerst an diese Grenze.
Warum Kosten pro Aufgabe trotzdem nicht Ihre Zahl sind
Eine Benchmark-Aufgabe endet, wenn der Evaluator sie bewertet. Ihre endet, wenn ein Mensch die Änderung mergt. Wiederholungen, abgelehnte Diffs und Review-Zeit liegen dazwischen – und keine Kosten-pro-Aufgabe-Grafik zeigt sie.
Die Zahl, die zu Ihrem Budget passt, sind die Kosten pro akzeptierter Änderung: die Gesamtausgaben des Modells für eine Aufgabe, über alle Versuche hinweg, geteilt durch die Änderungen, die Sie ausgeliefert haben. Das vollständige Argument haben wir in wenn ein günstigeres Modell mehr kostet gemacht. Die Kurzfassung:
cost per accepted change = cost per attempt / acceptance rate
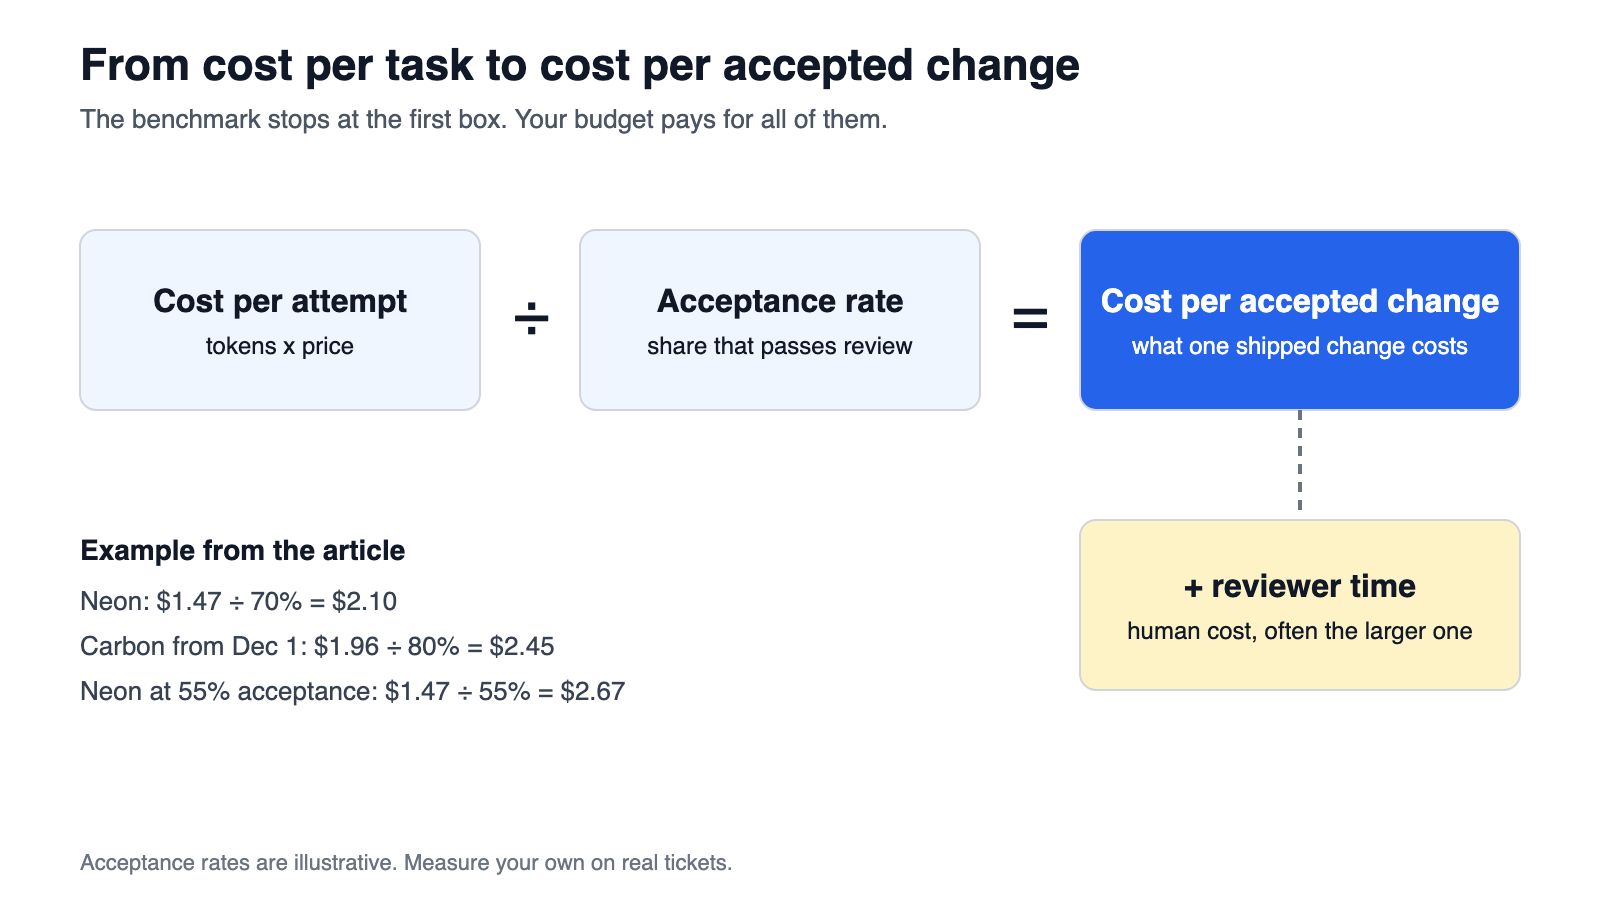
Rechnen wir das Beispiel von oben durch. Wenn Neon bei 70 % der ersten Versuche das Review besteht, werden aus 1,47 $ pro Versuch 2,10 $ pro akzeptierter Änderung. Wenn Carbon zum Dezember-Preis bei 80 % besteht, werden aus 1,96 $ dann 2,45 $. Neon gewinnt weiterhin. Sinkt Neons Akzeptanz aber auf 55 %, kostet es 2,67 $ pro akzeptierter Änderung – und Carbon gewinnt. Ihre Akzeptanzraten entscheiden über die Wahl, nicht Googles Diagramm.
Die Reviewer-Zeit liegt außerhalb dieser Formel und kostet in der Regel mehr als die Tokens. Human Review ist der Engpass bei parallelen Agents – weniger abgelehnte Diffs sparen also den teuersten Teil.
Wie Sie Neon auf Ihren eigenen Aufgaben gegen Carbon testen
Sie brauchen keinen neuen Benchmark. Sie brauchen zwei Wochen echte Tickets und eine Möglichkeit festzuhalten, welches Modell was erledigt hat. Sharkly bietet Ihnen genau dieses Board: Jede Aufgabe enthält den Lauf des Agents, sein Ergebnis und seinen Review-Status an einem Ort.
- Wählen Sie 20 bis 30 gewöhnliche Aufgaben aus Ihrem Backlog: Bugfixes, kleine Refactorings, neue Tests.
- Legen Sie zwei Agents an. Ein Sharkly Agent folgt dem Standardmodell seines Runtime und hat keine Modellauswahl, so die Agents-Dokumentation. Richten Sie daher jeden Agent auf ein Runtime mit unterschiedlichem Modell: eins auf
gemini-4-neon, eins aufgemini-4-carbon. - Verteilen Sie die Aufgaben auf die beiden Agents, mit ähnlichem Schwierigkeitsgrad auf beiden Seiten.
- Erfassen Sie pro Aufgabe drei Zahlen: Tokens aus Ihrer Gemini-API-Nutzung, Versuche bis zur Akzeptanz und Reviewer-Minuten.
- Berechnen Sie die Kosten pro akzeptierter Änderung für jedes Modell – mit beiden Carbon-Preisen, falls Ihr Test über den 1. Dezember hinausreicht.
Sharkly verkauft keine Modell-Tokens. Ihre Läufe werden über den bereits am Runtime konfigurierten Gemini-API-Schlüssel abgerechnet, sodass der Vergleich fair bleibt: Nichts in der Plattform verschiebt den Preis zugunsten eines Modells. Für den größeren Kontext siehe warum eine Agent-Plattform Ihnen keine Tokens verkaufen sollte und Tracking der Ausgaben über Claude Code, Codex und Gemini hinweg.
Wo Neon, Carbon und Hydrogen jeweils hingehören
Googles Modellkarte empfiehlt Carbon für „Ihre schwierigsten Projekte mit langem Horizont“ und Hydrogen für „schnelle alltägliche Ausführung“ – Neon liegt dazwischen. Kostenseitig ergeben sich für ein Agent-Team drei Bahnen:
- Hydrogen zu 1,50 / 7,50 $ für umfangreiche, risikoarme Arbeiten. Siehe Gemini 4 Hydrogen für Coding-Agents.
- Neon bei
highals Standardbahn für komplexe Tickets und als Lead, der parallele Hydrogen-Subagents steuert. - Carbon für Arbeiten mit langem Horizont, bei denen Neon selbst bei
xhighscheitert. Unser Carbon-Review zeigt, wo es seinen Preis wert ist.
Der Pairing-Leitfaden für Carbon und Hydrogen zeigt ein Planner-and-Workers-Board; ab dem 1. Dezember übernimmt Neon den Planner-Platz für weniger Geld. Zum Routing über mehrere Anbieter hinweg siehe Modell-Routing für Agent-Teams.
Fazit
Gemini 4 Neon ist ab dem 1. Dezember bei jeder Lesart von Googles Zahlen pro Aufgabe günstiger als Carbon. Vor diesem Datum hängt es davon ab, welcher Carbon-Preis hinter der 32-%-Grafik stand – und Google hat es nicht verraten. Der Listenpreis war ohnehin nie die entscheidende Zahl: Tokens pro Aufgabe, Denkstufe und Akzeptanzrate sind es.
Führen Sie den Zwei-Wochen-Test mit Ihrem eigenen Backlog durch und kalkulieren Sie beide Modelle pro akzeptierter Änderung. Wenn Sie bereits mehrere Coding-Agents betreiben, bietet Ihnen Sharkly ein Board, um Aufgaben zuzuweisen, die Ergebnisse der Agents zu vergleichen und das Review in einer Warteschlange zu halten. Die Sharkly-Dokumentation führt durch das Verbinden eines Computer und das Anlegen von Agents.
FAQ
Wie viel kostet Gemini 4 Neon?
3 $ pro 1 Mio. Eingabe-Tokens, 15 $ pro 1 Mio. Ausgabe-Tokens inklusive Thinking und 0,15 $ pro 1 Mio. gecachten Eingabe-Tokens im bezahlten Tarif der Gemini API. Batch und Flex halbieren das auf 1,50 / 7,50 $. Einen kostenlosen API-Tarif gibt es nicht.
Ist Gemini 4 Neon günstiger als Gemini 4 Carbon?
Pro Token: nein bis zum 30. November (3 / 15 $ gegen 2 / 10 $) und ja ab dem 1. Dezember (3 / 15 $ gegen 4 / 20 $). Pro Aufgabe berichtet Google, dass Neon bei high 32 % günstiger als Carbon ist – ohne zu verraten, welchen Carbon-Preis es verwendet hat.
Hat Gemini 4 Neon einen Free-Tarif?
Nein. Die Preisseite listet „Not available“ für Neons Free-Tarif auf jeder Serviceebene. Gemini 4 Hydrogen hat einen.
Werden Thinking-Tokens bei Gemini 4 Neon abgerechnet?
Ja. Google berechnet Thinking-Tokens zum Ausgabepreis von 15 $ pro 1 Mio., ebenso Funktionsdeklarationen und Grounding-Systemanweisungen. Das Senken der thinking_level ist der wichtigste Hebel, um Tokens zu sparen.
Welche Denkstufe ist am günstigsten für Coding-Agents?
low verbraucht die wenigsten Tokens, xhigh die meisten. Google empfiehlt, alle vier Stufen auf Ihrem Evaluierungsset zu testen und die niedrigste Stufe zu wählen, die Ihre Qualitätsanforderung erfüllt. Starten Sie bei komplexen Codeänderungen mit high.
Wann steigt der Preis von Gemini 4 Carbon?
Am 1. Dezember 2026. Die Eingabe steigt von 2 $ auf 4 $ pro 1 Mio. Tokens und die Ausgabe von 10 $ auf 20 $, laut der Preisseite der Gemini API.


