

Kurzfassung: GPT-6.2 kostet bei Astra 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens, bei Sol 2 $ und 10 $. Gecachte Input-Lesezugriffe kosten 0,40 $ bzw. 0,10 $. Eine beispielhafte Agent-Aufgabe mit 20 Durchläufen kostet etwa 3,23 $ auf Astra und 0,81 $ auf Sol – mit funktionierendem Prompt-Caching und viermal so viel ohne.
OpenAI hat GPT-6.2 Astra und GPT-6.2 Sol am 17. November 2026 veröffentlicht. Astra ist das Frontier-Modell für die anspruchsvollsten Aufgaben. Sol ist das Alltagsmodell, und seine Modellseite sagt, es sei „built for powering agents at scale“.
Ein Preis pro Million Tokens sagt wenig darüber aus, was ein Agent-Team ausgibt. Agents senden ihren Kontext bei jedem Durchlauf erneut, daher hängt die Rechnung von Caching, Kontextlänge und der Anzahl gleichzeitig laufender Agents ab. Diese Anleitung rechnet die GPT-6.2-Preisliste in Zahlen pro Aufgabe und pro Monat um und zeigt dann die Limits, die die Kosten vorhersehbar halten. Wenn Sie bereits Coding-Agents parallel betreiben, ist Sharkly der Ort, an dem Sie diese Limits pro Agent festlegen.
GPT-6.2-Preise für Astra und Sol
Hier ist die Standard-API-Preisliste von der Astra-Modellseite und der Sol-Modellseite, geprüft am 20. November 2026. Alle Preise gelten pro Million Tokens.
| Preis pro 1M Tokens | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Input | $8.00 | $2.00 |
| Gecachter Input (Lesezugriffe) | $0.40 | $0.10 |
| Cache-Schreibvorgänge (30 Minuten Speicherung) | $10.00 | $2.50 |
| Cache-Schreibvorgänge (12 Stunden Speicherung) | $20.00 | $5.00 |
| Output | $40.00 | $10.00 |
| Kontextfenster | 1,050,000 | 1,050,000 |
Sol kostet auf jeder Zeile exakt ein Viertel von Astra. Beide Modelle teilen sich dasselbe Kontextfenster und dieselben Rate-Limits – der Preis ist also das Unterscheidungsmerkmal auf der Rechnung.
Die Preisregeln, die die Gesamtsumme verändern
Fünf Regeln auf den Modellseiten bewegen eine Agent-Rechnung mehr als der Listenpreis:
- Zuschlag für langen Kontext. Eine Anfrage mit mehr als 272K Input-Tokens zahlt das Doppelte für Input und Cache und das 1,5-Fache für Output – auf die gesamte Anfrage.
- Cache-Schreibvorgänge kosten extra. Das Schreiben eines Präfixes in den Cache kostet das 1,25-Fache des normalen Inputs für 30 Minuten oder das 2,5-Fache für 12 Stunden.
- Cache-Lesezugriffe sind günstig. Bei GPT-6.2 kostet ein gecachter Lesezugriff das 0,05-Fache des normalen Inputs, laut OpenAIs Prompt-Caching-Guide.
- Batch kostet 50 Prozent der Standardpreise.
- Geschwindigkeit kostet mehr. Der Fast-Modus kostet das Doppelte des Standardpreises. Ultrafast kostet das Dreifache bis zum 28. Februar 2027 und ab dem 1. März 2027 das Sechsfache.
GPT-6.2 unterstützt kein Flex-Processing. Der Ersatz ist ein vergünstigtes Background-Completion-Fenster, das weiter unten behandelt wird.
Was eine einzelne Agent-Aufgabe bei GPT-6.2 kostet
Nehmen wir eine beispielhafte Coding-Aufgabe: 20 Durchläufe, 60.000 Input-Tokens pro Durchlauf und 2.000 Output-Tokens pro Durchlauf. Das sind 1,2 Millionen Input-Tokens und 40.000 Output-Tokens für die gesamte Aufgabe. Ihre Zahlen werden abweichen – setzen Sie also Ihre eigenen ein.
| Szenario | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Keine Cache-Treffer | $11.20 | $2.80 |
| 90 Prozent Cache-Treffer | $3.23 | $0.81 |
| 90 Prozent Cache-Treffer, 8-Stunden-Background-Fenster | $1.94 | $0.49 |
Die gecachten Zeilen gehen davon aus, dass 90 Prozent des Inputs aus dem Cache gelesen werden und die übrigen 10 Prozent als 30-minütiger Cache-Schreibvorgang abgerechnet werden. Das ist der pessimistische Fall – ein realer gecachter Lauf sollte also bei oder unter diesen Zahlen liegen.
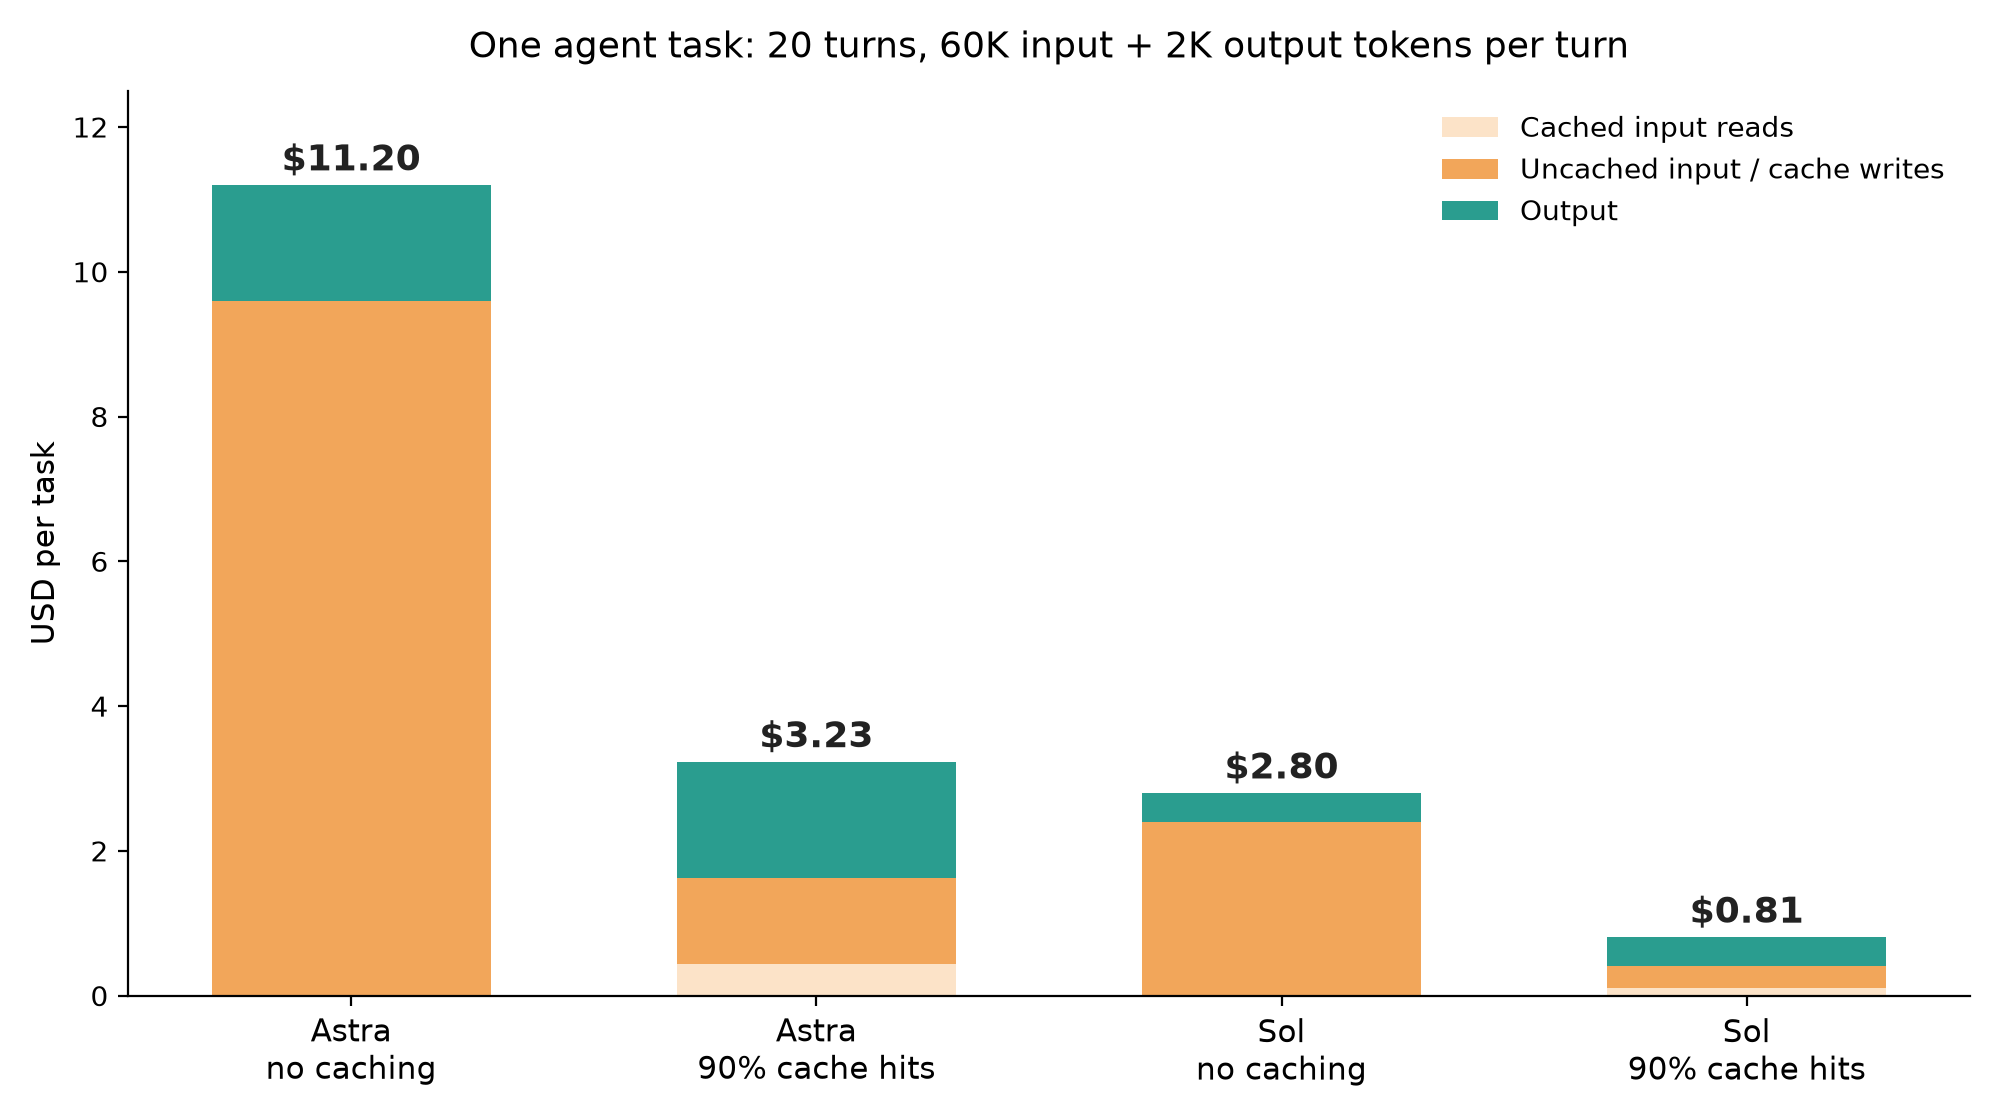
Zwei Zahlen stechen heraus. Caching senkt die Aufgabenkosten auf beiden Modellen um rund 71 Prozent. Und eine gecachte Astra-Aufgabe kostet nur wenig mehr als eine ungecachte Sol-Aufgabe. Das günstige Modell mit defektem Cache kostet fast so viel wie das teure Modell mit funktionierendem.
Wo der Langkontext-Zuschlag zuschlägt
Coding-Agents, die die Hälfte eines Repositorys lesen, können 272K Input-Tokens pro Durchlauf überschreiten. Vergleichen Sie zwei Sol-Durchläufe, beide mit 2.000 Output-Tokens und ohne Cache:
- 270.000 Input-Tokens: 0,54 $ Input plus 0,02 $ Output, insgesamt 0,56 $.
- 300.000 Input-Tokens: 1,20 $ Input plus 0,03 $ Output, insgesamt 1,23 $.
Ein 11 Prozent größerer Kontext kostet mehr als doppelt so viel. Wenn Ihr Agent-Harness den Kontext komprimiert, halten Sie ihn unter 272K. Dieselbe Logik steckt hinter unserem Beitrag zu warum günstige Modelle teurer sein können: Der Preis pro akzeptierter Änderung schlägt den Preis pro Token.
GPT-6.2-Kosten für ein Agent-Team pro Monat
Jetzt skalieren wir die gecachten Zahlen. Sagen wir, fünf Agents schaffen jeweils 8 Aufgaben pro Tag an 22 Arbeitstagen. Das sind 880 Aufgaben pro Monat.
| Team-Setup | Aufgaben pro Monat | Monatliche Modellkosten |
|---|---|---|
| Alle fünf Agents auf Astra | 880 | $2,842 |
| Ein Astra-Lead, vier Sol-Agents | 176 + 704 | $1,139 |
| Alle fünf Agents auf Sol | 880 | $713 |
Das gemischte Setup kostet 60 Prozent weniger als reines Astra. Es belässt das Frontier-Modell bei Planung und anspruchsvollen Reviews und gibt Routinearbeit an Sol. Die Lead-Rolle behandeln wir in GPT-6 Astra als Crew-Leader, und dieselbe Überlegung steckt hinter gleiches Budget, mehr Agents mit GPT-6 Sol.
Der Preis ist nur ein Limit. Tokens pro Minute stoppen ein Agent-Team eher als das Geld, zumindest bei den niedrigeren Usage-Tiers – der GPT-6.2-Rate-Limits-Guide geht das Tier für Tier durch.
Codex-Pläne versus API-Keys
Wenn Ihre Agents Codex über einen ChatGPT-Plan laufen lassen, zahlen Sie nicht pro Token. Sie verbrauchen ein Kontingent. Die Codex-Preisseite schätzt 6 bis 50 lokale Nachrichten pro Fünf-Stunden-Fenster für GPT-6.2 Astra bei Plus und Standard Business sowie 17 bis 180 für Sol. Lange Sitzungen erschöpfen das Kontingent schneller, daher sagt die Token-Rechnung oben weiterhin voraus, welche Aufgaben zuerst das Kontingent aufbrauchen.
Unser GPT-6.2-Codex-Guide behandelt das Setup für beide Modelle.
So senken Sie die GPT-6.2-Kosten für Agent-Teams
Die folgende Reihenfolge bewegt zuerst das meiste Geld:
- Caching zum Laufen bringen. Legen Sie stabile Anweisungen in einer
developer-Nachricht am Anfang des Inputs ab und schreiben Sie frühere Durchläufe nie um. Ein geändertes Präfix ist ein Cache-Miss. - Standardmäßig Sol verwenden. Eine Aufgabe nur dann an Astra hochstufen, wenn sie mehrere Services berührt oder Sol dieselbe Art von Aufgabe zweimal nicht bewältigt.
- Unter 272K Input-Tokens bleiben pro Anfrage.
- Massenarbeit in Background-Fenster verlagern, wenn Sie die API aus Ihrem eigenen Harness aufrufen.
- Batch für Evals und Offline-Jobs nutzen, niemals für einen interaktiven Agent.
- Fast und Ultrafast ausgeschaltet lassen, außer jemand wartet auf das Ergebnis.
Vergünstigte Background-Fenster ersetzen Flex
OpenAIs Background-Mode-Guide listet zwei vergünstigte Completion-Fenster für die Responses API auf, in öffentlicher Beta bei GPT-6.2: 2h mit 30 Prozent unter dem Standardpreis und 8h mit 40 Prozent darunter. Sie teilen sich das Batch-Rate-Limit, nicht Ihr Live-Token-Limit.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Fragen Sie die Response-ID später ab oder verwenden Sie einen Webhook. Das eignet sich für Testgenerierung, Dependency-Updates und Dokumentationsdurchläufe, die niemand vor dem nächsten Morgen braucht.
GPT-6.2-Ausgaben pro Agent in Sharkly kontrollieren
Sharkly verkauft keine Tokens weiter. Jeder Lauf wird gegen den bereits an die Runtime gebundenen Codex-Plan bzw. API-Key abgerechnet, sodass Ihre OpenAI-Rechnung die einzige verbindliche Quelle bleibt. Was Sharkly Ihnen bietet, ist die Kontrolle darüber, wie viel Arbeit auf dieser Rechnung landet.
Jeder Agent hat eine Zeile Default model, die die Modelle auflistet, die seine Runtime meldet. Stellen Sie Ihre Routine-Agents auf Sol und Ihren Lead-Agent auf Astra. Wenn eine Aufgabe mehr braucht, beschreibt die Sharkly-Dokumentation einen Override pro Aufgabe: Fahren Sie im Assignee-Picker mit der Maus über den Agent und wählen Sie ein Modell nur für diesen Lauf.
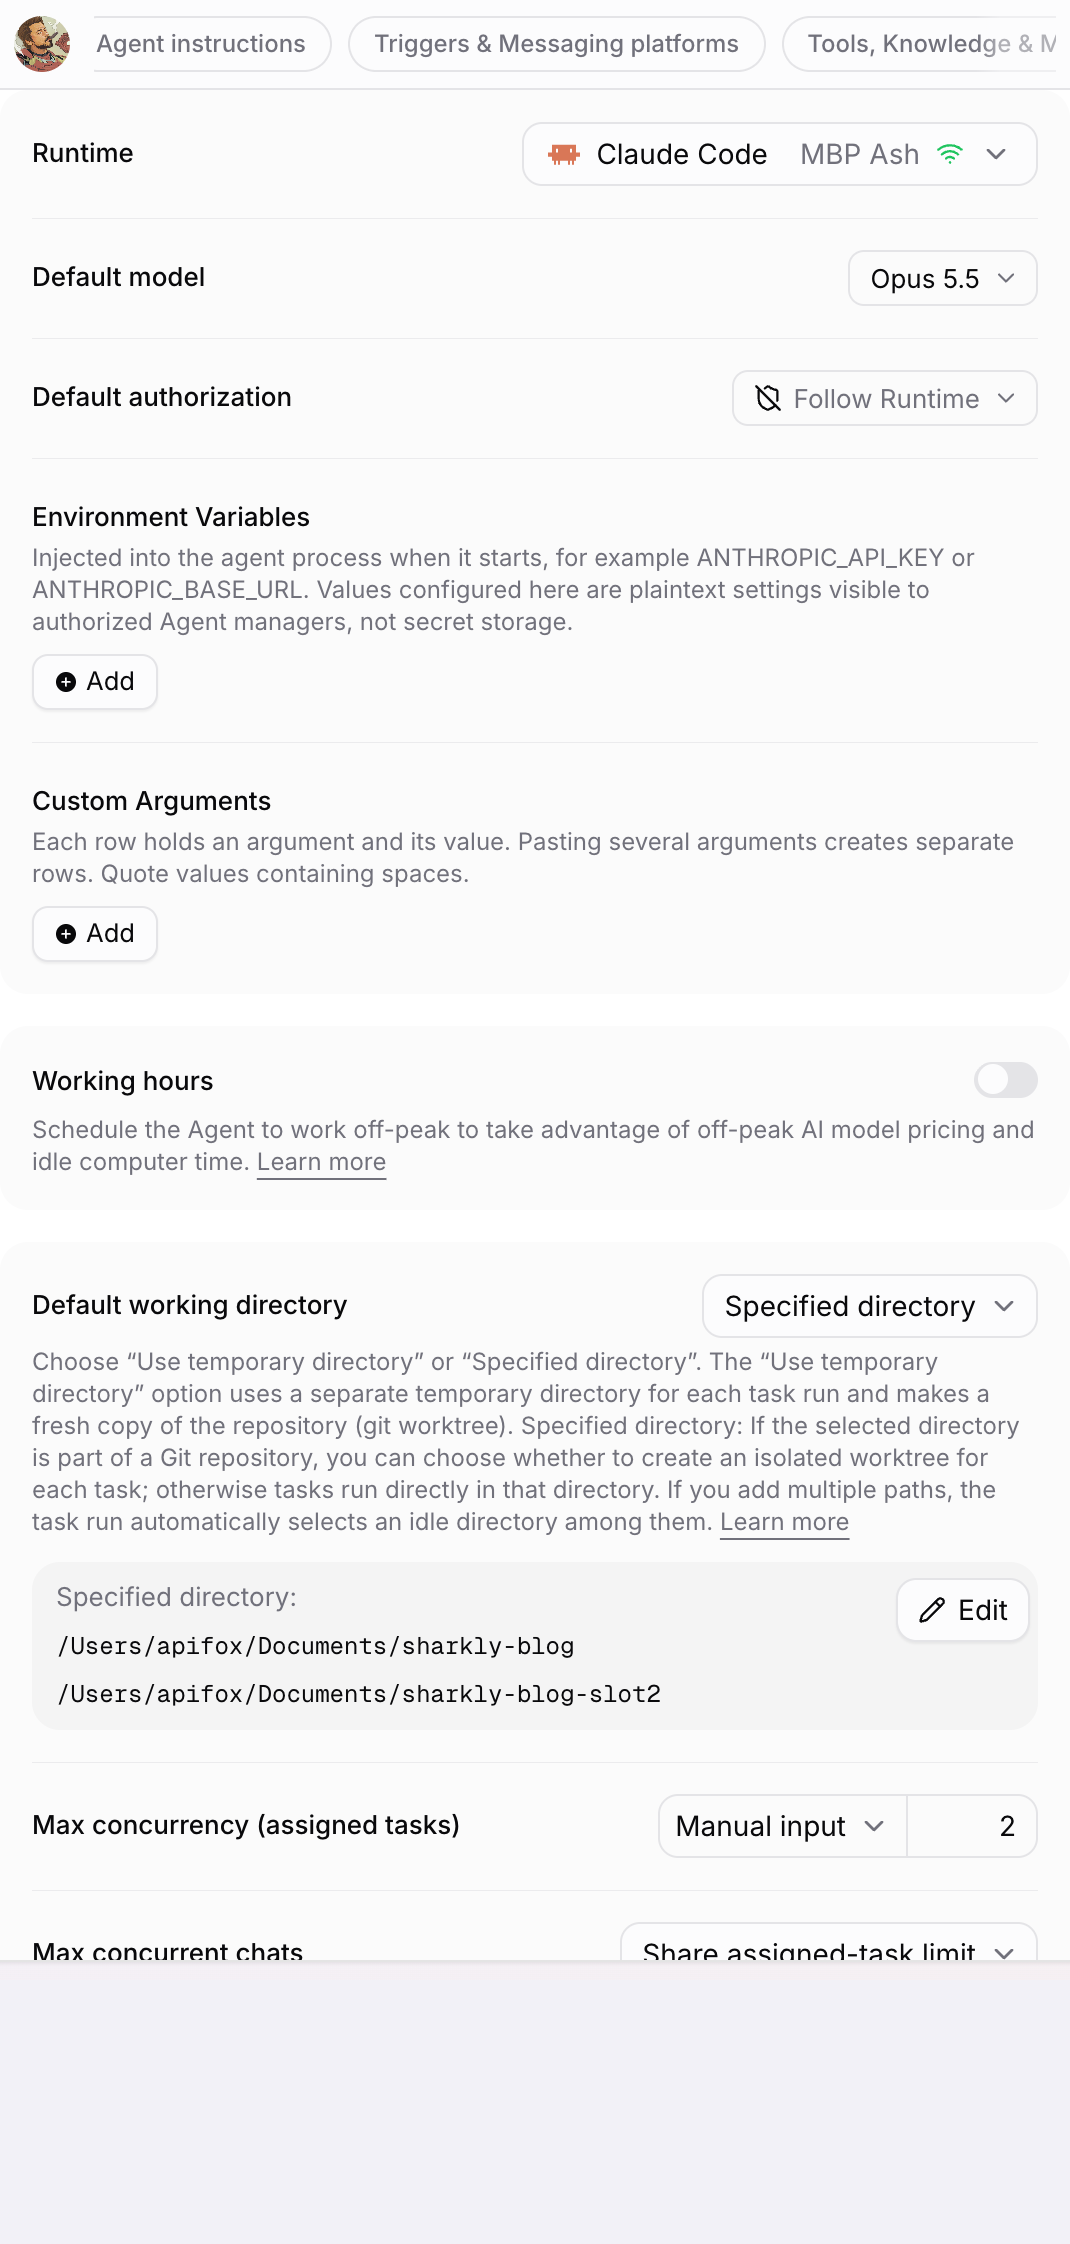
Dasselbe Panel enthält Environment Variables, die beim Start in den Agent-Prozess injiziert werden. Geben Sie jeder Agent-Gruppe einen API-Key aus ihrem eigenen OpenAI-Projekt, und Ihre OpenAI-Usage-Seite schlüsselt die Ausgaben nach Gruppe auf. Working hours plant einen Agent in Schwachlastzeitfenster ein, sodass Massenaufgaben nachts laufen und die Tageskapazität für diejenigen bleibt, die warten.
Ausgaben brauchen auch eine Obergrenze. Max concurrency begrenzt, wie viele Aufgaben ein Agent gleichzeitig ausführt, Max run duration stoppt einen Lauf, der sich in einer Schleife festfährt, und Queue timeout verwirft Arbeit, die zu lange gewartet hat.
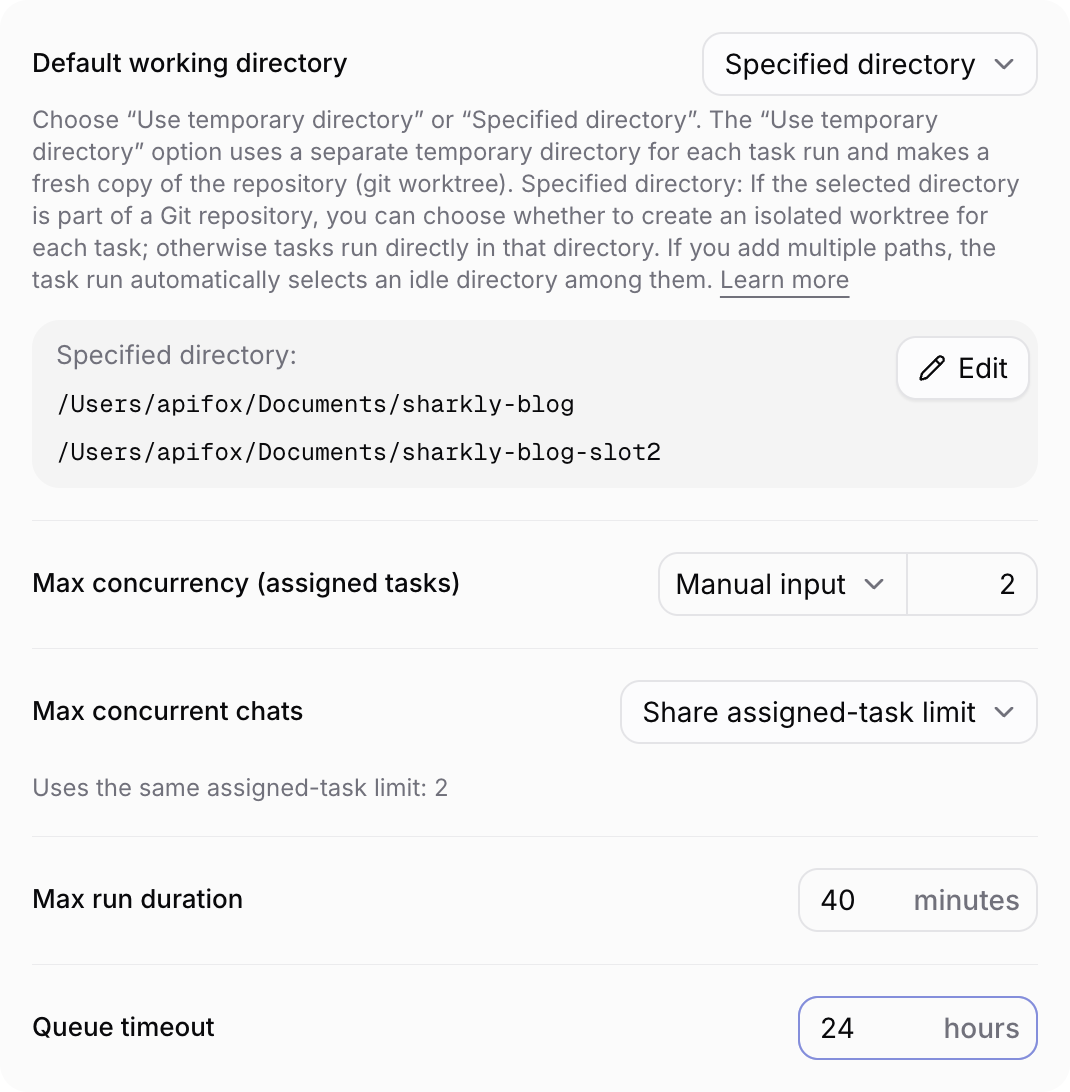
Ein Lauf-Limit von 40 Minuten bei einem Sol-Agent begrenzt den Worst Case. Die Lauf-Liste jedes Agents zeigt die Tokens, die jeder Lauf verbraucht hat, sodass Sie den Aufgabentyp erkennen, der dreimal so viel verbrennt wie die anderen. Diese Aufgabe braucht eine präzisere Beschreibung oder ein günstigeres Modell.
Fazit
Die GPT-6.2-Preise wirken einfach: Astra kostet auf jeder Zeile das Vierfache von Sol. Die Agent-Rechnung ist nicht einfach. Caching bewegt eine Aufgabe um rund 71 Prozent, die 272K-Schwelle kann einen Durchlauf verdoppeln, und Parallelität multipliziert alles. Messen Sie eine echte Aufgabe, bringen Sie Ihre Cache-Hit-Rate nach oben, verlagern Sie Routinearbeit auf Sol und begrenzen Sie, was gleichzeitig läuft.
Probieren Sie es zuerst an einem Agent aus. Verbinden Sie einen Computer, erstellen Sie einen Codex-Agent auf GPT-6.2 Sol, stellen Sie Max concurrency auf 2 und Max run duration auf 40 Minuten ein und weisen Sie ihm eine Routineaufgabe zu. Lesen Sie dann die Tokens des Laufs. Mehr zum Betrieb eines Teams in parallel finden Sie in wie man 10 AI-Coding-Agents gleichzeitig betreibt.
FAQ
Wie viel kostet GPT-6.2?
GPT-6.2 Astra kostet 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens. GPT-6.2 Sol kostet 2 $ und 10 $. Gecachte Input-Lesezugriffe kosten 0,40 $ bei Astra und 0,10 $ bei Sol.
Ist GPT-6.2 Sol günstiger als Astra?
Ja. Sol kostet ein Viertel von Astra bei Input, Output, gecachten Lesezugriffen und Cache-Schreibvorgängen. Beide teilen sich ein Kontextfenster von 1.050.000 Tokens und dieselben Rate-Limits.
Was gilt beim GPT-6.2-Preis für langen Kontext?
Anfragen über 272K Input-Tokens zahlen das Doppelte für Input und Cache und das 1,5-Fache für Output – auf die gesamte Anfrage, nicht nur auf die Tokens oberhalb der Schwelle.
Unterstützt GPT-6.2 Flex-Processing?
Nein. OpenAI verweist langlebige Arbeiten stattdessen an vergünstigte Background-Completion-Fenster: 2h mit 30 Prozent Rabatt und 8h mit 40 Prozent Rabatt, in öffentlicher Beta.
Wie viel kostet GPT-6.2 Batch?
Batch kostet 50 Prozent der Standardpreise bei beiden Modellen. Es eignet sich für Evals und Offline-Jobs, nicht für interaktive Agents.
Berechnet Sharkly Gebühren für GPT-6.2-Tokens?
Nein. Sharkly betreibt die Coding-Agents, die Sie bereits verwenden, und die Modellnutzung wird gegen Ihren eigenen Codex-Plan oder API-Key abgerechnet. Sharkly steuert, welches Modell jeder Agent verwendet und wie viele Aufgaben gleichzeitig laufen.


