
OpenAI hat GPT-6 Luna am 22. September veröffentlicht – für 0,10 $ pro Million Input-Tokens und 0,50 $ pro Million Output-Tokens, mit der API-ID gpt-6-luna und einem Kontextfenster von 1 Mio. Tokens. Bei diesem Preis ist die spannende Frage nicht mehr, ob das Modell abstrakt betrachtet gut genug ist. Sondern welche Lanes eures Boards ihr bereit seid, ihm zu übergeben – und wie die günstige und die teure Lane auf demselben Computer laufen, ohne dass jemand den Überblick verliert, welche davon ein bestimmtes Ergebnis produziert hat.
Das ist zuerst ein Konfigurationsproblem und erst danach ein Modellproblem. Ein Team, das Luna überall einbindet, spart Geld und gibt es im Review wieder aus. Ein Team, das Luna nie einbindet, zahlt weiter Premiumpreise dafür, dass ein Agent eine Testdatei umbenennt. Dieser Leitfaden geht den kleinsten sinnvollen Weg: gpt-6-luna auf einem Computer einbinden, in einer eigenen Lane halten, einen echten Task zuweisen und das Ergebnis dort nachlesen, wo das Team es sehen kann.
TL;DR
Bindet gpt-6-luna als Standardmodell einer Runtime auf einem verbundenen Computer ein, stellt sicher, dass diese Runtime in Sharkly als Available angezeigt wird, gebt ihr einen eigenen Agenten, statt den teuren Agenten wiederzuverwenden, erhöht das Timeout pro Task, bevor ihr einem langen Lauf vertraut, und setzt Luna nur auf Arbeit ein, deren Ergebnis ein Mensch in unter einer Minute prüfen kann. Sharkly zeigt den Modellnamen nicht an. Angezeigt werden der Run, das Log, die Rückfragen und das Ergebnis am Task. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab.
Wo die Modelleinstellung sitzt
Sharkly wählt keine Modelle aus. Die Agents-Dokumentation ist eindeutig: „Der Agent folgt dem Standardmodell der Runtime. Er verspricht keinen bestimmten Modellnamen und zeigt auch keinen an. Modelle werden in der Runtime- oder Computer-Tool-Konfiguration geändert, nicht am Agenten.“
Es gibt also kein Modell-Dropdown an einem Agenten und auch keine Einstellung für die Denktiefe. Vier Rollen, jede mit einer Aufgabe. Der Agent legt fest, wie Arbeit behandelt werden soll. Der Computer stellt den Host und die lokalen Ressourcen bereit. Die Runtime führt die eigentliche Agent-Session aus. Der Task bleibt der gemeinsame Datensatz für das Team. Die vollständige Anleitung zu diesem Setup findet sich in unserem GPT-6-Sol-Leitfaden; dieser Beitrag behandelt den Teil, der spezifisch dafür ist, ein günstiges Modell aufs Board zu bringen.
Schritt 1: gpt-6-luna am Computer einbinden
Auf dem Computer, der ihn ausführen soll, aktualisiert ihr euer Agent-Tool und meldet euch mit einem Konto oder API-Schlüssel an, der Zugriff auf Luna hat. OpenAI hat Luna in ChatGPT Work sowie in Codex für die Tarife Plus, Pro, Business, Enterprise und Edu verfügbar gemacht, Free- und Go-Nutzern Luna in der Desktop-App gegeben und es noch nicht in Chat aufgenommen. Wenn codex -m gpt-6-luna auf diesem Host in einem normalen Terminal eine Session startet, kann Sharkly es nutzen.
Legt dann den Standard fest, damit Runs auf dieser Runtime ihn übernehmen:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Zwei Warnhinweise zu diesem Snippet. Der Schlüsselname für den Reasoning-Effort unterscheidet sich je nach Codex-Version, also gleicht ihn mit der Beispielkonfiguration für den Build ab, der auf diesem Computer installiert ist. Und high steht dort bewusst und nicht als Standardwert: Jedes unten aufgeführte veröffentlichte Luna-Ergebnis ist mit hohem oder maximalem Effort gemessen, nicht mit der Einstellung, die man wählen würde, um ein günstiges Modell noch günstiger zu machen. [VERIFY]
Zurück in Sharkly: Öffnet die Computer-Detailansicht und startet den Rescan oder den Verbindungstest. Die Runtime sollte als Available angezeigt werden. Ein Computer, der nur online anzeigt, bedeutet lediglich, dass sein lokaler Dienst Heartbeats sendet. Der Capability-Status der Runtime sagt euch, ob ein Run starten kann.
Schritt 2: Die günstige Lane sichtbar trennen
Ein Computer kann eine oder mehrere Runtimes bereitstellen, von denen jede ihren eigenen Verbindungsstatus meldet, und aus der Computer-Detailansicht lässt sich eine benutzerdefinierte ACP-Runtime mit eigenem Namen und eigenem Startbefehl hinzufügen. Genau das ist der Hebel, den es hier zu nutzen gilt. Gebt der Luna-Lane einen eigenen Runtime-Eintrag und einen eigenen Agenten, benannt nach der Lane und nicht nach dem Modell – dann sagt euch das Board, in welcher Lane ein Task gelaufen ist, ohne dass jemand ein Ausführungslog lesen muss.
Das ist kein Kosmetikdetail. Sharkly kann nicht zuverlässig auslesen, welches Modell eine Runtime tatsächlich verwendet – genau deshalb folgen Agenten dem Runtime-Standard und zeigen keinen Modellnamen an. Wenn ein Agent zwischen Dienstag und Donnerstag still das Modell wechselt, weil jemand eine Konfigurationsdatei bearbeitet hat, dann waren zwei Runs, die am Task identisch aussehen, nicht identisch. Eine Lane pro Kostenstufe macht das an der einen Stelle sichtbar, an der das Team ohnehin hinschaut. Wie Runtimes erkannt und getestet werden, steht in Computer in Sharkly.
Ein Entscheidungspaar, denn zwei Lanes kosten Pflege. Teilt die Runtime auf, wenn mehr als eine Person Arbeit auf diesem Computer zuweist und der Unterschied zwischen einem Run für 0,10 $ und einem für 10 $ für jemanden eine Rolle spielt. Teilt sie nicht auf, wenn ein einzelner Entwickler pro Woche eine Handvoll Tasks ausführt; eine einzige Runtime und eine Entscheidung pro Task sind weniger im Kopf zu behalten, und die Worktree-Isolierung verhindert ohnehin, dass die Runs kollidieren.
Schritt 3: Den Run auf ein Modell abstimmen, das langsam anläuft
Günstig ist nicht dasselbe wie schnell, und diese Einstellung wird zuerst falsch gemacht. Artificial Analysis, ein Drittanbieter und nicht einer der beiden Anbieter, hat für die Max-Reasoning-Variante von GPT-6 Luna 153,9 Output-Tokens pro Sekunde bei 124,23 Sekunden bis zum ersten Token gemessen. Das ist länger, als die meisten Leute warten, bevor sie annehmen, ein Prozess habe sich aufgehängt.
Setzt also das Timeout pro Task bewusst und haltet das Arbeitsverzeichnis im Temporary-Modus, damit jeder Task ein isoliertes Verzeichnis und einen frischen Worktree bekommt. Zwei Luna-Runs im selben Repository können sich dann nicht gegenseitig überschreiben, und ein Run, der nachdenkt, sieht anders aus als ein Run, der abgestürzt ist, weil der Task einen Status trägt und ein Terminal-Scrollback nicht.
Wo eine günstige Runtime in einer Crew hingehört
Eine Crew ist eine wiederverwendbare Gruppe aus Personen und Agenten, koordiniert von einem leitenden Agenten. Die Platzierungsregel, die sich aus OpenAIs eigenen Zahlen ergibt, lautet: Luna gehört zu den Mitgliedern und nicht an die Spitze.
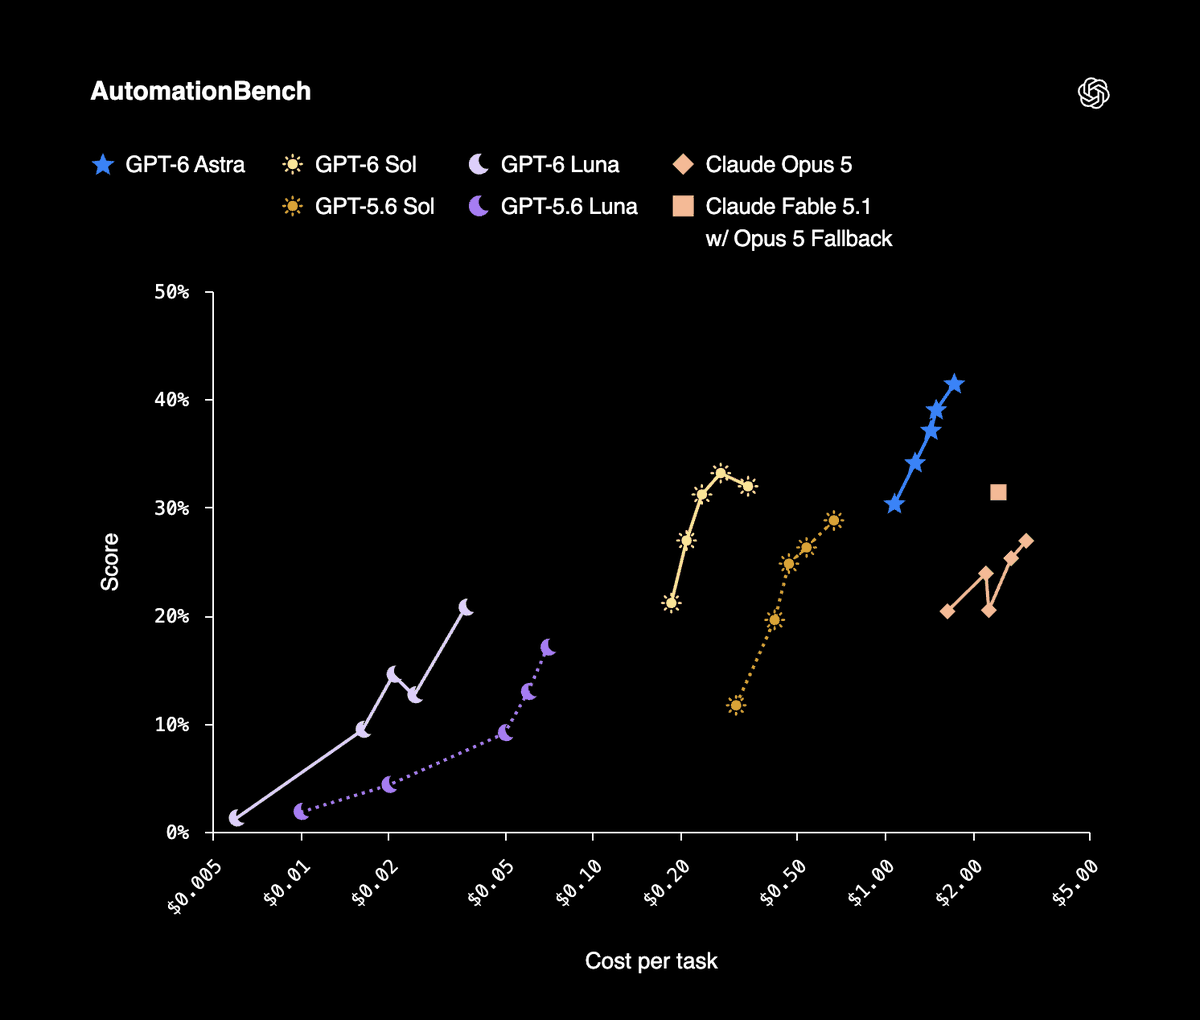
Der Mitglieds-Fall ist stark. Bei DeepSWE 1.1 meldet OpenAI für Luna mit maximalem Effort 66,6 %, vergleichbar mit Claude Opus 5 und Fable 5 mit mittlerem Effort, bei 93 % geringeren Kosten pro Task als Opus 5 und 96 % geringeren als Fable 5. Bei OSWorld 2.0 offline schlägt Luna mit maximalem Effort GPT-5.6 Sol mit mittlerem Effort zu einem Zehntel der Kosten. Bei AutomationBench 1.0.6 erreicht Luna mit hohem Effort 5,4 Prozentpunkte mehr als sein Vorgänger bei 58 % geringeren Kosten pro Task, und bei der Faktenrichtigkeit erreicht Luna mit höherem Effort GPT-5.6 Sol zu etwa einem Hundertstel der Kosten. OpenAI beschreibt Sol und Luna außerdem als 50 % günstiger als die Promotionspreise von GPT-5.6, und diese Einschränkung stammt von OpenAI selbst: Die Vergleichsbasis ist ein Aktionspreis und kein Listenpreis.
Der Leader-Fall ist schwach, und zwar nicht wegen eines Benchmarks. Ein Leader interpretiert das Ziel, entscheidet, was die Mitglieder tun, und führt ihre Ergebnisse in einem Task zusammen. Ein Interpretationsfehler an der Spitze ist nicht ein schlechter Run, sondern jeder Run jedes Mitglieds auf das Falsche gerichtet, und die Ersparnis bei den Tokens des Leaders ist dagegen ein Rundungsfehler. Unser Leitfaden zum Crew-Leader argumentiert am anderen Ende der Preisliste genauso.
| Arbeit | Lane | Warum |
|---|---|---|
| Triage, Labeling, Backlog-Pflege | Luna | Hohes Volumen, und ein Mensch kann das Urteil in Sekunden prüfen |
| Test-Gerüste, Review-Notizen im ersten Durchgang | Luna mit hohem Effort | Die veröffentlichten Gewinne gibt es bei high oder max, nicht bei einer niedrigeren Einstellung |
| Änderungen an Code, der ausgeliefert wird | GPT-6 Sol bei 2 $ / 10 $ | AutomationBench 33,2 % bei 0,27 $ pro Task |
| Ein mehrdeutiges Ziel für eine Crew interpretieren | GPT-6 Sol oder Astra bei 10 $ / 50 $ | Ein Fehler des Leaders multipliziert sich über alle Mitglieder |
Schreibt das als Regel auf, nicht als Gewohnheit. Welches Modell für welche Coding-Aufgabe behandelt die Routing-Frage in voller Länge.
Eine Einschränkung beim Lesen von OpenAIs Vorsprüngen: Der Launch-Post vergleicht mit Claude Opus 5, und Anthropic hat Opus 5 noch am selben Tag, nur Stunden später, durch Opus 5.5 ersetzt. Die Luna-Vergleiche oben beziehen sich also auf die vorherige Generation des jeweils genannten Modells.
Was eine günstige Runtime nicht günstiger macht
Luna senkt den Preis dafür, eine Änderung zu produzieren. Am Preis dafür, eine Änderung abzunehmen, ändert das nichts. Zehn günstige Runs produzieren zehn Diffs, zehn Sätze Testausgaben und zehn Entscheidungen, die nur ein Mensch treffen kann – und OpenAIs eigene Ausgabenzahlen sind eher eine Warnung als eine Beruhigung: Das Unternehmen meldet einen Median-Forscher mit über 600 $ pro Tag für Coding-Agenten, das 90. Perzentil liegt bei 7.000 $. Günstiger pro Task ist genau die Art und Weise, wie so eine Rechnung entsteht.
Die ehrliche Version des Pitches also: Eine günstige Runtime lohnt sich zum Einbinden, wenn die Arbeit, die sie übernimmt, schnell von einem Menschen überprüfbar ist, und sie ist eine Milchmädchenrechnung, wenn sie die Warteschlange vor eurem Reviewer vervielfacht. Haltet Kontext, Fortschritt, Blocker, Ergebnisse und menschliches Review von der Anfrage bis zum Release sichtbar und entscheidet die Lane zum Zeitpunkt der Zuweisung statt im Review. Menschliches Review ist der Engpass behandelt die Scheduling-Seite davon.
Wenn ihr bereits mehrere Coding-Agenten laufen lasst: Verbindet einen Computer, erstellt einen Agenten auf der günstigen Lane und weist ihm etwas Langweiliges zu.


