
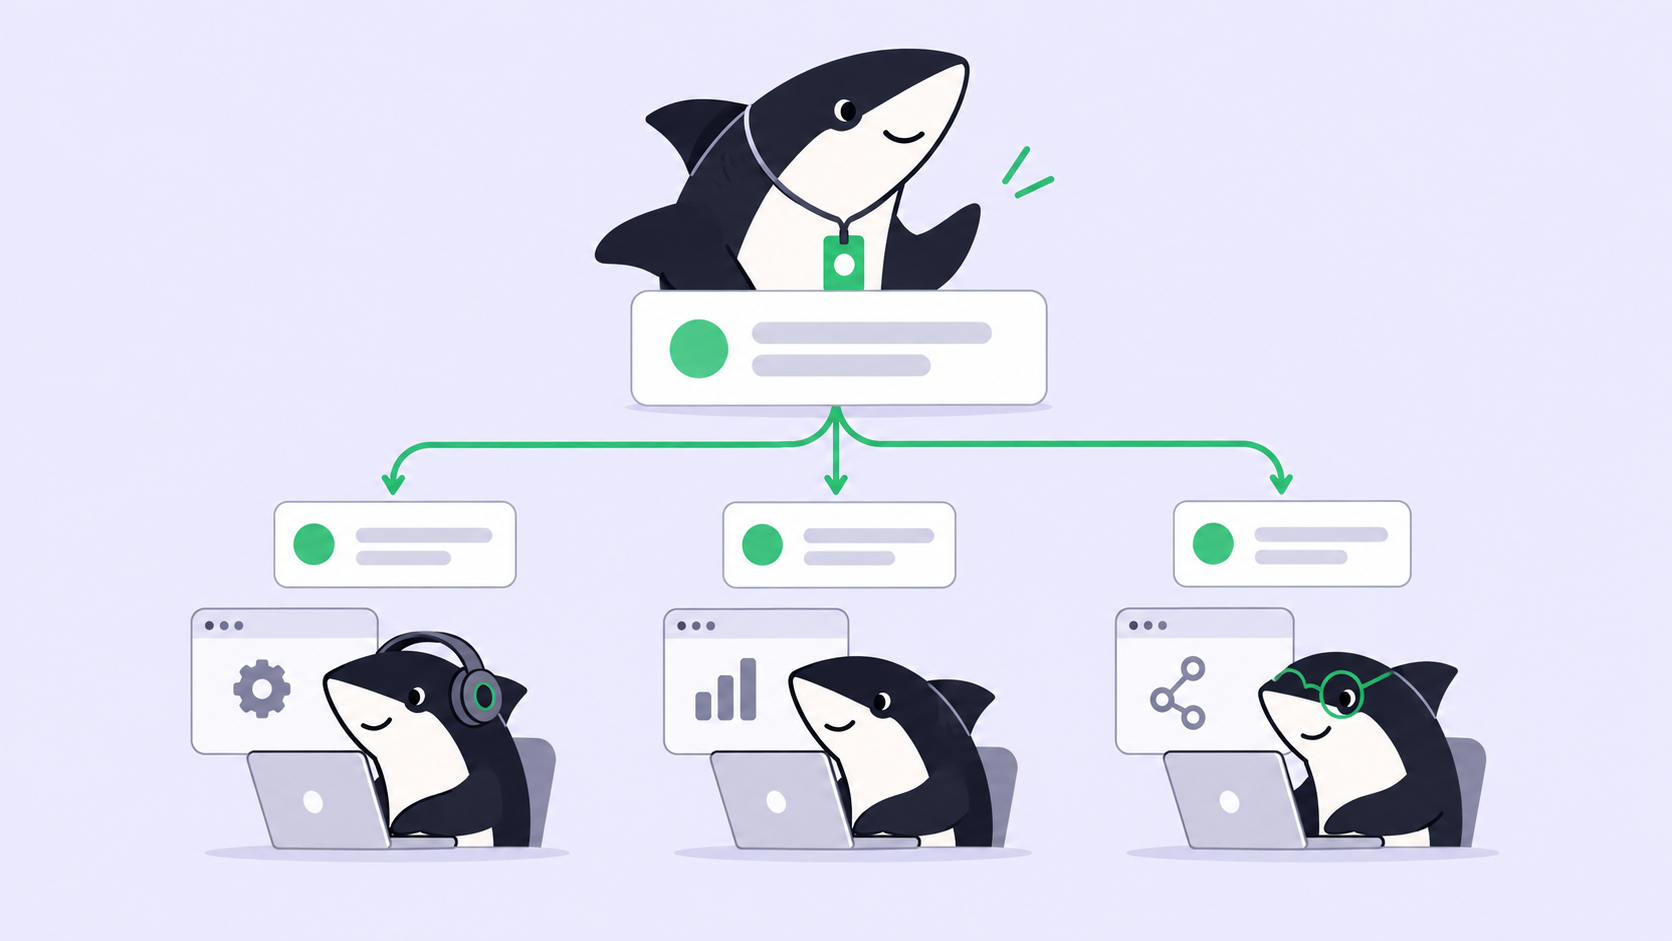
Ein Crew-Leader schreibt fast keinen Code. Er liest den Task, entscheidet, wer handeln soll, erwähnt die Mitglieder, die er braucht, wartet, liest, was zurückgekommen ist, und führt es entweder zusammen oder schickt es zurück. Bei GPT-6 Astra mit 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens trug der Agent, der den wenigsten Code produzierte, den höchsten Satz in der Crew.
OpenAI hat GPT-6 Sol am 22.09.2026 veröffentlicht – 2 $ Input, 10 $ Output, API-ID gpt-6-sol, ein Fünftel von Astras Satz auf beiden Seiten. Das macht Sol nicht zum intelligentesten verfügbaren Modell. Es macht den koordinierenden Platz günstig genug, dass du ihn in jeder Crew besetzen kannst, die du laufen lässt.
Das Plädoyer für Astra haben wir in GPT-6 Astra als dein Crew-Leader dargelegt: Gib den Platz, an dem entschieden wird, an das beste Urteilsvermögen im Team, und die Mitglieder dürfen gewöhnlich sein. Das Argument gilt weiterhin. Was sich geändert hat, ist der Preis dafür. Was sich nicht geändert hat, ist die Warteschlange fertiger Arbeit, die darauf wartet, dass ein Mensch sie abnimmt.
TL;DR
Eine Crew ist eine wiederverwendbare Gruppe aus Personen und Agents, die von einem leitenden Agent koordiniert wird, und die Ausführung ist leader-first: Der Leader liest den Task-Kontext und die Crew-Anweisungen, bevor irgendein Mitglied startet. Dieser Platz ist input-lastig und läuft öfter als einmal pro Task, seine Rechnung richtet sich also nach dem Lesen, nicht nach dem Schreiben. Sol zu 2 $ / 10 $ mit 90 % Rabatt auf gecachte Input-Reads macht es bezahlbar, in jeder Crew einen Leader sitzen zu haben. Behalte Astra oder Claude Opus 5.5 auf dem Platz, wenn die Anforderung selbst uneindeutig ist. Agents recherchieren, führen aus, testen und berichten. Personen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab.
Was der Leader-Platz tatsächlich verbraucht
Die Sharkly-Docs beschreiben die Crew-Ausführung als feste Abfolge. Wenn der Task einen ausführbaren Status hat und der Leader bereit ist, startet der Leader-Agent zuerst. Er liest den Task-Kontext und die Crew-Anweisungen und erledigt dann entweder die Arbeit selbst oder erwähnt geeignete Agent-Mitglieder für bestimmte Beiträge. Deren Ergebnisse kehren in den Task zurück, und der Leader führt zusammen, was zurückgekommen ist.
Lies das als Abrechnungsmuster. Jeder Leader-Turn beginnt mit Lesen: der Beschreibung, den Kommentaren seit dem letzten Mal, den Crew-Anweisungen, den verfügbaren Rollen und allem, was Mitglieder bereits gepostet haben. Er endet mit dem Schreiben einer kurzen Entscheidung oder einer Erwähnung. Input-lastig, output-arm, und das immer wieder.
Und der Platz ist geschäftiger, als die meisten Teams erwarten, denn der Leader läuft nicht einmal pro Task. Bei einem der Crew zugewiesenen Task kann ein zulässiger einfacher Kommentar eines Mitglieds den Crew-Leader starten – unter derselben Verfügbarkeitsvoraussetzung wie jeder andere Lauf. Ein Task mit einer aktiven Diskussion ist ein Task, dessen Leader den Thread mehrfach gelesen hat.
| Kandidat für den Leader-Platz | API-ID | Input / Output pro 1 Mio. | Gecachter Input |
|---|---|---|---|
| GPT-6 Astra | nicht angegeben | 10 $ / 50 $ | nicht angegeben |
| Claude Opus 5.5 | claude-opus-5-5 |
4 $ / 20 $ | 0,20 $ Lesen, 5 $ Schreiben |
| GPT-6 Sol | gpt-6-sol |
2 $ / 10 $ | 90 % Rabatt auf Reads |
| GPT-6 Luna | gpt-6-luna |
0,10 $ / 0,50 $ | 90 % Rabatt auf Reads |
Das sind die API-Preise der Anbieter, und sie stehen hier wegen der Verhältnisse, nicht wegen der Rechnung. Die Modellnutzung läuft weiter über die Abos oder API-Schlüssel, die in euren Coding-Tools konfiguriert sind; was euer Team zahlt, hängt also von den verbundenen Tarifen ab.
Kosten pro Task, nicht Kosten pro Token
Ein Leader, der eine Anforderung falsch deutet, kostet einen ganzen Tag voller Mitglieder-Läufe – die Preisliste ist also der falsche Ort, um das zu klären. OpenAI veröffentlicht die Kosten pro Task zusammen mit dem Score, und das kommt der eigentlichen Frage näher.
| AutomationBench 1.0.6, wie OpenAI sie veröffentlicht hat | Score | Kosten pro Task |
|---|---|---|
| GPT-6 Sol, extra-hoher Aufwand | 33,2 % | 0,27 $ |
| GPT-6 Astra, geringer Aufwand | 30,3 % | 3,9× Sol |
| Claude Opus 5, maximaler Aufwand | 26,9 % | 11,1× Sol |
Bei Agents' Last Exam V1 erreicht Sol mit maximalem Aufwand 56,4 % – mehr als das beste Ergebnis von Opus 5 – bei 60 % geringeren Kosten pro Task.
Drei ehrliche Einschränkungen, bevor du wegen dieser Tabelle irgendetwas ausgibst. Das sind Benchmark-Läufe des gesamten Agents, keine Leader-Läufe; niemand veröffentlicht eine Zahl zu Koordinationskosten, und die tatsächliche Rechnung deines Leaders hängt davon ab, wie gesprächig deine Tasks sind. Die Astra-Zeile steht für geringen Reasoning-Aufwand – OpenAIs eigener Vergleichspunkt, nicht Astra bei voller Leistung. Und OpenAI erklärt unumwunden, Astra „continues to be our best model across the board“, während Artificial Analysis als Drittpartei Sols Intelligenzindex mit 48 angibt – gegenüber 58 für Claude Opus 5.5. Sol ist nicht das stärkste Modell, das du auf diesen Platz setzen kannst. Es ist das stärkste, das du dir leisten kannst, dort in jeder Crew sitzen zu lassen.
Caching ist ein Rabatt, der besonders dem Leader-Platz zugutekommt
GPT-6 erhöht die Cache-Trefferquote standardmäßig und gewährt 90 % Rabatt auf gecachte Input-Reads. Zwei Änderungen sind für einen Leader wichtiger als für ein Mitglied: Das Ändern des Reasoning-Aufwands oder der verfügbaren Tools macht den Cache nicht mehr ungültig, und explizite Breakpoints lassen dich festlegen, wo ein gecachter Prefix endet. OpenAI nennt GitHub, wo über Milliarden von Anfragen hinweg mehr als 50 % weniger Prompt-Tokens frisch verarbeitet werden müssen.
Ein Leader ist der größte Wiederholungstäter, wenn es um erneut gesendeten Kontext in einer Crew geht. Er liest in jedem Turn dieselben Crew-Anweisungen, dieselben Repository-Konventionen und einen wachsenden Task-Thread, und dieser Prefix ist jedes Mal nahezu identisch. Genau dafür ist ein gecachter Prefix gemacht. Die Konfiguration liegt im Runtime auf dem Computer, nicht am Agent; wie du GPT-6-Sol-Agents in Sharkly betreibst zeigt, wo sie hingehört.
Wann Astra oder Opus 5.5 den Platz behält
Setze Sol als Leader ein, wenn die Crew täglich viele klar umrissene Tasks bearbeitet, die Rollen stabil sind und der größte Teil des Urteilsvermögens in den Crew-Anweisungen festgeschrieben werden kann, statt bei jedem Lauf neu hergeleitet zu werden. Behalte ein teureres Modell auf dem Platz, wenn die Anforderung selbst uneindeutig ist, wenn eine falsche Auslegung drei Mitglieder auf den falschen Weg schickt oder wenn der Task eine einzige lange Arbeit statt vieler kurzer ist.
Ein günstigerer Leader ist kein Grund, eine Crew auf Arbeit anzusetzen, die ein einzelner Agent erledigen kann. Die Docs sind da eindeutig: Bei kleinen, klar umrissenen Arbeiten weise den Task direkt einem Agent zu. Nutze eine Crew, wenn der Leader das Ziel auslegen, andere Agent-Mitglieder einbeziehen und deren Ergebnisse in einem Task zusammenführen muss. Ein Ein-Datei-Fix, der über eine Crew läuft, bezahlt einen Koordinationslauf, den er nie gebraucht hätte – zu jedem Preis.
Ein Wechsel des Leader-Modells ändert auch nichts an der Zuständigkeit. Der Owner verwaltet die Crew; der Leader koordiniert die Ausführung.
Das Urteilsvermögen schriftlich festzuhalten, ist es, was einen günstigeren Platz tragfähig macht:
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
Noch ein operativer Hinweis, bevor du einem langen Leader-Turn vertraust. Artificial Analysis hat 102,15 Sekunden bis zum ersten Token für die Max-Reasoning-Variante von GPT-6 Sol gemessen – eine Drittparteiangabe für eine Konfiguration mit maximalem Aufwand, nicht vom Anbieter. [VERIFY] Die ganze Crew wartet auf den ersten Turn des Leaders; ein Leader, der nachdenkt, und einer, der hängt, sehen also gleich aus, bis ein Status etwas anderes sagt.
Die Rechnung, die sich nicht bewegt hat
OpenAI berichtet, dass sein Researcher-Median über 600 $ pro Tag für Coding-Agents ausgibt und das 90. Perzentil 7.000 $. Zu Sols Preisen kann ein Team, das Crew-Läufe bisher rationieren musste, sich nun ein Vielfaches davon leisten – und jeder einzelne davon endet in einem Ergebnis, das ein Mensch lesen muss.
Das ist die Einschränkung, die ein Preisnachlass eher verschärft als löst. Günstigere Koordination kauft mehr parallele Arbeit, mehr Diffs und mehr Entscheidungen pro Woche – gegen eine Review-Kapazität in Arbeitsstunden, die sich am 22.09.2026 nicht verändert hat. Agents recherchieren, führen aus, testen und berichten. Personen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Automatisierung endet dort, wo das Urteil des Teams gefragt ist.
Deshalb zählt beim Leader das Ergebnis mehr als sein Satz. Ein Leader-Lauf, der im Scrollback endet, ist bei 0,27 $ wertlos und bei 3 $ wertlos. Ein Leader-Lauf, der Plan, Mitglieder-Ergebnisse, Checks, Fehlschläge und die offene Frage in einem Task zurückliefert, ist das, was einen Menschen Arbeit in Minuten abnehmen lässt, statt sie zu rekonstruieren. Halte Kontext, Fortschritt, Blocker, Ergebnisse und menschliche Prüfung von der Anfrage bis zum Release sichtbar – dann wird der günstigere Platz zu Durchsatz statt zu Rückstand.
Was du diese Woche ändern solltest
- Wähle eine Crew mit einem teuren Leader und richte ihr Runtime auf diesem Computer auf
gpt-6-solaus. - Schreibe das Urteilsvermögen, für das der Leader bisher improvisieren musste, schriftlich in die Crew-Anweisungen.
- Führe einen Sprint durch und vergleiche zwei Zahlen mit dem vorherigen: abgeschlossene Tasks und nach dem Review zurückgeschickte Tasks. Wenn die Rückläufer zugenommen haben, hat der alte Platz mehr geleistet, als du dachtest.
Wenn du bereits mehrere Agents laufen lässt, bietet Sharkly einen zentralen Ort, um ihre Tasks und Ergebnisse zu verwalten.


