
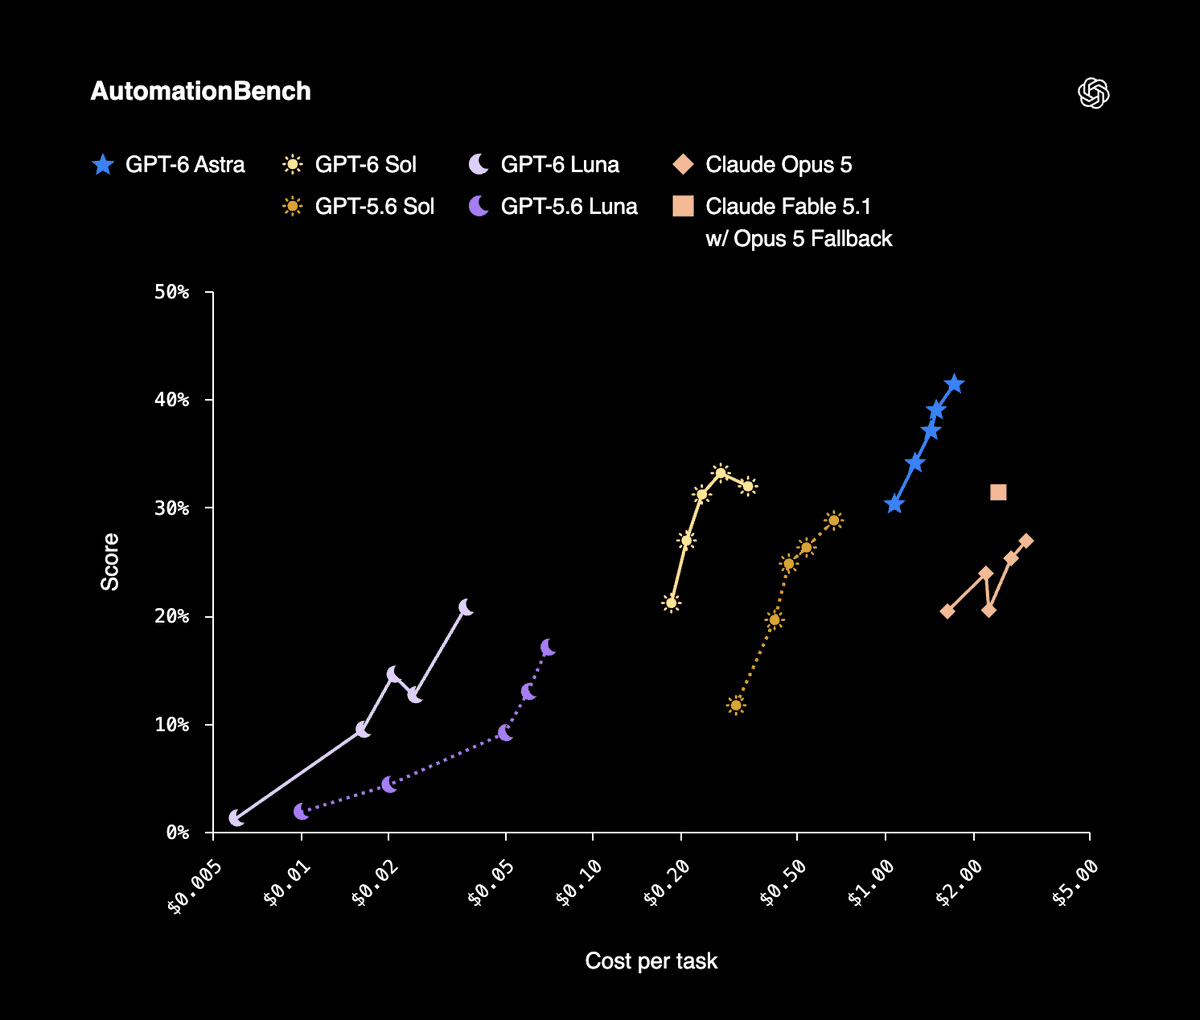
OpenAI hat GPT-6 Sol am 22. September veröffentlicht – für 2 US-Dollar pro Million Input-Tokens und 10 US-Dollar pro Million Output-Tokens, mit der API-ID gpt-6-sol und einem Kontextfenster von 872k. Die Zahl, die verändern sollte, wie euer Board aussieht, ist nicht der Token-Preis. Es sind die Kosten pro abgeschlossener Aufgabe: In den Ergebnissen von OpenAIs AutomationBench 1.0.6 erreicht Sol mit xhigh Reasoning-Effort 33,2 % bei 0,27 US-Dollar pro Aufgabe, während Claude Opus 5 mit maximalem Effort 26,9 % erreicht – bei 11,1-mal höheren Kosten pro Aufgabe als Sol.
Lies das als Budgetaussage und nicht als Rangliste. Wenn euer Team Agent-Runs bisher rationiert hat, weil ein vollständiger Run teuer war, dann hat sich diese Einschränkung gerade verschoben. Die nächste Einschränkung ist die, aus der man sich nicht freikaufen kann: Ein Mensch muss immer noch den Diff lesen und die Arbeit abnehmen. Dieser Leitfaden nimmt den kleinsten sinnvollen Weg durch das Setup und ist dann ehrlich über den Teil, den die Preissenkung nicht löst. Sol in Codex auf einem Computer einrichten, einen Agent anlegen, eine echte Task zuweisen.
TL;DR
Setze model = "gpt-6-sol" in Codex auf einem verbundenen Computer, prüfe, dass die Codex Runtime in Sharkly als verfügbar angezeigt wird, lass das Arbeitsverzeichnis des Agent im Temporary-Modus, erhöhe das Timeout pro Task, bevor du dem ersten langen Run vertraust, und weise eine Task zu. Sharkly zeigt den Modellnamen nicht an. Angezeigt werden der Run, das Log, die Rückfragen und das Ergebnis an der Task. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab.
Wo die Modelleinstellung liegt
Sharkly wählt keine Modelle aus. Die Agents-Dokumentation sagt es unmissverständlich: „Der Agent folgt dem Standardmodell der Runtime. Er verspricht oder zeigt keinen bestimmten Modellnamen an. Modelle änderst du in der Konfiguration der Runtime oder des Computer-Tools, nicht am Agent.“
Am Agent gibt es kein Modell-Dropdown und auch keine Steuerung für die Denktiefe – such also gar nicht erst danach. Vier Rollen, jede mit einer Aufgabe. Der Agent legt fest, wie Arbeit behandelt werden soll. Der Computer stellt den Host und die lokalen Ressourcen bereit. Die Runtime führt die eigentliche Agent-Session aus, und Codex ist hier die Runtime. Die Task bleibt die gemeinsame Aufzeichnung für das Team.
Schritt 1: GPT-6 Sol in Codex auf dem Computer einrichten
Auf dem Computer, der ihn ausführen soll, aktualisierst du Codex und meldest dich mit einem Konto oder API-Schlüssel an, der Zugriff auf Sol hat. OpenAI hat Sol in ChatGPT Work und in Codex für die Tarife Plus, Pro, Business, Enterprise und Edu verfügbar gemacht; in Chat gibt es Sol noch nicht. Wenn codex -m gpt-6-sol in einem normalen Terminal auf diesem Host eine Session startet, kann Sharkly es verwenden.
Setze dann den Standard, damit jeder Run auf diesem Computer ihn übernimmt:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Zwei Hinweise zu diesem Snippet. Der Name des Keys für den Reasoning-Effort unterscheidet sich zwischen Codex-Versionen – prüfe ihn gegen die Beispielkonfiguration für den Codex-Build auf diesem Computer. Und die Effort-Stufe ist eine Kostenentscheidung, kein Qualitätsregler, den man einfach auf Maximum stehen lässt: Die von OpenAI selbst veröffentlichten Ergebnisse nutzen für verschiedene Benchmarks unterschiedliche Effort-Stufen, und der oben genannte Wert von 0,27 US-Dollar pro Aufgabe ist die xhigh-Zeile. [VERIFY]
Zurück in Sharkly: Öffne die Computer-Detailseite und starte den Rescan oder den Verbindungstest. Die Codex Runtime sollte als verfügbar angezeigt werden. Ein Computer, der nur online anzeigt, bedeutet lediglich, dass sein lokaler Dienst Heartbeats sendet. Der Capability-Status der Runtime ist das, was dir sagt, dass ein Run starten kann.
Schritt 2: Richte den Cache ein, bevor du die Crew skalierst
Das ist die GPT-6-Änderung, die am meisten zählt, sobald mehr als ein Agent im selben Repository arbeitet – und genau die werden die meisten Teams überspringen.
OpenAI meldet für GPT-6 standardmäßig höhere Cache-Hit-Rates, 90 % Rabatt auf gecachte Input-Reads, ein Prompt-Caching-Dashboard und ein Diagnose-Tool und – wichtig für Agent-Arbeit – dass eine Änderung des Reasoning-Efforts oder der Tool-Verfügbarkeit den Cache nicht mehr ungültig macht. Explizite Breakpoints lassen dich festlegen, wo ein gecachter Prefix endet. Laut OpenAI verzeichnete GitHub über Milliarden von Anfragen hinweg mehr als 50 % weniger Prompt-Tokens, die frisch verarbeitet werden mussten.
Für eine Crew sieht das in der Praxis so aus. Jeder Agent-Run im selben Repository sendet einen großen, nahezu identischen Prefix erneut: die Repository-Struktur, die Hausregeln, den Testbefehl, die Konventionen. Genau dafür ist ein Cache da – und deshalb kann eine ganze Flotte von Agents pro Run deutlich weniger kosten als der erste Agent.
Ein Entscheidungspaar, denn das ist keine kostenlose Arbeit. Pinne einen stabilen Prefix und setze einen expliziten Breakpoint, wenn mehrere Agents wiederholt gegen dieselbe Codebase laufen und dein Skill- und Instruktionstext feststeht. Lass es bleiben, wenn ein Agent nur ein paar Mal pro Woche läuft oder sich seine Instruktionen noch wöchentlich ändern – dann verbringst du mit der Pflege der Grenze mehr Zeit, als du einsparst.
Schritt 3: Baue den Agent um einen Run herum, der langsam anläuft
Öffne Agents, wähle New Agent, wähle den Computer und die Codex Runtime aus und stelle dann drei Dinge ein.
Timeout pro Task. Setze es bewusst, denn ein Sol-Run in einem hohen Reasoning-Modus kann tot aussehen, bevor er beschäftigt aussieht. Artificial Analysis, ein Drittanbieter und nicht einer der beiden Anbieter, hat 102,15 Sekunden bis zum ersten Token für die Variante von GPT-6 Sol mit maximalem Reasoning gemessen. Das ist länger, als die meisten warten, bevor sie annehmen, dass etwas hängt – und genau dieser Fehlerfall wird durch einen Status auf einem gemeinsamen Board verhindert, in einem Terminal aber nicht. Ein Run, der nachdenkt, und ein Run, der abgestürzt ist, sehen im Scrollback identisch aus. Was ein Status mitbringen muss, damit er lesenswert ist, steht unter Observability für Coding-Agents.
Arbeitsverzeichnis. Temporary-Modus. Jede Task bekommt ein isoliertes Verzeichnis, und repository-gestützte Runs bereiten einen frischen Worktree vor, sodass zwei Sol-Runs im selben Repository sich nicht gegenseitig überschreiben können. Die Standard-Parallelität für temporäre Verzeichnisse liegt bei 50 % des Limits des Computers. Lass es dabei, bis dieser Computer mehrere echte Runs bewältigt hat; höhere Parallelität verbraucht gleichzeitig CPU, Arbeitsspeicher, Festplatte und Anbieterkapazität.
Instruktionen. Kurz und stabil:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Schritt 4: Weise eine Task zu und entscheide dann, ob eine Crew ihren Platz verdient
Wähle eine Task mit einem klaren Abnahmekriterium. Wähle den Agent als Assignee und verschiebe die Task aus dem Backlog in einen Status, dessen Kategorie „bereit für Arbeit“ ist; eine im Backlog zugewiesene Task wartet. Der Run durchläuft queued, dispatched und running, und der Tab Executions streamt das Log. Wenn der Agent eine Entscheidung braucht, kommt die Frage als Kommentar zur Task zurück, die Task zeigt „wartet auf menschliche Antwort“ an, und das landet in deiner Inbox.
Für eine klar abgegrenzte Änderung ist ein Agent die richtige Wahl, und die beweglichen Teile bleiben bei null. Eine Crew ist eine wiederverwendbare Gruppe aus Personen und Agents, die von einem Leader-Agent koordiniert wird – und sie verdient ihren Platz, wenn der Leader ein Ziel interpretieren und die Ergebnisse mehrerer Mitglieder in einer Task zusammenführen muss.
Sol ändert diese Rechnung, denn ein Leader liest, plant, weist zu und prüft vor allem – und genau diese Arbeit ließ sich am schwierigsten rechtfertigen, wenn sie an der Spitze einer Preisliste stand:
| Runtime-Modell | API-ID | Input / Output pro 1 Mio. | Wo es in einer Crew passt |
|---|---|---|---|
| GPT-6 Astra | nicht angegeben | $10 / $50 | Leader, wenn der Plan selbst der schwierige Teil ist |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Leader und die Mitglieder, die echte Änderungen vornehmen |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | Mitglieder für hohes Volumen: Triage, Labeling, Scaffolding |
Dasselbe Setup für Astra haben wir in GPT-6 Astra als Crew-Leader einsetzen beschrieben. Das Argument dort gilt weiterhin; nur der Preis darunter hat sich verschoben.
Was die Preissenkung nicht kauft
OpenAI beschreibt Sol als 50 % günstiger als der Aktionspreis von GPT-5.6. Diese Einschränkung stammt von OpenAI selbst und sie ist wichtig, denn die Vergleichsbasis ist ein Aktionspreis und kein Listenpreis. Zwei weitere Einschränkungen gehören auf dieselbe Seite. OpenAIs Launch-Benchmarks vergleichen mit Claude Opus 5, das Anthropic noch am selben Tag Stunden später durch Opus 5.5 ersetzt hat – lies diese Vorsprünge also als Werte gegen die vorherige Generation. Und die Effort-Stufe macht den Unterschied: Sol erreicht 68,8 % bei DeepSWE 1.1 und 56,4 % bei Agents' Last Exam V1 mit maximalem Effort – nicht mit der Einstellung, die du für Routineaufgaben dauerhaft aktiviert lassen würdest.
Dann der Teil, bei dem es gar nicht um das Modell geht. OpenAI berichtet, dass seine Forscher im Median mehr als 600 US-Dollar pro Tag für Coding-Agents ausgeben, wobei das 90. Perzentil über 7.000 US-Dollar liegt. Günstiger pro Aufgabe ist der Weg, wie so eine Rechnung entsteht, nicht wie man sie vermeidet. Jeder Run erzeugt weiterhin eine Änderung, die ein Mensch lesen, hinterfragen und abnehmen muss – und diese Warteschlange ist diese Woche nicht 11-mal günstiger geworden. Plane um die Review-Kapazität herum statt um die Modellwahl, halte das Routing als Regel fest statt als Vorliebe, und bewahre Zuweisung, Fortschritt, Blocker, Ergebnisse und menschliches Review von der Anfrage bis zum Release an einem Ort auf.
Wenn du bereits mehrere Coding-Agents laufen lässt, verbinde einen Computer, erstelle einen Agent und weise ihm etwas Langweiliges zu.


