
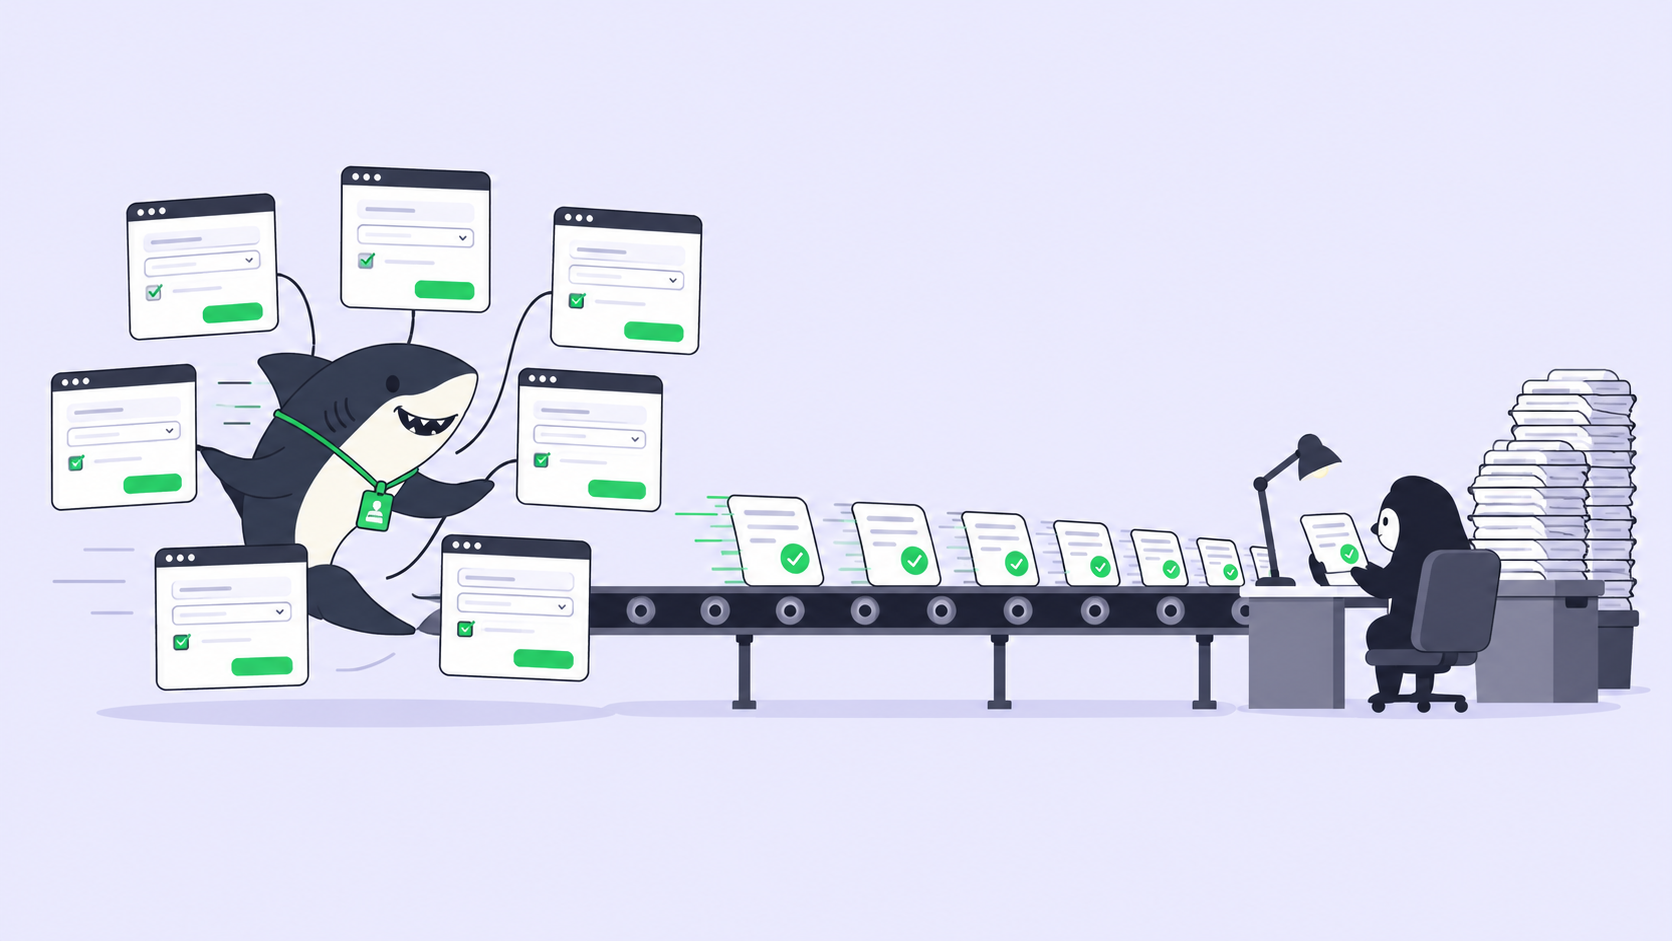
Anthropic hat Claude Haiku 5.5 am 7. Oktober veröffentlicht und gezielt für browserbasierte Aufgaben positioniert. Im Ankündigungsbeitrag wird das Modell als besonders geeignet für „zeitkritische Aufgaben wie Live-Kundensupport und Browser-Nutzung“ beschrieben; auf der Produktseite werden das Ausfüllen von Formularen, Dateneingabe sowie der Datentransfer zwischen Anwendungen hervorgehoben. Zudem wurden mit demselben Release Computer Use und Browser Use als Beta-Features in Anthropics Python- und TypeScript-SDKs integriert. Im Benchmark OSWorld 2.1 für Computer-Nutzung, auf den sich Anthropic beruft, erzielt Haiku 5.5 bei maximalem Aufwand („max effort“) 72,4 % bei etwa 0,61 $ pro Durchlauf und 53,3 % für rund 0,13 $ beim voreingestellten mittleren Aufwand („medium effort“).
Die öffentlichkeitswirksame Zahl spiegelt jedoch nur eine Teilbewertung wider. Wirft man einen Blick in die System Card, zeigt sich bei denselben Durchläufen eine strikte Erfolgsquote von lediglich 37,1 %. Ein Team, das Haiku 5.5 für Browser-Automatisierungen einsetzt, erhält somit Durchläufe für wenige Cent – aber auch Ergebnisse, die meist nur unvollständig abgeschlossen sind. Die Ausführung ist günstig geworden, die Überprüfung hingegen nicht. Für Teams mit mehreren Agenten verlagern sich die tatsächlichen Kosten der Browser-Automatisierung damit auf diejenigen, die die Ergebnisse kontrollieren müssen.
TL;DR
Auf Anthropics Offline-Subset von OSWorld 2.1 erreicht Haiku 5.5 durchschnittlich 72,4 % Teilbewertung, schließt aber nur 37,1 % der Versuche vollständig erfolgreich ab. Sonnet 5.5 und Opus 5.5 weisen bei deutlich höheren Preisen dieselbe Lücke von 34 bis 35 Prozentpunkten auf. Betrachten Sie jeden Browser-Durchlauf als unvollständig, bis er geprüft wurde: Definieren Sie eine strikte Abnahmeprüfung im Task, lassen Sie den Agenten vor jeder Submit-Aktion stoppen und erledigte Punkte, offene Punkte sowie Nachweise melden, und lassen Sie den letzten Schritt von einem Menschen über einen Kommentar mit @-Erwähnung des Agenten freigeben. Investieren Sie in Modell-Aufwand, um Review-Zeit zu sparen – die Ausführung ist der günstige Teil. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Freigaben und nehmen die Ergebnisse ab.
Teilweise erledigt ist nicht fertig
Anthropic hat OSWorld 2.1 auf 82 von 108 Tasks bei 1080p mit bis zu 500 Schritten pro Versuch bei maximalem Aufwand getestet und den Durchschnitt aus fünf Durchläufen gebildet. Dabei wurden zwei Werte pro Modell ausgewiesen – und der zweite ist derjenige, mit dem Reviewer im Alltag umgehen müssen.
| Modell (max. Aufwand) | Teilbewertung | Strikter Erfolg | Differenz | Kosten pro Versuch | Kosten pro striktem Erfolg (unsere Berechnung) |
|---|---|---|---|---|---|
| Haiku 5.5 | 72,4 % | 37,1 % | 35,3 Pkt. | 0,61 $ | ca. 1,65 $ |
| Sonnet 5.5 | 83,9 % | 48,8 % | 35,1 Pkt. | 5,73 $ | ca. 11,75 $ |
| Opus 5.5 | 87,2 % | 53,2 % | 34,0 Pkt. | nicht aufgeführt | nicht aufgeführt |
Erstens ist diese Diskrepanz kein spezifisches Problem von Haiku. Bei jedem Modell der Familie klafft eine Lücke von rund 35 Punkten zwischen „die meisten Schritte wurden ausgeführt“ und „die Aufgabe ist erledigt“ – selbst Opus 5.5 besteht nur in etwa der Hälfte der Fälle vollständig. Ein beträchtlicher Teil der Versuche mit Computer Use endet nach diesen Messungen also unvollständig. Zweitens macht Haiku 5.5 die Produktion unfertiger Arbeit extrem günstig: Pro striktem Erfolg kostet es etwa ein Siebtel von Sonnet 5.5, pro Versuch sogar nur etwa ein Neuntel.
Unfertige Arbeitsergebnisse sind bei Browser-Aufgaben besonders tückisch. Ein Durchlauf, der komplett fehlschlägt, hinterlässt keine Spuren. Ein Durchlauf jedoch, der 31 von 40 Datensätzen ins CRM überträgt oder ein Lieferantenformular bis zum Steuerfeld ausfüllt, hinterlässt in einer fremden Anwendung einen Zustand, der aus der Ferne fertig aussieht. Wer das Ergebnis überprüft, muss die neun fehlenden Datensätze erst mühsam suchen – ohne dass auf dem Bildschirm irgendetwas darauf hinweisen würde.
Wohin sich die Kosten verlagern, wenn der Durchlauf Centbeträge kostet
Eine kostengünstige Browser-Pipeline verändert, welchen Posten im Budget man im Auge behalten muss. Bei 0,13 $ pro Versuch sind hundert Durchläufe zum Ausfüllen von Formularen lediglich ein Rundungsfehler auf der Modell-Rechnung. Hundert Durchläufe, bei denen jedes Mal ein Mensch bestätigen muss, was eingegeben wurde, können jedoch einen ganzen Arbeitstag kosten. Haiku 5.5 ist bei Prompts bis zu 100.000 Tokens 90 % günstiger als Haiku 4.5 – die prüfende Person ist es nicht.
Hinzu kommt ein kleiner Haken bei der Preisgestaltung: Haiku 5.5 kostet bei Prompts bis 100.000 Tokens 0,10 $ pro Million Eingabe-Tokens und 0,50 $ pro Million Ausgabe-Tokens, darüber hinaus jedoch 0,50 $ bzw. 2,50 $. Eine längere Browser-Sitzung kann das Prompt-Volumen schnell über diesen Schwellenwert treiben – ab dann wird für jede weitere Anfrage der höhere Tarif fällig. Ein weiterer Grund, browserbasierte Tasks kurz zu halten: ein Formular, ein Datenstapel, ein Task.
Bereits in Menschliche Überprüfung ist der Engpass und Agenten-Arbeitstage pro menschlichem Arbeitstag wurde dieses Argument dargelegt. Was Haiku 5.5 grundlegend ändert, ist das Verhältnis: Bei 0,13 $ pro Durchlauf fällt die Ausführung finanziell kaum ins Gewicht – und günstige Modelle können teurer werden, sobald man die Review-Warteschlange einrechnet. Der einzige verbleibende Hebel besteht darin, jede Überprüfung schneller zu machen.
Review von Computer-Use-Agenten: Was der Task enthalten muss
Der Task eines Browser-Agenten ist dann überprüfbar, wenn die Kontrolle weniger Zeit in Anspruch nimmt als das erneute Ausführen. Das hängt von drei Faktoren ab, die der Agent nicht im Nachhinein erfinden kann: eine strikte Abnahmeprüfung, die bereits vor dem Durchlauf definiert wurde, ein Bericht, der Erledigtes klar von Unerledigtem trennt, und Nachweise, die ein Mensch einsehen kann, ohne die gesamte Sitzung noch einmal abspielen zu müssen.
In Sharkly ist der Task bereits der zentrale, gemeinsame Datensatz. Er umfasst die Beschreibung, Kommentare, Anhänge und Aktivitäten; der Text des Agenten für das Team wird als an den Durchlauf gekoppelter Kommentar im Task hinterlegt; und das Ausführungsprotokoll erfasst Tool-Aufrufe sowie Runtime-Events. Das Review-Design stützt sich also auf zwei Säulen: Die Task-Beschreibung definiert, was „fertig“ bedeutet, und die Agent-Instruktionen legen fest, was der Bericht enthalten muss. Eine Ausgangsbasis für die Instruktionen eines Agenten zur Browser-Dateneingabe:
Restate the acceptance check from the Task description before you start.
Work up to, but not including, any submit, send, publish, pay, or delete action.
Then stop and report, in this order:
  Done: every record or field you completed, by its identifier.
  Not done: everything you skipped or could not complete, and why.
  Check: the acceptance check, and whether your own count meets it.
  Evidence: the paths of the screenshots you saved in the task directory.
Leave the Task waiting for human review. Do not take the final action
until a person @ mentions you in a comment on this Task to release it.
Formulieren Sie die Abnahmeprüfung als zählbare Größe: „40 Zeilen im CRM, jede mit passender E-Mail-Adresse“, statt „Tabelle importieren“. Die Liste „Not done“ deckt genau das auf, was die Teilbewertung verbirgt; das explizite Benennen übersprungener Elemente verwandelt einen 72-%-Durchlauf in einen 72-%-Durchlauf mit bekanntem Restaufwand. Unser Leitfaden zur Überprüfung von Agentenarbeit mit Nachweisen auf Task-Ebene vertieft das Thema Berichtsformate weiter.
Gemäß Sharklys Agent-Dokumentation nutzt der Agent das Standardmodell der Runtime; um dies zu ändern, geben Sie ein anderes Modell in den „Custom arguments“ des Agenten oder der Runtime an (claude-haiku-5-5 für Claude Code). Es gibt kein Dropdown-Menü zur Modellauswahl. Die Einrichtung wird in Claude Haiku 5.5 Agenten in Sharkly ausführen beschrieben.
Vor dem Absenden stoppen
Ein Teilergebnis mag für einen Entwurf akzeptabel sein, für ein bereits abgeschicktes Formular ist es das nicht. Trennen Sie irreversible Schritte daher aus dem Durchlauf heraus, anstatt darauf zu hoffen, dass das Modell alles fehlerfrei erledigt.
Dieses Muster greift auf Funktionen zurück, die Sharkly bereits mitbringt. Der Agent arbeitet bis zur finalen Aktion und versetzt den Task anschließend in den Status „Wartet auf menschliche Überprüfung“, was direkt im Posteingang des Reviewers erscheint. Der Reviewer öffnet den Bericht sowie die Screenshots, korrigiert oder lehnt ab und erwähnt den Agenten anschließend mit einem @-Kommentar im Task, um den Schritt freizugeben. Ein einfacher Kommentar ohne Erwähnung startet den Agenten nicht; erst die Erwähnung öffnet oder setzt die Konversation im Task fort, und die Antwort des Agenten wird als weiterer verknüpfter Kommentar gespeichert. Das eigentliche Absenden erfolgt im selben Task und unter demselben Datensatz – nachdem ein Mensch zugestimmt hat. Unser Leitfaden zu Approval Gates zeigt, an welchen weiteren Stellen ein solcher Stopp sinnvoll ist.
Dieses Gate mindert zudem ein weiteres Risiko im Browser-Einsatz: Ein Browser-Agent liest Seiten, die er nicht selbst verfasst hat. Laut Anthropics System Card widersteht Haiku 5.5 Prompt Injections besser als alle vorherigen Haiku-Modelle und hält bei adaptiven Angreifern in Computer-Use-Umgebungen weitgehend mit den Spitzenmodellen mit. Das ist jedoch ein Benchmark-Ergebnis und kein Garantieversprechen für Ihr individuelles Lieferantenportal – und eine injizierte Anweisung, die den Submit-Button ohne Freigabe durch einen menschlichen Kommentar gar nicht erst erreichen kann, richtet deutlich weniger Schaden an. Die hostseitige Absicherung (ein dedizierter Computer, an den Agenten über geheime Umgebungsvariablen gebundene Zugangsdaten, jeweils nur ein Browser-Durchlauf gleichzeitig) entspricht unserem Leitfaden für Computer-Use-Guardrails; weitere Aspekte behandelt der Beitrag Prompt Injection und Agent-Guardrails.
Daraus ergibt sich eine klare Entscheidungsgrundlage für diese Pipeline: Setzen Sie einen Haiku 5.5 Browser-Agenten ein, wenn sich das Ergebnis anhand einer Zahl oder Liste in unter einer Minute überprüfen lässt und die finale Aktion entweder reversibel ist oder durch einen Kommentar freigegeben werden muss. Überlassen Sie die Arbeit hingegen einem Menschen oder einem größeren Modell mit demselben Gate, wenn das Überprüfen darauf hinausläuft, die Arbeit noch einmal selbst zu machen – denn in diesem Fall bringt eine strikte Erfolgsquote von 37 % nichts außer einem zweiten Arbeitsdurchgang.
In Aufwand investieren, Review-Zeit sparen
Haiku 5.5 ist Anthropics erstes Haiku-Modell mit einer Aufwandseinstellung (Effort Setting); der Standardwert ist „medium“. Auf OSWorld verbessert ein höherer Aufwand die Teilbewertung für sehr wenig Geld erheblich:
| Aufwand (Effort) | Teilbewertung | Kosten pro Versuch |
|---|---|---|
| Low | 42,0 % | 0,07 $ |
| Medium (Standard) | 53,3 % | 0,13 $ |
| High | 61,3 % | 0,18 $ |
| Xhigh | 67,6 % | 0,28 $ |
| Max | 72,4 % | 0,61 $ |
Der Wechsel von „Medium“ zu „Max“ schlägt mit etwa 0,49 $ mehr pro Versuch zu Buche und bringt 19 Punkte mehr bei der Teilbewertung. Wenn diese Punkte das Review auch nur minimal verkürzen, ist „Max“ für jeden browserbasierten Task, der von einem Menschen geprüft wird, die wirtschaftlichere Option. Die System Card stellt die strikte Erfolgsquote zwar nach Aufwand grafisch dar, nennt konkrete Zahlen jedoch nur für die Stufe „Max“ – messen Sie die tatsächlichen Endergebnisse daher an Ihren eigenen Tasks, bevor Sie sich für eine niedrigere Stufe entscheiden. Der Aufwand wird in Claude Code auf dem Computer konfiguriert; der Agent selbst bietet weder eine Modellauswahl noch eine Steuerung der Denktiefe. Nutzen Sie die günstige Schiene dort billig, wo niemand die Ausgabe liest, wie in Luna für die langweiligen achtzig Prozent beschrieben – für eine Browser-Pipeline gilt das jedoch nicht.
Browser-Aufgaben, die Daten in Drittsysteme schreiben, sollten einen eigenen Task erhalten, anstatt Teil eines größeren Gesamtdurchlaufs zu sein – denn am Ende muss jemand die Ergebnisse abnehmen. Die allgemeine Regel dazu erläutert der Beitrag Haiku 5.5 als Subagent oder eigenständiger Agent.
Ein günstigerer Browser-Agent führt zu mehr Durchläufen – und mehr Durchläufe bedeuten mehr unvollständige Ergebnisse, die auf eine manuelle Überprüfung warten. Wenn Sie bereits mehrere Agenten einsetzen, bietet Sharkly Ihnen einen zentralen Ort, um deren Tasks und Resultate zu verwalten.


