
Sie versuchen zu entscheiden, welchem Coding-Agent Sie echte Arbeit anvertrauen sollen: Claude Code, Codex, Gemini CLI, OpenCode – oder gleich zwei davon. Also lesen Sie die Benchmark-Ergebnisse. Ein Agent löst 68 % eines öffentlichen Aufgabensatzes, ein anderer 71 %, und danach sollen Sie Ihre Wahl treffen. Dann landet der Agent in Ihrem Repository und bleibt an einem Build-Schritt hängen, den noch kein öffentlicher Datensatz je gesehen hat.
Ein Benchmark misst eine feste, gemeinsame Menge von Problemen. Ihre Codebasis ist eine private Menge von Problemen: Ihre Konventionen, Ihr Monorepo-Layout, der flaky Test, den alle ignorieren, das Deploy-Skript, das nur eine Person versteht. Die Punktzahl, die über Ihre Woche entscheidet, ist die, die Sie auf diesem Code erzielen – nicht die, die ein Labor veröffentlicht hat. Dieser Leitfaden beschreibt eine Methode, um Coding-Agents anhand der Software zu vergleichen, die Sie tatsächlich ausliefern, und wie Sie diesen Vergleich durchführen, ohne fünf Terminals zu öffnen, um die Agents auseinanderzuhalten.
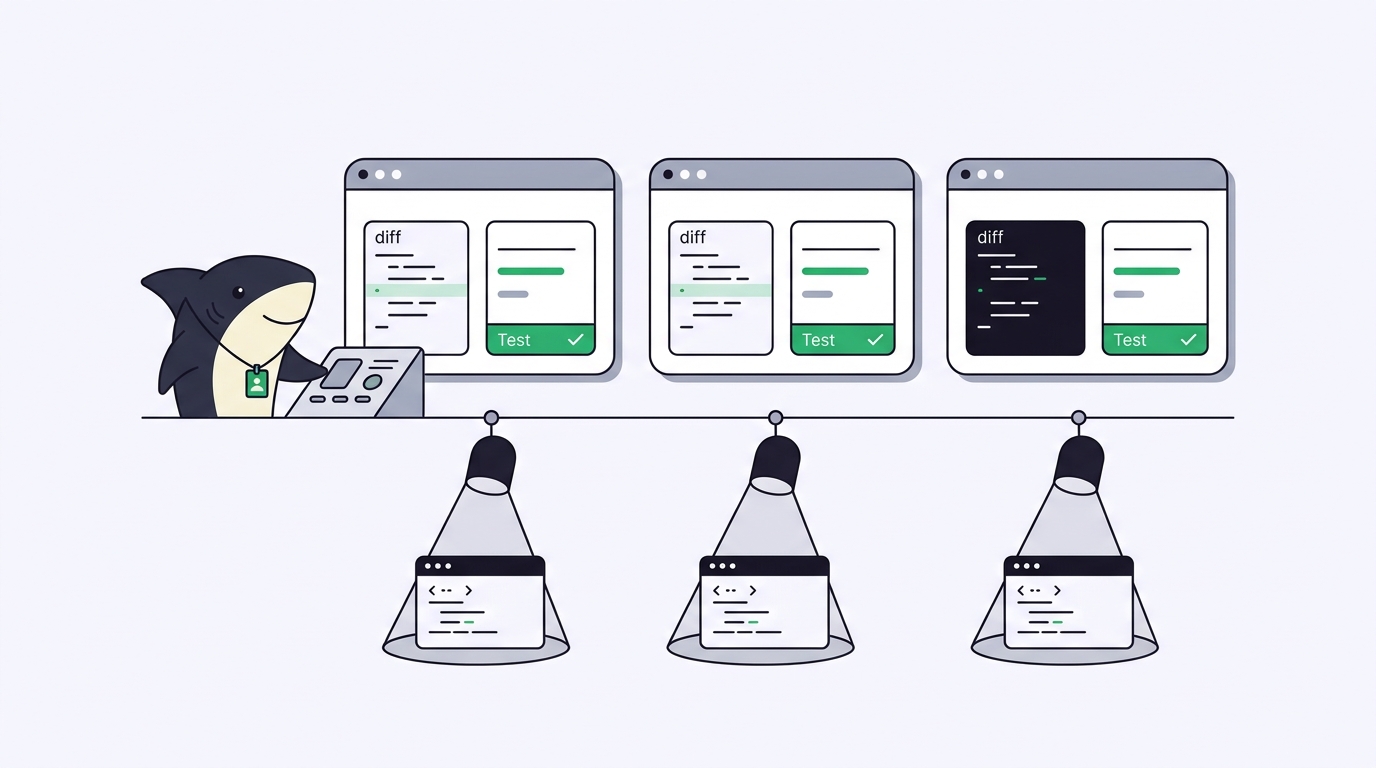
Sharkly ist der Ort, an dem diese Methode ankommt. Sharkly ist eine All-in-One-Plattform für Agent-Command und -Management: Sie verbinden Ihren eigenen Computer, weisen verschiedenen Agents dieselbe Task zu, und jeder Lauf liefert seinen Diff, seine Testausgabe und sein Review an einen einzigen Ort zurück. Genau das macht einen fairen Vergleich möglich. Die Variable, die Sie messen wollen, ist der Agent – nicht das Terminal-Jonglieren, das Sie sonst betreiben müssten, damit sich drei Läufe nicht gegenseitig in die Quere kommen.
Ein Benchmark-Ergebnis misst einen Datensatz, nicht Ihr Repository
Ein Coding-Agent-Benchmark ist ein fester öffentlicher Testsatz, der für alle gleich bewertet wird. Genau das macht ihn für die Labore, die Modelle bauen, nützlich – und genau das macht ihn zu einem schwachen Prädiktor für Sie.
Öffentliche Benchmarks wie SWE-bench beziehen ihre Aufgaben aus bekannten Open-Source-Projekten, mit einer abgestimmten Testumgebung und kuratierten Akzeptanzprüfungen. Nichts davon beschreibt Ihren Dienstag. Was die Leistung eines Agents auf Ihrem Code bestimmt, sind die Dinge, die ein öffentlicher Datensatz niemals enthalten kann: Ihre internen Bibliotheken, die das Modell nie gelesen hat, Ihre Lint-Konfiguration, die 400 Zeilen lange Kontextdatei, die erklärt, wie der Dienst tatsächlich startet, das eine Modul ohne Tests.
Ein hohes Benchmark-Ergebnis sagt nicht voraus, wie sich ein Agent in Ihrem Repository verhält. Es sagt voraus, wie er sich in dem von jemand anderem verhält. Betrachten Sie das Leaderboard als groben Filter dafür, welche Agents einen Test wert sind, und führen Sie dann den Test durch, der zählt. Wenn Sie noch dabei sind, auszuwählen, auf welches Modell Sie jeden Agent ausrichten, ist die Zuordnung von Modellen zu Agent-Rollen eine bessere Ausgangsfrage als die reine Punktzahl.
Wählen Sie eine echte Aufgabe, keinen Spielzeug-Prompt
Beginnen Sie mit dem kleinsten sinnvollen Vergleich. Benchmarken Sie Agents nicht mit „bau eine Todo-App“. Wählen Sie eine echte Anforderung aus Ihrem Backlog: einen überschaubaren Bug, ein kleines Feature in einem einzigen Modul, eine Migration, die Sie sowieso gemacht hätten. Etwas mit einem Akzeptanztest, den Sie ausführen können, und einem Diff, den Sie in wenigen Minuten lesen können.
Geben Sie dann jedem Agent dieselbe Eingabe: dieselbe Aufgabenbeschreibung, denselben Ausgangs-Commit, dieselben Akzeptanzkriterien. Schreiben Sie es so auf, wie es in Ihrem Tracker stehen würde, eine Aufgabe wie SH-312: fix the timezone drift in the invoice export. Wenn ein Agent einen umfangreicheren Prompt bekommt als ein anderer, messen Sie Ihren Prompt, nicht den Agent.
Nutzen Sie einen Bugfix, wenn Sie sehen wollen, wie ein Agent vorhandenen Code liest und sich an die Vorgaben hält. Nutzen Sie ein kleines Feature, wenn Sie sehen wollen, wie er neuen Code strukturiert und ob er seine eigenen Tests schreibt. Führen Sie im Laufe der Zeit beides durch; eine einzelne Aufgabe sagt Ihnen nur etwas über eine einzelne Aufgabe.
Vergleichen Sie jeden Agent in Bestform, nie in schlechtester Form
Jeder Agent hat ein Setup, in dem er seine stärkste Arbeit leistet: das richtige Modell, die richtige Kontextdatei, die Berechtigungen, die er tatsächlich braucht. Geben Sie Claude Code seine CLAUDE.md, geben Sie Codex seine Konfiguration, geben Sie jeder Runtime die Umgebung, die ihre Dokumentation empfiehlt. Einen gut konfigurierten Agent mit einem nackten zu vergleichen, sagt Ihnen nichts – außer, welchen Sie sich die Mühe gemacht haben einzurichten.
Sie in Bestform Seite an Seite laufen zu lassen, ist der Punkt, an dem der Terminal-Ansatz auseinanderbricht. Auf Sharkly weisen Sie jedem Agent dieselbe Task zu, und jeder Agent läuft auf einem verbundenen Computer in einem isolierten Worktree, sodass drei Agents, die dasselbe Repository bearbeiten, niemals die Dateien der anderen anfassen. Sie erhalten drei saubere Versuche am selben Problem statt eines gemeinsam genutzten Arbeitsverzeichnisses und eines Merges, den Sie von Hand entwirren müssen. Wenn Sie das bisher manuell gemacht haben, ist mehrere Agents gleichzeitig laufen zu lassen genau der Teil, den Sharkly Ihnen abnehmen soll.
Wenn Sie nur einen Agent verwenden und in der Kommandozeile leben, reicht eine einzelne gut abgestimmte Claude-Code-Sitzung in einem Worktree aus, und Sie brauchen das alles vielleicht gar nicht. Die Gleichung ändert sich in dem Moment, in dem Sie zwei oder mehr Agents vergleichen, über mehr als eine Aufgabe hinweg, und die Ergebnisse in einer Form haben wollen, die Sie tatsächlich Seite an Seite lesen können.
Fünf Kriterien, die bei echter Arbeit den Ausschlag geben
Ein Benchmark bewertet eine einzige Zahl: Hat die Aufgabe bestanden oder nicht. Echte Arbeit entscheidet sich an fünf Dingen, die diese Zahl auslässt.
| Kriterium | Die Frage, die es beantwortet |
|---|---|
| Parallele Ausführung | Kann ich die Agents gleichzeitig an derselben Aufgabe laufen lassen, isoliert, ohne Konflikte? |
| Team-Sichtbarkeit | Kann jemand außer mir sehen, was jeder Agent getan hat – und warum? |
| Review-Ablauf | Wie schnell kann ich den Diff, die Tests und die bekannten Grenzen lesen und annehmen oder ablehnen? |
| Ausführung auf eigener Maschine | Läuft der Agent auf meinem Computer, gegen meine echte Umgebung und meine Secrets? |
| Integrationen | Landet das Ergebnis im Tracker, im Repo und in den Review-Tools, die wir bereits nutzen? |
Bei den ersten vier sehen die meisten Agents in einem Benchmark identisch aus und verhalten sich auf Ihrem Code völlig unterschiedlich. Besonders die Ausführung auf der eigenen Maschine ist für einen öffentlichen Test unsichtbar: Ein Agent, der gegen Ihre tatsächliche Toolchain, Ihre lokale Datenbank, Ihre echten CI-Hooks läuft, wird an dem getestet, was Sie ausliefern – nicht in einer Sandbox, die dem nur ähnelt.
Agents recherchieren, führen aus, testen und berichten. Sie geben die Richtung vor, erteilen die Befugnis und nehmen das Ergebnis ab. Ein Vergleich ist nur dann ehrlich, wenn Sie jeden dieser Teile sehen können – für jeden Agent –, ohne ihn aus dem Scrollback rekonstruieren zu müssen.
Bewerten Sie, was zurückkommt, nicht was der Agent behauptet
Ein Agent, der „done“ ausgibt, ist nicht dasselbe wie eine Änderung, die besteht. Bewerten Sie jeden Lauf nach dem, was zurückkommt, nicht nach dem, was behauptet wird. Für jeden Versuch ist die nützliche Evidenz dieselbe kurze Liste: der Diff, die Typecheck- und Testergebnisse, die Änderungszusammenfassung und die Grenzen, die der Agent einräumt. Sharkly hält Kontext, Fortschritt, Blocker, Ergebnisse und menschliches Review von der Anfrage bis zum Release sichtbar, sodass sich der Vergleich wie eine Tabelle mit Ergebnissen liest statt wie fünf Terminals, an die Sie sich erinnern müssen.
Hier zeigt sich auch der eigentliche Engpass. Zwei Agents können eine Aufgabe beide in zwanzig Minuten „erledigen“ und Sie trotzdem jeweils eine Stunde für das Review kosten. Das Review der Agent-Ausgabe ist oft die eigentliche Grenze dafür, wie viel parallele Arbeit ein Team aufnehmen kann, und das sollte stark ins Gewicht fallen, wenn Sie einen Agent auswählen. Was zu gewichten ist, hängt davon ab, wer auswählt:
| Auswahl für | Am stärksten gewichten |
|---|---|
| Einzelentwickler | Review-Ablauf und Ausführung auf eigener Maschine; Sie sind der einzige Reviewer |
| Kleines Team | Parallele Ausführung und Team-Sichtbarkeit; mehrere Personen müssen dieselben Läufe sehen |
| Plattform-Team | Integrationen und Sichtbarkeit; der Workflow muss den nächsten besten Agent überleben |
Genau darum geht es beim Vergleich überhaupt. Der beste Agent von heute ist vielleicht nicht der beste Agent im nächsten Quartal, und Ihren Workflow jedes Mal neu aufzubauen, wenn sich die Spitze ändert, ist eine Steuer für sich. Sharkly ist kein Coding-Agent und keine Benchmark-Harness; es ist die Ebene, die es Ihnen ermöglicht, Agents weiterhin gegen Ihren eigenen Code zu testen, ohne den Prozess jedes Mal neu um sie herum aufzubauen.
Wenn Sie weiterhin mehrere Coding-Agents nutzen möchten, statt sich auf ein Ökosystem festzulegen, dann ist das genau das Problem, für das Sharkly entwickelt wurde. Laden Sie Sharkly herunter, verbinden Sie einen Computer und weisen Sie zwei Agents dieselbe echte Aufgabe zu. Der Vergleich, den Sie zurückbekommen, dreht sich um Ihre Codebasis – und nur der sagt Ihre Woche voraus.


