
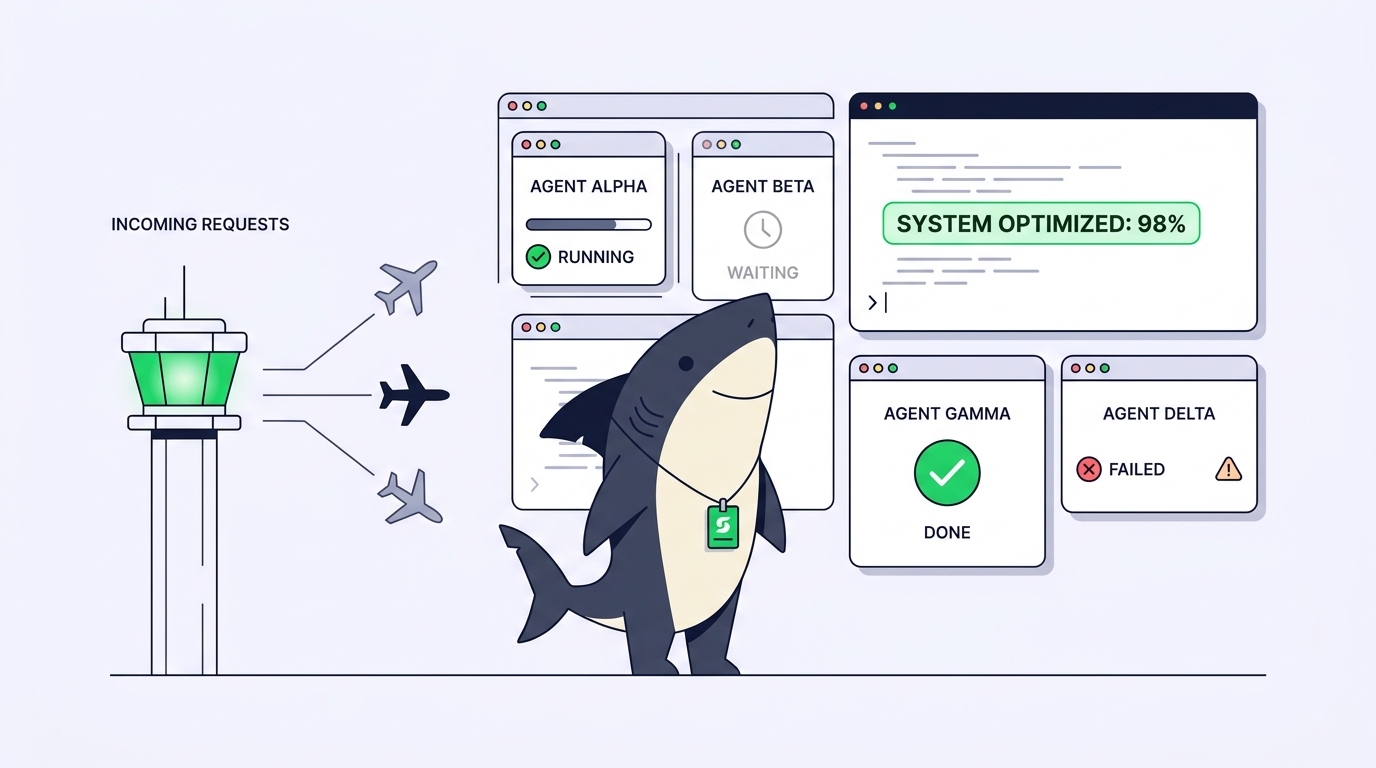
Heute Morgen hast du drei Coding-Agents gestartet. Einer refaktoriert ein Auth-Modul, einer schreibt Tests, einer geht einem unzuverlässigen CI-Job nach. Eine Stunde später hast du fünf offene Terminals, zwei getrennte tmux-Panes und das nagende Gefühl, dass mindestens einer von ihnen schon vor einer Weile gestoppt hat und untätig herumsteht, während du nicht hingesehen hast. Du wechselst mit Alt-Tab die Fenster, scrollst durch ein Log und rätst ins Blaue hinein.
Dieses Rätselraten ist der eigentliche Preis dafür, Agents parallel laufen zu lassen. Mehrere Coding-Agents gleichzeitig zu starten, ist heutzutage ein Kinderspiel. Zu wissen, welcher deine Hilfe braucht, welcher festhängt und welcher still und heimlich fertig geworden ist – genau das frisst den Nachmittag auf. Parallele Coding-Agents zu überwachen bedeutet, vier entscheidende Fragen live zu beantworten, ohne fünf Fenster öffnen zu müssen: Was tut der jeweilige Agent gerade, wie weit ist er gekommen, was blockiert ihn und was liegt zur Überprüfung vor?
Dieser Leitfaden führt zunächst durch ein Do-it-yourself-Monitoring-Setup, benennt die Schwachstellen bei jedem Schritt und zeigt anschließend, wo dieser Ansatz an seine Grenzen stößt und welchen Mehrwert eine gemeinsame Task-Ebene bietet. Diese gemeinsame Ebene ist Sharkly: Coding-Agents hast du bereits im Einsatz, und Sharkly macht sie zu einem Team, indem es den Fortschritt, Blocker und Ergebnisse jedes Agents an einem zentralen Ort sichtbar hält, statt sie über Terminals zu verstreuen. Du kannst den Großteil dieses Monitorings selbst bauen. Sinn und Zweck dieses Vergleichs ist es, genau zu erkennen, ab wann die selbstgebaute Lösung mehr Zeit und Nerven kostet, als sie einspart.
Die vier Signale, auf die es wirklich ankommt
Monitoring ist nicht gleich Monitoring. Wenn jemand sagt, ein Agent-Durchlauf „sieht gut aus“, meint er meist eines von vier verschiedenen Signalen – und jedes davon versagt auf andere Weise.
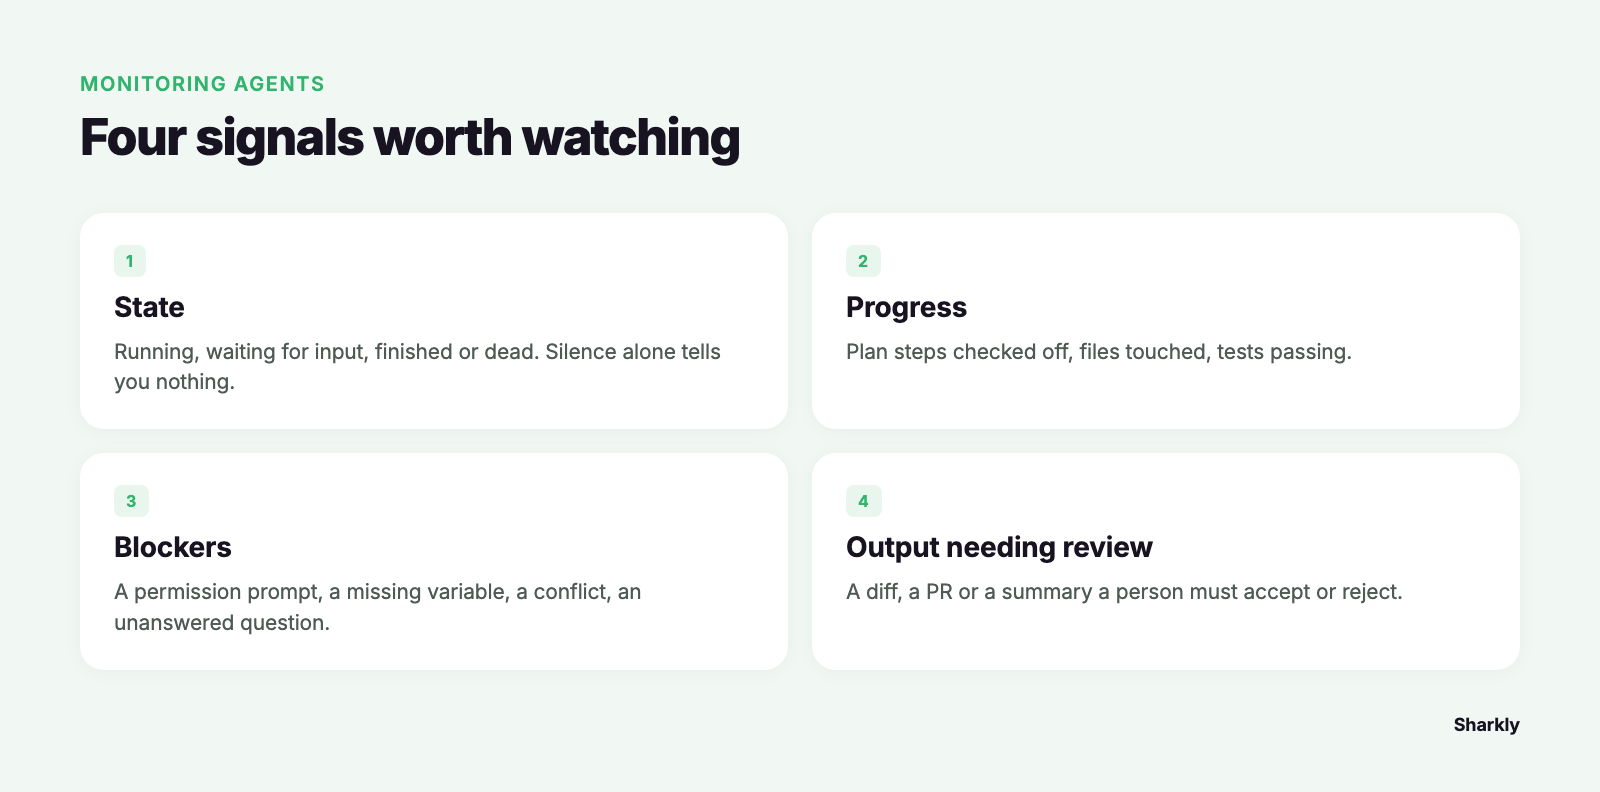
- Status. Läuft der Prozess, wartet er auf eine Eingabe, ist er fertig oder abgestürzt? Ein beendeter Agent und ein hängengebliebener Agent erzeugen beide keine neuen Ausgaben mehr – Stille allein sagt also gar nichts aus.
- Fortschritt. Wie viel von der Aufgabe ist erledigt? Abgehakte Schritte im Plan, bearbeitete Dateien, bestandene Tests. Der Fortschritt verrät, ob ein aktiver Agent wirklich vorankommt oder in einer Endlosschleife feststeckt.
- Blocker. Worauf wartet der Agent? Eine Berechtigungsabfrage, eine fehlende Umgebungsvariable, ein Merge-Konflikt oder eine Rückfrage, die niemand beantwortet hat.
- Ergebnisse zur Überprüfung. Was hat der Agent geliefert, das ein Mensch nun abnehmen oder ablehnen muss? Ein Diff, ein PR, eine Zusammenfassung der Änderungen.
Achtet man nur auf den Status, übersieht man den Agent, der zwar läuft, aber in einer Retry-Schleife festhängt. Achtet man nur auf den Fortschritt, entgeht einem derjenige, der schon vor zwanzig Minuten fertig war. Ein solides Monitoring muss alle vier Signale für jeden einzelnen Agent auf einen Blick sichtbar machen.
Schritt 1: Monitoring im Eigenbau – und wo der Ansatz schwächelt
Das selbstgebaute Setup setzt auf Tools, die du ohnehin schon nutzt. Hier ist die ehrliche Bestandsaufnahme samt der Lücken, die jeder Schritt hinterlässt.
Sehen, was läuft. Wenn jeder Agent in seinem eigenen git worktree läuft, liste sie mitsamt ihren Branches auf:
git worktree list
tmux ls   # if each agent runs in a tmux session
Schwachstelle: Das zeigt dir lediglich, dass eine Session existiert, nicht aber, ob der darin laufende Agent arbeitet oder wartet. Ein tmux-Pane, das an einer Continue? (y/n)-Abfrage festhängt, sieht genauso aus wie eines mitten in der Arbeit. Du merkst es erst, wenn du dich per attach einklinkst.
Fortschritt beobachten. Verfolge die Ausgabe jedes Agents mit tail und polle seinen Worktree auf Änderungen:
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
Schwachstelle: Das skaliert linear mit der Anzahl der Agents. Drei Logs lassen sich noch lesen. Sechs parallel laufende Log-Tails nicht mehr – und watch-Schleifen zeigen dir nur Dateiänderungen, aber keine echten Bedeutungen. Du siehst zwar, dass Dateien geändert werden, hast aber keine Ahnung, ob die Änderung korrekt ist oder ob der Agent sich im Kreis dreht.
Fertigstellung mitbekommen. Kapsle jeden Agent so, dass er dir ein Signal sendet, sobald der Prozess endet:
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
Schwachstelle: Der Exit-Code 0 bedeutet lediglich, dass der Prozess beendet wurde – nicht, dass das Ergebnis brauchbar oder die Arbeit überhaupt abgeschlossen ist. Viele Agents beenden sich sauber, nachdem sie eine Frage gestellt haben, die du nie gesehen hast. Ein „Fertig“-Ping verleitet dazu, einem Signal zu vertrauen, das in Wahrheit gar nicht „fertig“ bedeutet.
Konflikte erkennen. Wenn mehrere Agents dasselbe Repository nutzen, halten Worktrees zwar deren Arbeitsverzeichnisse getrennt, doch wenn zwei Agents dieselbe Datei auf zwei unterschiedlichen Branches bearbeiten, kommt es beim Mergen unweigerlich zur Kollision.
git worktree list --porcelain | grep branch
Schwachstelle: Du erfährst erst beim Merge von den Überschneidungen – und das ist der denkbar ungünstigste und teuerste Zeitpunkt dafür.
Nichts davon ist grundlegend falsch. Für zwei oder drei Agents, die an unabhängigen Aufgaben arbeiten, sind ein paar tmux-Panes und eine watch-Schleife ein völlig ausreichendes Monitoring – da braucht man keine schwereren Geschütze aufzufahren. Halte die Zahl der beweglichen Teile bei null, bis du an die Grenzen stößt.
Wo das DIY-Monitoring an seine Grenzen stößt
Diese Grenze ist erreicht, sobald du so viele Agents ausführst, dass sie nicht mehr auf einen einzigen Bildschirm passen. Dann potenzieren sich drei Probleme:
Polling verrät den Status, nicht die Ursache. git status und ein Log-Tail zeigen zwar, dass sich etwas geändert hat oder keine Ausgabe mehr erfolgt. Sie können dir jedoch nicht sagen, ob der Agent an einem Prompt festhängt, eine fehlende Abhängigkeit ihn blockiert oder er schlicht fertig ist. Am Ende verbindest du dich nacheinander mit jeder einzelnen Session, um die Ursache zu ermitteln – und genau dieses ständige Wechseln zwischen Terminals sollte durch die Parallelisierung eigentlich vermieden werden.
Es gibt keinen gemeinsamen Status. Dein Monitoring existiert nur lokal auf deinem Laptop, in deinem tmux-Server und in deiner Shell-Historie. Teamkollegen können nicht sehen, welcher Agent für welche Aufgabe zuständig ist – und du selbst siehst es auch nicht mehr, sobald du das Notebook zuklappst. Läuft ein Agent auf einem Remote-Server, versagt der lokale Tail-Ansatz komplett.
Das Review wird zum Flaschenhals. Genau dieser Punkt wird meist unterschätzt. Es bringt wenig, Agents parallel laufen zu lassen, wenn das Reviewen ihrer Ergebnisse anschließend wieder sequenziell in einer Einer-Warteschlange landet. Fünf fertige Diffs ohne einen gemeinsamen Ort, an dem festgehalten wird, was „geprüft / Änderungen angefordert / gemergt“ wurde, bedeuten bloß fünf Browser-Tabs und ein diffuses Merken im Kopf. Die Agents sind schneller geworden – der Mensch dahinter langsamer.
An diesem Punkt fehlen dir nicht noch mehr Terminals. Was dir fehlt, ist ein zentraler Überblick.
Was ein Task-Board bringt: Alle Ergebnisse an einem zentralen Ort
Eine Task-Ebene ändert die Einheit des Monitorings von „ein Prozess in einem Pane“ zu „ein Task mit einem Status“. Genau um diesen Paradigmenwechsel herum ist Sharkly aufgebaut, und er bildet die vier Signale direkt ab.
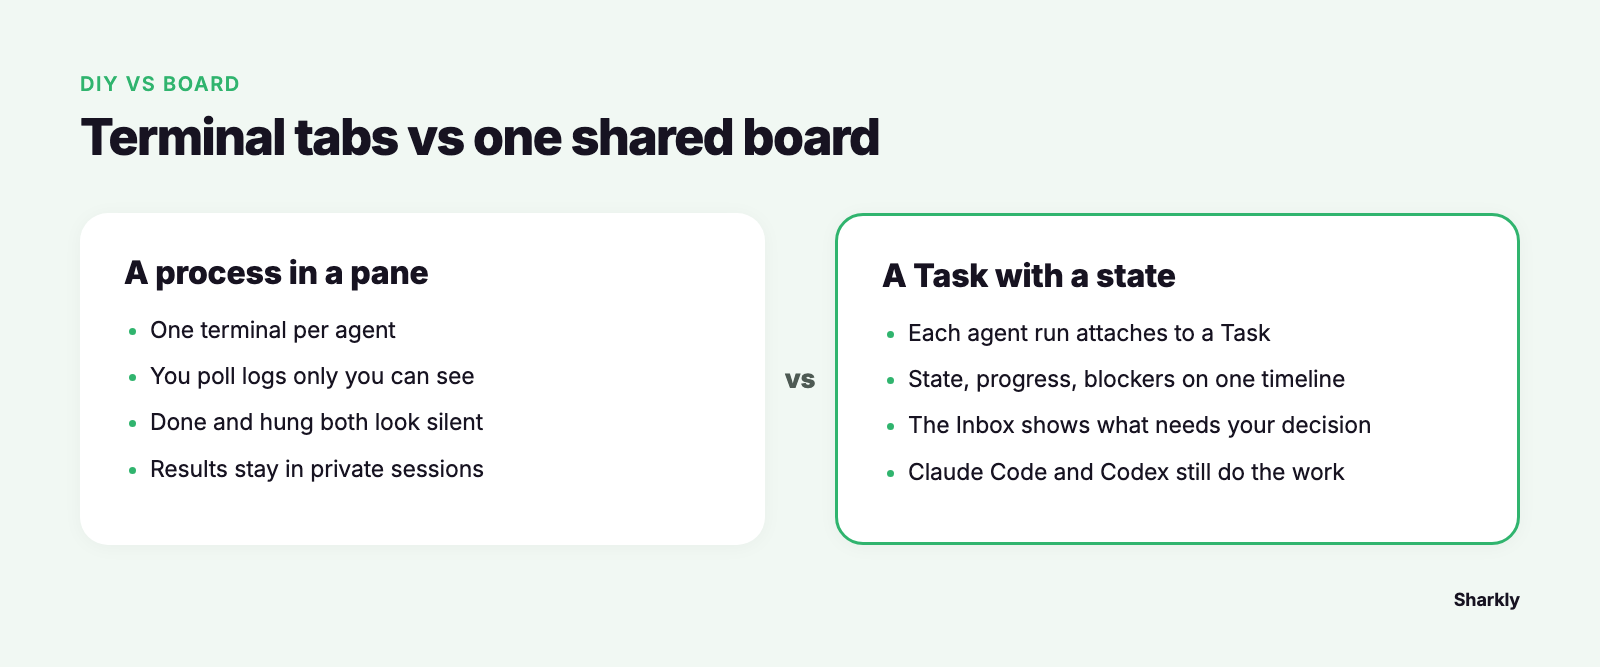
Jeder Agent-Durchlauf ist an einen Task gekoppelt. Status, Fortschritt, Blocker und Ergebnisse fließen direkt in die Timeline dieses Tasks zurück, anstatt in einem Logfile zu verstauben, das nur du sehen kannst. Statt ständig manuell nachzusehen, blickst du einfach auf ein Board: Welche Tasks sind in Bearbeitung, welche sind blockiert, welche sind abgeschlossen und warten auf dich? In der Inbox von Sharkly landen genau die Durchläufe, die menschliche Aufmerksamkeit erfordern. Die Frage lautet damit nicht länger „Ist schon irgendetwas fertig?“, sondern „Hier ist das, was meine Entscheidung braucht“. Agents recherchieren, führen aus, testen und berichten; Menschen geben die Richtung vor, erteilen Freigaben und nehmen das Ergebnis ab. Die Automatisierung endet dort, wo menschliches Urteilsvermögen gefragt ist.
Diese klare Abgrenzung ist wichtig, denn Missverständnisse entstehen schnell: Sharkly führt weder den Agent aus, noch schreibt es den Code. Claude Code, Codex und die anderen Runtimes, die du bereits nutzt, übernehmen weiterhin die Ausführung. Sharkly legt eine gemeinsame Ebene für Tasks, Umgebungen, Kontext und Reviews darüber, sodass der Fortschritt eines Durchlaufs und das zugehörige Diff an einem Ort landen, den das gesamte Team von der Anfrage bis zum Release einsehen kann. Zudem wird jeder Durchlauf in einem eigenen, isolierten Worktree gehalten – Überschneidungen an denselben Dateien, die man sonst erst beim Mergen bemerken würde, bleiben so sauber auf den jeweiligen Task begrenzt.
Die ehrliche Entscheidungshilfe lautet: Wenn du nur ein oder zwei Agents für voneinander unabhängige Aufgaben laufen lässt und die Ergebnisse an niemanden übergeben musst, reicht das DIY-Monitoring völlig aus – Sharkly wäre dann reiner Overhead. Die Rechnung ändert sich jedoch, sobald die Agents mehr Bildschirme füllen, als du hast, wenn Aufgaben auf entfernten Rechnern laufen oder wenn andere Teammitglieder denselben Überblick benötigen. Wenn du weiterhin flexibel verschiedene Coding-Agents nutzen möchtest, statt dich auf ein einziges Ökosystem festzulegen, ist genau diese gemeinsame Übersicht das Problem, für das Sharkly entwickelt wurde. Einen umfassenderen Überblick darüber, was auf ein solches Board gehört, findest du im Artikel darüber, was ein Dashboard für KI-Coding-Agents wirklich anzeigen sollte.
Eine Monitoring-Checkliste für den sofortigen Einsatz
Ganz gleich, ob du bei der selbstgebauten Lösung bleibst oder auf eine gemeinsame Ebene umsteigst: Ein Monitoring für parallele Agents sollte folgende Fragen beantworten, ohne dass du dich erst in eine einzige Session einklinken musst:
- Jeder Agent ist einem benannten Task zugeordnet. Kein anonymes „agent-3“. Du solltest auf Anhieb sagen können, wofür welcher Agent da ist.
- Der Status ist auf einen Blick erkennbar. Ob aktiv, wartend auf Eingabe, fertig oder fehlgeschlagen – klar unterscheidbar und nicht erst aus Stille geschlussfolgert.
- Blockierte Agents machen sich bemerkbar. Ein Prompt, der auf ein
y/nwartet, ein fehlendes Secret oder eine unbeantwortete Frage werden dir aktiv angezeigt, anstatt heimlich die Ausführung zu stoppen. - „Fertig“ bedeutet überprüfbar, nicht nur beendet. Ein abgeschlossener Durchlauf verweist auf ein Diff oder einen PR, nicht nur auf einen Exit-Code.
- Reviews besitzen einen eigenen Status. „Geprüft“, „Änderungen angefordert“ und „Gemergt“ werden nachverfolgt, damit parallele Arbeit nicht wieder in einer sequenziellen Warteschlange versandet.
- Die Übersicht bleibt auch bei zugeklapptem Laptop erhalten und ist teilbar. Der Status existiert an einem zentralen Ort statt nur in deiner Shell-Historie.
- Arbeiten im selben Repository sind isoliert. Jeder Agent besitzt seinen eigenen Worktree, und Dateiüberschneidungen fallen vor dem Merge auf, nicht erst währenddessen.
Gehe diese Liste anhand deines aktuellen Setups durch. Die Punkte, die du heute nicht abhaken kannst, sind genau jene, die dich später einen ganzen Nachmittag kosten werden. Wenn du bereits mehrere Agents im Einsatz hast, bietet dir Sharkly einen zentralen Ort, um deren Tasks und Ergebnisse zu verwalten. Du kannst deine bestehenden Coding-Agents auch über Sharkly ausführen und deine gewohnten Runtimes einfach weiternutzen.


