
Ein Pull Request landet in deiner Queue – 340 geänderte Zeilen über neun Dateien hinweg. Geschrieben hat ihn ein Coding-Agent. Der Diff verrät dir nicht, was dem Agenten aufgetragen wurde, welche Ansätze er ausprobiert und wieder verworfen hat, was er ausgeführt hat, um sich selbst zu überzeugen, dass die Änderung funktioniert, oder wo er weiß, dass er eine Abkürzung genommen hat. Also bleibt dir eine von zwei Möglichkeiten: kurz überfliegen und freigeben oder die gesamte Änderung von Grund auf neu nachvollziehen. Ersteres ist der Weg, auf dem schlechter Code in Produktion landet. Letzteres bedeutet, dass der Agent dir gar nichts gespart hat.
KI-generierten Code gut zu reviewen ist eine andere Aufgabe als das Review des PR eines Kollegen, denn der Autor kann nicht neben dir sitzen und seine Überlegungen erklären. Die Lösung: Prüfe den Diff zusammen mit seiner Evidence – dem Ziel, den durchgeführten Checks und den Grenzen, die der Agent selbst schon benannt hat. Genau darum ist Sharkly herum gebaut. Sharkly liegt über deinen Coding-Agenten (Claude Code, Codex, Gemini und wie sie alle heißen) und hält Ziel, Änderung, Verifikationsergebnisse und das menschliche Review jedes Runs in einem einzigen Task zusammen, statt sie über Terminals und PR-Beschreibungen zu verstreuen.
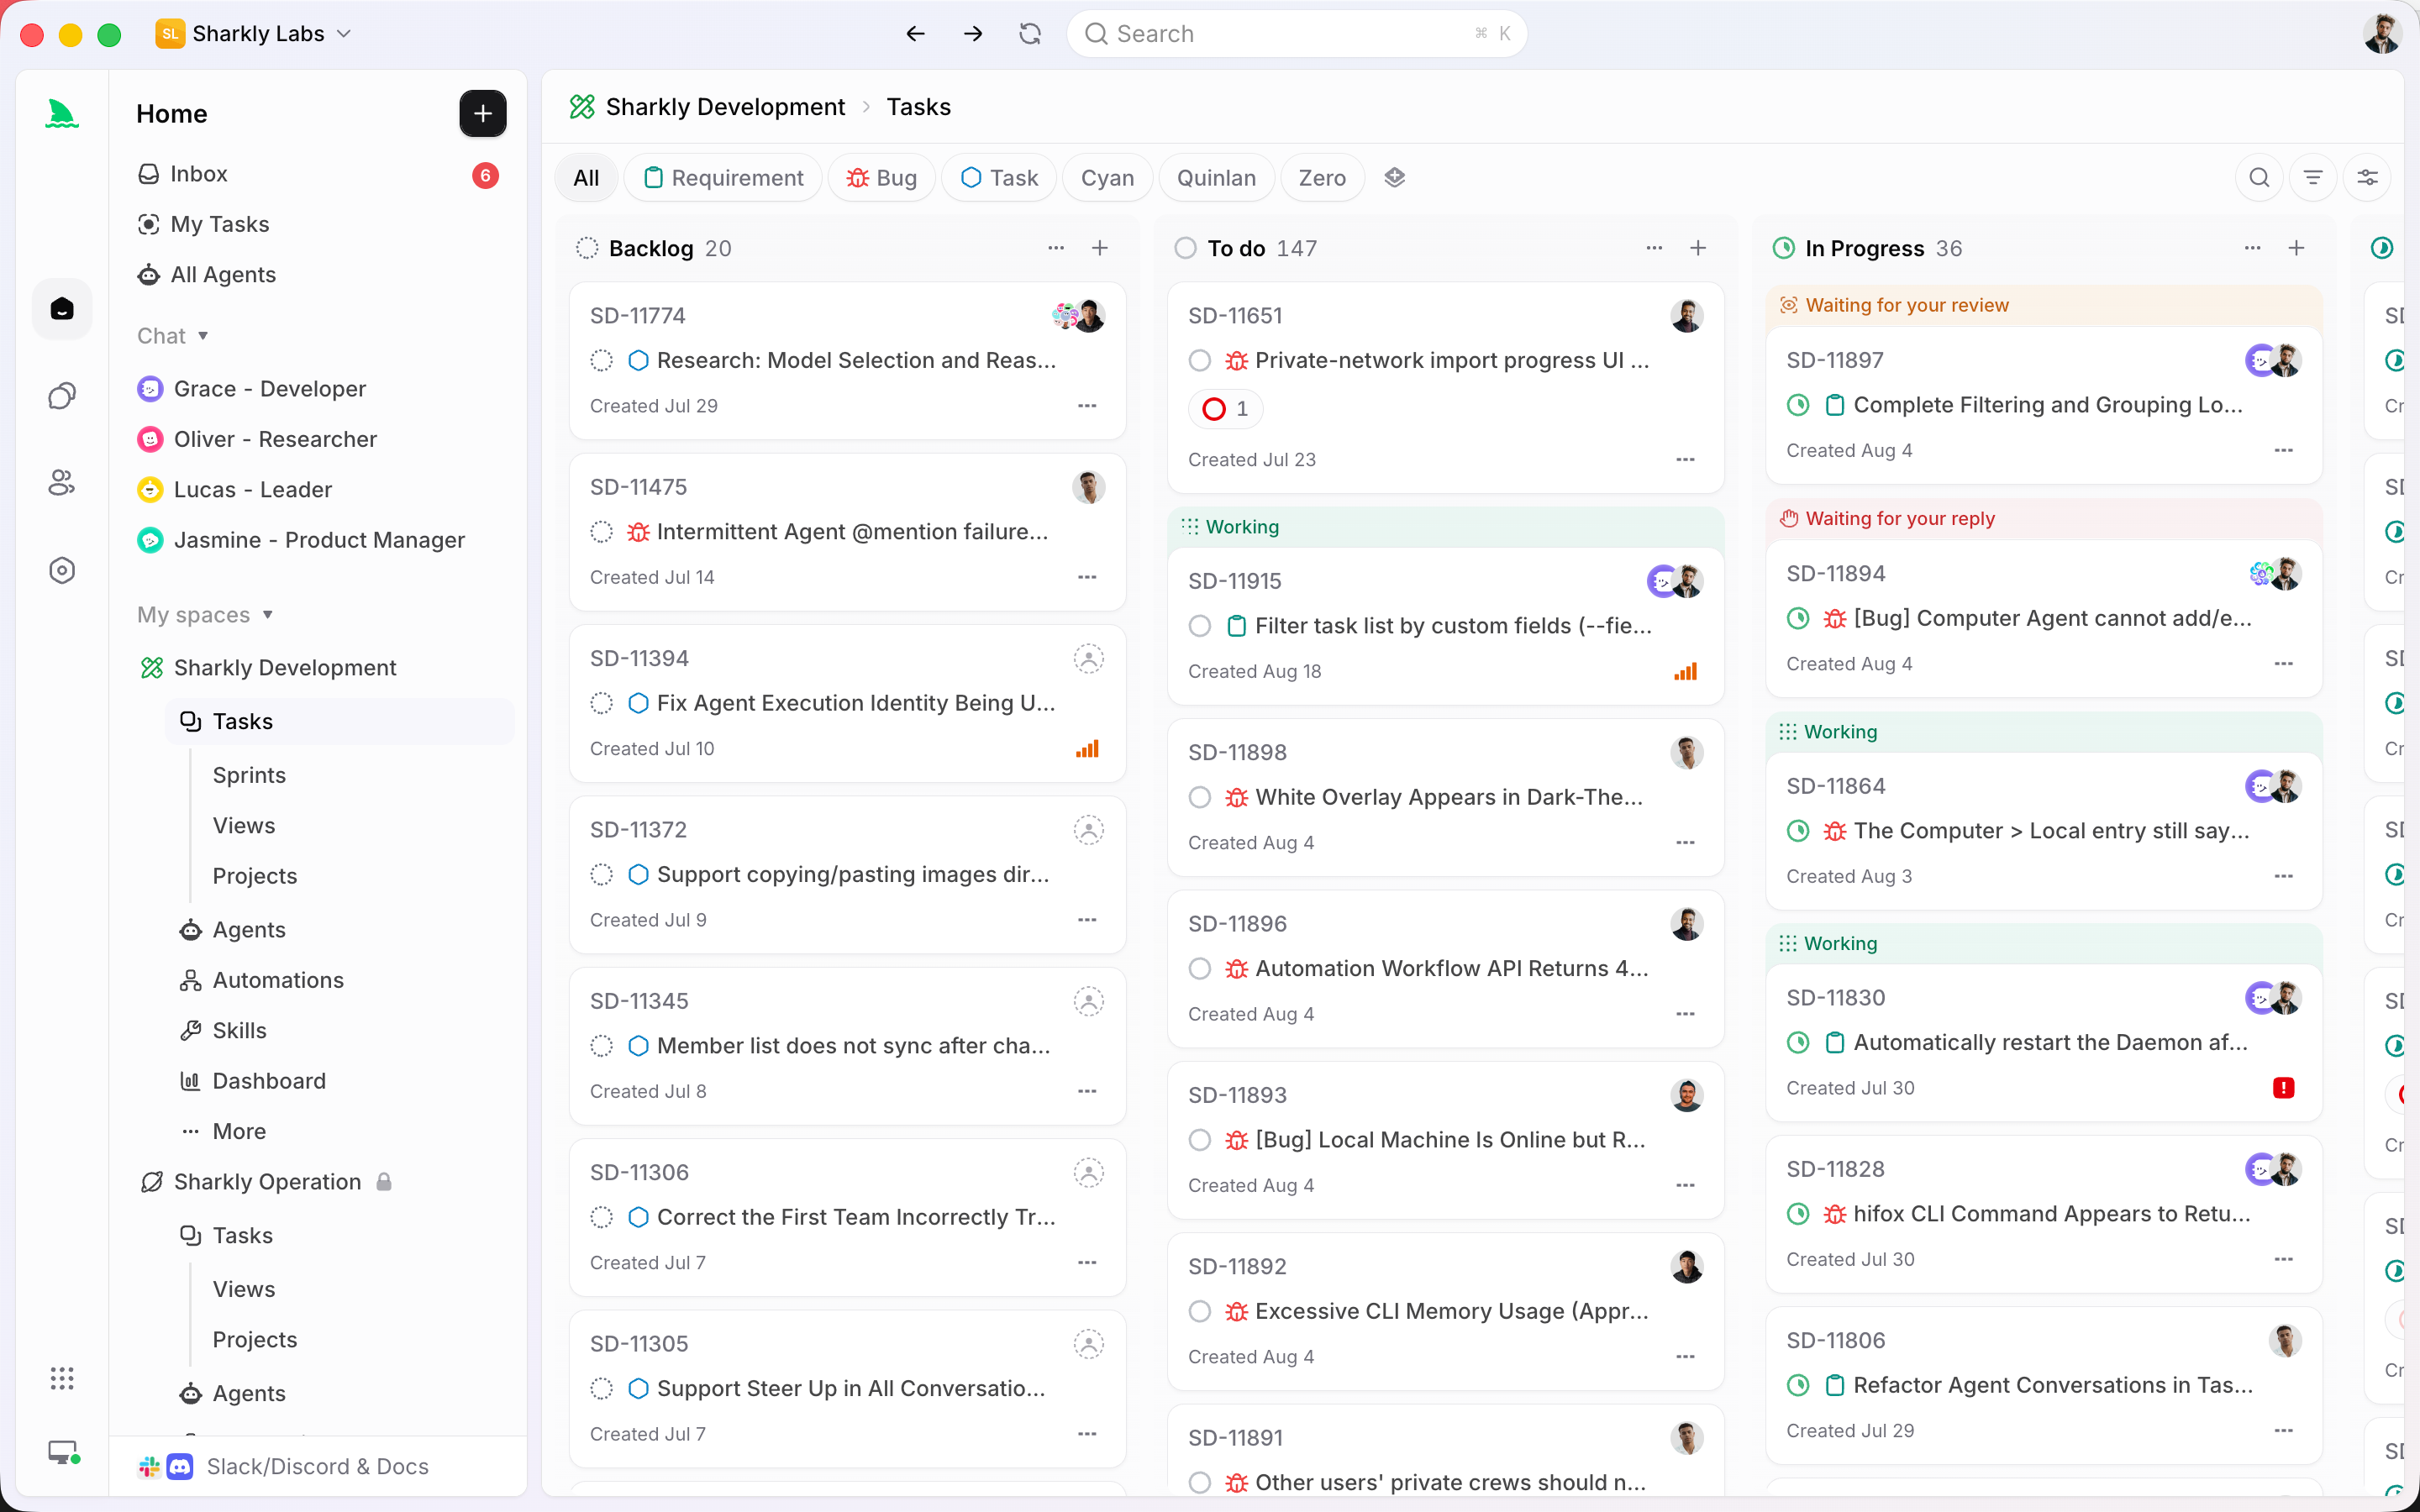
Dieser Leitfaden beschreibt das Betriebsmodell dahinter: wer Arbeit zuweist, wer sie ausführt, wer sie prüft, wer sie abnimmt, welche Status und Gates die Aufgabe eines Agenten von der eines Menschen trennen – und ein durchgerechnetes Beispiel vom Ticket bis zum gemergten PR.
Kurz gesagt
Reviewe KI-generierten Code auf Task-Ebene, nicht auf Diff-Ebene. Lass den Agenten eine Änderungszusammenfassung, die Ergebnisse von Typecheck/Tests/Build und alle bekannten Grenzen an einen gemeinsamen Task anhängen, und verschiebe diesen Task anschließend in einen Review-Status. Ein Mensch liest die Evidence parallel zum Diff, fordert Änderungen an oder akzeptiert und trifft die Merge-Entscheidung. Agenten produzieren und verifizieren; Menschen nehmen ab.
Warum das alleinige Review des Diffs scheitert
Code zu lesen ist schwerer, als ihn zu schreiben. Eine gut dokumentierte Tatsache beim Code-Review ist, dass der Reviewer weniger Kontext hat als der Autor – und wenn der Autor ein Agent ist, ist diese Lücke total. Ein GitHub-Diff zeigt dir das Ziel, nie den Weg. Du siehst nicht, dass der Agent zuerst eine Caching-Schicht ausprobiert hat, in eine Race Condition gelaufen ist und sie wieder zurückgebaut hat. Du siehst auch nicht, dass er die Testsuite ausgeführt hat und ein flaky Test fehlgeschlagen ist, der nichts mit der Änderung zu tun hat.
Ohne diesen Kontext zerfällt das Review in zwei Fehlermodi. Beim bloßen Abnicken gibst du plausibel aussehenden Code frei, der still einen Edge Case bricht, den der Agent nie bedacht hat. Beim vollständigen Nachvollziehen rekonstruierst du die Überlegungen selbst – und damit ist der Geschwindigkeitsvorteil des Agenten dahin. Keines von beidem skaliert, wenn drei Agenten gleichzeitig PRs aufmachen. Der Ausweg: Mach die Arbeit des Agenten reviewbar, nicht nur sein Ergebnis.
Was Evidence auf Task-Ebene wirklich bedeutet
Evidence auf Task-Ebene ist der Datensatz, den ein Agent an seinen Task anhängt: das Ziel, von dem er ausgegangen ist, die Änderung, die er erzeugt hat, die Checks, die er ausgeführt hat, und die Grenzen, die ihm bekannt sind. Statt eines nackten Diffs bekommst du einen Diff mit Herkunftsnachweis.
In der Praxis besteht das Evidence-Paket aus vier Teilen:
- Das Ziel und die Abnahmekriterien, in der Task-Beschreibung, damit das Review an dem gemessen wird, was gefordert war, und nicht daran, was plausibel aussieht.
- Die Änderungszusammenfassung in den eigenen Worten des Agenten: was er angefasst hat und warum.
- Verifikationsergebnisse: die Ausgabe von Typecheck, Tests und Build, die der Agent vor der Übergabe ausgeführt hat.
- Bekannte Grenzen: die Edge Cases, Annahmen und Follow-ups, die der Agent offengelegt hat, statt sie zu verstecken.
All das landet wieder im Task. Ausführung, Blocker, Ergebnisse und die anschließende Diskussion liegen auf einer einzigen Timeline. Der Reviewer öffnet also einen einzelnen Datensatz, statt sich einen PR, einen Slack-Thread und einen halb vergessenen Prompt zusammenzureimen. Das ist die Disziplin hinter einem nachvollziehbaren Workflow von den Anforderungen bis zum Code: Die Evidence ist Teil des Deliverables.
Das Betriebsmodell: Wer zuweist, wer ausführt, wer prüft, wer abnimmt
Gutes Review braucht klare Rollen. Der Vertrag ist kurz: Agenten recherchieren, führen aus, testen und berichten; Menschen geben die Richtung vor, erteilen die Freigabe und nehmen das Ergebnis ab. Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist.
| Rolle | Wer | Aufgabe |
|---|---|---|
| Assigner | Eine Person (in der Regel der Task Owner) | Beschreibt den Bedarf, legt Abnahmekriterien fest, weist den Task zu |
| Runner | Ein Agent, auf einem verbundenen Computer, über eine Runtime | Übernimmt den Task, führt ihn in einem isolierten Worktree aus, hängt die Evidence an |
| Reviewer | Eine Person | Liest den Diff gegen die Evidence, fordert Änderungen an oder gibt frei |
| Accepter | Eine Person (der Owner oder eine designierte freigebende Person) | Trifft die endgültige Abnahme- und Merge-/Release-Entscheidung |
Sharkly ersetzt nicht Claude Code, Codex oder andere Ausführungstools. Es ergänzt die Tools, die dein Team ohnehin nutzt, um eine gemeinsame Ebene aus Task, Computer, Kontext und Review. Die Runtime schreibt den Code; Sharkly entscheidet, in wessen Queue das Review landet und welche Evidence vorliegen muss, bevor ein Mensch einen Blick darauf wirft. Wenn du die ausführlichere Version der Zuweisungsseite willst, lies wer Agentenarbeit zuweist und wer sie abnimmt.
Status und Review-Gates: Agenten verschieben nach Ready for review, Menschen nach Done
Das Review-Gate ist eine Statusgrenze. In Sharkly gehört jeder Task-Status zu einer festen Kategorie mit Systembedeutung: Backlog (geparkt), Unstarted (bereit, nicht begonnen), Started (in Arbeit) und Completed (abschließend). Mehrere sichtbare Status können sich eine Kategorie teilen, sodass der Workflow eines Task-Typs Development und Ready for review als zwei unterschiedliche Started-Status führen kann, bevor irgendetwas Completed erreicht.
Erst diese Struktur macht das Gate real. Ein Agent kann einen Task von Development nach Ready for review bringen und ihn dort auf das menschliche Review warten lassen. In einen Completed-Status darf er den Task nicht selbst verschieben. Die Abnahme ist per Design ein menschlicher Übergang.
| Status | Kategorie | Wer verschiebt ihn hierhin |
|---|---|---|
| Backlog | Backlog | Person, wenn Arbeit geparkt wird |
| Todo | Unstarted | Person, wenn der Task bereit ist |
| Development | Started | Agent, wenn er den Task übernimmt und bearbeitet |
| Ready for review | Started | Agent, sobald die Evidence angehängt ist |
| Done | Completed | Person, nach der Abnahme |
Konfiguriere den Workflow so, dass der Übergang in deinen Completed-Status einen Menschen erfordert – und du hast ein Review-Gate, das auch dann hält, wenn Agenten schneller produzieren, als du hinterhersehen kannst. Das ist die mechanische Variante, einen Menschen bei Coding-Agenten im Loop zu halten, und hier entscheidest du, wo du Agenten vor dem Merge stoppst.
Ein durchgerechnetes Beispiel: vom Ticket zum gemergten PR
Nehmen wir SH-312: „Rate Limiting für den öffentlichen Search-Endpoint, 60 Requests pro Minute pro API Key.“
- Eine Person legt SH-312 mit diesem Ziel und zwei Abnahmekriterien an: Requests über dem Limit liefern HTTP 429 zurück, und das Limit gilt pro Key, nicht pro IP. Der Task startet in Todo.
- Ein Agent übernimmt ihn, verschiebt ihn nach Development und läuft in einem isolierten Worktree, damit sein Checkout nie mit anderen Agenten kollidiert, die am selben Repo arbeiten. (Worktrees sind der Grund, warum parallele Runs sauber bleiben; siehe ein Checkout pro Task.)
- Der Agent implementiert einen Token-Bucket-Limiter, öffnet einen PR und hängt seine Evidence an SH-312: eine Änderungszusammenfassung, den bestandenen Typecheck und die bestandenen Unit-Tests, das Build-Ergebnis und eine bekannte Grenze: „Der Bucket liegt im Prozessspeicher, daher werden Limits bei jedem Deploy zurückgesetzt und sind nicht über Instanzen hinweg geteilt.“
- Der Agent verschiebt SH-312 nach Ready for review. Der Task landet mit Diff und Evidence gemeinsam in der Queue eines Menschen.
- Der Reviewer liest zuerst den Hinweis zur bekannten Grenze, entscheidet, dass der In-Memory-Bucket vorerst in Ordnung ist, und fordert eine Änderung an: den
Retry-After-Header bei einer 429-Antwort zurückgeben. Der Agent setzt die Änderung um und hängt die aktualisierte Testausgabe erneut an. - Der Reviewer nimmt ab, merged den PR und verschiebt SH-312 nach Done – mit einem bereits verlinkten Follow-up-Ticket für einen geteilten Limiter.
Das Review dauerte Minuten, weil der Reviewer die Änderung nie rekonstruieren musste; diese Arbeit hat die Evidence übernommen. Es ist derselbe Loop wie beim Claude-Code-Projektmanagement vom Issue bis zum Review, nur dass das Evidence-Paket das Review schnell macht statt zum Flaschenhals.
Wie du die Evidence schnell prüfst – und wann du es locker angehen lässt
Nicht jede Änderung braucht die volle Behandlung. Nutze eine Entscheidungsregel.
Fahre schwer auf, wenn die Änderung Auth, Billing, Datenmigrationen, öffentliche APIs oder irgendetwas betrifft, das sich schwer rückgängig machen lässt: Lies den Diff Zeile für Zeile, führe die Tests selbst erneut aus und prüfe die bekannten Grenzen gegen deine eigenen Edge Cases. Bleib locker, wenn die Änderung ein Textfeinschliff, ein gut getestetes internes Refactoring oder ein Dependency-Bump mit grünen Checks ist: Zusammenfassung lesen, Diff überfliegen, bestätigen, dass die Verifikation durchgelaufen ist, und abnehmen.
Eine schnelle Checkliste für das intensive Review:
- Erfüllt der Diff jedes Abnahmekriterium – nicht nur den Happy Path?
- Hat der Agent die Checks tatsächlich ausgeführt oder behauptet er es nur? Prüfe die angehängte Ausgabe.
- Lies den Hinweis zu den bekannten Grenzen. Ist eine dieser Grenzen eher ein Blocker als ein Follow-up?
- Bleibt die Änderung im Rahmen des Auftrags, oder hat der Agent unzusammenhängende Dateien angefasst?
Wenn du bereits mehrere Coding-Agenten laufen lässt, ist das der Workflow, den Sharkly dir an einer Stelle zu verwalten gibt: Task zuweisen, den Agenten Evidence anhängen lassen, am Gate reviewen. Du kannst die Einzelteile auch selbst mit Worktrees, PR-Templates und einem Status-Board zusammenbauen – oder Sharkly herunterladen und Task, Evidence und Gate als ein System bekommen.
FAQ
Was ist Evidence auf Task-Ebene bei KI-generiertem Code? Es ist der Datensatz, den ein Agent zusammen mit dem Diff an seinen Task anhängt: das Ziel, eine Änderungszusammenfassung, die Ergebnisse von Typecheck/Tests/Build, die er ausgeführt hat, und alle bekannten Grenzen. Dieses Paket zu reviewen ist schneller und sicherer, als nur einen Diff zu reviewen.
Kann ein KI-Agent seinen eigenen Code freigeben? Nein – und genau darum geht es bei einem Review-Gate. Ein Agent kann einen Task nach Ready for review verschieben, aber der Übergang in einen Completed-Status ist eine menschliche Entscheidung. Agenten produzieren und verifizieren; Menschen nehmen ab.
Wie reviewe ich KI-Code schneller, ohne ihn nur abzunicken? Passe den Aufwand dem Risiko an. Lies die Evidence bei jeder Änderung, aber reserviere zeilenweises Review und das erneute Ausführen von Tests für Risikobereiche wie Auth und Migrationen. Sieh dir an, wie die Review-Kapazität skaliert, wenn Agenten die Menschen überholen.
Nutze ich noch Pull Requests? Ja. Agenten öffnen echte Pull Requests auf GitHub; die Task-Ebene ergänzt die Evidence und das Gate darum herum, damit der PR nicht der einzige Ort ist, an dem Kontext lebt.


