
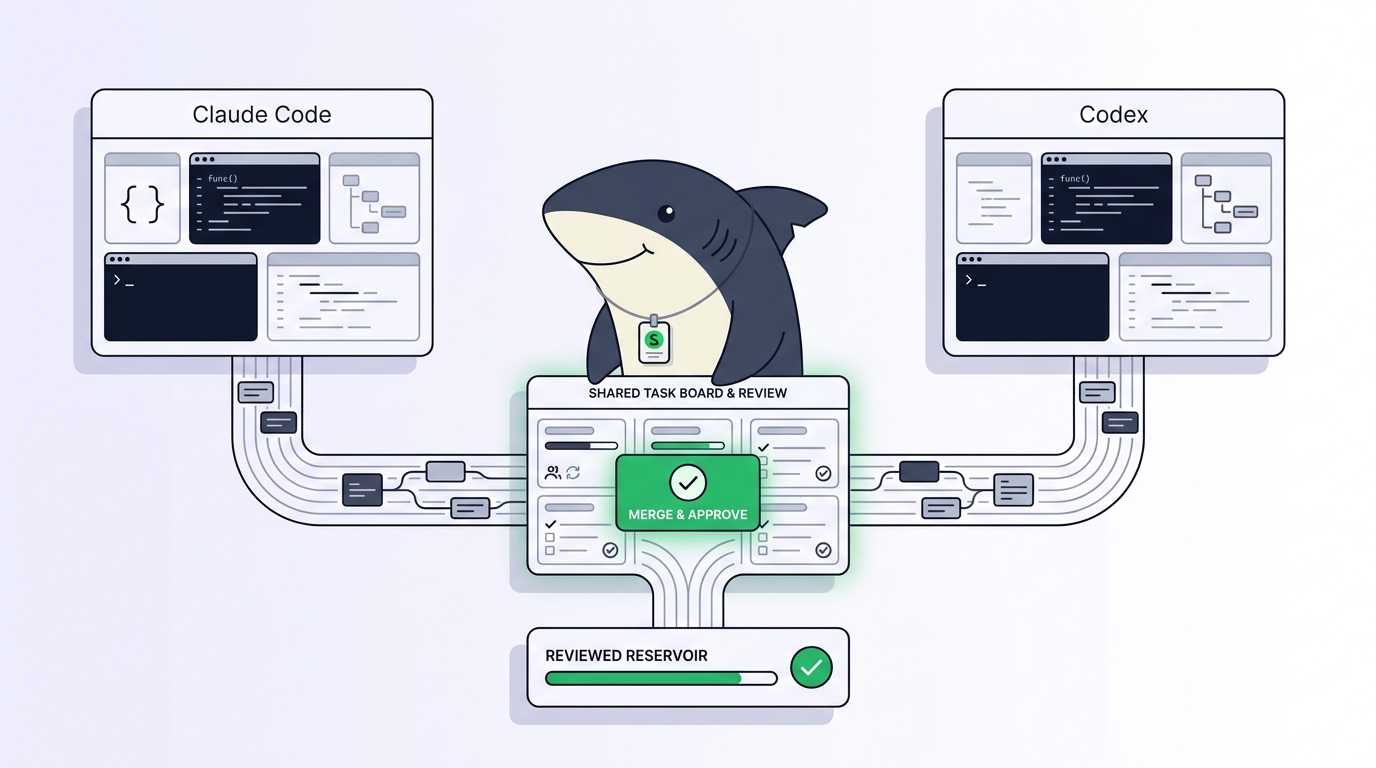
Claude Code ist stark darin, eine große Codebasis zu lesen und einen Plan über viele Dateien hinweg zu halten. Codex ist stark bei eng abgegrenzten, testgetriebenen Änderungen. Viele Entwicklerinnen und Entwickler möchten irgendwann beides im selben Repository einsetzen: das eine Werkzeug entwirft ein Refactoring, während das andere eine flaky Testsuite stabilisiert. In dem Moment, in dem man es versucht, wird genau das Arbeitsverzeichnis zum Problem. Zwei verschiedene Tools, zwei verschiedene CLIs, ein Ordner, in den beide schreiben.
Diese Anleitung führt dich Schritt für Schritt durch das Setup, benennt bei jedem Schritt den Failure-Mode und zeigt, wo zwei Terminals an ihre Grenzen stoßen. Die Isolationshälfte ist mit git worktrees ein gelöstes Problem. Die Koordinationshälfte – zu wissen, welches Tool an was arbeitet, und jede Änderung reviewbar zu halten – ist der Punkt, an dem eine runtime-neutrale Ebene wie Sharkly übernimmt.
Sharkly ist kein Ersatz für Claude Code oder Codex. Es ergänzt die gemeinsame Task-, Computer-, Kontext- und Review-Ebene um die Ausführungstools, die du ohnehin nutzt, sodass aus einer Claude-Code-Session und einer Codex-Session zwei Aufgaben in einem Workflow werden statt zwei Terminals, die du ständig im Blick behalten musst.
Warum du Claude Code und Codex im selben Repo laufen lassen würdest
Drei Gründe tauchen immer wieder auf, und sie sind nicht dasselbe Problem.
Unterschiedliche Stärken bei unterschiedlichen Aufgaben. Die Arbeit mit großem Kontext (diesen Bug über das Modul hinweg nachvollziehen, diese Migration planen) delegierst du an einen Agenten, die eng abgegrenzte, überprüfbare Arbeit (diesen Test zum Laufen bringen, diese Funktion straffen) an den anderen. Das Tool zur Aufgabe passend zu wählen, ist ein eigenes Thema; siehe welches Modell für welche Coding-Aufgabe.
Ein direkter Vergleich an echter Arbeit. Der einzige ehrliche Benchmark ist deine Codebasis, nicht ein Leaderboard. Beide auf dasselbe Ticket anzusetzen und die Diffs zu vergleichen, sagt dir mehr als jede veröffentlichte Punktzahl. Die Methode beschreiben wir in wie man Coding-Agents auf der eigenen Codebasis vergleicht.
Du bezahlst ohnehin schon für beides. Viele Teams haben bereits ein Claude-Abo und einen Codex- oder API-Seat. Provider-Neutralität ist der Punkt: Dein Workflow sollte überleben, egal welches Tool das nächste beste Modell ausliefert, ohne dass du alles neu aufbauen musst.
Was auch immer der Grund ist, das Scheitern ist identisch. Zwei Agenten in einem Ordner sind zwei Schreibende, die ein Dokument ohne Sperre bearbeiten. Der eine wechselt den Branch unter dem anderen weg oder formatiert eine Datei mitten in der Bearbeitung um, und du bekommst halb angewendete Diffs, die keinen Sinn ergeben.
Schritt 1: Gib jedem Agenten seinen eigenen Worktree
Der git worktree behebt die Kollision an der Wurzel. Ein Repository kann mehrere Arbeitsverzeichnisse gleichzeitig ausgecheckt haben, jedes auf seinem eigenen Branch, die sich eine einzige .git-Datenbank teilen. Statt eines Ordners, um den beide Tools kämpfen, bekommst du einen pro Aufgabe.
# One checkout per task, each on its own branch
git worktree add ../app-refactor -b agent/refactor
git worktree add ../app-tests    -b agent/tests

git worktree list
Richte ein anderes Tool auf jedes Verzeichnis:
cd ../app-refactor && claude          # Claude Code on the refactor
cd ../app-tests    && codex           # Codex on the test suite
Failure-Mode, wenn du das überspringst: Beide Tools führen cd in dasselbe Repo aus, konkurrieren um dieselben Dateien, und eines überschreibt still und heimlich die nicht committete Arbeit des anderen. Worktrees machen das physisch unmöglich. Das anschließende Aufräumen hat seine eigenen Fallstricke; Worktrees ohne den Aufräum-Schmerz verwalten behandelt git worktree remove und das Problem mit veralteten Branches.
Schritt 2: Weise jedem Tool die richtigen Anweisungen zu
Claude Code und Codex lesen unterschiedliche Projektdateien. Claude Code sucht nach CLAUDE.md; Codex liest AGENTS.md. Wenn dein Repo nur eine davon enthält, arbeitet ein Agent blind gegenüber deinen Konventionen.
Behalte beide und halte sie konsistent. Das zuverlässige Muster besteht darin, die geteilten Regeln einmal zu schreiben und beide Einstiegspunkte darauf verweisen zu lassen:
<!-- CLAUDE.md and AGENTS.md both start with -->
See ./docs/agent-conventions.md for build, test, and style rules.
# Verify each tool actually loads its file before you turn it loose
claude --version   # Claude Code reads CLAUDE.md from the worktree root
codex --version    # Codex reads AGENTS.md from the worktree root
Failure-Mode, wenn du das überspringst: Codex folgt der einen Lint-Konfiguration, während Claude Code einer anderen folgt, und jeder Merge wird zum Stil-Kampf, den niemand je schriftlich festgehalten hat. Eine persönliche Anmerkung ist hier wichtig: Ein Install-Token transportiert deine Konventionen nicht, und eine per .gitignore ignorierte lokale Datei wandert nicht in den Worktree. Lege geteilte Regeln in getrackten Dateien ab, sonst startet jeder neue Worktree leer.
Schritt 3: Starten und dann zusehen, wie die Koordinationslücke aufgeht
Mit zwei Worktrees und zwei Konfigurationsdateien funktioniert die Mechanik. Du hast Claude Code auf dem einen Branch und Codex auf einem anderen, keiner berührt die Dateien des anderen. Für einen Nachmittag mit zwei Agenten hält das.
Die Lücke öffnet sich, wenn du von der Tastatur aufschaust. Jede Session führt ihre eigene Historie in ihrem eigenen Tab, unsichtbar für die andere. Wenn der Codex-Lauf wissen muss, was der Claude-Code-Lauf bereits geändert hat, gibt es keinen gemeinsamen Speicher, den man konsultieren könnte – also wirst du zur Integrationsschicht. Agenten werden zu unterschiedlichen Zeiten fertig und warten still auf Eingaben, sodass „beide parallel laufen lassen" still und leise zu „jeden nacheinander prüfen" verkommt.
Skaliere das über zwei hinaus. Der natürliche nächste Schritt ist ein Wrapper-Skript, das Worktrees hochzieht, das richtige Tool in jedem startet und die Ausgabe in benannte tmux-Panes leitet. Für eine Handvoll Läufe hilft das. Dann wächst es: Branch-Benennung, Aufräumen, eine Möglichkeit zu erkennen, welches Tool an welcher Aufgabe arbeitet, Retries für das, was abgestürzt ist. Bevor du dich versiehst, pflegst du ein sprödes Orchestrierungs-Framework, das mit Bash zusammengehalten wird, bei dem die eine Hälfte des Zustands in der Shell-Historie lebt und die andere in deinem Kopf. Viele gleichzeitig laufen zu lassen, stößt an dieselbe Wand, egal ob alle Agenten Claude Code sind, wie in mehrere Claude-Code-Agenten laufen lassen, oder eine Mischung.
Wo zwei Terminals nicht mehr skalieren
Der ehrliche Test, ob du dem DIY-Setup entwachsen bist:
- Kann ein Teammitglied sehen, was deine Agenten gerade tun, ohne dass du ihm dein Terminal vorliest?
- Wenn Codex um 14 Uhr fertig wird und eine Eingabe braucht – sagt dir das irgendetwas?
- Wenn beide Agenten gleichzeitig fertig werden, gibt es eine Warteschlange zum Reviewen ihrer Arbeit, oder nur dich und zwei Branches?
Wenn die Antworten Nein lauten, ist das fehlende Teil nicht noch ein Shell-Skript. Es ist eine Ebene, die Arbeit dem einen oder anderen Tool zuweist, den Live-Status anzeigt und jede Änderung reviewbar hält, bevor sie gemergt wird. Das ist es, was ein Task-Board gegenüber rohen Terminals hinzufügt.
Das ist die Grenze, die man klar benennen sollte. Claude Code und Codex übernehmen die Ausführung. Eine Kommandoebene verwaltet Zuweisung, verbundene Computer, Aufgabenkontext, Fortschritt, Blocker, Ergebnisse und menschliches Review über beide hinweg. In Sharkly weist du eine Task einer Claude-Code-Runtime und eine andere einer Codex-Runtime zu; jede läuft in ihrem eigenen isolierten Worktree auf einem verbundenen Computer, und Ausführung, Blocker und Ergebnisse kehren zur Task-Timeline zurück, statt in privaten Terminals zu verschwinden.
Die Arbeitsteilung bleibt sauber. Agenten recherchieren, führen aus, testen und berichten. Menschen setzen die Richtung, erteilen die Befugnis und nehmen das Ergebnis ab. Die Automatisierung endet dort, wo dein Urteilsvermögen gefragt ist, und übergibt einen Diff mit den angehängten Verifikationsnachweisen. Du behältst die Tools, für die du ohnehin bezahlst, die Modellnutzung läuft weiterhin über die in jedem konfigurierten Abos und API-Keys, und du bekommst einen Ort, an dem du siehst, wer an was arbeitet.
Nutze das manuelle Setup, wenn du ein oder zwei Agenten für einen Nachmittag laufen lässt und den Zustand im Kopf behalten kannst. Greife zu einer gemeinsamen Ebene, wenn eine zweite Person Sichtbarkeit braucht, wenn die Anzahl über das hinaussteigt, was ein Terminalfenster anzeigt, oder wenn du Tools oft genug vergleichst, dass „welcher Lauf diesen Branch erzeugt hat" nicht mehr offensichtlich ist.
Eine Checkliste, die du heute durchgehen kannst
Geh das von oben nach unten durch, wenn du das nächste Mal beide Tools auf ein Repo ansetzt:
- [ ] Erstelle einen
git worktreepro Aufgabe, jeder auf seinem eigenen Branch. Richte niemals zwei Tools auf dasselbe Verzeichnis. - [ ] Committe sowohl
CLAUDE.mdals auchAGENTS.md, die jeweils auf eine gemeinsame Konventionsdatei im getrackten Quellcode verweisen. - [ ] Bestätige, dass jedes Tool seine Konfiguration aus der Worktree-Wurzel lädt, bevor du Arbeit zuweist.
- [ ] Weise jedem Agenten eine abgegrenzte Task zu. Arbeit mit großem Kontext an den einen, eng abgegrenzte testgetriebene Arbeit an den anderen.
- [ ] Lege dein Review-Gate im Voraus fest: Kein Branch wird gemergt, bis eine Person den Diff und die Testergebnisse gelesen hat.
- [ ] Wenn du zwei oder drei gleichzeitige Läufe überschreitest, hör auf, das Bash zu skalieren, und verlagere Zuweisung, Status und Review in eine Ebene.
Wenn du beides weiterhin nutzen möchtest – Claude Code und Codex –, statt dich auf ein Ökosystem festzulegen, ist das genau das Problem, für das Sharkly entwickelt wurde. Lade Sharkly herunter, verbinde einen Computer und weise deine erste Task dem Agenten zu, der zur Arbeit passt.
FAQ
Können Claude Code und Codex gefahrlos dieselben Dateien bearbeiten? Nicht im selben Verzeichnis. Gib jedem seinen eigenen git worktree, damit sie auf getrennten Branches arbeiten, und merge dann über das Review. Nebenläufigkeit im selben Verzeichnis ist der Punkt, an dem nicht committete Arbeit verloren geht.
Brauche ich zwei Abos? Du brauchst, was auch immer jedes Tool erfordert. Die Modellnutzung läuft weiterhin über die in Claude Code und Codex konfigurierten Abos oder API-Keys; eine Koordinationsebene ändert diesen Zugang nicht und verkauft ihn nicht weiter.
Ist ein Task-Board für zwei Agenten überdimensioniert? Für zwei Agenten, die du in einer Sitzung kontrollierst, reichen einfache Worktrees und zwei Terminals. Das Board verdient seinen Platz, wenn ein Teammitglied Sichtbarkeit braucht oder die Anzahl der Läufe steigt. Siehe die besten Tools zur Verwaltung paralleler KI-Coding-Agenten.


