
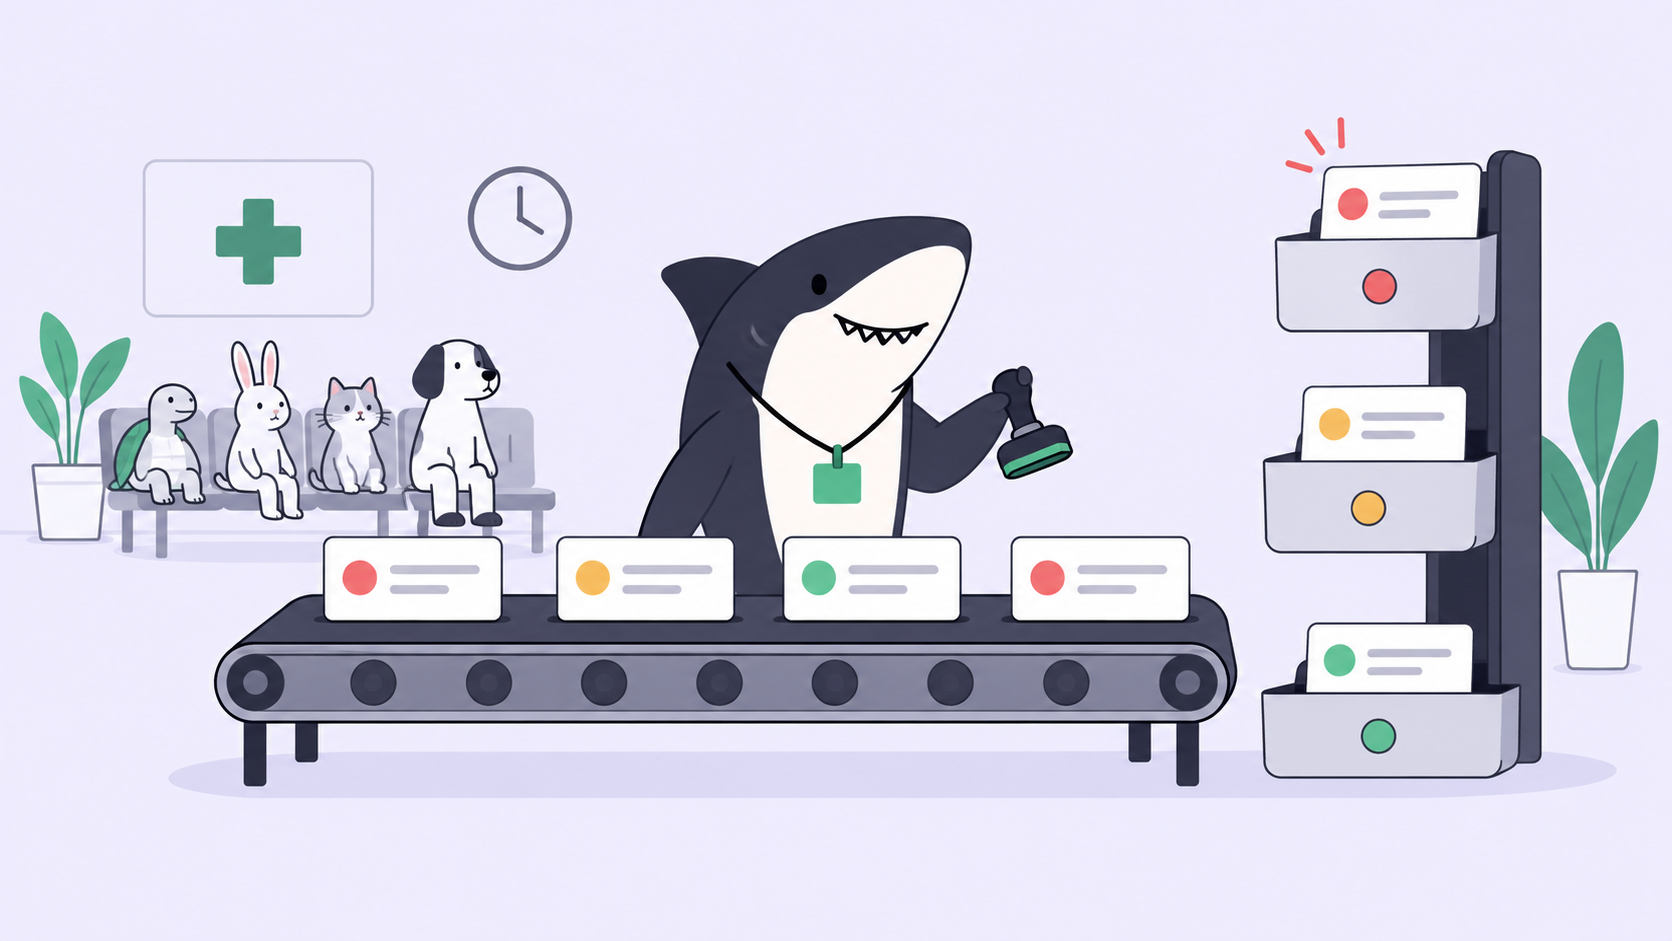
Vier Coding-Agents werden innerhalb derselben Stunde fertig und öffnen vier Pull Requests. Einer betrifft einen Billing-Retry-Pfad, einer benennt einen Test-Helper um, einer fügt eine Migration hinzu, einer korrigiert einen Tippfehler im README. Der Engpass ist weder der Code noch die Tests. Es ist die Frage, die ein Mensch beantwortet, bevor er einen einzigen Diff gelesen hat: Welchen davon schaue ich mir zuerst an? Wir haben bereits dargelegt, dass menschliches Review der Engpass ist, sobald Agents parallel laufen. Dieser Beitrag behandelt den mechanischen Teil dieses Problems – die Reihenfolge in der Warteschlange – und wie ein Entscheidungsmodell wie Jev diese Aufgabe dem Reviewer abnehmen kann, ohne ihm das Review abzunehmen.
Was Jev ist
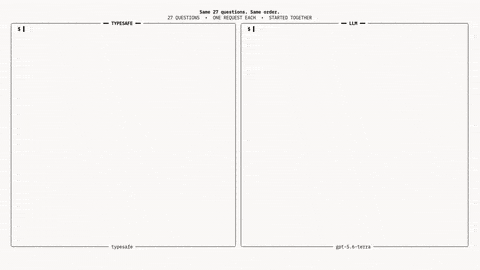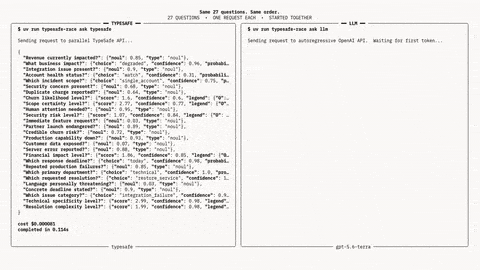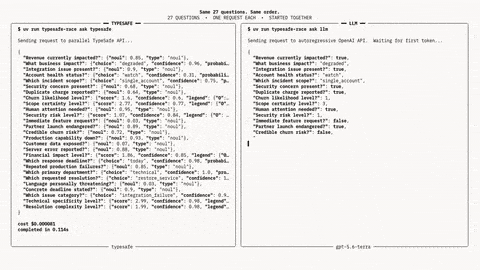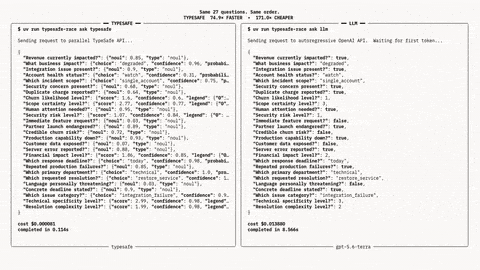
Jev ist ein System-One-Model von TypeSafe AI: Man sendet einen Zustand (State) und eine Reihe typisierter Fragen, und es liefert für jede Frage eine Antwort mit kalibrierter Wahrscheinlichkeit zurück – niemals Freitext. Um den Namen klarzustellen: Gemeint ist Jev, das TypeSafe-Modell, nicht der YouTuber und nicht die Impfung gegen Japanische Enzephalitis. Der Launch-Post von TypeSafe beschreibt es als „unstrukturierter State rein, typisierte probabilistische Entscheidungen raus“. Die API besteht aus einem einzigen Endpoint, POST https://api.typesafe.ai/v1/systemone, Bearer-Key, Modell jev-latest, drei Fragetypen: noul (Ja/Nein-Wahrscheinlichkeit), choice (eine Auswahl aus bis zu 255 Optionen) und score (eine Position auf einer Skala mit 2 bis 10 Stufen). Nur Text, 64k Tokens pro Anfrage, davon 32k für den State, 0,042 $ pro Million Input-Tokens, Output wird nicht berechnet. Unser Schwesterbeitrag zu Jev als Entscheidungsschicht für Coding-Agents behandelt das Modell allgemein; hier setzen wir es für eine einzige Aufgabe ein.
Die drei Review-Fragen
Jeder PR, den ein Coding-Agent öffnet, wirft dieselben drei Fragen auf, und jede davon entspricht einem Primitiv. Der State ist für alle drei derselbe: eine Diff-Zusammenfassung, das Testergebnis und die berührten Pfade. Nicht der vollständige Diff. Eine Zusammenfassung hält den Aufruf im Budget und sorgt dafür, dass das Modell die Routing-Frage beantwortet, statt den Code noch einmal zu prüfen.
Braucht das vor dem Merge einen Menschen? Ein noul. Das ist der Filter. Er entscheidet, ob ein PR überhaupt in die menschliche Warteschlange kommt oder in einer niedrig priorisierten Spur wartet.
Welcher Reviewer oder welche Warteschlange? Ein choice über die Warteschlangen, die euer Team tatsächlich betreibt. Die Antwort enthält die Auswahl plus die vollständige Verteilung – eine Aufteilung von 0,48 / 0,44 zwischen zwei Warteschlangen sagt euch also, dass der PR über eine Zuständigkeitsgrenze hinweg reicht, was für sich genommen schon eine wichtige Information ist.
Wie viel Risiko trägt er? Ein score auf einer geordneten Skala. Das Ergebnis ist eine wahrscheinlichkeitsgewichtete Position, eine Änderung kann also bei 2,6 zwischen „logic change covered by tests“ und „touches auth, billing, or data“ landen. Diese Zahl ist der Sortierschlüssel für die Warteschlange.
Eine einzige Anfrage beantwortet alle drei:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
Die Antwort besteht aus drei typisierten Antworten unter denselben Schlüsseln. Für SH-418 ist ein needs_human nahe 0,9 zu erwarten, queue wählt payments, und risk liegt nahe der Spitze der Skala. Ein Billing-Retry-Fix mit grünen Tests landet trotzdem ganz vorne in der Payments-Warteschlange, denn grüne Tests beantworten nicht die Frage, ob ein Mensch das lesen sollte.
Schwellenwerte und was jedes Band bewirkt
Eine Wahrscheinlichkeit ist erst nützlich, wenn Code daraus eine Aktion macht. Die folgenden Bänder sind ein Ausgangspunkt, keine Empfehlung für euer Repository; justiert sie nach einer Woche mit Läufen.
needs_human |
Aktion |
|---|---|
| 0,85 und darüber | Ganz vorne in der menschlichen Warteschlange, sortiert nach risk absteigend |
| 0,15 bis 0,85 | Menschliche Warteschlange, sortiert nach risk, hinter dem Band darüber |
| unter 0,15 | Niedrig priorisierte Spur; ein Mensch merged trotzdem, nach eigenem Zeitplan |
Zwei Regeln halten das ehrlich. Erstens: Ein risk an der Spitze der Skala hebt einen PR immer ins vordere Band, egal was needs_human sagt. Ein Modell, das sich zu 0,12 sicher ist, dass eine Schema-Migration ein Review braucht, hat eine aufgeräumte Diff-Zusammenfassung gesehen, nicht die Produktion. Zweitens: Ein choice, dessen zwei beste Optionen weniger als 0,1 auseinanderliegen, geht an beide Warteschlangen, nicht an keine. Unklarheit über die Zuständigkeit ist ein Grund, dass zwei Personen einen Blick auf eine Änderung werfen – nicht keiner.
Beachtet, was in jedem Band beim Menschen bleibt: der Merge. Die Bänder ändern die Lesereihenfolge und die Lesetiefe. Sie ändern nie, wer entscheidet.
Jev für die Warteschlange nutzen, nicht für das Urteil
Setzt Jev ein, wenn die Frage einen festen Satz möglicher Antworten hat, der State eine getreue Zusammenfassung ist und ihr die Aufmerksamkeit eines Menschen in einer besseren Reihenfolge einsetzen wollt: Wer liest das, wie bald, in welcher Warteschlange. Diese Fragen tauchen bei jedem PR auf und sind zu diesem Preis günstig genug, um sie bei jedem Lauf zu stellen.
Setzt einen Menschen ein – oder ein Sprachmodell, das seinen Schlussfolgerungsweg offenlegen kann –, wenn die Frage lautet, ob die Änderung korrekt ist. Eine Wahrscheinlichkeit, dass eine Änderung ein Review braucht, ist noch kein Review. Jev hat keinen Compiler, keinen Test-Runner und keinen Zugriff auf die Datei, die es bewertet, sondern nur auf die Zusammenfassung, die ihr gesendet habt. Ein Wert von 0,96 für „safe to merge“ ist ein starkes Argument, diesen PR ganz oben auf die Liste von jemandem zu setzen – nie ein Argument, diesen Jemand zu überspringen. Das Approval-Gate steht hinter dem Modell, und das Modell hat keine Möglichkeit, es zu öffnen.
Was die Community gebaut hat
Wenige Tage nach dem Launch veröffentlichte ein Entwickler jev-review, das sein README als „einen kleinen Code-Review-Workflow, gebaut mit TypeSafe Jev“ beschreibt. Es reviewt entweder einen Git-Diff oder eine ganze Codebasis, prüft auf Korrektheit, Sicherheit, Zuverlässigkeit, Kompatibilität und Testabdeckung, wählt Code-Regionen aus, bevor es deren Impact bewertet, wendet Schwellenwerte und Workflow-Richtlinien im Code an und zeigt die Ergebnisse in einem lokalen Dashboard. Das README ist beim Umfang vorsichtig: Es nennt das Projekt „ein Experiment, schnelle typisierte Urteile zu einem Review-Workflow zusammenzusetzen“ und sagt, es „integriert noch keine Compiler-Diagnosen, statischen Analyzer, Repository-Indizierung oder generierte Erklärungen“.
Zwei Dinge an diesem Design sind nachahmenswert: Die Orchestrierung lebt im Code, und Jev beantwortet nur klar umrissene Fragen; außerdem ist die Arbeit gestaffelt – erst eine Region auswählen, dann bewerten – statt einer riesigen Frage über den gesamten Diff. Jev ist zudem im Vercel AI Gateway als typesafe-ai/jev über experimental_evaluate im AI SDK 7 verfügbar; die Gateway-Dokumentation weist darauf hin, dass dies nur über das AI SDK möglich ist.
Wie das mit Sharkly zusammenpasst
Sharkly ruft Jev nicht für euch auf und ist kein Entscheidungsmodell. Es ist die gemeinsame Task-, Computer-, Kontext- und Review-Schicht um die Coding-Agents, die euer Team ohnehin betreibt. Was eine sortierte Warteschlange von dieser Schicht braucht, ist ein Ort zum Laufen und ein Ort zum Landen.
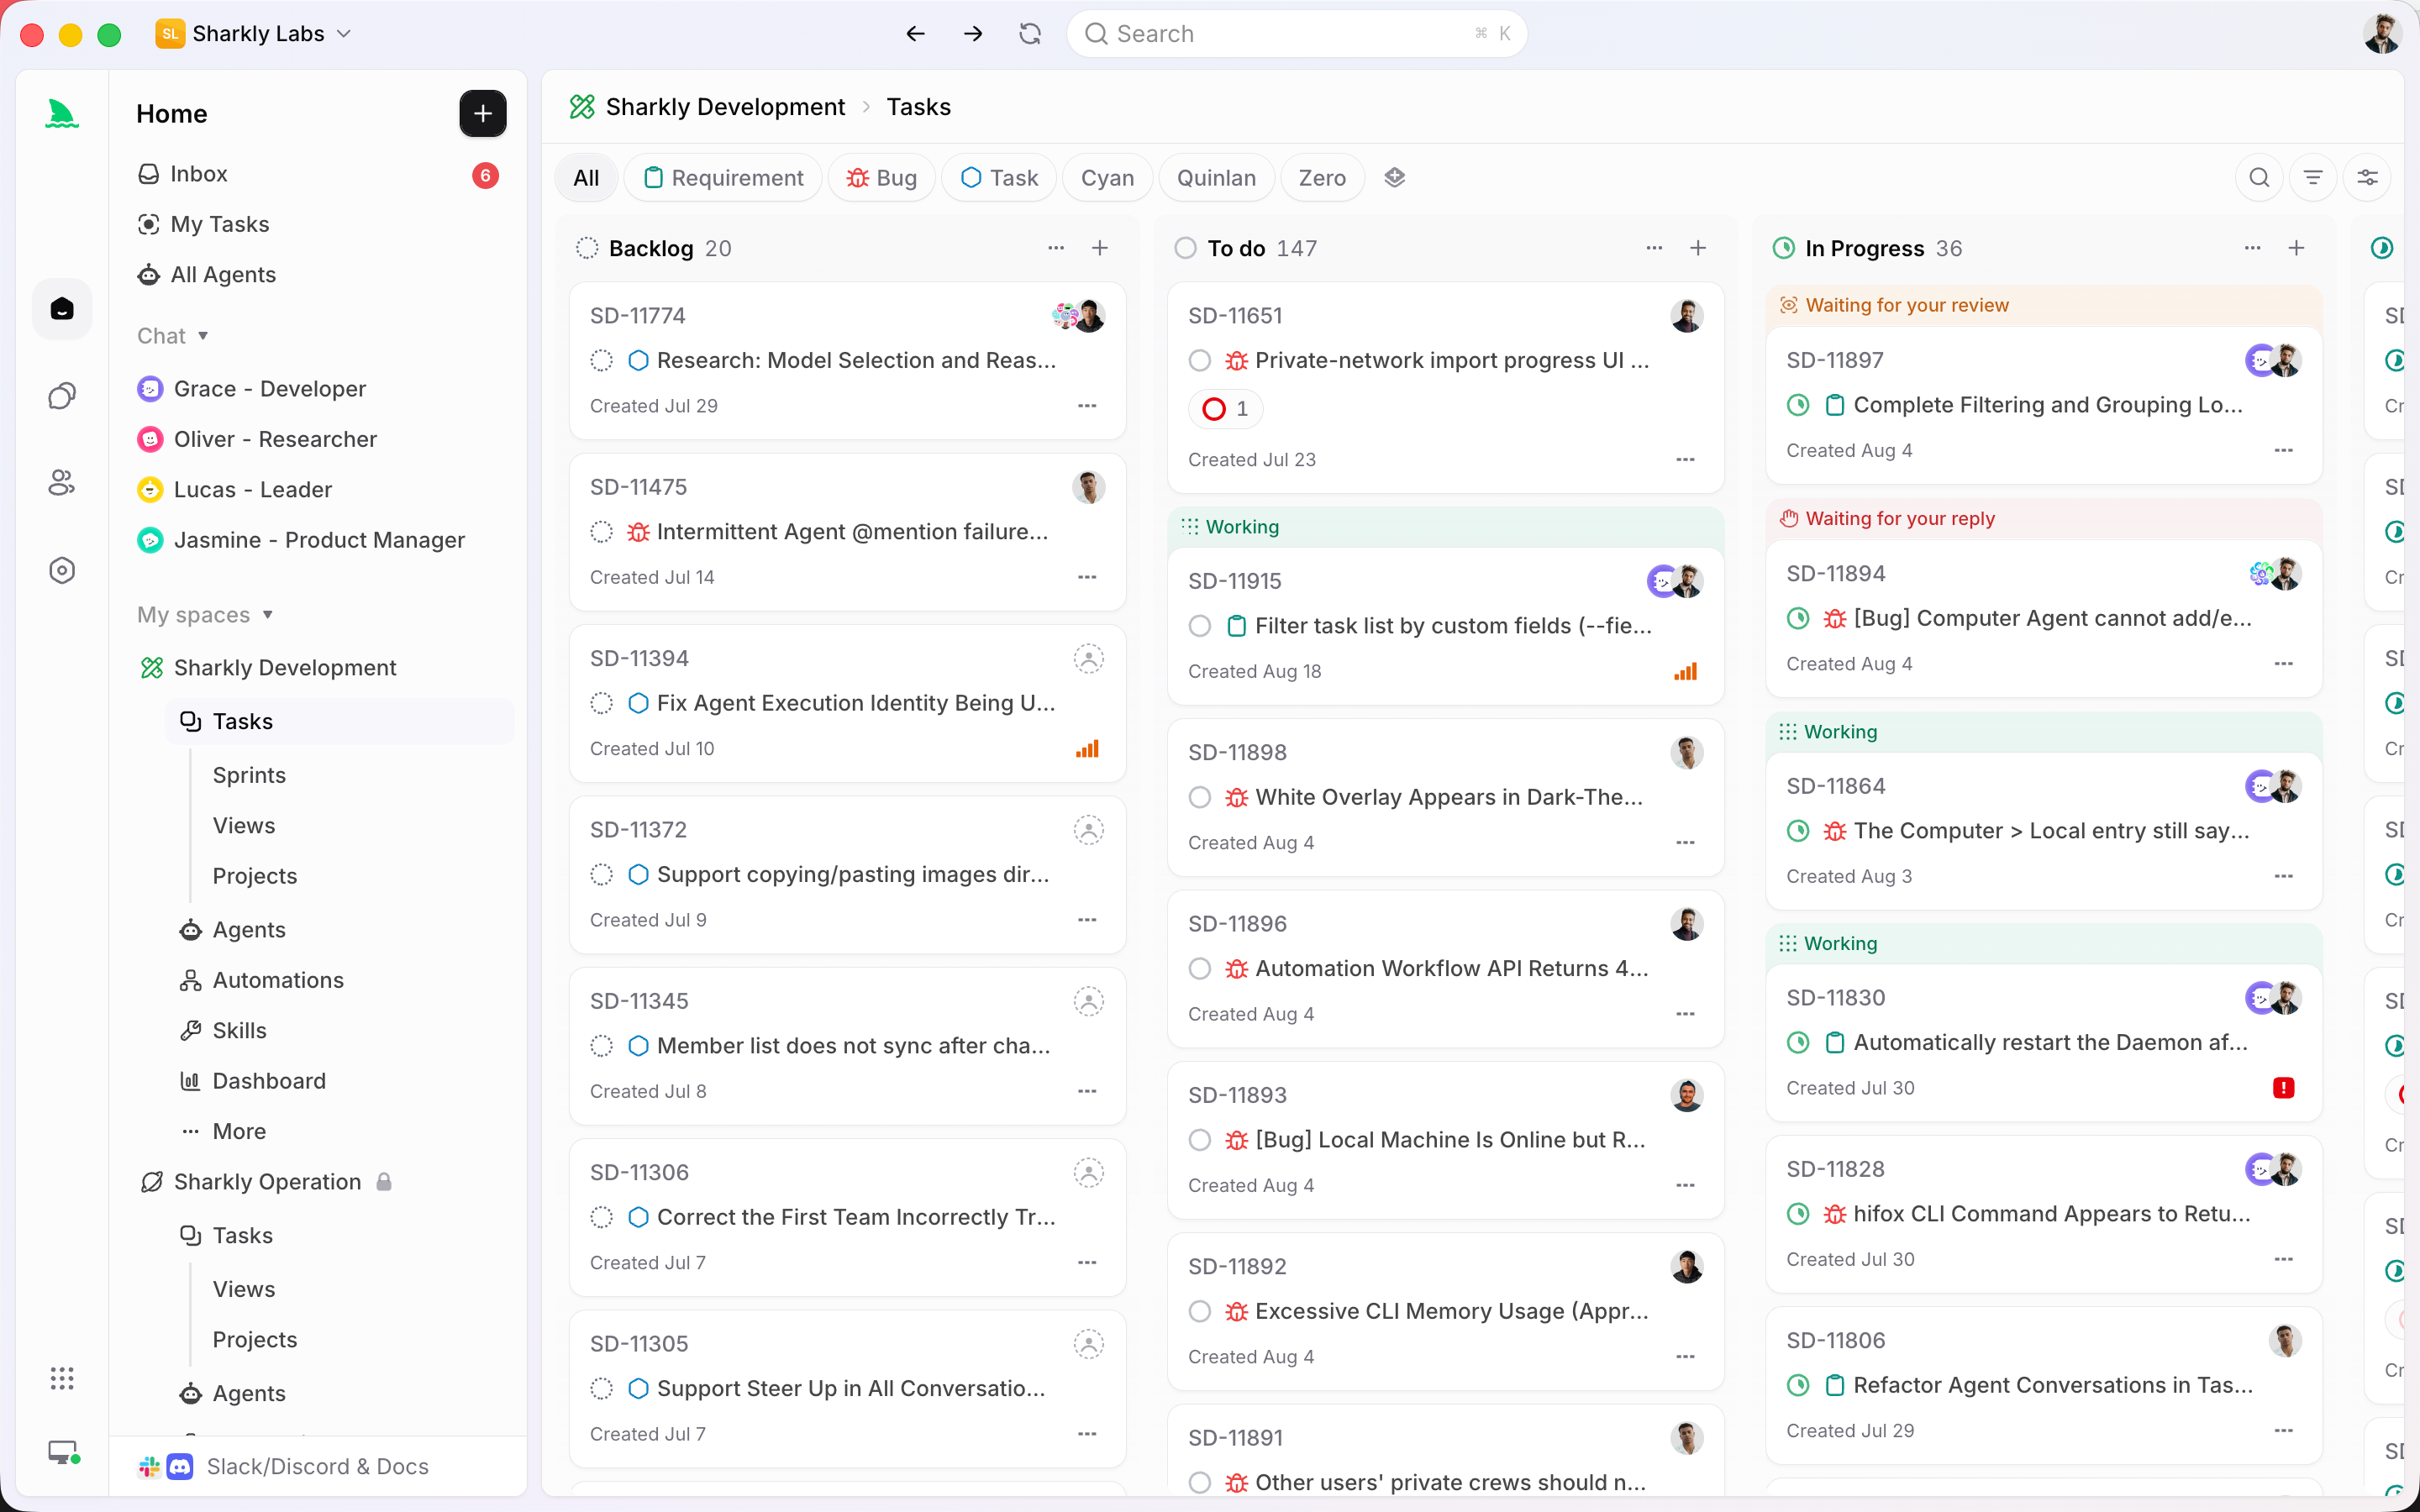
Der Ort zum Laufen ist eine Automation: eine Space-eigene Regel, die einen Agent mit einer Reihe von Anweisungen zu einem Trigger startet, und ein Trigger ist eine Task, die in einen gewählten Status wechselt. Richtet sie auf den Status aus, den eure Agents erreichen, wenn ein PR offen ist, und die Anweisungen lauten: die Diff-Zusammenfassung, das Testergebnis und die berührten Pfade der Task lesen; Jev mit den drei Fragen aufrufen; die Antworten und das Band als Kommentar an der Task zurückschreiben; ein Label für die Warteschlange setzen. Die Doku ist eindeutig, dass ein abgeschlossener Lauf „kein Versprechen ist, dass jedes nachgelagerte Geschäftsergebnis korrekt war“ – genau die Grenze, die auch die Review-Bänder ziehen.
Der Ort zum Landen ist die Task selbst. Das Band, die Warteschlange und der Risk-Score kehren in die Task zurück, wo der Reviewer ohnehin hinschaut – neben der Change-Zusammenfassung und den Verifikationsergebnissen des Laufs. Ein Mensch öffnet das Board, sortiert nach Risiko, und sieht, warum jeder PR dort steht, wo er steht. Agents öffnen den Pull Request, führen die Tests aus und berichten. Menschen lesen in der Reihenfolge, die die Warteschlange vorschlägt, und nehmen an oder lehnen ab. Die Reihenfolge kam aus einer Wahrscheinlichkeit; die Entscheidung nicht.
Wenn ihr bereits mehrere Agents laufen lasst und die Review-Warteschlange das eigentliche Problem ist, dann ist das genau der Workflow, den Erste Schritte mit Sharkly einrichtet: ein Computer, ein Agent, eine Task mit den Belegen, die ein Ranking braucht.
FAQ
Kann Jev den ganzen Diff statt einer Zusammenfassung lesen?
Es nimmt bis zu 32k Tokens State entgegen, ein kleiner Diff passt also hinein. Sendet trotzdem eine Zusammenfassung: Diffs von Agents sprengen das Budget, und eine Zusammenfassung hält die Frage auf der Routing-Ebene. Den vollständigen Diff liest der Mensch, daneben die Belege auf Task-Ebene.
Was, wenn der Agent die Diff-Zusammenfassung selbst geschrieben hat?
Dann kann die Zusammenfassung zu Gunsten des Agents verzerrt sein, und das Ranking erbt diese Verzerrung. Bevorzugt eine Zusammenfassung, die in einem separaten Schritt aus dem Diff erzeugt wird, und lasst einen risk-Score an der Spitze immer einen niedrigen needs_human-Wert überstimmen. Hier gelten die Grenzen von KI-Code-Review: Das Modell kann ranken, was ihm gezeigt wird, aber nicht verifizieren, was ihm nicht gezeigt wird.
Bedeutet ein niedriges Band, dass der PR automatisch gemerged wird?
Nein. Ein niedriges Band bedeutet, dass ein Mensch ihn später merged, nach eigenem Zeitplan, ohne ihn zuerst in der Warteschlange zu lesen. Die Verantwortung für den Merge – und für die Arbeit, die der Agent erzeugt hat – bleibt in jedem Band bei einer namentlich genannten Person.
Ist Jev über Sharkly kostenlos?
Sharkly verkauft Jev oder irgendein anderes Modell nicht weiter; ihr bringt euren eigenen TypeSafe- oder Gateway-Key mit, genauso wie Läufe über die Abonnements abgerechnet werden, die an eure Runtimes gebunden sind. Sharkly selbst ist derzeit für Organisationen mit bis zu 5 Personen kostenlos.


