
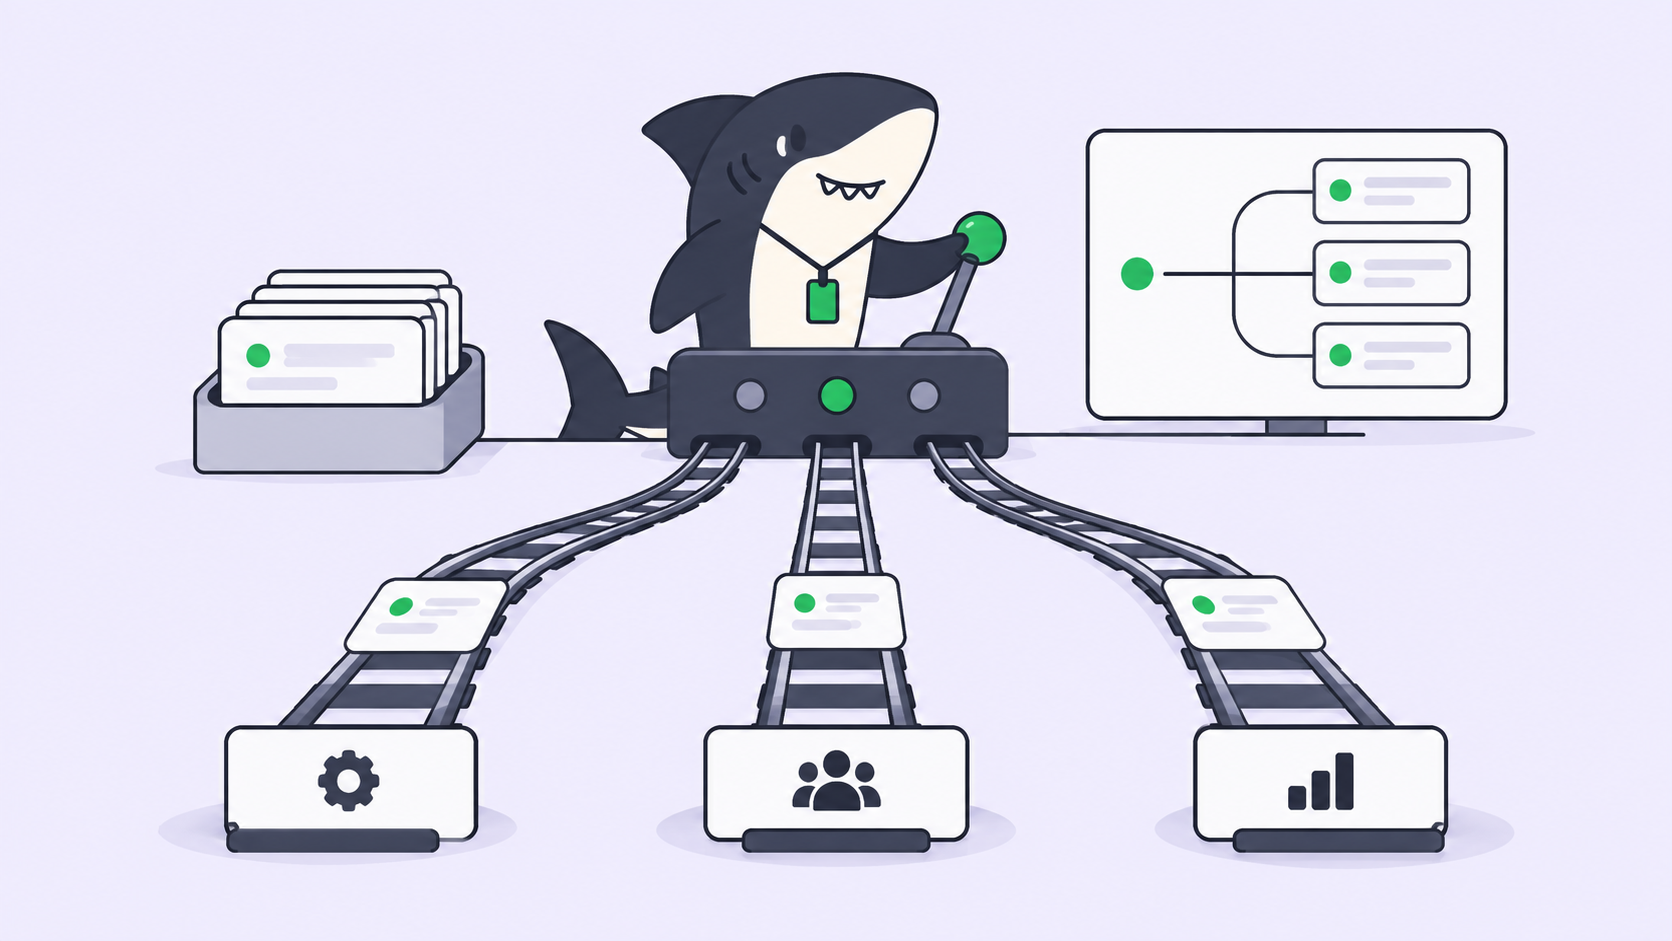
Dein Team verteilt Arbeit bereits zwischen Modellen. Nur eben im Kopf. Ein Entwickler lässt alles auf der teuren Stufe laufen, weil sie seltener fehlschlägt. Ein anderer ist letzten Monat auf eine günstige umgestiegen und hat es niemandem erzählt. Ein Dritter läuft immer noch mit dem, was das Tool bei der Installation voreingestellt hat. Das ist verkraftbar, solange eine Person einen Agenten steuert. Es endet in dem Moment, in dem fünf Agenten parallel laufen und niemand sagen kann, welcher für einen Docstring das Vierzigfache dessen ausgibt, was nötig wäre, oder welcher still einen Job verpatzt, für den er nie stark genug war.
Am 22. September 2026 wurde der Abstand zwischen den Stufen groß genug, um eine Rolle zu spielen. Anthropic lieferte Claude Opus 5.5 aus. OpenAI lieferte GPT-6 Sol und GPT-6 Luna aus. Der Abstand zwischen der günstigsten und der teuersten der drei beträgt bei Input-Tokens den Faktor vierzig, und jede von ihnen ist gut genug, um ihr eine echte Aufgabe zu übergeben.
Eine Routing-Regel ist eine schriftliche Festlegung, keine Vorliebe
Eine Routing-Regel ist eine schriftliche Festlegung, welche Klasse von Task auf welcher Runtime läuft – und sie hängt am Agent, der die Arbeit ausführt, nicht an der Person, die den Lauf zufällig gestartet hat.
Das ist die ganze Idee, und die wichtige Hälfte davon ist „schriftlich“. Eine Vorliebe lebt im Terminal einer einzelnen Person und verfällt, sobald diese in den Urlaub geht. Eine Regel lebt direkt neben dem Agent, sodass ein Assignee, der einen Task übernimmt, sie erbt, ein Reviewer sehen kann, welche Stufe den Diff erzeugt hat, den er gerade liest, und eine Meinungsänderung im nächsten Quartal eine einzige Änderung ist statt sechs Gespräche.
Eine Routing-Regel ist keine Rangliste von Modellen. Sie kürt keinen Sieger und braucht auch keinen. Sie sagt, wohin jede Art von Arbeit standardmäßig geht und was passiert, wenn sich dieser Standard als falsch erweist.
Was die drei Stufen kosten
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API-ID | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Input / Output pro 1 Mio. | 4 $ / 20 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ |
| Gecachter Input | 0,20 $ lesen, 5 $ schreiben | 90 % Rabatt auf Lesevorgänge | 90 % Rabatt auf Lesevorgänge |
| Kontext | 1M | 872k | 1M |
Zum Vergleich: Claude Opus 5 kostet 5 $ / 25 $ und GPT-6 Astra 10 $ / 50 $. OpenAI beschreibt Sol und Luna als 50 % günstiger als den promotional-Preis von GPT-5.6. Das Wort „promotional“ stammt von OpenAI selbst, und es verändert die Aussage: Die Vergleichsbasis für diese Schlagzeile ist ein Rabattpreis, kein Listenpreis. OpenAI erklärt außerdem, Astra „bleibt in jeder Hinsicht unser bestes Modell“ – eine nützliche Erinnerung daran, dass Sol innerhalb der eigenen Familie die Preis-Leistungs-Stufe ist und nicht das Flaggschiff.
Eine praktische Prüfung, bevor du eine Stufe in eine Regel schreibst: OpenAI listet Sol und Luna in ChatGPT Work und in Codex für Plus, Pro, Business, Enterprise und Edu, wobei Free und Go Luna in der Desktop-App erhalten, und sagt, dass beide noch nicht in Chat verfügbar sind. Die Verfügbarkeit prägt eine Routing-Regel genauso wie der Preis, denn eine Stufe, die die Hälfte deiner Crew nicht erreicht, ist keine Stufe.
Route nach den Kosten pro abgeschlossener Aufgabe, nicht nach dem Token-Preis
Der Token-Preis ist nur ein Stellvertreter für die Zahl, die du tatsächlich zahlst. Ein Modell zum Fünftel des Preises, das vier Versuche und eine menschliche Rettungsaktion braucht, ist nicht günstiger. OpenAI hat zu diesem Launch die Kosten pro Aufgabe zusammen mit dem Score veröffentlicht – ungewöhnlich direkt und genau die richtige Form von Beleg für eine Routing-Entscheidung.
| Benchmark, wie von OpenAI veröffentlicht | Ergebnis | Kosten pro Aufgabe, relativ |
|---|---|---|
| AutomationBench 1.0.6, Sol auf extra-high | 33,2 % | 0,27 $ pro Aufgabe |
| AutomationBench 1.0.6, GPT-6 Astra auf low | 30,3 % | 3,9x Sol |
| AutomationBench 1.0.6, Claude Opus 5 auf max | 26,9 % | 11,1x Sol |
| AutomationBench 1.0.6, Fable 5.1 mit Opus-5-Fallback auf max | 31,4 % | mehr als 8,9x Sol |
| Agents’ Last Exam V1, Sol auf max | 56,4 %, besser als der Bestwert von Opus 5 | 60 % niedriger als Opus 5 |
| OSWorld 2.0 offline, Sol auf extra-high | 60,5 % gegenüber Opus 5 auf medium mit 60,3 % | rund 80 % günstiger |
| DeepSWE 1.1, Luna auf max | 66,6 % | 93 % günstiger als Opus 5 |
| DeepSWE 1.1, Sol auf max | 68,8 %, nur 1,1 Prozentpunkte von Fable 5 auf extra-high entfernt | rund 80 % günstiger |
An dieser Tabelle stimmen zwei Dinge gleichzeitig. Die Abstände sind groß, und sie beziehen sich auf Claude Opus 5, nicht auf Opus 5.5, das es noch nicht gab, als OpenAIs Beitrag geschrieben wurde, und das Stunden später erschien – laut Anthropic selbst 40 % günstiger im Betrieb als Opus 5. Niemand hat den Vergleich neu gerechnet. Behandle die Zeilen als die zuletzt veröffentlichten Zahlen und die Rangfolge, die sie nahelegen, als Hypothese, die du an deinem eigenen Repository testest.
Was diesen Vorbehalt übersteht, ist die Form – und die Form ist genau das, was eine Routing-Regel braucht. Die günstigen Stufen behaupten sich bei klar umrissener, wiederholbarer Arbeit zu einem Bruchteil der Kosten. Die Angaben von Anthropic zu Opus 5.5 betreffen gar nicht die Kosten pro Aufgabe: 40 % günstiger im Betrieb als Opus 5, rund 30 % schnellere Ausgabe, maximal 128k Output und 18 Stunden oder länger konzentriert bei der Sache bleiben. Das beschreibt ein Modell, auf das du lange, unschöne Arbeit richtest – nicht eines für hundert kleine Jobs.
Die Regel, ausformuliert
Hier ist das Artefakt. Es ist bewusst langweilig, und es gehört dorthin, wo das Team es liest – nicht in eine private Konfigurationsdatei auf einem einzelnen Laptop.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
Drei Zeilen leisten die eigentliche Arbeit. Die Standardstufe ist benannt, damit ein Task, über den niemand nachgedacht hat, an einer vernünftigen Stelle landet. Die Eskalation ist explizit, damit ein günstiger Fehlschlag nicht unbemerkt zu einem teuren ausufert. Ausnahmen werden am Task festgehalten – das ist der Unterschied zwischen einer Regel und einem Vorschlag.
Die Eskalation ist die Hälfte, die Teams auslassen
Die Einsparungen in der Tabelle oben sind real – pro Versuch. Sie verpuffen, wenn aus einem günstigen Versuch routinemäßig ein teurer Wiederholungsversuch plus menschliche Rettung wird, denn dann zahlst du für beide Läufe und für die Unterbrechung. Genau das ist der Fehlermodus automatischer Fallback-Ketten: Sie verstecken die Kosten der günstigen Stufe in der Rechnung der teuren, und niemand sieht den Wechselkurs.
Mach die Eskalation deshalb manuell und sichtbar. Ein fehlgeschlagener Lauf kommt zum Task zurück – mit Log, dem bisherigen Diff und der Frage, an der er hängen geblieben ist. Ein Mensch entscheidet, ob er ihn eine Stufe hochroutet, aufteilt oder klärt. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Wenn dein Eskalationspfad eine Retry-Schleife ist, hast du genau die Entscheidung automatisiert, für die es einen Menschen gebraucht hätte.
Und noch etwas solltest du im Blick behalten, bevor du latenzempfindliche Arbeit eine Stufe nach unten routest. Artificial Analysis, ein Drittanbieter und nicht einer der beiden Hersteller, hat die „max“-Reasoning-Varianten gemessen: 115,2 Output-Tokens pro Sekunde für Sol bei 102,15 Sekunden bis zum ersten Token und 153,9 Tokens pro Sekunde für Luna bei 124,23 Sekunden. Prüfe diese Werte gegen die aktuelle Auflistung, bevor du dich auf sie verlässt. [VERIFY] Die Form ist der Punkt: Bei maximalem Reasoning-Aufwand sind die günstigen Modelle nicht die schnell startenden, und ein Agent, der hundert Sekunden nachdenkt, sieht genauso aus wie ein Agent, der sich aufgehängt hat. Auf welche Stufe du auch routest: wie die Runtime Fortschritt und Fehler signalisiert entscheidet, ob jemand den Unterschied bemerkt.
Wann man keine Routing-Regel schreiben sollte
Wenn du einen Agenten auf einem Repository betreibst, lass das alles. Wähle die Stufe, die zu deiner Arbeit passt, und mach weiter. Routing kostet ein Dokument, das gepflegt werden will, und eine Diskussion, die geführt werden muss, und es zahlt sich erst aus, wenn mehrere Agenten gleichzeitig laufen und sich ihre Kosten- oder Fehlermuster unterscheiden.
Die Schwelle liegt ungefähr hier: Schreib die Regel, sobald zwei oder mehr Personen einen Lauf starten können oder ein Budget mehrere gleichzeitige Agenten abdeckt. Darunter ist die Regel Overhead. Darüber ist ihr Fehlen der Grund, warum niemand die Rechnung des letzten Monats erklären kann.
Die Zahl, die sich nicht bewegt
Die Kosten pro abgeschlossener Aufgabe sind auf beiden Seiten dieses Launches stark gefallen. Zur Einordnung: OpenAI berichtet, dass sein mittlerer Researcher über 600 $ pro Tag für Coding-Agenten ausgibt, das 90. Perzentil liegt bei 7.000 $. Teams unterhalb dieser Linie bekommen für dasselbe Budget nun ein Vielfaches an fertiggestellter Agenten-Arbeit – ein guter Grund, die Ausgaben pro Runtime statt pro Rechnung zu verfolgen.
Zusätzliche Reviewer-Stunden gab es keine. Routing ist ein Kostenhebel und ein Zuverlässigkeitshebel, aber kein Durchsatzhebel, denn die Warteschlange an Arbeit, die darauf wartet, von einem Menschen abgenommen zu werden, bleibt unverändert. Was Routing leisten kann, ist, diese Warteschlange lesbar zu machen: welche Stufe diesen Diff erzeugt hat, was er gekostet hat, wie viele Versuche nötig waren und ob der Task, der zweimal fehlgeschlagen ist, in jemandes Inbox liegt – oder nirgendwo. Halte Ziel, Lauf, Kosten, Blocker und Review vom Request bis zum Release am Task, und die Routing-Regel wird zu einer Einstellung, die das Team bearbeitet, statt zu einer Gewohnheit, die sechs Leute privat pflegen.
Sharkly führt das Modell nicht aus und wählt es auch nicht für dich aus. Sharkly ist die gemeinsame Task-, Computer-, Kontext- und Review-Schicht um die Tools herum, die das tun – und genau dort muss eine Routing-Regel leben, wenn sie die Person überdauern soll, die sie geschrieben hat. Wenn du bereits mehrere Coding-Agenten laufen lässt, sind welches Modell welche Aufgabe bekommt und welcher Agent sie bekommt dieselbe Entscheidung aus zwei Blickwinkeln. Verbinde einen Computer, erstelle einen Agent pro Stufe und gib der günstigen etwas Langweiliges.


