
Im Ankündigungsbeitrag zu Muse Wonder beschreibt Meta ein Verhalten namens „Active Focus“: Das Modell arbeitet beharrlich an anspruchsvollen Zielen, probiert alternative Lösungsansätze aus, überwindet Hindernisse und bittet – wie Meta es formuliert – bei Bedarf um Klärung oder meldet sich vor folgenreichen Aktionen zurück. Meta empfiehlt zudem eine menschliche Bestätigung vor weitreichenden Schritten; der coding-agents guide liefert Muse Code von Beginn an mit aktivierten Genehmigungen und einer Sandbox aus.
Das ist architektonisch genau der richtige Ansatz. Gleichzeitig wirft es eine Frage auf, die jedem Team vertraut ist, das Agenten parallel betreibt: Wenn das Modell innehält, um nachzufragen – wer antwortet dann, wie schnell und mit welchem Kontext? Eine Rückfrage, die in einem Terminal landet, auf das niemand schaut, bedeutet einen blockierten Lauf. Eine Rückfrage hingegen, die in einer gemeinsamen Inbox landet und direkt mit dem zugehörigen Task verknüpft ist, wird zu einem echten Review-Schritt. In diesem Beitrag geht es darum, genau diese zweite Variante aufzubauen.
Was Active Focus bewirkt
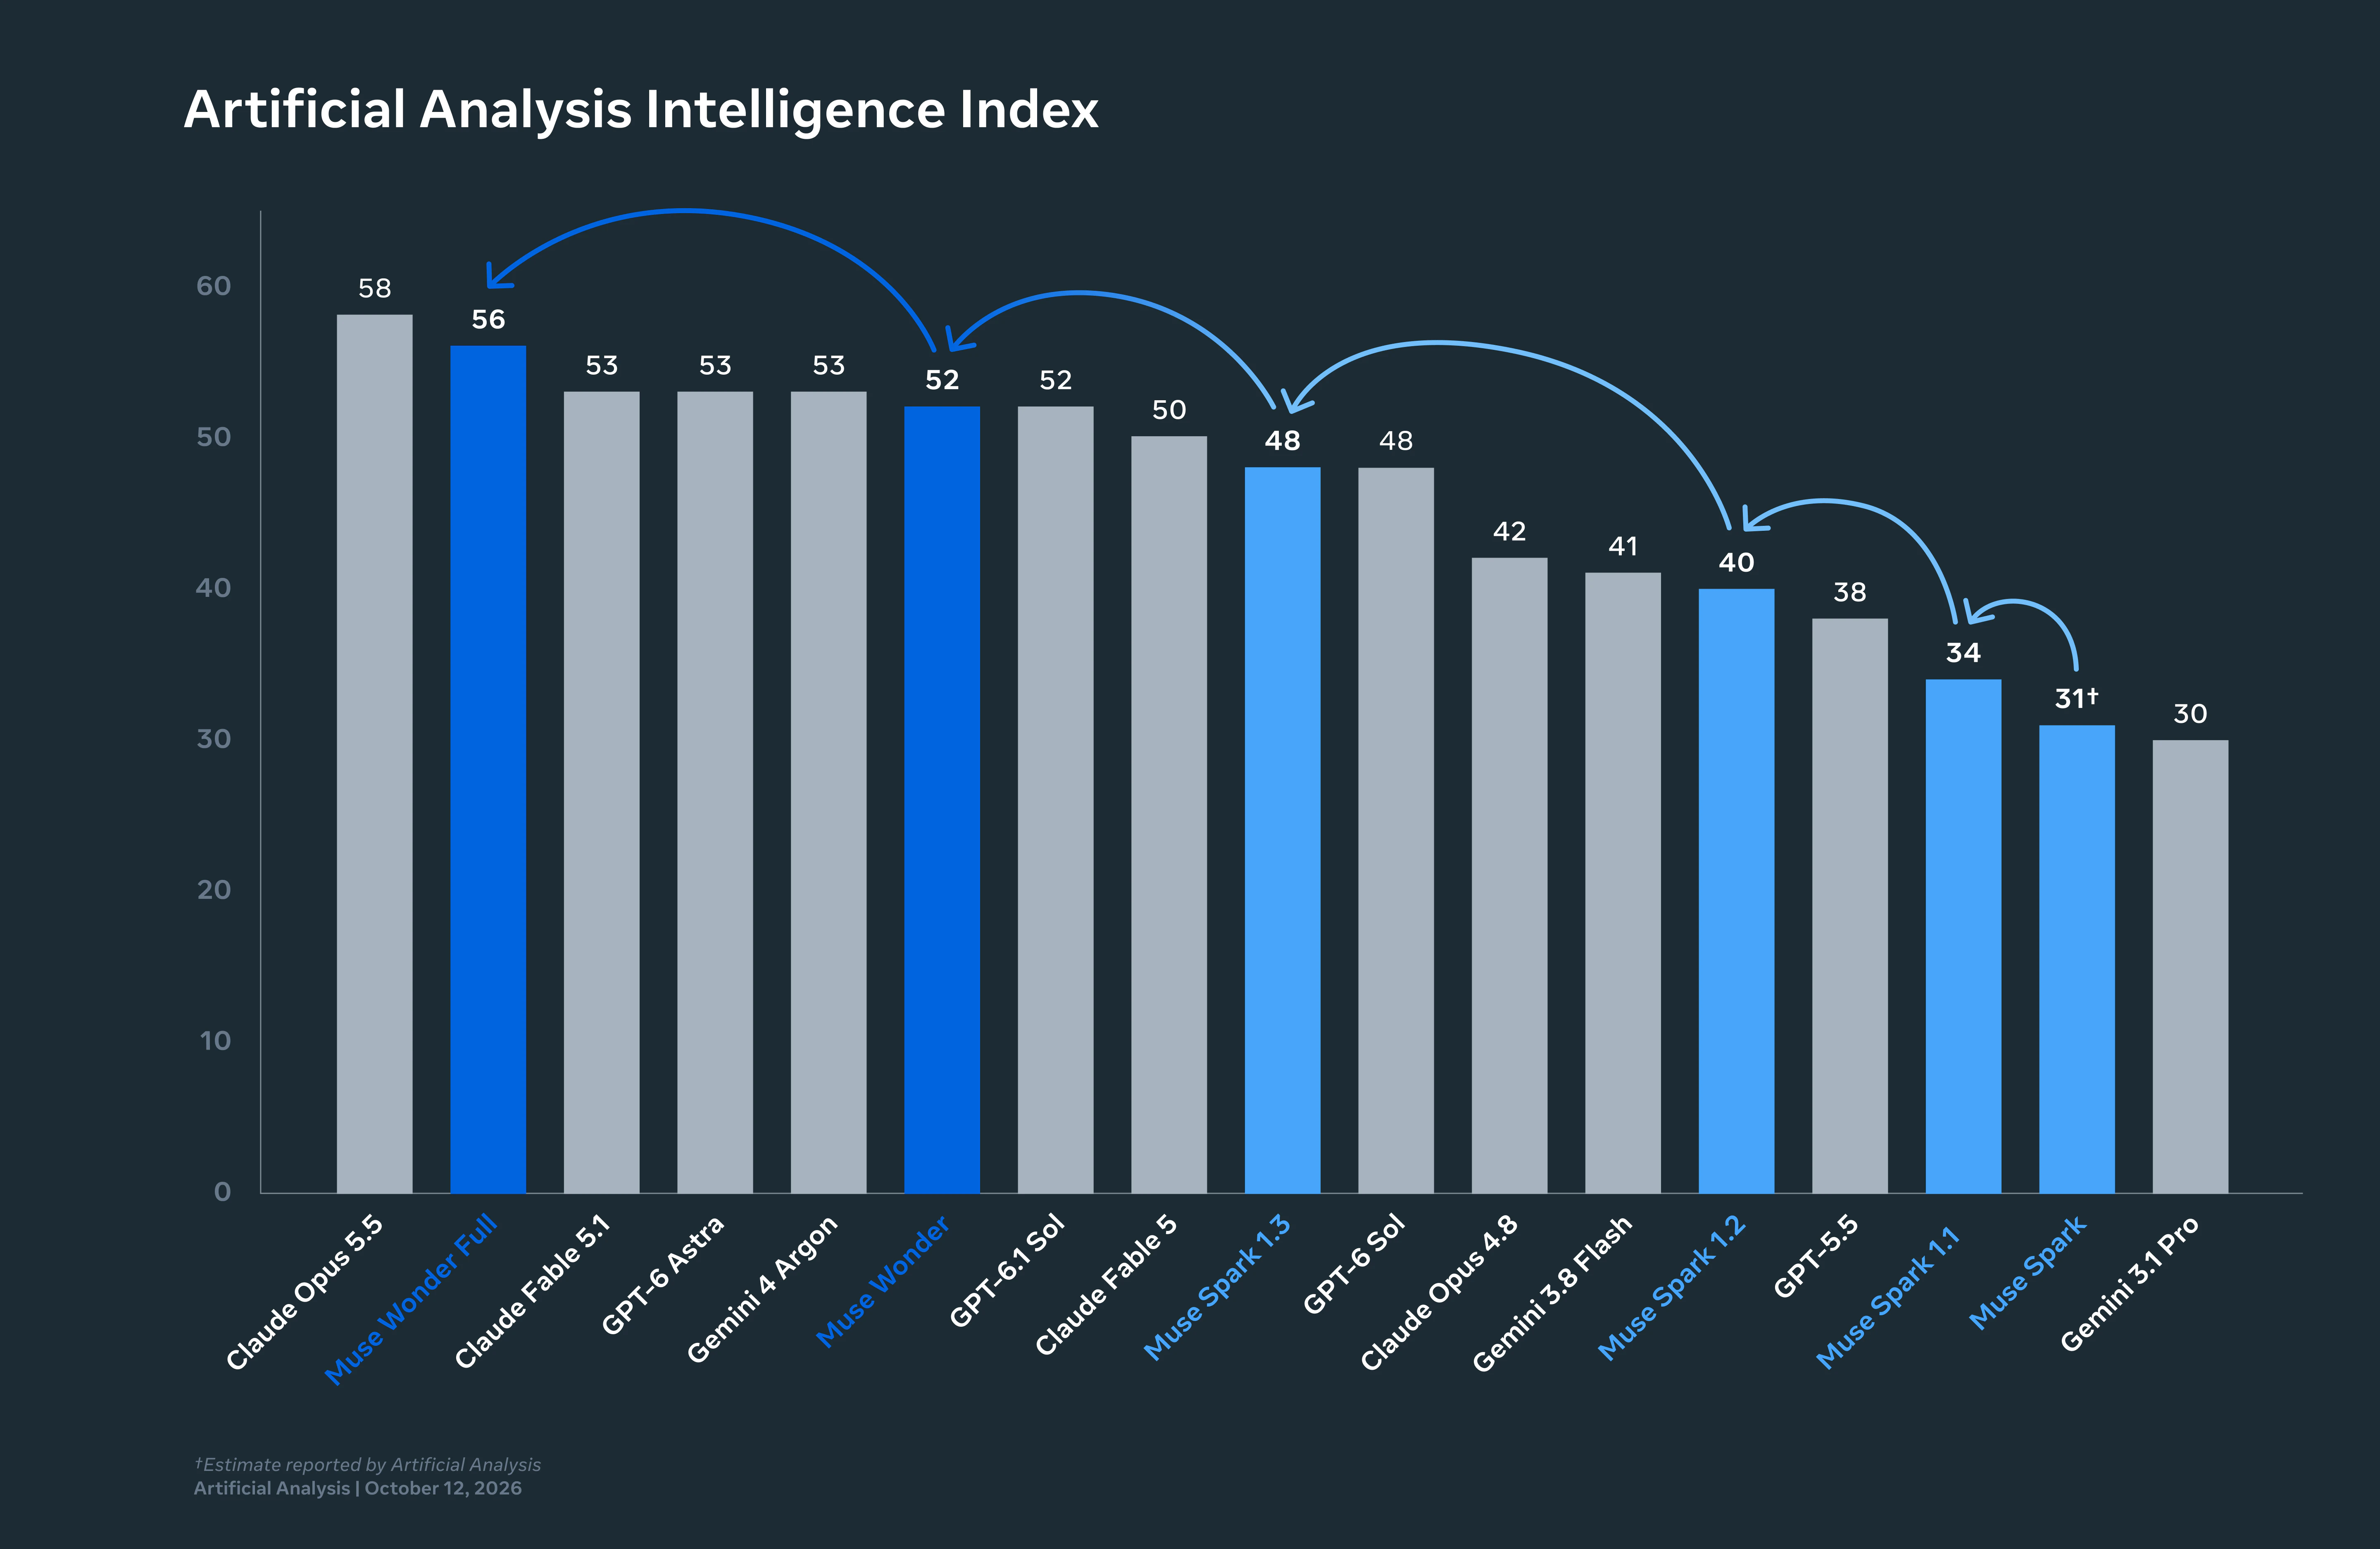
Meta hat das Modell auf drei Kernverhaltensweisen trainiert und misst diese anhand eines internen Benchmarks namens FocusBench. Dort führt Muse Wonder Full mit 54,2 %, während das per API verfügbare Wonder bei 44,9 % liegt – hinter GPT-6 Astra und Claude Opus 5.5. Doch lassen wir die Benchmarks beiseite: Entscheidend für ein Board sind die Verhaltensweisen:
- Persistenz. Das Modell gibt bei Fehlschlägen nicht auf. Beim Langzeit-Coding-Benchmark SWE-Marathon erzielt Wonder 53,1 Punkte gegenüber 46,3 bei Opus 5.5. Das bedeutet: längere Läufe, mehr Versuche, mehr Review-Aufwand.
- Klärung. Ist eine Aufgabe unklar, fragt das Modell nach, statt blind zu raten. Auf einem Board ist das ein Kommentar zum Task; im Terminal lediglich ein Prompt, der auf einen Tastendruck wartet.
- Check-ins. Das Modell pausiert vor Aktionen, die es als wichtig einstuft. Meta selbst empfiehlt, bei allem mit spürbaren Auswirkungen auf eine menschliche Bestätigung zu setzen.
Jede dieser Eigenschaften verändert die Struktur der Review-Queue. Persistenz sorgt für mehr Umfang pro Task. Klärungen führen zu Unterbrechungen. Und Check-ins erfordern Entscheidungen, die einen Durchlauf so lange blockieren, bis jemand sie trifft.
Wo der Check-in landet
In Muse Code erscheint eine Bestätigungsaufforderung im Terminal des Nutzers, und der Durchlauf pausiert. Bei Headless-Läufen (muse exec) gibt es keinen interaktiven Prompt; laut Metas Dokumentation muss man daher entweder eine Policy wählen, die unbeaufsichtigt durchlaufen kann, oder damit rechnen, dass angehaltene Aktionen ungelöst bleiben. Das ist der unverblümte Kompromiss: Entweder sitzt jemand an der Tastatur, das Modell läuft ohne Freigabeprüfungen, oder die Aktion wartet bis in alle Ewigkeit.
Auf einem Sharkly-Board ist der Lauf ein Task, der einem Agenten auf einem Computer zugewiesen ist. Wenn der Agent innehält, um nachzufragen, wird die Frage als Kommentar an den Task zurückgespielt und in die Inbox weitergeleitet. Der Task liefert den gesamten Kontext: was gefragt wurde, was der Agent bisher getan hat sowie das Ausführungsprotokoll der Tool-Calls und Runtime-Events. Wer auch immer das Ticket übernimmt, antwortet direkt im Task, sodass der Lauf an genau dieser Stelle fortgesetzt werden kann. Der Check-in bleibt eine menschliche Entscheidung – aber eine mit nachvollziehbarem Verlauf, einer klaren Queue und mehreren Personen, die sie treffen können.
Das ist der Unterschied zwischen einem Schutzmechanismus und einem Stillstand. Das Verhalten des Modells ist identisch; das System drumherum entscheidet darüber, ob ein Check-in eine Minute oder einen ganzen Tag kostet.
Agenten instruieren: So werden Check-ins wirklich nützlich
Ein Check-in ist nur so gut wie die gestellte Frage. Verankern Sie die Kriterien für eine präzise Rückfrage direkt in den Anweisungen des Agenten:
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
Die erste Regel zieht eine klare Grenze. Metas Modell entscheidet selbst, was es für wichtig hält; die Anweisung gibt ihm vor, was für das Team zählt. Die zweite Regel sorgt dafür, dass jemand, der den Durchlauf nicht live verfolgt hat, den Kommentar innerhalb von 30 Sekunden beantworten kann. Die dritte Regel verhindert, dass das Modell wegen jeder Kleinigkeit nachhakt – genau jenes Fehlverhalten, das aus einem vorsichtigen Agenten einen nervigen macht. Der Guardrails-Beitrag zu Opus 5.5 beleuchtet dieselbe Abgrenzung aus Sicht von Prompt Injections: Das Review-Gate ist die maßgebliche Kontrollinstanz, ganz gleich, was das Modell verspricht.
Die Review-Queue richtig dimensionieren
Persistenz bedeutet mehr Review-Aufwand pro Task, nicht weniger. Stellen Sie sich darauf ein.
| Lane | Typischer Ablauf | Was in der Queue landet |
|---|---|---|
| Muse Wonder bei einem langen Task | Viele Schritte, mehrere verworfene Ansätze | Ein längeres Diff, ein längeres Log, null bis drei Check-ins |
| Opus 5.5 beim selben Task | Weniger Schritte, entscheidungsfreudiger | Ein kürzeres Diff oder ein nur halb erledigter Task |
| Beliebiges Modell, unbeaufsichtigt über Nacht | Alles, was die Policy zugelassen hat | Entweder blockierte Aktionen oder Aktionen, die niemand bestätigt hat |
Drei bewährte Praktiken halten die Queue im Fluss: Weisen Sie Check-ins pro Lane einer namentlich benannten Person zu statt dem gesamten Team, damit eine Frage nicht an einer unbestimmten Gruppe hängenbleibt. Definieren Sie ein agentenspezifisches Timeout pro Task, damit ein durch einen Check-in blockierter Lauf sichtbar fehlschlägt, anstatt stundenlang als aktiv angezeigt zu werden. Und prüfen Sie bei Wonder-Läufen nicht nur das Diff, sondern auch das Log: Der Weg über drei gescheiterte Ansätze ist genau das, was ein persistentes Modell ausmacht – und dort verstecken sich die subtilen Fehler. Der Artikel Coding agents while you’re away behandelt den unbeaufsichtigten Einsatz über Nacht, und human review is the bottleneck erklärt, warum dieser Prozess auch mit besseren Modellen nicht billiger wird.
Wie ein gelungener Check-in auf dem Board aussieht
Hier ist das Ergebnis, das die obigen Anweisungen liefern – als Task-Kommentar, auf den ein Reviewer direkt vom Smartphone aus reagieren kann:
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
Vier Zeilen, eine Entscheidung, beide Handlungsstränge vorab durchdacht. Der Reviewer tippt im Task einfach „Ja“ oder „Nein, behalten“, der Durchlauf wird fortgesetzt und das Log dokumentiert, wer die Entscheidung getroffen hat. Vergleichen Sie das mit einem Terminal-Prompt, der ein knappes Allow? [y/N] ausgibt – gerichtet an jemanden, der die vierzig vorangegangenen Schritte gar nicht mitverfolgt hat.
Zwei Optimierungen, sobald die Lane eine Woche lang im Einsatz war: Falls eine einzelne Person die meisten Check-ins beantwortet, weisen Sie dem Agenten dieser Lane einen zweiten namentlich benannten Reviewer zu, damit ein Nachmittagsmeeting nicht jeden längeren Durchlauf lahmlegt. Und falls der Agent wiederholt zu derselben Art von Aktion nachfragt, gehört dieser Fall als dauerhafte Freigabe oder dauerhafte Ablehnung direkt in die Systemanweisungen – nicht in die Queue.
Der Anwendungsfall Computer Use
Meta zählt Computer Use zu den Kernfähigkeiten von Wonder: das Bedienen von Browsern, Desktop-Umgebungen und mobilen Apps. Genau hier sind Check-ins am wichtigsten und ein Terminal-Prompt am unzureichendsten, da die Aktion in einem Klick auf einen Bildschirm besteht, den die prüfende Person nicht sehen kann. Hier gelten dieselben Regeln wie im Computer-Use-Beitrag zu Astra: Der Agent läuft auf einem vom Team ausgewählten Computer, der Check-in benennt den Screen sowie die konkrete Aktion, und die freigebende Person kann das Task-Log einsehen, bevor sie zustimmt. Ein Modell, das um Erlaubnis bittet, auf „Submit“ zu klicken, ist nur dann sicher, wenn jemand nachvollziehen kann, was dieser Klick tatsächlich bewirkt.
Worum es hierbei nicht geht
Active Focus ist ein Modellverhalten – und Modellverhalten ist keine Garantie. Im eigenen Model Card von Meta heißt es, dass die Modelle bei unbekannten mehrstufigen Aufgaben Fehler machen können; der vollständige Sicherheitsbericht steht noch aus. Der Check-in ist eine Funktion, die ein gutes Review-System noch besser macht; sie ersetzt es nicht. Ein Team, das „meldet sich vor wichtigen Aktionen zurück“ als Freifahrtschein für den unbeaufsichtigten Betrieb versteht, zieht die falschen Schlüsse. Ein Team hingegen, das jedem Check-in einen Task, einen Reviewer und ein Timeout zuweist, hat genau das System geschaffen, für das diese Funktion gedacht ist.
Nichts davon schlägt sich auf der Rechnung von Sharkly nieder. Die Modellnutzung läuft über den auf dem Computer konfigurierten Meta-Key. Das Modell wurde am 12. Oktober aktualisiert. Kontext, Fortschritt, Blocker, Ergebnisse und menschliche Reviews blieben von der Anfrage bis zum Release lückenlos transparent. Sie können diesen Ablauf manuell über Git-Worktrees aufbauen – oder Sharkly nutzen, um den gesamten Workflow zu steuern.


