
Meta hat Muse Wonder am 12. Oktober veröffentlicht – zu einem Preis von 4 $ pro Million Input-Token und 20 $ pro Million Output-Token, mit einem Kontextfenster von 1 Mio. Token und einer API, die drei Dialekte beherrscht: OpenAI Responses, Chat Completions und Anthropic Messages. Genau dieser letzte Punkt sorgt dafür, dass das Modell schon heute direkt über ein Sharkly-Board nutzbar ist. Metas Leitfaden für Coding-Agents beschreibt, wie sich Codex und Claude Code auf muse-wonder-1.0 ausführen lassen, indem man sie auf api.meta.ai verweist – und beide zählen zu den Runtimes, die ein Sharkly Computer bereitstellen kann. Das Modell, auf das sich Metas wichtigste Benchmark-Ergebnisse beziehen – Muse Wonder Full –, steht jedoch nicht über die API zur Verfügung und kann somit nicht als Modell einer Runtime dienen. Mehr dazu weiter unten.
Diese Anleitung zeigt, wie Sie auf einem bestehenden Sharkly Computer mithilfe der Codex-Runtime eine eigene Lane für Muse Wonder einrichten. Zudem erfahren Sie, wie Sie das Modell direkt am Agenten benennen, damit auf dem Board klar ersichtlich ist, an welche Lane eine Task übergeben wurde, und wie Sie die Aufgaben auf die Kernstärke des Modells abstimmen, die Metas und Artificial Analysis’ Benchmarks belegen: lang laufende, agentische Workflows.
TL;DR
Konfigurieren Sie auf dem Computer in ~/.codex/config.toml einen Codex-Provider für Meta mit model = "muse-wonder-1.0", wire_api = "responses" und lassen Sie den API-Schlüssel über MODEL_API_KEY aus den Umgebungsvariablen des lokalen Dienstes auslesen. Führen Sie einen Rescan durch, bis die Codex-Runtime als „Available“ angezeigt wird. Erstellen Sie anschließend einen Agenten auf dieser Runtime, geben Sie das Modell in den Custom arguments an und weisen Sie ihm die umfangreichen Tasks zu: mehrstufige Refactorings, Migrationen oder Review-and-Fix-Schleifen. Belassen Sie wissens- und terminalintensive Aufgaben bei Opus 5.5- oder Astra-Agenten. Agenten recherchieren, führen aus, testen und berichten – die Task liefert das Ergebnis.
Wo die Modelleinstellung hinterlegt wird
Sharkly wählt Modelle nicht selbst aus. Laut der Agents-Dokumentation greift ein Agent standardmäßig auf das Default-Modell der Runtime zurück und blendet keinen Modellnamen ein. Möchte man das Modell ändern, gibt man dies in den Custom arguments des Agenten oder der Runtime an, etwa über specify model: model-name. Es gibt weder ein Dropdown-Menü für Modelle noch eine Einstellung für die Denktiefe (Thinking Depth), da Sharkly nicht zuverlässig auslesen kann, welches Modell eine Runtime letztlich verwendet hat.
Für ein Meta-Modell bedeutet das zwei Ebenen: Der Provider – über den die Runtime api.meta.ai und den zugehörigen Schlüssel findet – wird in der Konfiguration der Runtime auf dem Computer hinterlegt. Die Wahl des Modells erfolgt hingegen direkt am Agenten. So kann ein einzelner Computer problemlos einen Muse-Wonder-Agenten und einen Opus-5.5-Agenten auf unterschiedlichen Runtimes betreiben – wobei das jeweilige Modell stets für Reviewer transparent einsehbar bleibt.
Schritt 1: Codex auf dem Computer einen Meta-Provider zuweisen
Die Codex-Konfiguration stammt direkt aus Metas Anleitung. Hinterlegen Sie auf dem Computer in ~/.codex/config.toml Folgendes:
model = "muse-wonder-1.0"
model_provider = "meta"
model_reasoning_effort = "high"
model_context_window = 1048576

[model_providers.meta]
name = "Meta Model API"
base_url = "https://api.meta.ai/v1"
env_key = "MODEL_API_KEY"
wire_api = "responses"
Zwei wichtige Hinweise von Meta: Melden Sie sich in Codex zuerst von OpenAI ab, da sonst weiterhin der OpenAI-Provider verwendet wird. Zudem ist wire_api = "responses" entscheidend: Die Responses-API überträgt Gedankengänge (Reasoning) über mehrere Interaktionsschritte hinweg, was langen Durchläufen die nötige Kohärenz verleiht.
Der API-Schlüssel gehört in die Umgebungsvariablen des Prozesses, der Codex startet – auf einem Sharkly Computer ist das der lokale Dienst. Setzen Sie MODEL_API_KEY dort, wo dieser Dienst seine Umgebungsvariablen einliest, und starten Sie ihn anschließend neu. Hinterlegen Sie den Schlüssel keinesfalls in Sharkly selbst. Die Computers-Dokumentation weist ausdrücklich darauf hin, dass Passwörter, Tokens und API-Schlüssel nichts in den Feldern für Executables, Argumente oder Umgebungsvariablen der Runtime zu suchen haben. Diese Felder sind für Standardeinstellungen gedacht, nicht für sensible Zugangsdaten.
Testen Sie die Konfiguration zunächst direkt im Terminal des Hosts, bevor Sie Anpassungen am Board vornehmen:
codex "Say which model you are and stop."
Antwortet Codex mit muse-wonder-1.0, ist das Modell für Sharkly einsatzbereit. Öffnen Sie die Detailansicht des Computers und führen Sie den Rescan bzw. Verbindungstest aus. Die Codex-Runtime sollte nun als „Available“ angezeigt werden. Wenn ein Computer lediglich als „Online“ markiert ist, bedeutet das nur, dass der lokale Dienst Heartbeats sendet – erst der Runtime-Status bestätigt, dass Workflows gestartet werden können.
Falls Sie Claude Code als Runtime bevorzugen, ordnet Metas Leitfaden die Modell-Slots wie folgt zu: ANTHROPIC_BASE_URL="https://api.meta.ai", ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY", ANTHROPIC_MODEL="muse-wonder-1.0", den Opus-Slot zu Wonder, die Sonnet- und Haiku-Slots sowie CLAUDE_CODE_SUBAGENT_MODEL zu muse-spark-1.3 und ENABLE_TOOL_SEARCH="true", damit MCP-Tools weiterhin geladen werden. Jeder Slot muss mit einem Meta-Modell belegt sein – andernfalls versuchen der Plan Mode und Subagenten, Claude-Modelle aufzurufen, die von Meta nicht bereitgestellt werden. Auch hier gilt dieselbe Regel: Der API-Schlüssel gehört in die Host-Umgebung, nicht in ein Sharkly-Eingabefeld.
Schritt 2: Einen Agenten erstellen, der sein Modell ausweist
Öffnen Sie den Bereich „Agents“, wählen Sie „New Agent“, bestimmen Sie den Computer sowie die Codex-Runtime und benennen Sie den Agenten passend zur Lane – beispielsweise „Long-run worker“ statt schlicht „Muse“. Geben Sie unter Custom arguments das Modell muse-wonder-1.0 an, genau wie zuvor getestet. Setzen Sie das Arbeitsverzeichnis auf „Create temporary directory“, damit jede Task isoliert ausgeführt wird, und wählen Sie das Timeout pro Task großzügiger als bei einer schnellen, einfachen Lane. Metas zentrales Verkaufsargument für dieses Modell ist schließlich sein Durchhaltevermögen – und genau das misst der SWE-Marathon.
Da Sharkly das Modell nicht automatisch anzeigt, wird der Agent über die Instruktionen angewiesen, es explizit festzuhalten:
You are the long-run lane. State the model id you ran on at the top of your report.
Take the Task as written. Plan before you edit, and keep a running list of what
you tried and why, so a reviewer can follow the path, not only the diff.
Run the closest relevant check before reporting done. Report failures as failures.
If you need a fact you are not sure of, look it up in the repository or say you
could not confirm it. Do not fill gaps from memory.
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, or any action you would want a person to confirm.
Die vierte Anweisung hat einen triftigen Grund: Artificial Analysis bewertet Wonder auf seinem Wissensindex mit lediglich 25 Punkten (im Vergleich zu 46 Punkten bei Opus 5.5) bei einer Halluzinationsrate von 27 %. Das Modell ist eine exzellente Arbeitskraft, aber ein mäßiges Lexikon – die Anweisung stellt klar, welche dieser Rollen es einnehmen soll.
Schritt 3: Umfangreiche Tasks hierher leiten
Wofür sich diese Lane eignet, zeigen Metas Model Card und die unabhängigen Benchmark-Ergebnisse:
| Metrik | Muse Wonder | Claude Opus 5.5 |
|---|---|---|
| SWE-Marathon (lange Coding-Durchläufe) | 53.1 | 46.3 |
| DeepSWE 1.1 | 78.8 | 74.2 |
| Terminal-Bench 4.0 | 52.0 | 59.6 |
| AA-Omniscience (Wissen) | 25 | 46 |
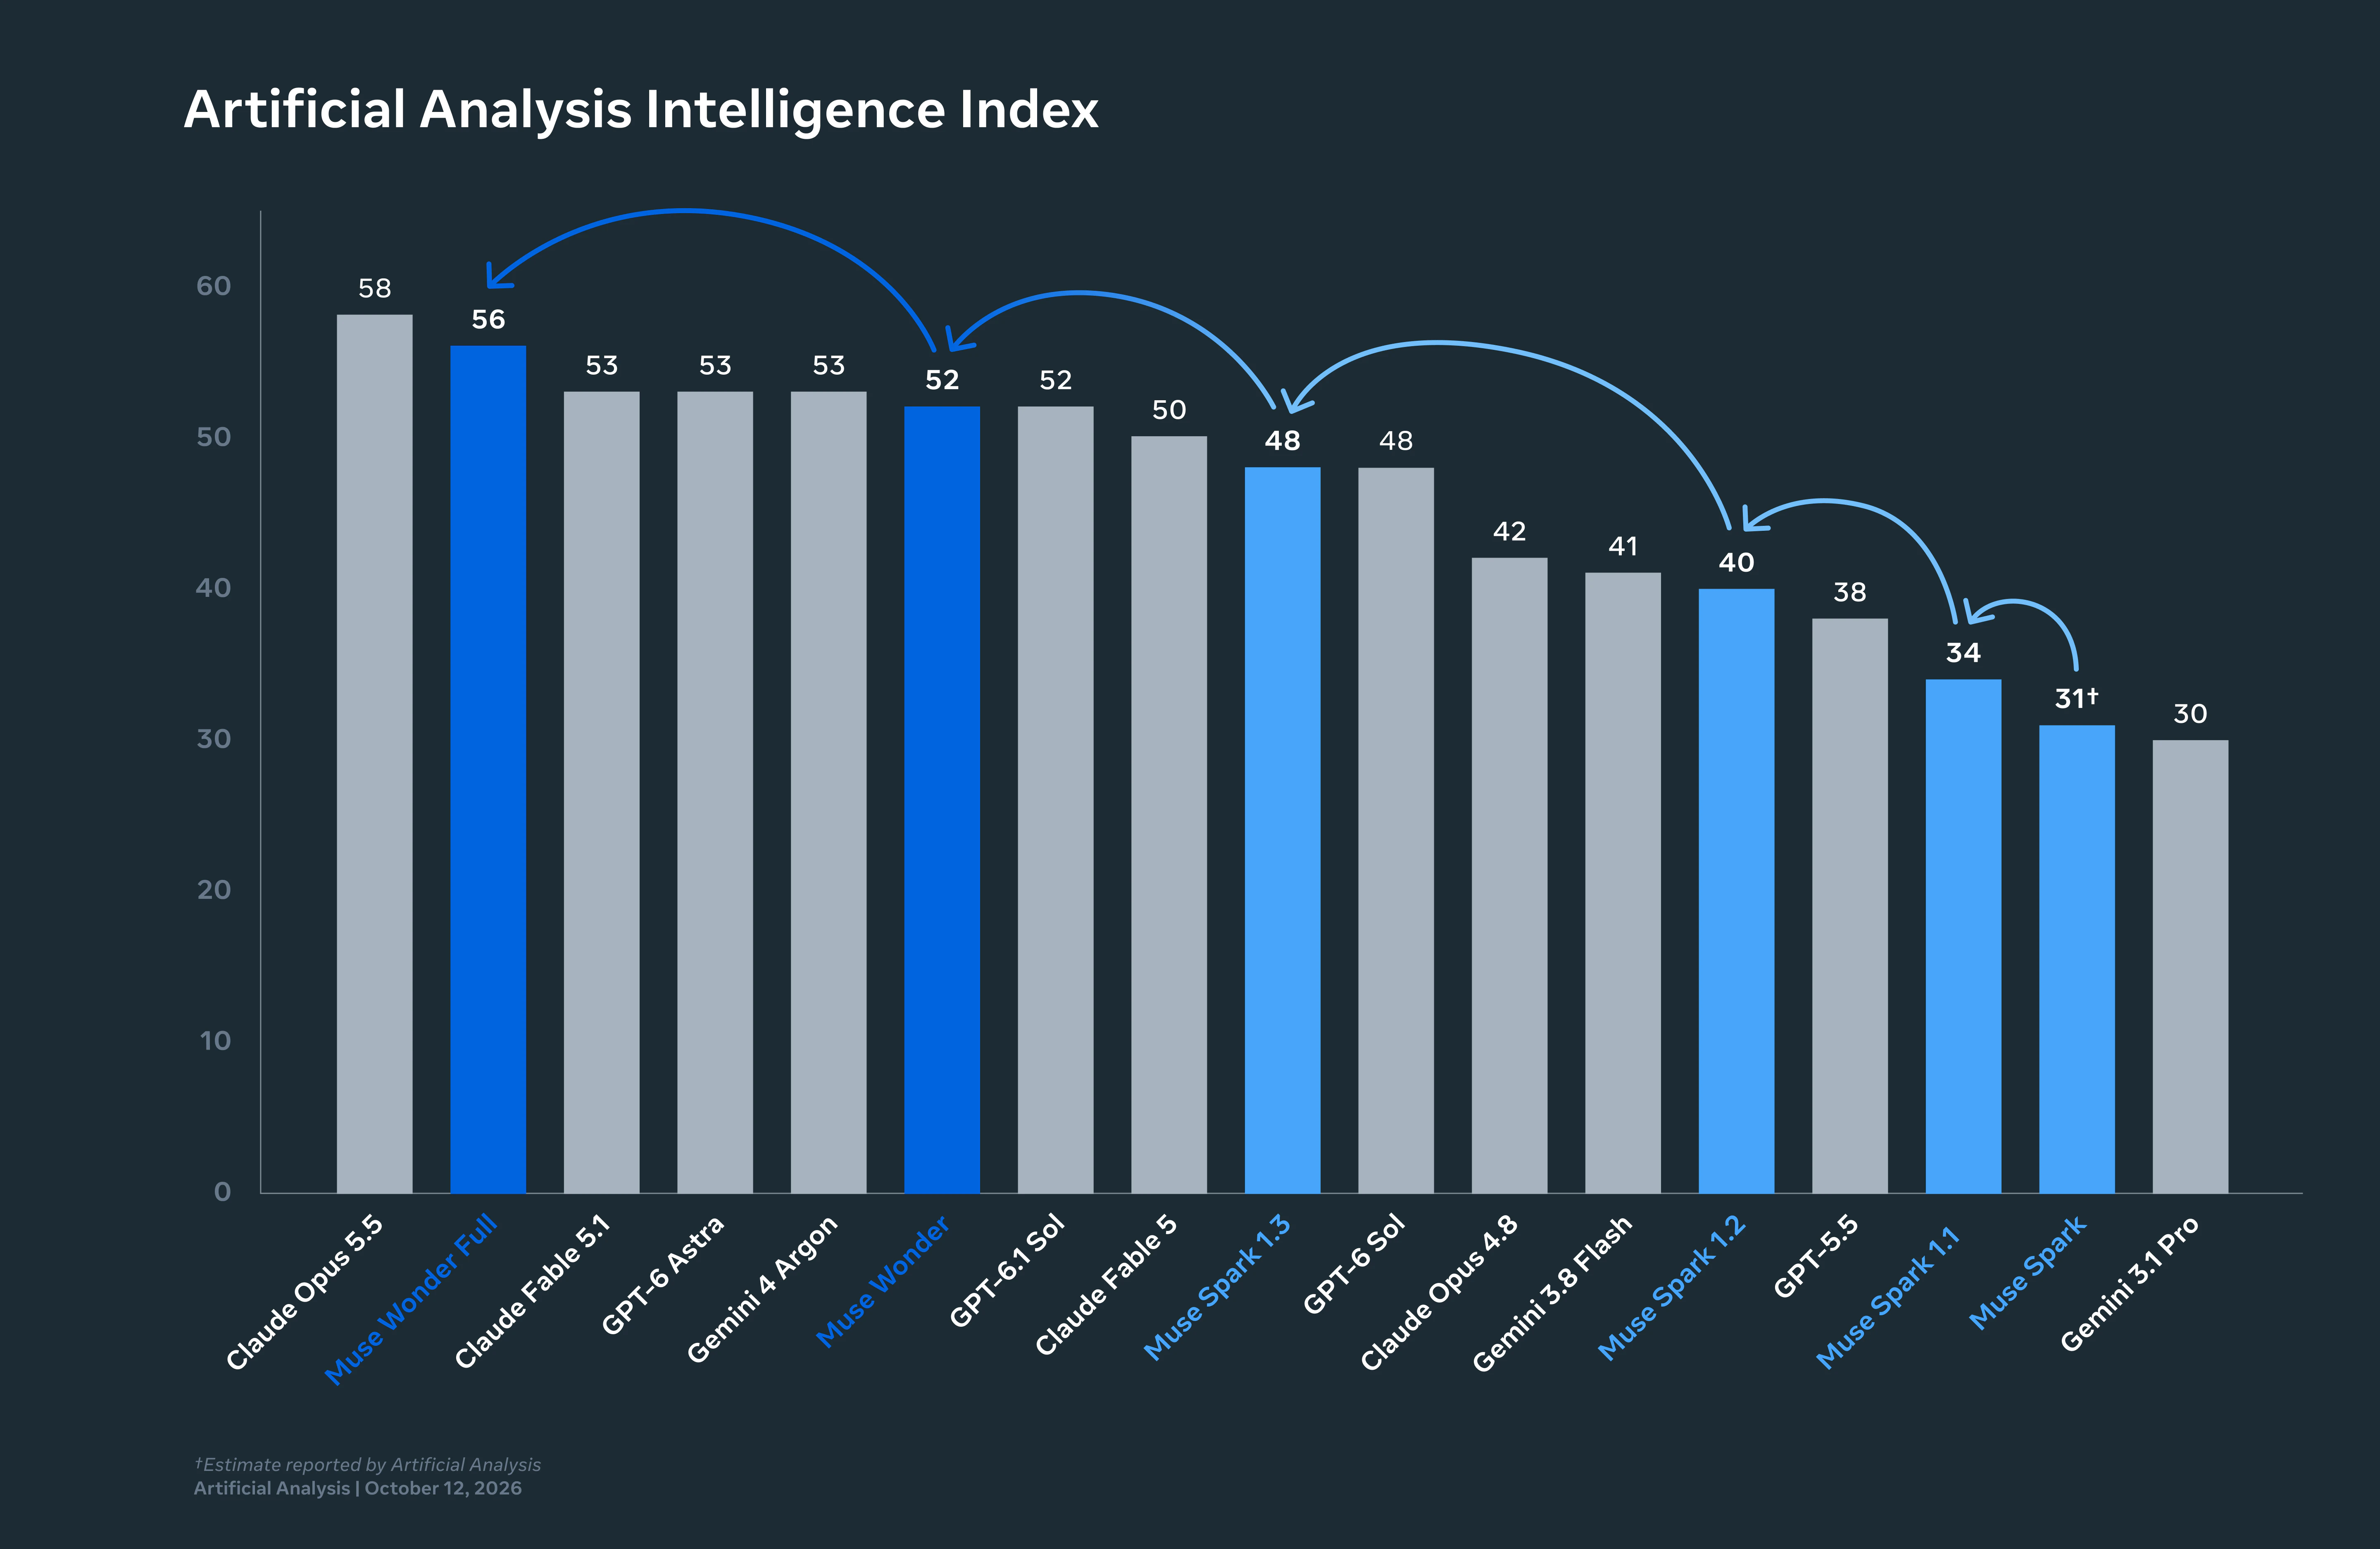
| Intelligence Index | 52 | 58 |
| Preis pro 1 Mio. In / Out | $4 / $20 | $4 / $20 |
Gleicher Preis, grundlegend anderes Profil. Daraus ergibt sich die Routing-Logik für eine Crew ganz von selbst:
- Weisen Sie Tasks dem Muse-Wonder-Agenten zu, wenn sie langwierig und mehrstufig sind und auf Hindernisse stoßen werden: dateiübergreifende Refactorings, Dependency-Migrationen mit fehlschlagenden Tests oder Fix-and-Verify-Schleifen bei unzuverlässigen Test-Suites.
- Belassen Sie Tasks bei Opus 5.5 oder Astra, wenn sie terminalintensiv sind, breites Faktenwissen voraussetzen oder den stärksten Reviewer erfordern. Der Artikel Welcher Agent übernimmt welche Task? erläutert die allgemeine Regel dazu.
Wählen Sie anschließend eine Task mit eindeutigen Akzeptanzkriterien, weisen Sie diese dem Muse-Wonder-Agenten zu und verschieben Sie sie aus dem Backlog in einen Status, der für die Bearbeitung bereit ist. Der Durchlauf durchläuft die Phasen „Queued“, „Dispatched“ und „Running“, während das Ausführungsprotokoll Tool-Aufrufe und Runtime-Ereignisse aufzeichnet. Hält der Agent an, um eine Rückfrage zu stellen, erscheint diese als Kommentar in der Task und wird in die Inbox weitergeleitet. Meta hat Wonder gezielt darauf trainiert, vor wichtigen Schritten rückzufragen – auf einem Board läuft diese Rückmeldung an genau der richtigen Stelle auf. Der Artikel Active Focus und die Review-Queue beschreibt, wie Sie damit am besten umgehen.
Was nicht funktioniert: Muse Wonder Full
Muse Wonder Full erzielt im Vergleich zu Wonders 52 Punkten einen Wert von 56 und liegt im Coding Agents Index mit 68 Punkten gleichauf mit Claude Code auf Sonnet 5.5. Das Modell ist jedoch exklusiv über Muse Code in den Tarifen „Power“ (50 $) und „Maximum“ (200 $) verfügbar. Da es über keine API-Modell-ID verfügt, lässt es sich weder über Codex noch über Claude Code ansteuern – und Muse Code ist keine Runtime, die der lokale Dienst von Sharkly automatisch erkennt. Sharkly bietet zwar eine benutzerdefinierte ACP-Runtime für Tools an, die von der Erkennung nicht erfasst werden, Metas Dokumentation schweigt sich jedoch darüber aus, ob Muse Code ACP unterstützt. Daher sollte dies als ungetestet eingestuft werden. Für ein Entwicklerteam bleibt Full somit ein Modell, das ein einzelner Entwickler lokal im Terminal bedient – nicht eines, das zentral über ein Board zugewiesen werden kann. Der Beitrag Muse Wonder Full im reinen Abomodell beleuchtet die genauen Konsequenzen.
Kosten und Datenschutz
Nichts davon erscheint auf der Rechnung von Sharkly. Die Modellnutzung wird direkt über den auf dem Computer hinterlegten Meta-API-Schlüssel zu Metas regulären Tarifen abgerechnet: 4 $ / 20 $ / 0,20 $ (gecached) pro Million Token, ohne Aufpreis für lange Kontexte und mit einem teamweiten Limit von 3.000 Anfragen sowie 4 Mio. Token pro Minute. Da bei langen Durchläufen der Kontext in jedem Schritt erneut übertragen wird, profitiert eine Muse-Wonder-Lane naturgemäß stark vom Prompt-Caching: Artificial Analysis ermittelte Kosten von 4,52 $ pro Task gegenüber 5,98 $ bei Opus 5.5 – hauptsächlich, weil Wonders Output günstiger ausfällt.
API-Traffic im Standard-Modus von Meta wird nicht für das Modelltraining verwendet. Das unterscheidet die API-Nutzung von Muse-Code-Abonnements, die standardmäßig im Contributor-Modus laufen. Da eine Runtime auf einem Computer auf die API zugreift, bleibt der Code Ihres Teams von Metas Trainingsdaten ausgeschlossen, ohne dass dafür erst Schalter umgelegt werden müssen.
Das Modell mag sich diese Woche geändert haben – Kontext, Fortschritt, Blocker, Ergebnisse und das menschliche Review blieben jedoch von der Anfrage bis zum Release lückenlos nachvollziehbar. Sie können diesen Ablauf manuell über Git-Worktrees abbilden oder Sharkly die Verwaltung des Workflows überlassen.


