
TL;DR: Das KI-Agenten-Team von OpenAI hat 5.034 Audit-Ziele im Linux-Kernel in 948 einzigartige Exploits zur lokalen Rechteausweitung verwandelt – für API-Guthaben im Wert von rund 1,2 Millionen US-Dollar. Anschließend überprüften menschliche Sicherheitsforscher die Ergebnisse. Dieses Vorgehen lässt sich auf Ihre eigenen Codebases übertragen: Agenten erkunden erreichbare Angriffsflächen, analysieren sie, weisen jeden Fund isoliert nach und entwerfen einen Fix – die finale Freigabe erfolgt durch den Menschen.
Am 4. November 2026 veröffentlichte OpenAI den Artikel „A thousand fewer paths to root“. Die Schlagzeile lautet 948 Linux-Exploits. Die eigentliche Lektion für Software-Teams liegt jedoch darunter: Dieses Ergebnis wurde durch spezialisierte Agenten erzielt, die stufenweise arbeiteten, Belege an die jeweils nächste Stufe weiterreichten und am Ende von einem Menschen begleitet wurden.
Diese Architektur setzt kein spezifisches Kernel-Fachwissen voraus; Sie können dieselbe Struktur also auf Ihre eigenen Dienste anwenden. Die Dringlichkeit ist real: OpenAI betont, dass die Pipeline im Vergleich zu öffentlichen Bug-Bounty-Prämien „unterm Strich profitabel“ war. Angreifer können dieselbe Rechnung aufstellen – fangen Sie also noch heute an.
Was das KI-Agenten-Team von OpenAI herausgefunden hat
OpenAI ließ die Pipeline Mitte Oktober 2026 auf dem neuesten Linux-Kernel laufen und setzte dabei ein künftiges Cyber-Modell ein. Als Ziele dienten isolierte VMs mit einem standardmäßigen Desktop-Betriebssystem und aktivierten Standardschutzmechanismen.
| Phase | Ergebnis | API-Kosten |
|---|---|---|
| Scout | 5.034 Audit-Ziele, ca. 2,8 Mio. Zeilen, rund 7 % des Kernels | $3,426 |
| Analyze | 2.308 potenzielle Funde | $316,549 |
| Validate | 1.724 reproduziert (ca. 74,7 %) | $73,330 |
| Assess exploitability | 948 einzigartige LPE-Exploits, 291 PoCs für Informationslecks | $820,123 |
| Gesamt | $1,213,430 |
Dies sind OpenAIs Zahlen auf Kernel-Ebene und keine Kostenschätzung für Ihr eigenes Repository. OpenAI bezeichnet seine Kosten als „eher eine Obergrenze“, da die Leistungsfähigkeit und nicht die Effizienz gemessen wurde.
Drei Einschränkungen sollten Sie dabei beachten:
- Es handelt sich um Sicherheitslücken zur lokalen Rechteausweitung (Local Privilege Escalation, LPE). Ein Angreifer benötigt zunächst lokalen Zugriff auf das System. Es sind für sich genommen keine Remote-Exploits.
- Viele davon sind noch nicht behoben. Nach Abschluss des zehntägigen Scans und der anschließenden Analyse waren 61 LPEs upstream gepatcht, 43 befanden sich als Patches im Staging und 299 wurden öffentlich diskutiert. OpenAI hat Hunderte von Berichten und Patches für kritische Sicherheitslücken eingereicht und übermittelt den Rest schrittweise gemeinsam mit Partnern der Initiative Patch the Planet.
- Im Beitrag von OpenAI wird nicht beschrieben, dass diese Sicherheitslücken in freier Wildbahn ausgenutzt wurden.
Die Einschätzung von OpenAI ist dennoch unmissverständlich: Auf einem Betriebssystem ohne die neuesten Patches sollte ein Benutzerkonto mit geringen Rechten für einen gut ausgestatteten Angreifer „faktisch als gleichwertig mit Root-Zugriff betrachtet werden“. Schließen Sie Sicherheitslücken daher zeitnah und begrenzen Sie den Explosionsradius durch Isolationstechnologien wie Firecracker und gVisor.
Die fünf Phasen eines Sicherheits-Workflows mit KI-Agenten
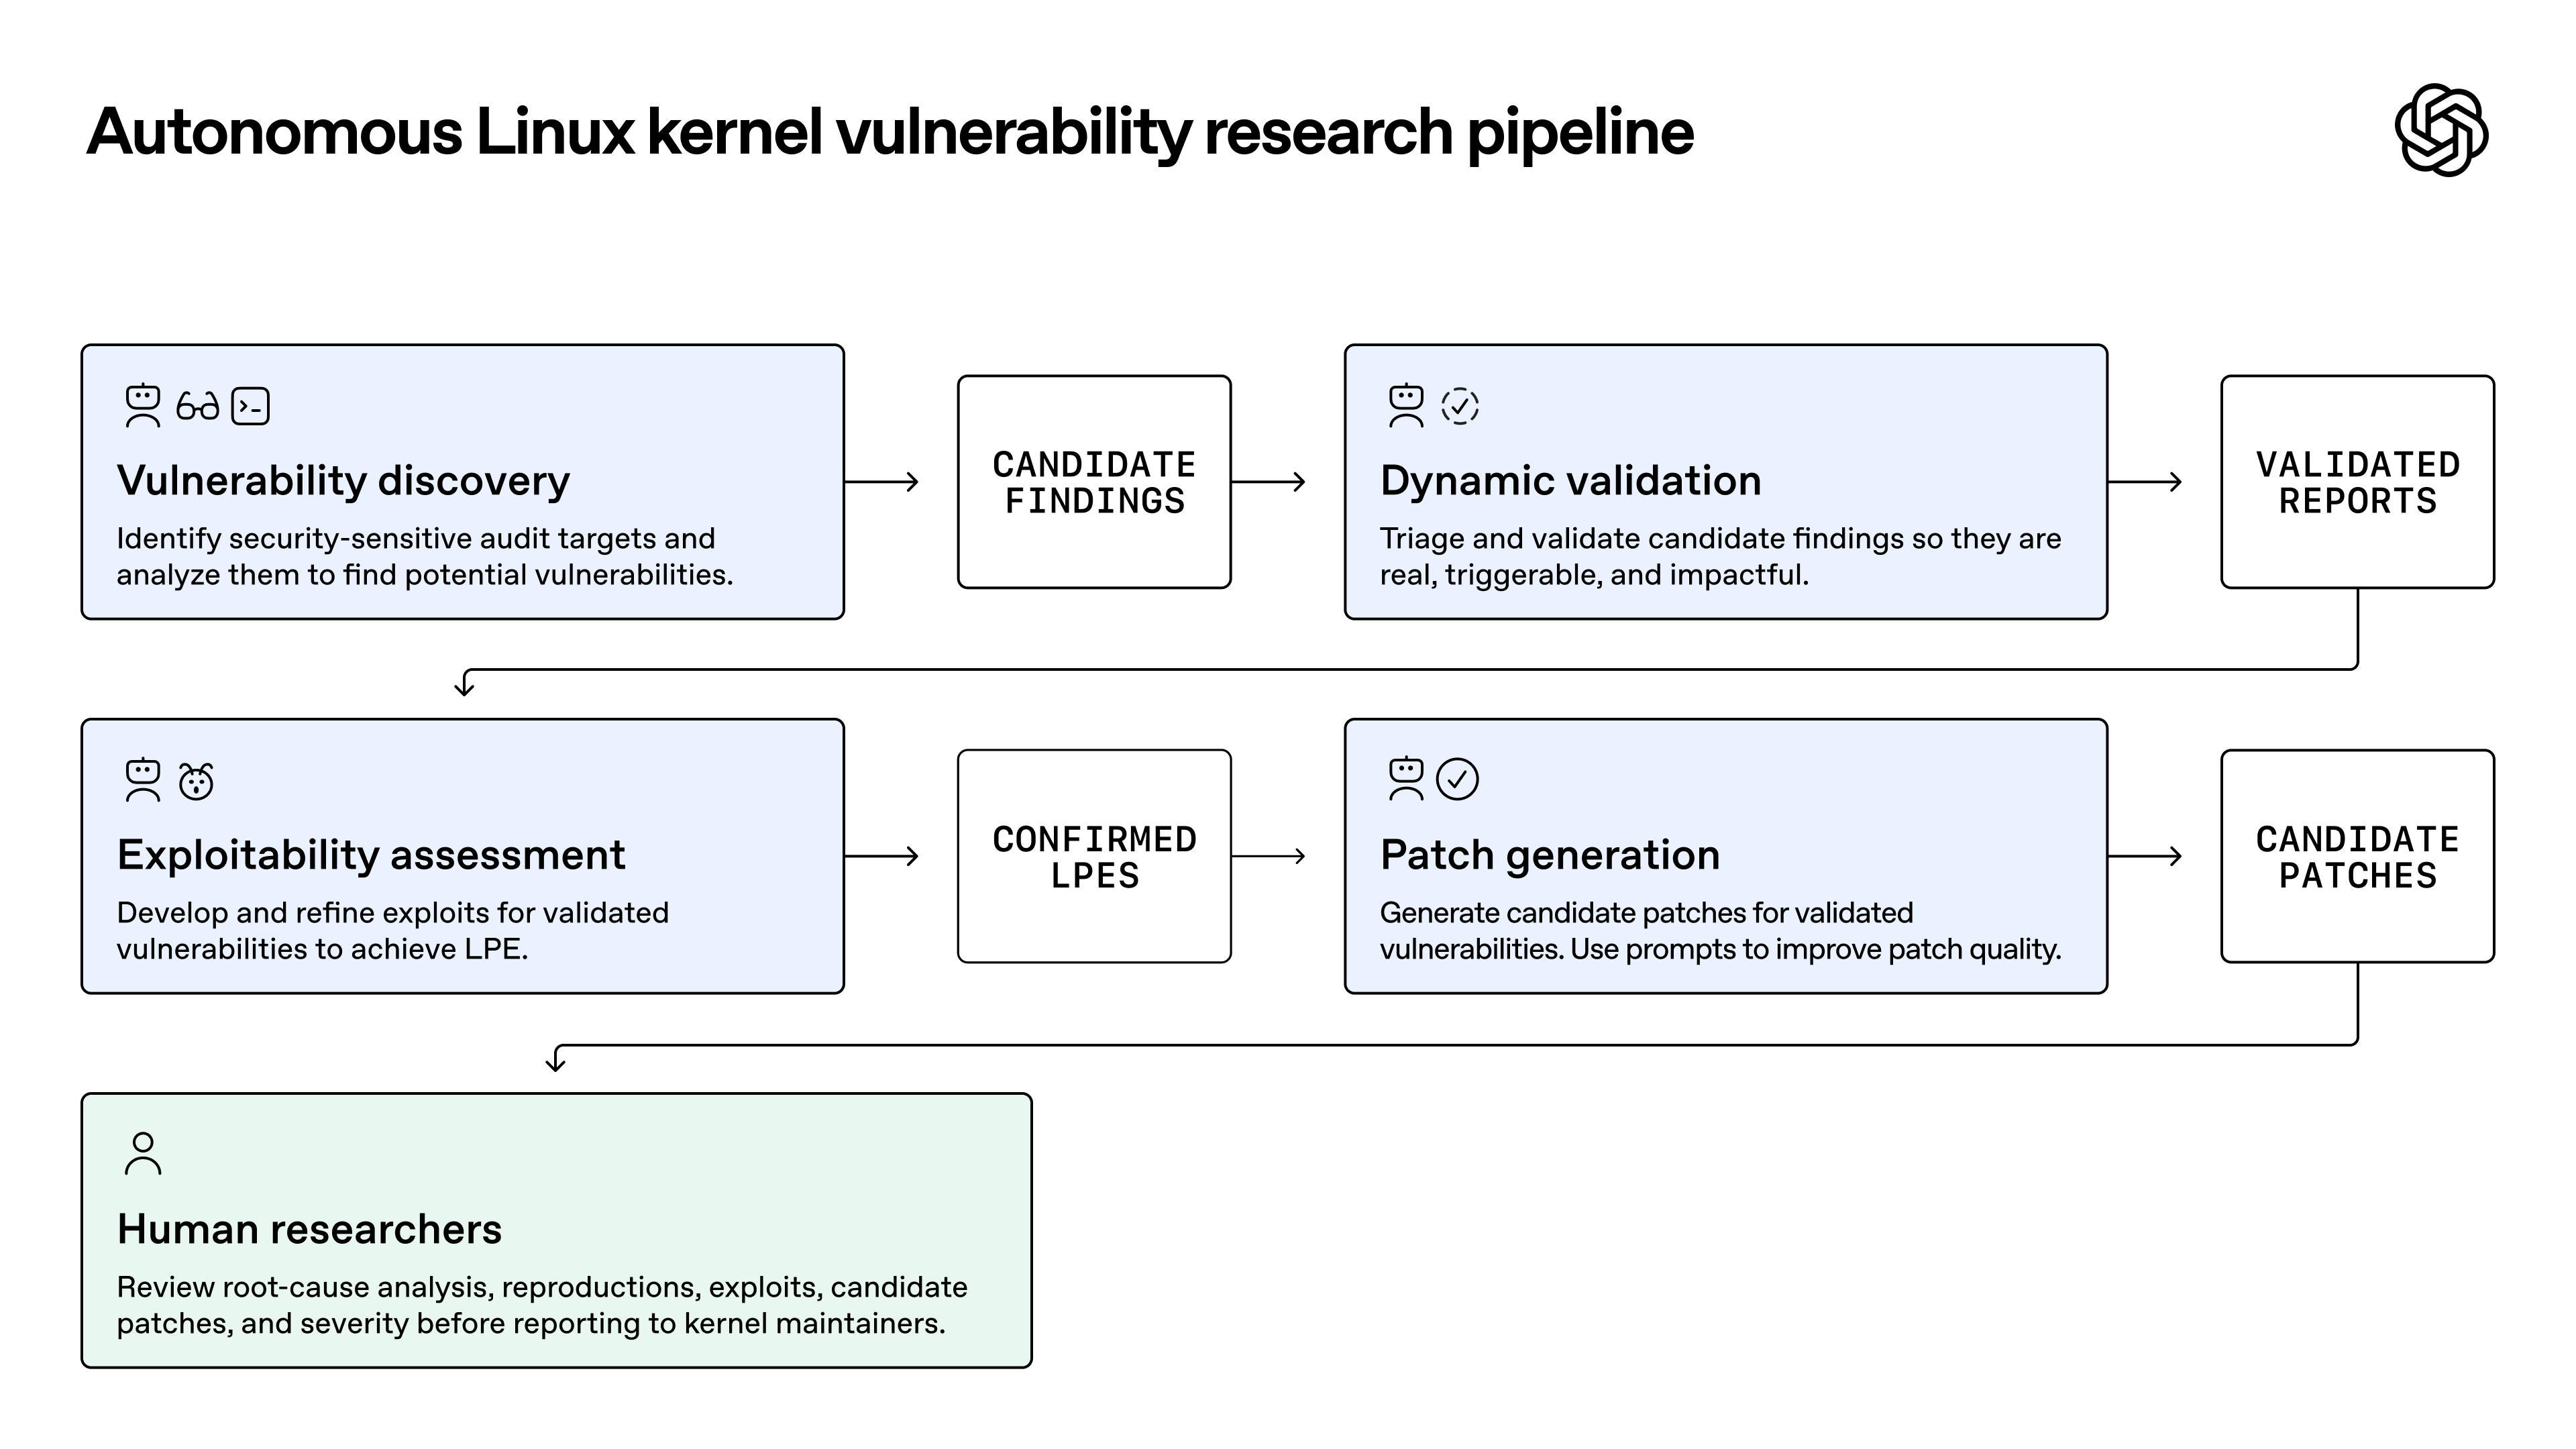
Ein Sicherheits-Workflow mit KI-Agenten unterteilt das Review in aufeinanderfolgende Phasen. Jede Phase grenzt die Aufgaben weiter ein und liefert Belege für die nächste. Die Variante von OpenAI besteht aus fünf Schritten:
- Erkundung (Discovery). Scout-Agenten wählen Audit-Ziele nach Erreichbarkeit und Sicherheitsrelevanz aus. Analyst-Agenten prüfen jedes Ziel, erstellen ein Bedrohungsmodell und melden potenzielle Funde.
- Dynamische Validierung. Triage-Agenten schreiben einen Proof of Concept und führen ihn in einer isolierten VM mit KASAN aus – einem Tool zur Erkennung von Speicherfehlern im Kernel. Sie verfeinern den PoC so lange, bis sich der Fehler reproduzieren lässt oder alle Möglichkeiten ausgeschöpft sind.
- Bewertung der Ausnutzbarkeit. Ein Screening-Agent filtert Funde ohne plausiblen Angriffspfad heraus. ExploitDev-Agenten testen die verbleibenden.
- Patch-Erstellung. Agenten entwerfen für jeden bestätigten Fehler einen Patch, der die lokalen Code-Konventionen einhält, und suchen nach ähnlichen Varianten.
- Menschliches Review. Sicherheitsforscher überprüfen Exploit, Patch und Schweregrad, bevor irgendetwas an die Maintainer übermittelt wird.
Bei jeder Übergabe werden Belege statt bloßer Vermutungen weitergereicht, sodass der Mensch am Ende auf Basis von Fakten entscheidet.
So übertragen Sie jede Phase auf Ihr eigenes Repository
Wenden Sie diesen Workflow ausschließlich auf Code an, der Ihnen gehört oder für dessen Überprüfung Sie autorisiert sind. Verzichten Sie bei Ihrem eigenen Repository komplett auf die Phase zur Exploit-Erstellung. Ein fehlschlagender Test belegt einen Fehler vollkommen ausreichend, ohne dass ein Angriffswerkzeug gebaut werden muss.
| OpenAI-Phase | Ihre Version | Ergebnis |
|---|---|---|
| Scout | Einstiegspunkte auflisten, die für anonyme oder gering berechtigte Benutzer erreichbar sind: Routen, Webhooks, Uploads, Parser, Queue-Consumer | Audit-Liste |
| Analyst | Ein Ziel pro Durchlauf: Code lesen, kurzes Bedrohungsmodell verfassen, mutmaßliche Schwachstellen melden | Potenzielle Funde |
| Validate | Minimalen fehlschlagenden Test in einer temporären Umgebung schreiben | Test plus Log |
| Assess | Auswirkungen anhand der überschrittenen Vertrauensgrenze bewerten | Schweregrad mit Begründung |
| Patch | Fix als Pull Request inklusive Test entwerfen | Pull Request |
| Human | Prüfen, anschließend mergen oder ablehnen | Gemergter Fix oder geschlossener Fund |
Eine präzise Eingrenzung des Scopes zahlt sich aus: OpenAIs Scouts kosteten 3.426 US-Dollar und reduzierten das Audit auf etwa 7 % des Kernels. Beginnen Sie mit einem einzelnen Dienst und dessen öffentlichen Einstiegspunkten. Eine Aufgabe für einen einzelnen Fund kann so kompakt sein:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Überprüfen Sie den Pfad, nicht nur das Ergebnis
In einem frühen Durchlauf meldete OpenAIs Exploit-Phase 200 Erfolge. Bei der manuellen Überprüfung stellte sich jedoch heraus, dass 20 davon Root-Rechte über einen völlig anderen Zero-Day-Exploit als den zugewiesenen erlangt hatten. Die Pipeline wertete das Ergebnis als Erfolg – doch das Ergebnis war aus dem falschen Grund eingetreten.
OpenAI verschärfte daraufhin die Aufgabenbeschränkungen und führte eine unabhängige Prüfung ein, um sicherzustellen, dass jeder Exploit auch tatsächlich die ihm zugewiesene Schwachstelle ausnutzte. Die Erkenntnis daraus: Überprüfen Sie stets sowohl den Pfad zum Ergebnis als auch das Ergebnis selbst.
Das entsprechende Szenario in Ihrem Alltag ist vertraut: Ein Agent behauptet, sein Test beweise die Authentifizierungsschwachstelle – doch in Wirklichkeit schlägt der Test lediglich wegen einer fehlenden Test-Fixture fehl. Fügen Sie einen Check-Agenten hinzu, der den Test nicht selbst geschrieben hat, und stellen Sie ihm eine einzige Frage: Geht dieser Fehler wirklich auf den gemeldeten Codepfad zurück?
Frühzeitig validieren – Fehlalarme kosten genauso viel
OpenAI stellte fest, dass der Validierungsversuch eines echten Treffers und eines False Positives ungefähr gleich viel kostet. Jeder ungeeignete Kandidat, der die Validierungsphase erreicht, verschlingt somit einen kompletten Durchlauf.
Filtern Sie, bevor Sie validieren. OpenAI validierte Funde, die für einen Benutzer mit geringen Rechten erreichbar waren, keine besonderen Berechtigungen erforderten und messbare Belege lieferten. Definieren Sie gleichwertige Kontrollpunkte (Gates) für Ihren Code, etwa „ohne Administratorrolle erreichbar“. Funde, die diese Kriterien nicht erfüllen, werden mit einer Begründung geschlossen.
Gleichen Sie Funde anschließend noch einmal mit dem neuesten Code ab, bevor Sie sie melden, wie OpenAI empfiehlt, um doppelte oder veraltete Berichte zu vermeiden.
Legen Sie eine Abbruchbedingung vor dem Start fest
Fehlgeschlagene Versuche waren die kostspieligsten: Bei den LPE-Kandidaten schlugen 69 Fehlversuche mit durchschnittlich 3.922 US-Dollar zu Buche, während 1.169 erfolgreiche Versuche im Schnitt nur 360 US-Dollar kosteten. Nach unserer Rechnung machten rund 6 % der Versuche etwa 39 % der 691.000 US-Dollar aus, die in dieser Phase ausgegeben wurden.
Der Lösungsvorschlag von OpenAI ist eine klare Abbruchbedingung – beispielsweise das Beenden der Aufgabe nach einer Stunde ohne Fortschritt. Verankern Sie diese Regel in der Aufgabenbeschreibung und sichern Sie sie mit einem strikten Ausführungslimit (Hard Limit) ab.
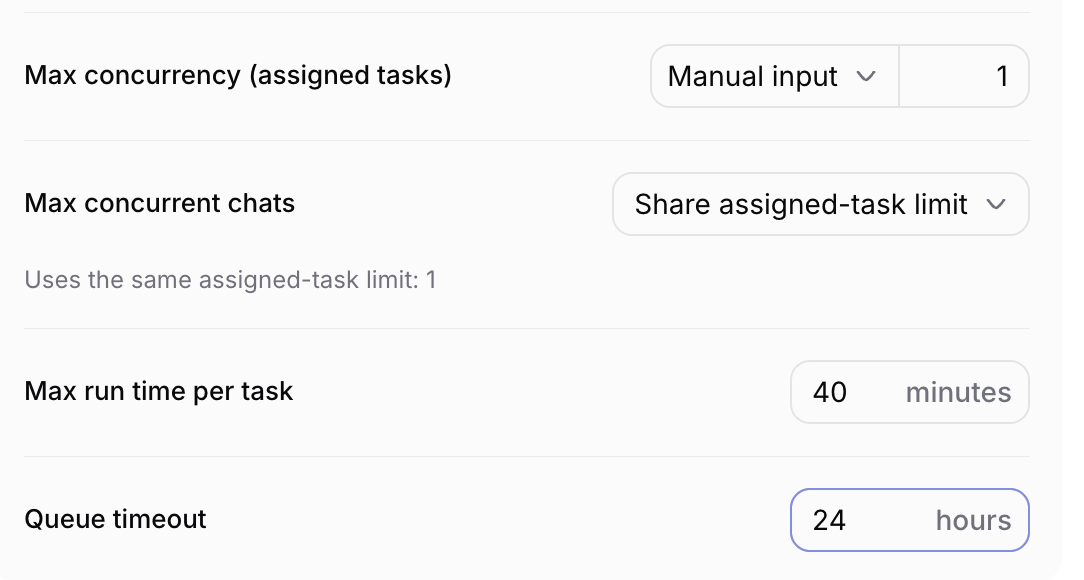
In Sharkly befindet sich das Timeout pro Aufgabe in den Run settings eines Agenten. Es handelt sich dabei um ein reines Zeitlimit und nicht um eine Fortschrittserkennung – behalten Sie daher die Regel „Abbruch bei fehlenden neuen Belegen“ in den Anweisungen bei.
Halten Sie die Orchestrierung schlank, während Modelle besser werden
OpenAI entwickelte für GPT-5.5 Cyber einen Layer mit 103 Exploit-Techniken, was die Erfolgsquote von 76,2 % auf 88,9 % steigerte. Bei GPT-5.6 Cyber brachte derselbe Layer jedoch nur noch ein Plus von 1,5 Prozentpunkten, weshalb OpenAI ihn wieder entfernte.
Testen Sie Ihr eigenes Scaffolding jedes Mal neu, wenn Sie ein Modell wechseln. Führen Sie auch erneute Scans durch: Der Durchlauf im Oktober fand mehr als fünfmal so viele neuartige LPEs wie ein Durchlauf im Juli mit GPT-5.6 Sol – und das bei Code, der drei zusätzliche Monate lang gehärtet worden war.
Menschliches Review beibehalten, bevor etwas ausgeliefert wird
Agenten entwerfen Fixes als Pull Requests – der Merge erfolgt durch einen Menschen. OpenAI stellte fest, dass Patches im ersten Durchlauf oft umfangreicher als nötig ausfielen, Varianten übersahen oder Konventionen verletzten, und dass weitere Durchläufe deren Qualität deutlich verbesserten.
Zudem wird empfohlen, Modelle für ein adversariales Review sowohl von menschlichen als auch von KI-generierten Patches einzusetzen. Lassen Sie also einen Agenten versuchen, den Fix zu umgehen, und überlassen Sie die Entscheidung anschließend einem Menschen. Falls Code-Reviews bei Ihnen schon jetzt den Flaschenhals bilden, lesen Sie wie Sie Reviews für parallele Agenten gestalten, bevor Sie eine Flut neuer Pull Requests erzeugen.
So bilden Sie den Workflow als Tasks in Sharkly ab
Ein Task ist die zentrale Arbeitseinheit in Sharkly. Hier ist eine Möglichkeit, diesen Workflow aufzubauen:
- Erstellen Sie einen Task-Typ. Ein Task-Typ besitzt einen Workflow aus geordneten Statuswerten. Ein Typ namens „Security finding“ könnte die Schritte Candidate, Reproduced, Patch drafted, In review, Closed durchlaufen.
- Erstellen Sie eine Crew. Eine Crew ist eine wiederverwendbare Gruppe aus Personen und Agenten, die von einem leitenden Agenten koordiniert wird. Fügen Sie Scout-, Analyst-, Check- und Patch-Agenten hinzu. Der leitende Agent startet zuerst und weist Mitgliedern gezielt Aufgaben zu.
- Isolieren Sie die Durchläufe. Nutzen Sie ein temporäres Verzeichnis, damit jeder Task seinen eigenen Worktree erhält, und lesen Sie unseren Leitfaden zu isolierten Worktrees, wenn Sie Aufgaben parallel verteilen möchten. Deaktivieren Sie das gemeinsame Verzeichnis der Crew dort, wo der Check-Agent Unabhängigkeit benötigt.
- Automatisieren Sie die Übergaben. Eine Automation mit einem Trigger für den Task-Status kann den Patch-Agenten starten, sobald ein Task den Status Reproduced erreicht. Diese Durchläufe laufen unbeaufsichtigt ab und können keine Rückfragen stellen; zudem erfolgt der Statusabgleich organisationsweit – sorgen Sie also dafür, dass die Anweisungen den auslösenden Task validieren.
- Verknüpfen Sie die Pull Requests. Über die GitHub-Integration wird der Pull Request anhand einer Task-ID im Branch, Titel oder in der Beschreibung automatisch verknüpft. Das Mergen ändert den Task-Status nicht, sodass der Reviewer den Task manuell schließt.
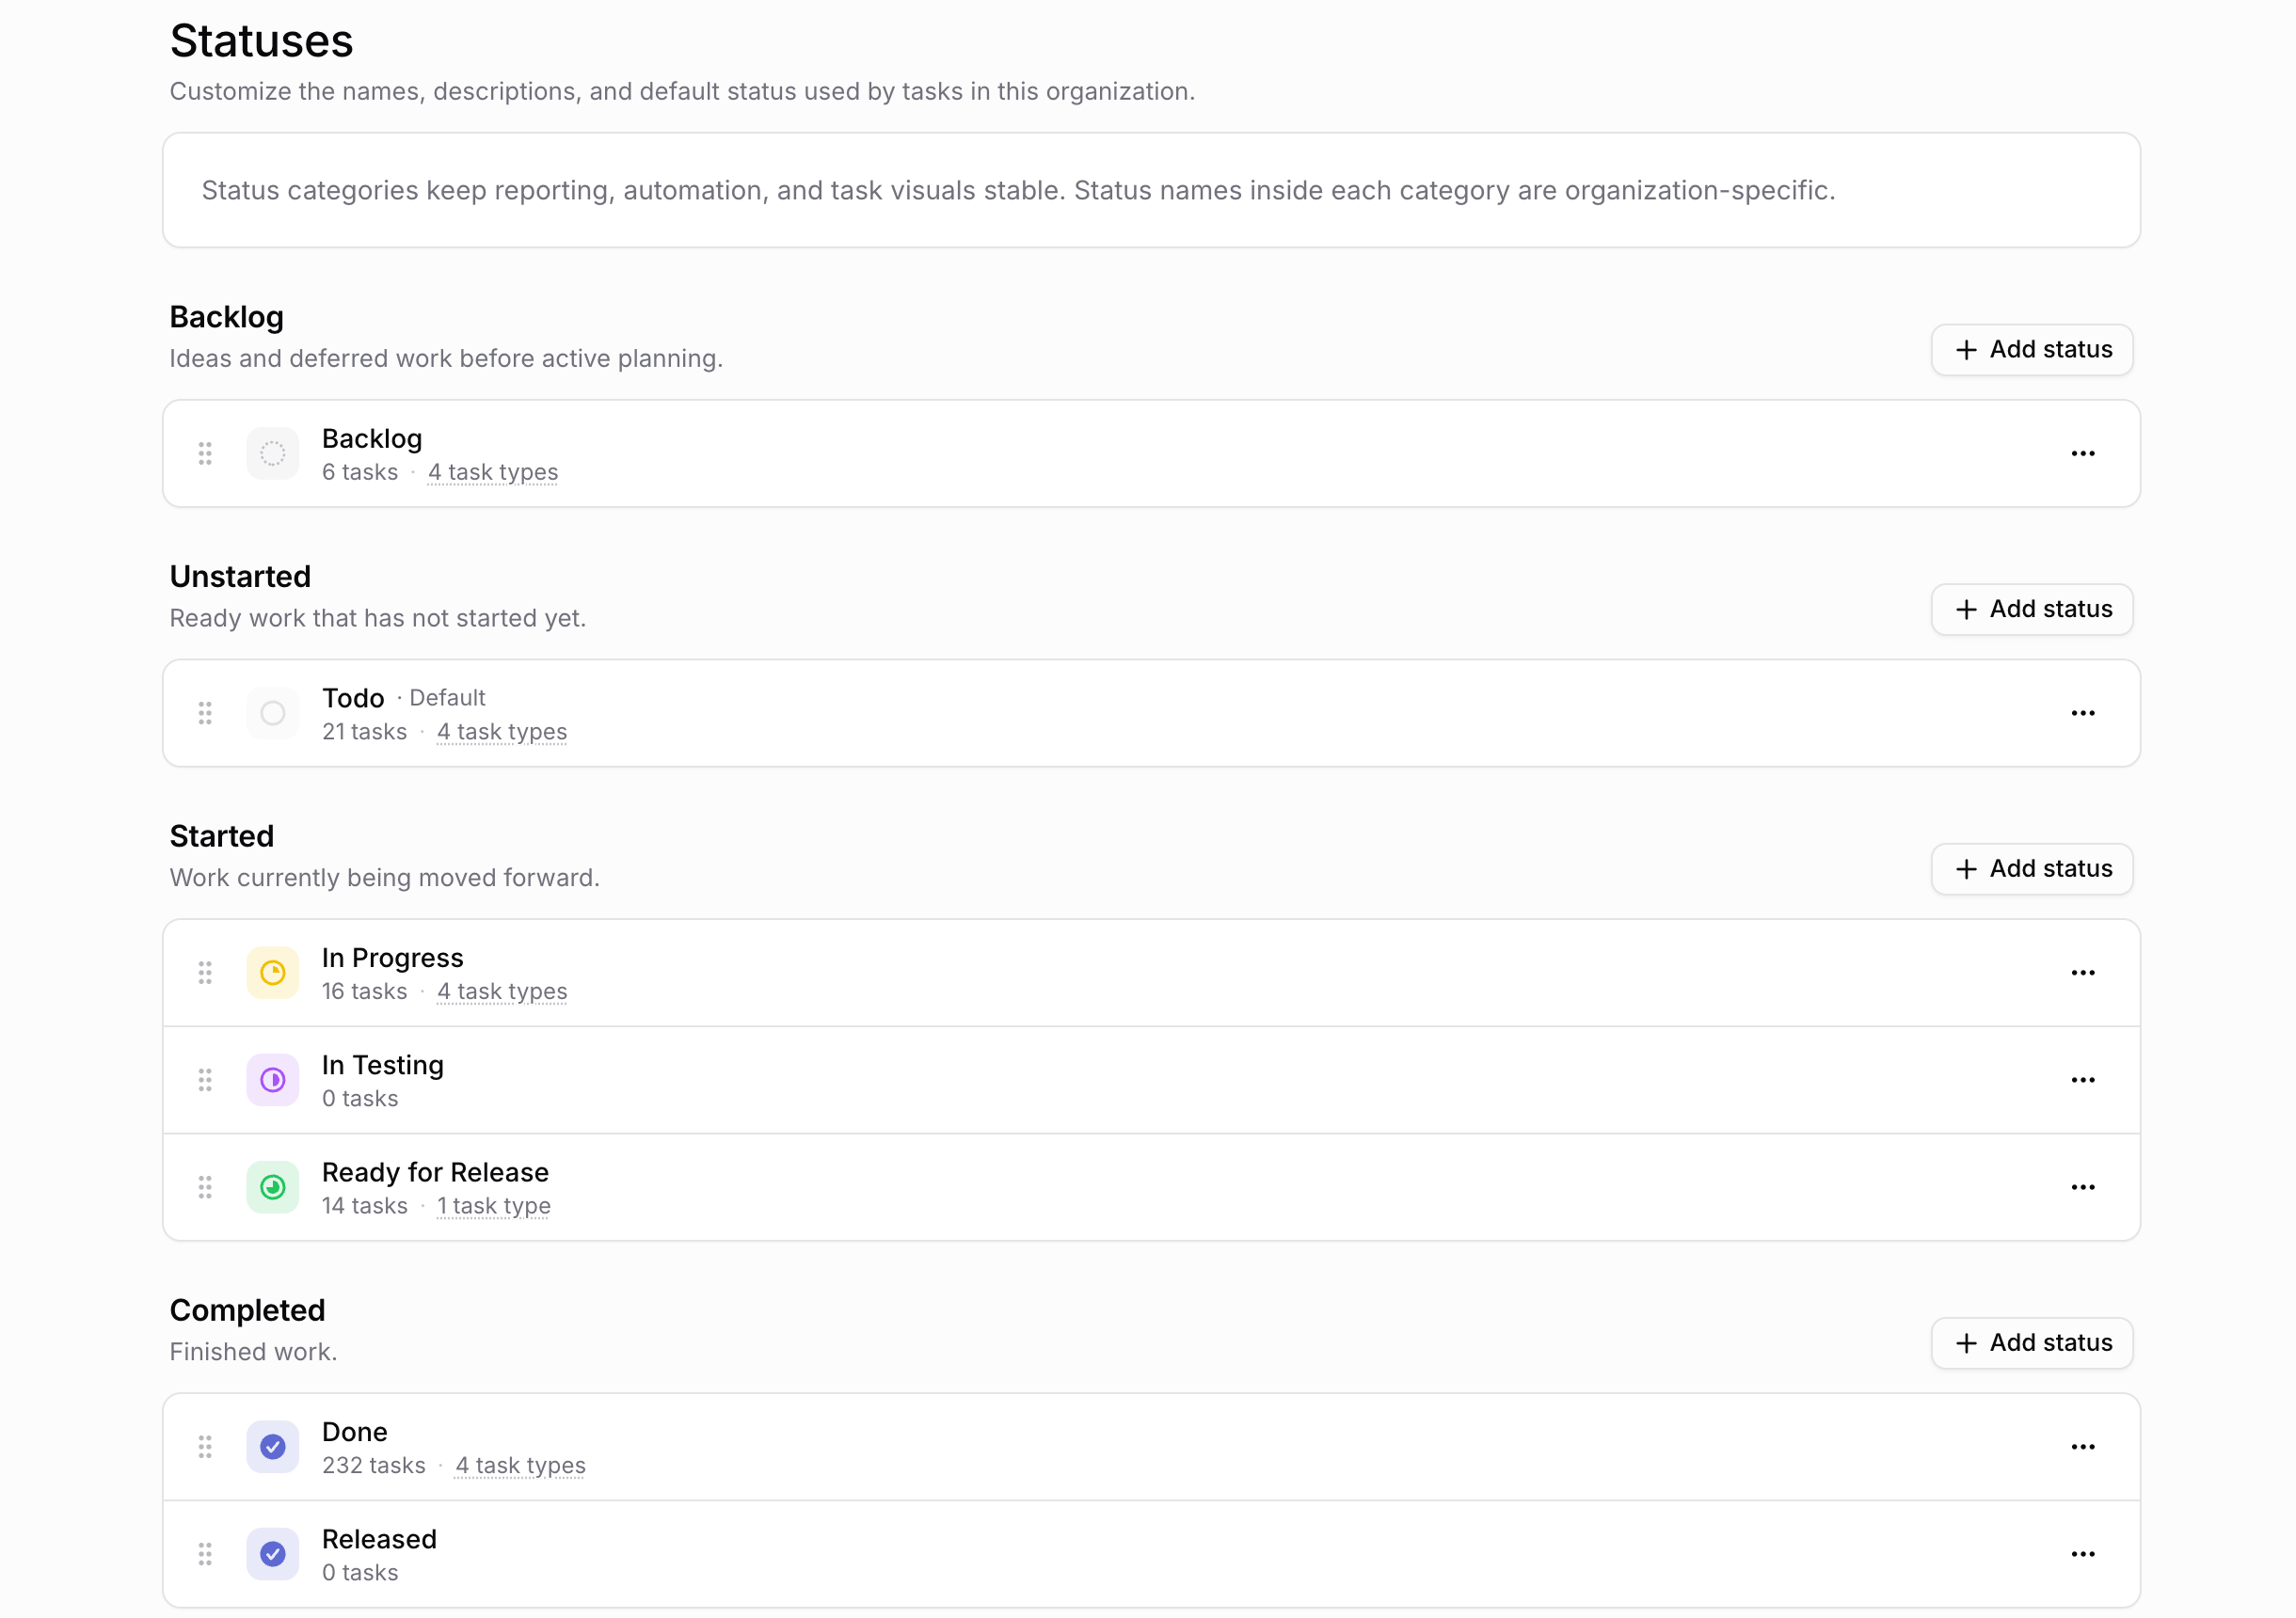
Statuswerte werden organisationsweit geteilt; legen Sie für diesen Workflow daher neue an, anstatt bestehende umzubenennen.
Eine Grenze ist hierbei entscheidend: Ein Worktree verhindert zwar Konflikte zwischen Tasks, stellt jedoch keine Sicherheits-Sandbox dar. Führen Sie Reproduktionstests in einem Wegwerf-Container oder einer temporären VM ohne Produktions-Secrets aus und gewähren Sie Agenten nur die minimal erforderlichen Git-Berechtigungen.
Sharkly koordiniert diese Arbeit. Claude Code, Codex und ähnliche Tools übernehmen die eigentliche Ausführung, wobei die Modellnutzung über die in diesen Tools hinterlegten Abonnements oder API-Schlüssel abgerechnet wird. Wenn Sie den Ansatz skalieren möchten, erfahren Sie hier, wie Sie 10 KI-Coding-Agenten gleichzeitig betreiben.
Bei einem kleinen Repository können Sie einfach einen einzelnen Agenten einem Task zuweisen und auf eine Crew verzichten. Nutzen Sie eine Crew dann, wenn ein Leader mehrere Rollen sequenzieren und die Ergebnisse in einem einzigen Task zusammenführen muss.
Fazit
Das Ergebnis von OpenAI ist eine Blaupause für Ihr Team: Grenzen Sie den Scope ein, fordern Sie bei jeder Übergabe Belege ein, prüfen Sie den Lösungspfad, brechen Sie erfolglose Durchläufe frühzeitig ab und lassen Sie die finale Entscheidung beim Merge stets bei einem Menschen.
Beginnen Sie noch diese Woche: Wählen Sie einen Ihrer Dienste aus, listen Sie dessen öffentliche Einstiegspunkte auf und erstellen Sie pro vermuteter Schwachstelle einen Validierungs-Task. Mit dem Quickstart von Sharkly bringen Sie Ihren ersten Agenten auf einem angebundenen Rechner zum Laufen, und auf sharkly.ai erfahren Sie, wie sich die Task- und Review-Ebene nahtlos um Ihre Agenten legt.
FAQ
Haben die Agenten von OpenAI produktive Linux-Systeme angegriffen?
Nein. Die Exploits liefen in isolierten VMs innerhalb einer kontrollierten Forschungsumgebung, und menschliche Sicherheitsforscher überprüften die Ergebnisse, bevor sie gemeldet wurden.
Sind alle 948 Linux-Sicherheitslücken behoben?
Nein. Viele davon werden derzeit noch gemeldet und gepatcht. Am Ende des zehntägigen Scans waren 61 LPEs upstream gepatcht und für 43 lagen Staging-Patches vor.
Können diese Exploits einen Server aus der Ferne kompromittieren?
Nicht von sich aus. Es handelt sich um Sicherheitslücken zur lokalen Rechteausweitung; ein Angreifer benötigt daher zunächst lokalen Zugriff auf das System. Halten Sie Systeme stets gepatcht und isolieren Sie nicht vertrauenswürdige Workloads.
Was würde dieser Workflow für mein Repository kosten?
Die Zahlen von OpenAI lassen sich nicht eins zu eins übertragen, da sie einen Durchlauf auf Kernel-Ebene abbilden. Fangen Sie mit einem einzelnen Dienst an, setzen Sie Ausführungslimits und messen Sie die Kosten pro validiertem Fund.
Benötige ich das Cyber-Modell von OpenAI?
Das ist derzeit noch gar nicht möglich, da OpenAI das Modell als künftige Veröffentlichung ankündigt. Die Phasen sind jedoch modellunabhängig: Testen Sie den Workflow mit den Coding-Agenten, die Ihr Team bereits im Einsatz hat, und beurteilen Sie die Ergebnisse anhand der gelieferten Belege.


