
Die meisten Teams, die mehrere Coding-Agents betreiben, setzen irgendwann eine monatliche Obergrenze für ihre Modellausgaben – meistens nach einer schlechten Woche. Man wählt eine Zahl, begrenzt die Parallelität, bis die Rechnung darunter bleibt, und schaut im nächsten Quartal wieder vorbei. Am 22.09.2026 hörte diese Zahl still und leise auf, das zu bedeuten, was sie einst bedeutete.
OpenAI hat GPT-6 Sol zu 2 Dollar pro Million Input-Tokens und 10 Dollar pro Million Output-Tokens veröffentlicht, API-ID gpt-6-sol, und dazu etwas deutlich Nützlicheres als einen Token-Preis publiziert: die Kosten pro Aufgabe. Auf AutomationBench 1.0.6 erzielt Sol mit extrahohem Reasoning-Aufwand 33,2 % bei 0,27 Dollar pro Aufgabe. Claude Opus 5 mit maximalem Aufwand kommt auf 26,9 % bei den 11,1-fachen Kosten pro Aufgabe von Sol auf derselben Testumgebung.
Rechnen Sie also erst einmal aus, was Ihre Obergrenze heute schon kauft, bevor Sie sie anheben. Für die meisten Teams lautet die Antwort: mehr fertiggestellte Runs, als irgendjemand lesen kann. Das heißt, die Obergrenze hat nie das Budget geschützt. Sie hat Ihre Reviewer geschützt – ganz nebenbei – und genau das hört jetzt auf.
TL;DR
Die Kosten pro akzeptierter Änderung geben an, was Ihr Team für Modell-Inferenz ausgibt, und zwar für jeden Diff, den ein Mensch tatsächlich liest und akzeptiert. Es ist die einzige Agent-Kostengröße, die sich auf tatsächlich ausgelieferte Arbeit bezieht. Zu den veröffentlichten Preisen kostet der gesamte monatlich reviewbare Durchsatz eines Teams mit vier Reviewern etwa 136 Dollar an GPT-6 Sol. Der limitierende Faktor hat sich von der Rechnung auf den Akzeptanzschritt verschoben, und keine Modellveröffentlichung ändert daran etwas. Agents recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und akzeptieren das Ergebnis.
Die Zahlen, die OpenAI tatsächlich veröffentlicht hat
OpenAI nennt den Score gemeinsam mit den Kosten pro Aufgabe – ungewöhnlich ehrlich und deutlich nützlicher als eine reine Preisliste.
| Modell, auf dem von OpenAI verwendeten Effort-Level | AutomationBench 1.0.6 | Kosten pro Aufgabe |
|---|---|---|
| GPT-6 Sol, extrahoch | 33,2 % | 0,27 $ |
| GPT-6 Astra, niedrig | 30,3 % | 3,9-fach Sol |
| Claude Opus 5, maximal | 26,9 % | 11,1-fach Sol |
| Fable 5.1 mit Opus 5 als Fallback, maximal | 31,4 % | mehr als 8,9-fach Sol |
OpenAIs eigene Zusammenfassung der ersten und dritten Zeile: Sol mit extrahohem Aufwand schlägt Opus 5 mit maximalem Aufwand bei etwa 9 % der Kosten pro Aufgabe von Opus 5. Dasselbe Muster zeigt sich auch an anderen Stellen im Beitrag. Bei Agents' Last Exam V1 erreicht Sol mit maximalem Aufwand 56,4 %, mehr als der beste Wert von Opus 5, bei 60 % geringeren Kosten pro Aufgabe. Bei DeepSWE 1.1 kommt Sol mit maximalem Aufwand auf 68,8 % – nur 1,1 Prozentpunkte unter Fable 5 mit extrahohem Aufwand (69,9 %) – und ist dabei rund 80 % günstiger pro Aufgabe.
Zu diesen Zahlen gehören zwei Einschränkungen, die selten mitgeliefert werden. OpenAIs Schlagzeile lautet, dass Sol und Luna jeweils 50 % günstiger sind als die promotional-Preise von GPT-5.6, und „promotional" ist OpenAIs eigenes Wort: Der Vergleich bezieht sich auf einen rabattierten Preis. Außerdem hat OpenAI gegen Claude Opus 5 verglichen, weil Claude Opus 5.5 nur Stunden später zu 4 und 20 Dollar pro Million erschien, gegenüber 5 und 25 Dollar bei Opus 5. Die Opus-5-Spalte ist der zuletzt veröffentlichte Vergleich, nicht der aktuelle.
Ein Budget in Runs umrechnen
Multipliziert man 0,27 Dollar mit 11,1, landet Opus 5 mit maximalem Aufwand auf dieser Testumgebung bei etwa 3,00 Dollar pro Aufgabe. Diese Rechnung stammt von uns, basierend auf OpenAIs zwei Zahlen. Teilt man eine monatliche Obergrenze durch den jeweiligen Wert, ergibt sich die Tabelle, die verändert, wie die Obergrenze zu lesen ist.
| Monatliches Modellbudget | Aufgaben auf Sol, extrahoch | Aufgaben auf Astra, niedrig | Aufgaben auf Opus 5, maximal |
|---|---|---|---|
| 250 $ | ca. 925 | ca. 240 | ca. 83 |
| 1.000 $ | ca. 3.700 | ca. 950 | ca. 330 |
| 5.000 $ | ca. 18.500 | ca. 4.750 | ca. 1.660 |
Die Kosten pro Aufgabe in einem Benchmark sind nicht Ihre Kosten pro Aufgabe. AutomationBench-Aufgaben sind benchmarkförmig: begrenzt, kurz und nichts wie ein echtes Ticket in einem Repository mit jahrelanger Historie. Ihre eigenen Aufgaben können zehn- oder hundertmal so viele Tokens verbrauchen. Was sich zwischen Benchmark und Ihrem Repository übertragen lässt, ist das Verhältnis zwischen den Modellen, nicht der absolute Dollarbetrag. Betrachten Sie die Tabelle als die Form der Veränderung, messen Sie dann Ihre eigenen Kosten pro Run über alle Agents hinweg und skalieren Sie sie entsprechend.
Es gibt eine zweite Korrektur, und sie wirkt in die entgegengesetzte Richtung. Die Kosten pro Aufgabe gelten pro Versuch, nicht pro Erfolg. Bei den im Benchmark selbst gemessenen 33,2 % landen rund zwei von drei Versuchen nicht, sodass Sol etwa 0,81 Dollar pro Benchmark-Erfolg kostet und Opus 5 mit maximalem Aufwand etwa 11,15 Dollar. Auch das ist unsere Rechnung, und sie ist grob, denn eine Benchmark-Bestehensquote ist nicht die Akzeptanzrate Ihres Teams. Entscheidend ist die Richtung: Die Kosten, etwas zweimal zu versuchen, sind inzwischen so gering, dass die Retry-Strategie eine Designentscheidung ist und keine Budgetfrage.
Wo die Obergrenze heute liegt
Stellen wir nun die Review-Seite auf dieselbe Grundlage. Ein Reviewer, der einen Diff richtig liest, versteht, was der Agent gewählt hat, und Verantwortung für das Ergebnis übernimmt, schafft an einem Arbeitstag eine bestimmte Anzahl von Änderungen. Nehmen wir sechs an – und passen Sie das an Ihr Team an.
| Reviewer | Akzeptierte Änderungen pro Monat | Sol-Kosten bei 0,27 $ | Opus 5 Max-Kosten bei 3,00 $ |
|---|---|---|---|
| 1 | ca. 126 | 34 $ | 378 $ |
| 2 | ca. 252 | 68 $ | 756 $ |
| 4 | ca. 504 | 136 $ | 1.512 $ |
| 8 | ca. 1.008 | 272 $ | 3.024 $ |
Sechs akzeptierte Änderungen pro Reviewer und Tag über 21 Arbeitstage – unsere Annahme und unsere Rechnung. Setzen Sie Ihre eigenen Zahlen ein, und das Fazit bleibt bestehen: Alles, was ein normales Engineering-Team in einem Monat tatsächlich akzeptieren kann, kostet ein paar hundert Dollar an Inferenz, selbst am teuren Ende. Eine Obergrenze von 1.000 Dollar für ein vierköpfiges Team ist keine Einschränkung. Sie entspricht etwa dem Siebenfachen dessen, was das Team überhaupt verarbeiten kann.
Genau darin liegt der eigentliche Sinn der Preissenkung für ein Team, das seine Arbeit reviewt. Sie hat Ihren Output nicht erhöht. Sie hat die letzte Ausrede dafür beseitigt, dass die Warteschlange kurz ist, und einen Engpass sichtbar gemacht, der schon immer der menschliche Review-Schritt war.
Die internen Ausgaben von OpenAI sind das nützliche Gegenbeispiel, kein Widerspruch. Der Median-Forscher dort fährt mehr als 600 Dollar pro Tag an Coding-Agent-Inferenz zu API-Preisen, und das 90. Perzentil liegt bei 7.000 Dollar pro Tag. Das sind echte Zahlen, und sie stellen die obige Tabelle in den Schatten, weil diese Arbeit eine andere Form hat: enormes Fan-out, automatisierte Bewertung und kein Schritt, in dem eine namentlich benannte Person jedes Ergebnis in einen Produktionsbranch akzeptiert. Wenn Ihr Prozess diesen Schritt hat, wird Ihre Modellrechnung klein bleiben – Ihre Warteschlange nicht.
Was Sie mit dem Spielraum kaufen sollten
Sobald das Budget nicht mehr limitierend ist, dreht sich die Frage nicht mehr darum, wie viele Runs man kauft, sondern darum, wofür man die Differenz ausgibt. Zwei Antworten reduzieren die Arbeit, die bei einem Reviewer ankommt, statt sie zu erhöhen.
Kaufen Sie Aufwand, nicht Volumen. Der Reasoning-Aufwand ist ein Kostenregler, und OpenAIs eigene Tabelle verwendet für verschiedene Benchmarks unterschiedliche Stufen. Die 0,27 Dollar stammen aus der Zeile mit extrahohem Aufwand, das heißt, der Aufpreis für einen sorgfältigeren Run steckt bereits in einer Zahl, die nur 9 % der Alternative beträgt. Zahlt man ihn bei gleicher Aufgabenzahl, kostet das fast nichts und liefert Diffs, deren Prüfung weniger Zeit in Anspruch nimmt.
Kaufen Sie Cache, nicht Tokens. GPT-6 rabattiert gecachte Input-Reads um 90 %, hält die Trefferquoten standardmäßig höher und invalidiert den Cache nicht mehr, wenn Sie den Reasoning-Aufwand oder die Tool-Verfügbarkeit ändern. Explizite Breakpoints lassen Sie entscheiden, wo ein gecachtes Präfix endet. OpenAI verweist auf GitHub, wo über Milliarden von Anfragen hinweg mehr als 50 % weniger Prompt-Tokens frisch verarbeitet werden mussten. Für eine Crew ist das der Unterschied zwischen dem ersten Agent an einem Repository und dem zehnten: Sie senden nahezu dasselbe Präfix aus Layout, Hausregeln und Konventionen erneut, und genau dafür ist ein Cache da. Die Token-Kosten von Repository-Kontext sind der Ort, an dem die Rechnung einer Flotte tatsächlich entsteht.
Das ehrliche Entscheidungspaar: Erhöhen Sie die Zahl der parallelen Runs, wenn die zusätzlichen Runs auf ein einziges Ergebnis zulaufen, das eine Person akzeptiert – etwa drei Versuche für eine Migration, bei der eine Testsuite den Gewinner auswählt. Erhöhen Sie sie nicht, wenn jeder Run seinen eigenen Diff, seine eigene Zusammenfassung und seine eigene Akzeptanzentscheidung produziert, so günstig die Runs auch geworden sind. Im zweiten Fall ist die Rechnung das Einzige, was gut skaliert hat.
Machen Sie die neue Obergrenze zählbar
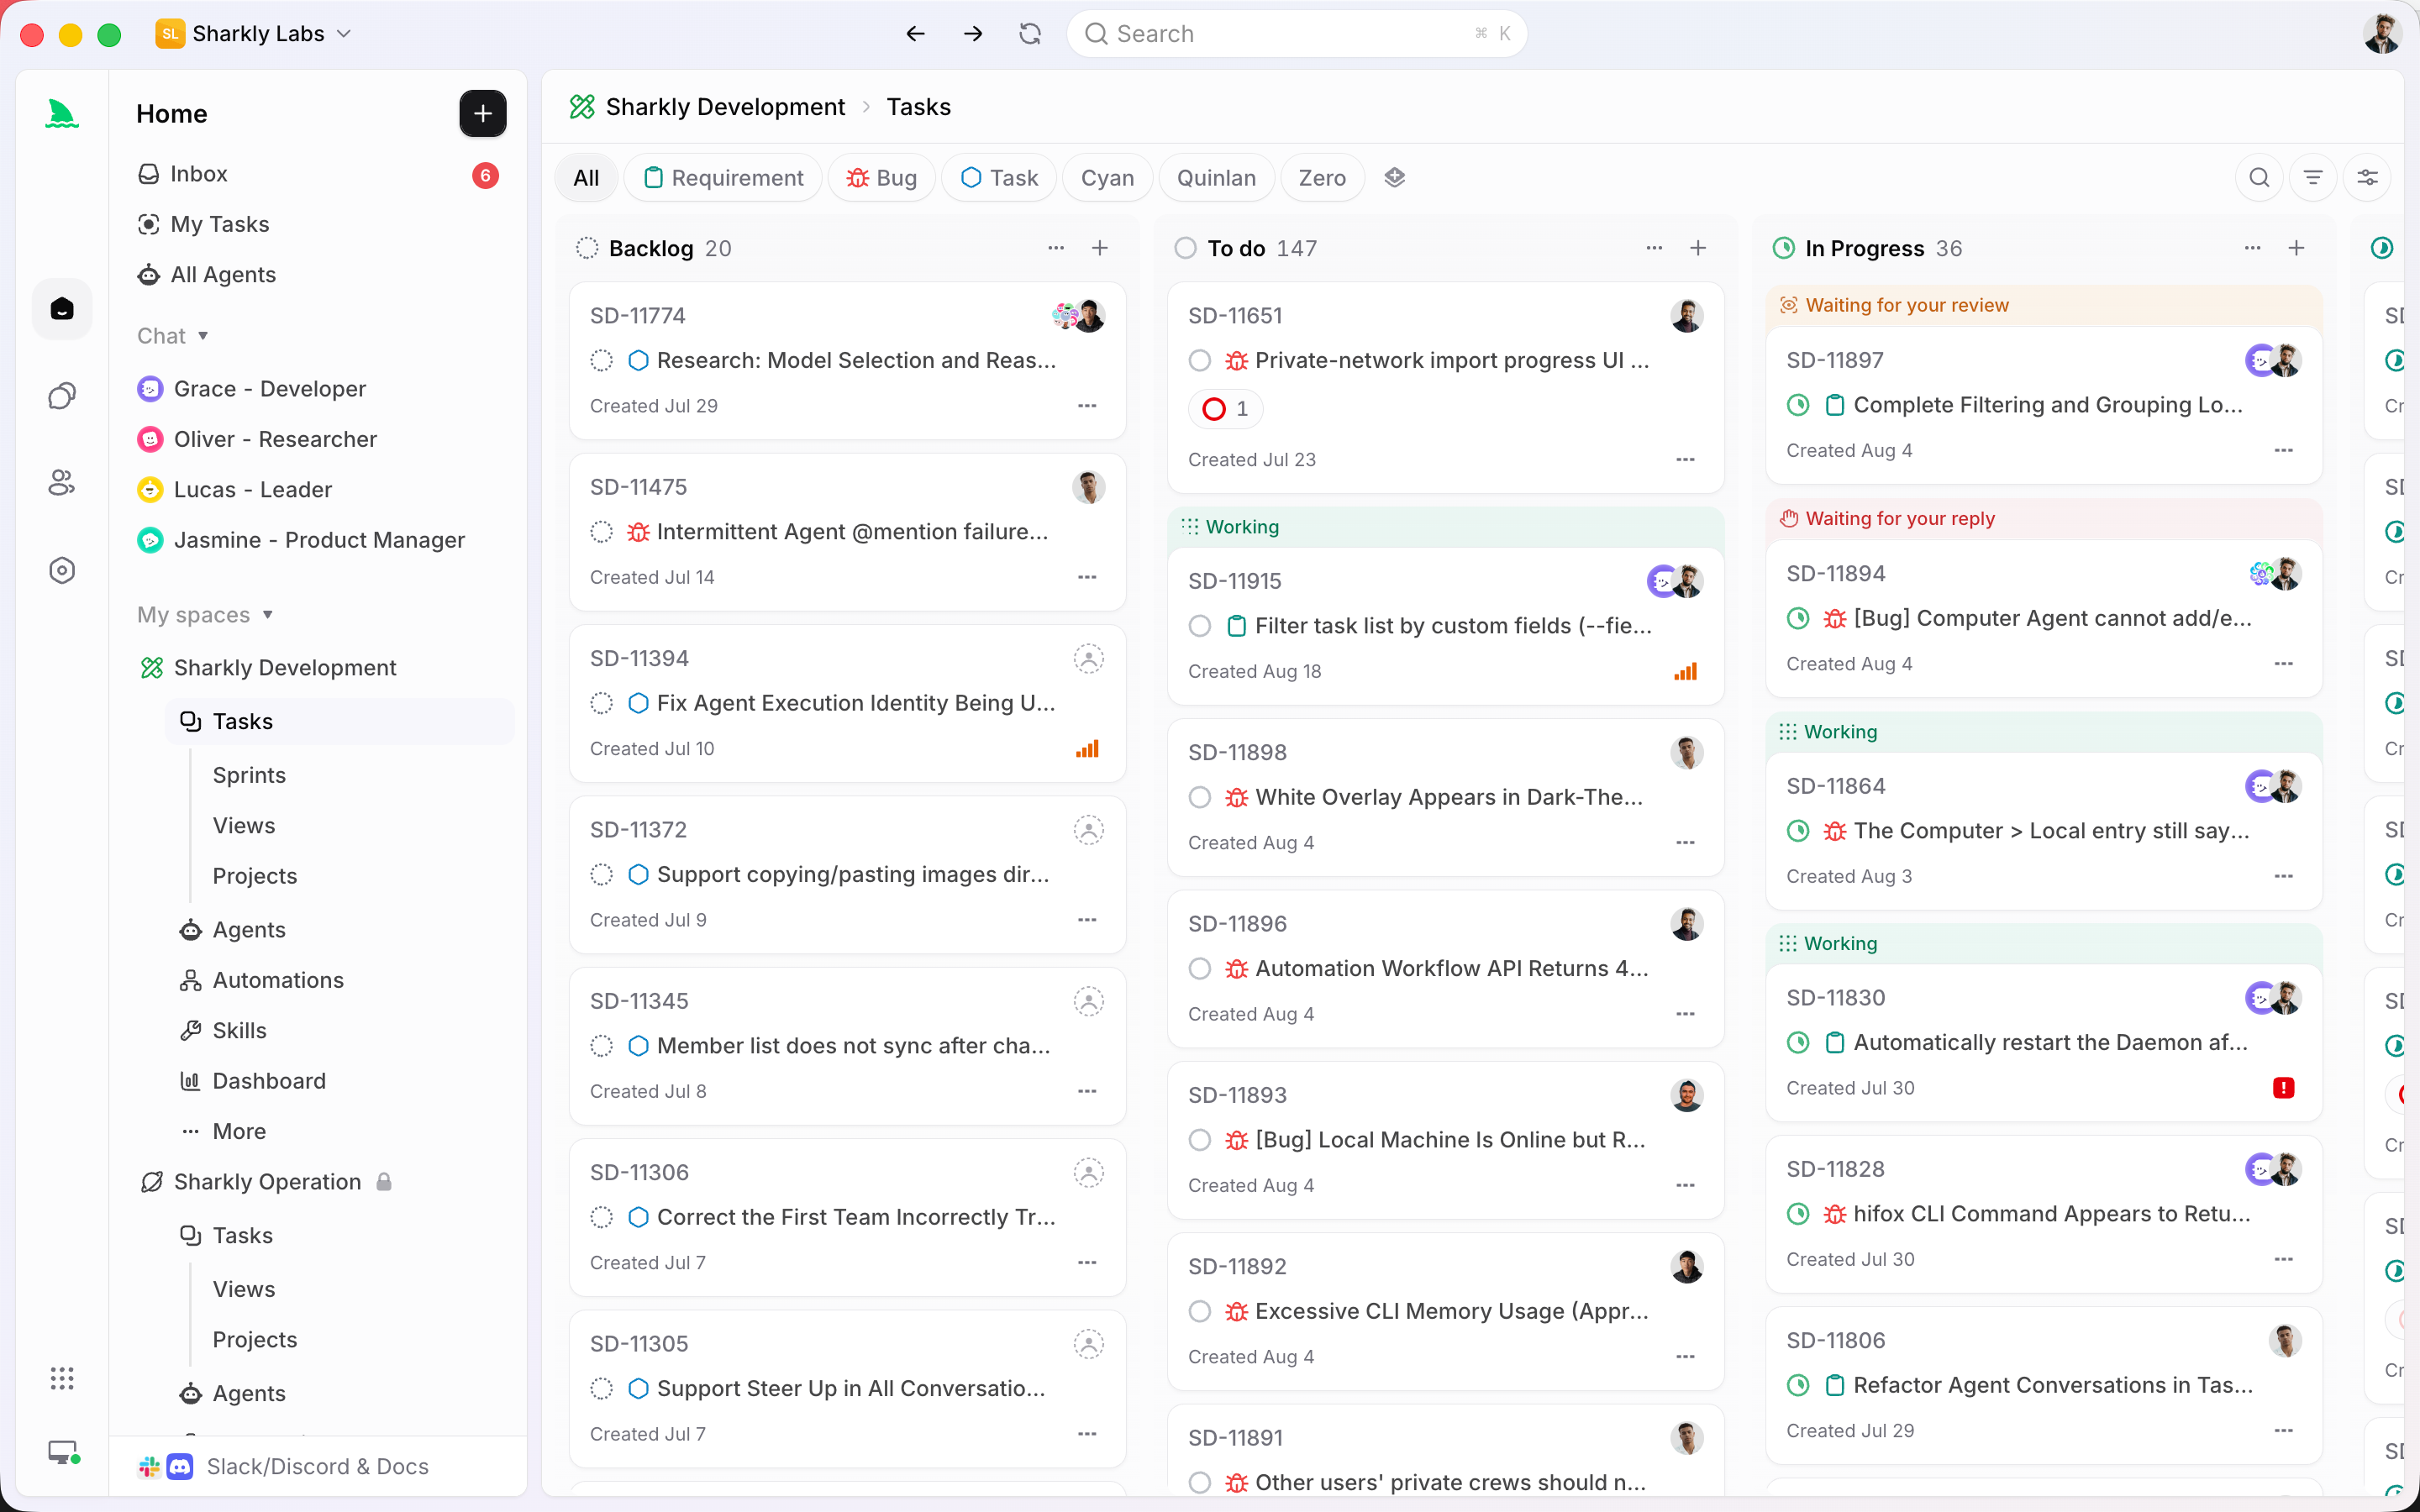
Das Budget war ein schlechter Stellvertreter für Kapazität, hatte aber einen Vorteil: Es war eine Zahl, die jemand im Auge behielt. Ersetzen Sie es durch die Zahl, die jetzt limitiert – fertiggestellte Runs, die auf einen Menschen warten.
Messbar ist das nur, wenn Runs aufhören, in privaten Terminals zu leben. Sharkly ist kein Ersatz für Codex, Claude Code oder die anderen Tools, die diese Modelle ausführen. Es ist die Schicht darum herum, in der Kontext, Fortschritt, Blocker, Ergebnisse und menschliches Review vom Request bis zum Release sichtbar bleiben. Ausführung und Blocker fließen zurück in die Task, sodass „wartet auf einen Menschen" ein Zustand wird, den man auf einem Board zählen kann, statt ein Gefühl, das man am Freitagnachmittag bekommt. Die Rechenlogik zur Review-Kapazität funktioniert nur, wenn man die Warteschlange sehen kann.
Wenn Sie bereits mehrere Coding-Agents betreiben, besteht der Schritt für diese Woche nicht darin, die Obergrenze zu erhöhen. Er besteht darin, herauszufinden, wie viele fertige Runs Ihr Team in einer normalen Woche akzeptiert, die Parallelität daran auszurichten und das übrig gebliebene Budget für Runs auszugeben, die leichter zu akzeptieren sind.


