
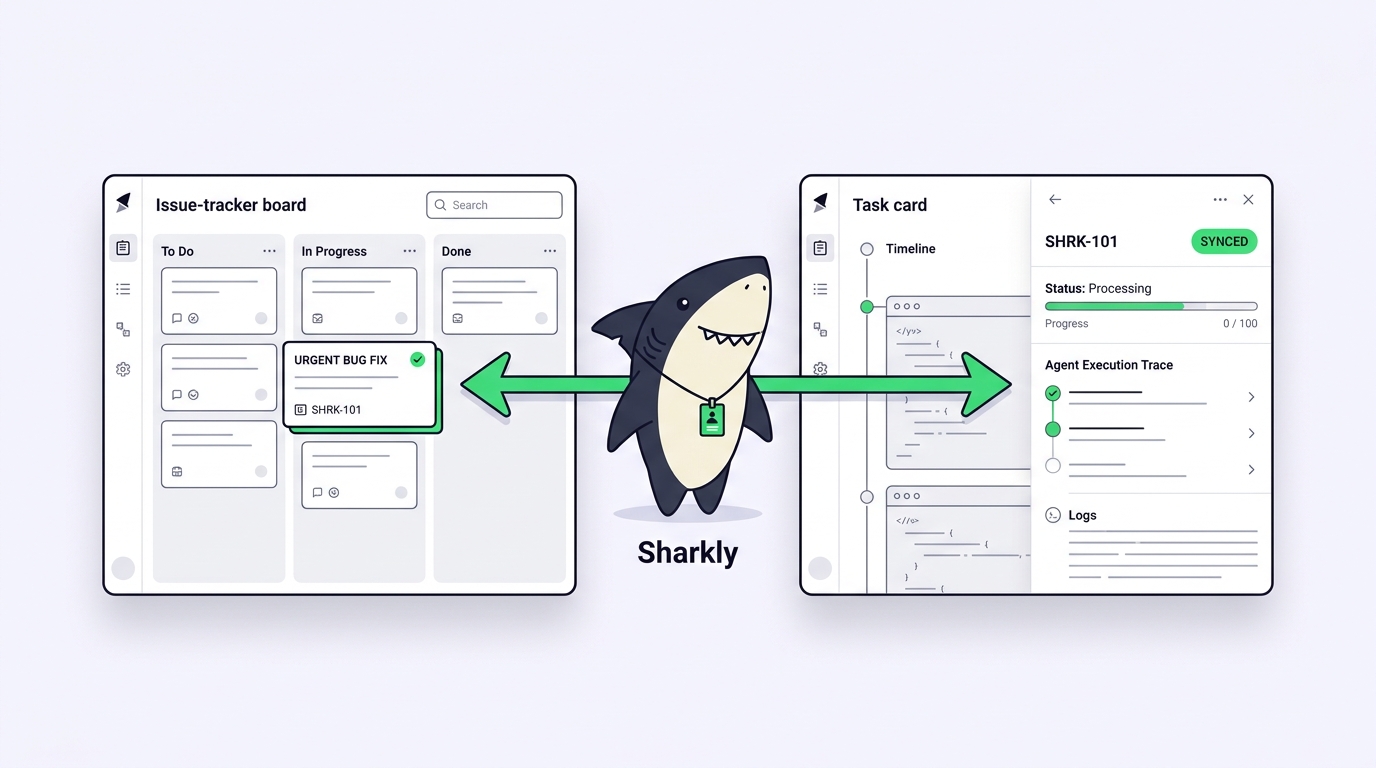
Dein Backlog lebt in Jira. Niemand räumt ihn um. Die Epics sind da, die Sprint-Reports gehen an die Führungsetage, und drei andere Teams hängen von diesen Work-Item-IDs ab. Wenn also jemand fragt, ob ein KI-Coding-Agent JIRA-4821 übernehmen sollte, geht es nicht um die Frage „Sollten wir Jira ersetzen?“. Sie ist enger und praktischer: Wo läuft der Agent eigentlich, wer prüft, was er produziert hat, und landet davon irgendetwas wieder im Ticket?
Das ist der eigentliche Vergleich. Jira hat inzwischen Agents, und die funktionieren. Sharkly führt ebenfalls Agents aus – auf Computern, die du verbindest – und syncht das Ergebnis zurück nach Jira. Dieser Leitfaden zieht ehrlich die Grenze zwischen beiden, inklusive der Fälle, in denen Sharkly zusätzlich zu viel des Guten wäre.
TL;DR
Jira ist ein System of Record, das um Agent-Ausführung erweitert wurde. Sharkly ist eine Ausführungsschicht, die sich mit deinem System of Record verbindet. Atlassians Rovo Dev übernimmt Planung, Coding und Review innerhalb der Atlassian-Umgebungen, und du kannst Work Items über das Assignee-Dropdown Agents zuweisen. Sharkly führt jede Runtime aus, für die dein Team bereits bezahlt, auf Computern, die du verbindest, hält den Ausführungs-Trace auf einer geteilten Task fest und syncht bidirektional mit Jira Cloud, Server oder Data Center. Wenn deine Agent-Arbeit in die von Atlassian unterstützten Umgebungen passt, reicht Jira allein. Wenn deine Agents auf deinen eigenen Maschinen laufen müssen – mit deinen eigenen Runtimes und deinem eigenen Review-Gate –, ergänzt Sharkly diese Schicht, ohne Jira zu verdrängen.
Was Jira gut kann – nüchtern betrachtet
Lass uns Jira von seiner besten Seite zeigen, denn diese Seite ist stark.
Jira ist der Ort, an dem sich ein Unternehmen darauf einigt, welche Arbeit existiert. Diese Einigkeit hat echten Wert: gemeinsame IDs, Berechtigungsmodelle, Audit-Historie, Reports, die Finance und Führungsetage ohnehin lesen. Jedes Tool, das ein Team bittet, das aufzugeben, verlangt etwas Teures.
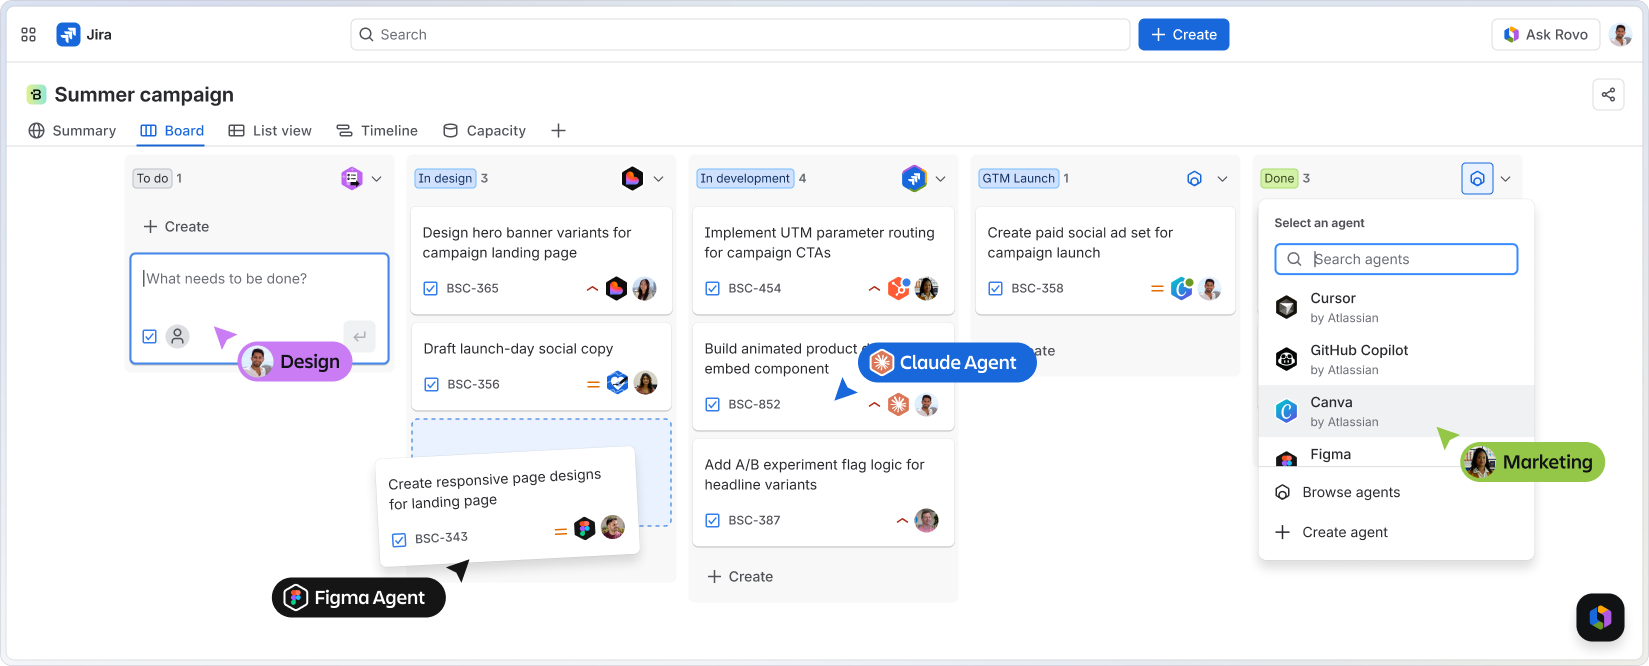
Atlassian hat beim Thema Agents auch nicht stillgehalten. Rovo Dev wird von Atlassian beschrieben als „ein kontextbewusster KI-Agent, der den Software-Development-Lifecycle beschleunigt, indem er Planung, Coding und Reviews übernimmt und repetitive Arbeit in großem Maßstab automatisiert“. Er validiert Code-Änderungen gegen die Akzeptanzkriterien in Jira und arbeitet im Terminal-CLI, in Bitbucket Cloud, GitHub und VS Code. Laut Atlassian ist Rovo Dev Standard für alle neuen und bestehenden Kunden allgemein verfügbar, mit monatlichen Credits, die in den Cloud-Plänen Standard, Premium und Enterprise eingeführt werden.
Das Zuweisungsmodell ist wirklich gut. Du öffnest das Assignee-Dropdown eines Work Items und wählst einen Agent aus, genau wie du eine Kollegin auswählen würdest – und diese Liste enthält auch Agents von Drittanbietern wie den GitHub Copilot Coding Agent. Atlassians eigenes Engineering-Team hat einen Bericht darüber veröffentlicht, wie es mit Rovo Dev in Jira 120 PRs in zwei Wochen geliefert hat. Das ist keine Demo-Zahl. Das ist ein Team, das seinen Durchsatz an echter Arbeit berichtet.
Die Ausgangslage lautet also nicht „Jira hängt hinterher“. Sie lautet: „Jira hat eine Antwort, und du solltest genau wissen, was diese Antwort abdeckt.“
Wo Jiras Antwort endet
Die Grenze verläuft dort, wo die Ausführung stattfindet und welche Tools erreichbar sind.
Die Jira-native Agent-Ausführung findet in den Umgebungen statt, die Atlassian unterstützt. Das ist Absicht, und für viele Teams ist es genau richtig. Es bedeutet aber auch, dass die Frage nach der Runtime für dich beantwortet ist. Wenn sich deine Entwickler auf Claude Code mit einem bestimmten Skills-Setup festgelegt haben, auf Codex über ein ChatGPT-Abo, auf die Gemini CLI, auf OpenCode oder auf etwas, das ihr gegen ein eigenes Protokoll gebaut habt, dann führt der Jira-native Weg diese nicht so aus, wie deine Entwickler sie lokal ausführen.
Es gibt eine zweite Grenze, die wichtiger ist, als die meisten Vergleiche zugeben: die Maschine. Agent-Arbeit ist nicht nur ein Model-Call. Sie braucht einen Checkout, einen Package Manager, Umgebungsvariablen, eine lokale Datenbank, die VPN-Route zu deiner Staging-API und die zwanzig kleinen Dinge, durch die dein Repo auf deinem Laptop baut, in einem generischen Container aber nicht. Teams stoßen in der zweiten Woche darauf, nicht in der ersten.
Und dann ist da die Review-Frage. Wenn ein Agent eine Änderung produziert, ist das nützliche Artefakt nicht nur der Pull Request. Es ist der Trace: was dem Agent gesagt wurde, was er gelesen hat, was er versucht hat, wo er hängengeblieben ist und was ein Mensch darüber entschieden hat. Dieser Datensatz braucht einen Ort, den die nächste Person lesen kann.
Die beiden Entscheidungsfälle
Sharklys eigene Dokumentation ist deutlich, was die Arbeitsteilung angeht – und dieselbe Deutlichkeit gilt hier.
Setze Jira allein ein, wenn deine Agent-Arbeit in die von Atlassian unterstützten Umgebungen passt, deine Repositories in Bitbucket oder GitHub liegen und die Agents, die du willst, zu denen gehören, die Jira bereits zuweisen kann. Dann hast du System of Record und Ausführungspfad in einem Produkt, einmal abgerechnet. Eine weitere Schicht einzuziehen, kauft dir nur unnötige Komplexität. Das ist eine echte Empfehlung, keine Verlegenheitslösung.
Ergänze Sharkly, wenn die Ausführung auf Hardware und Runtimes stattfinden muss, die du kontrollierst. Ein Computer in Sharkly stellt den Ausführungs-Host für Agent-Arbeit bereit – das kann ein lokaler Rechner, ein Remote-Server, ein Container oder ein unterstützter Cloud-Host sein. Ein kleiner lokaler Dienst verbindet diesen Computer mit Sharkly, erkennt verfügbare Runtimes, nimmt Arbeit entgegen, bereitet das Task-Verzeichnis vor, startet die ausgewählte Runtime und streamt den Fortschritt zurück. Genau das versucht Jira gar nicht erst zu sein.
Eine Definition, weil alles Weitere darauf aufbaut. Eine Task ist die zentrale Arbeitseinheit in Sharkly. Sie enthält Ziel und Beschreibung, die verantwortliche Person, den zugewiesenen Agent oder Crew, die Kommentare, den Ausführungsstatus, den Trace und das Ergebnis. Wo ein Jira-Issue festhält, dass Arbeit existiert, hält eine Sharkly-Task fest, wie die Arbeit erledigt wurde und von welchem Agent auf welcher Maschine.
Du musst dich nicht entscheiden: der Sync-Weg
Genau hier gehen die meisten „Sharkly vs. Jira“-Gegenüberstellungen schief. Die beiden schließen sich nicht gegenseitig aus, und die Integration ist dokumentiert und nicht bloß Wunschdenken.
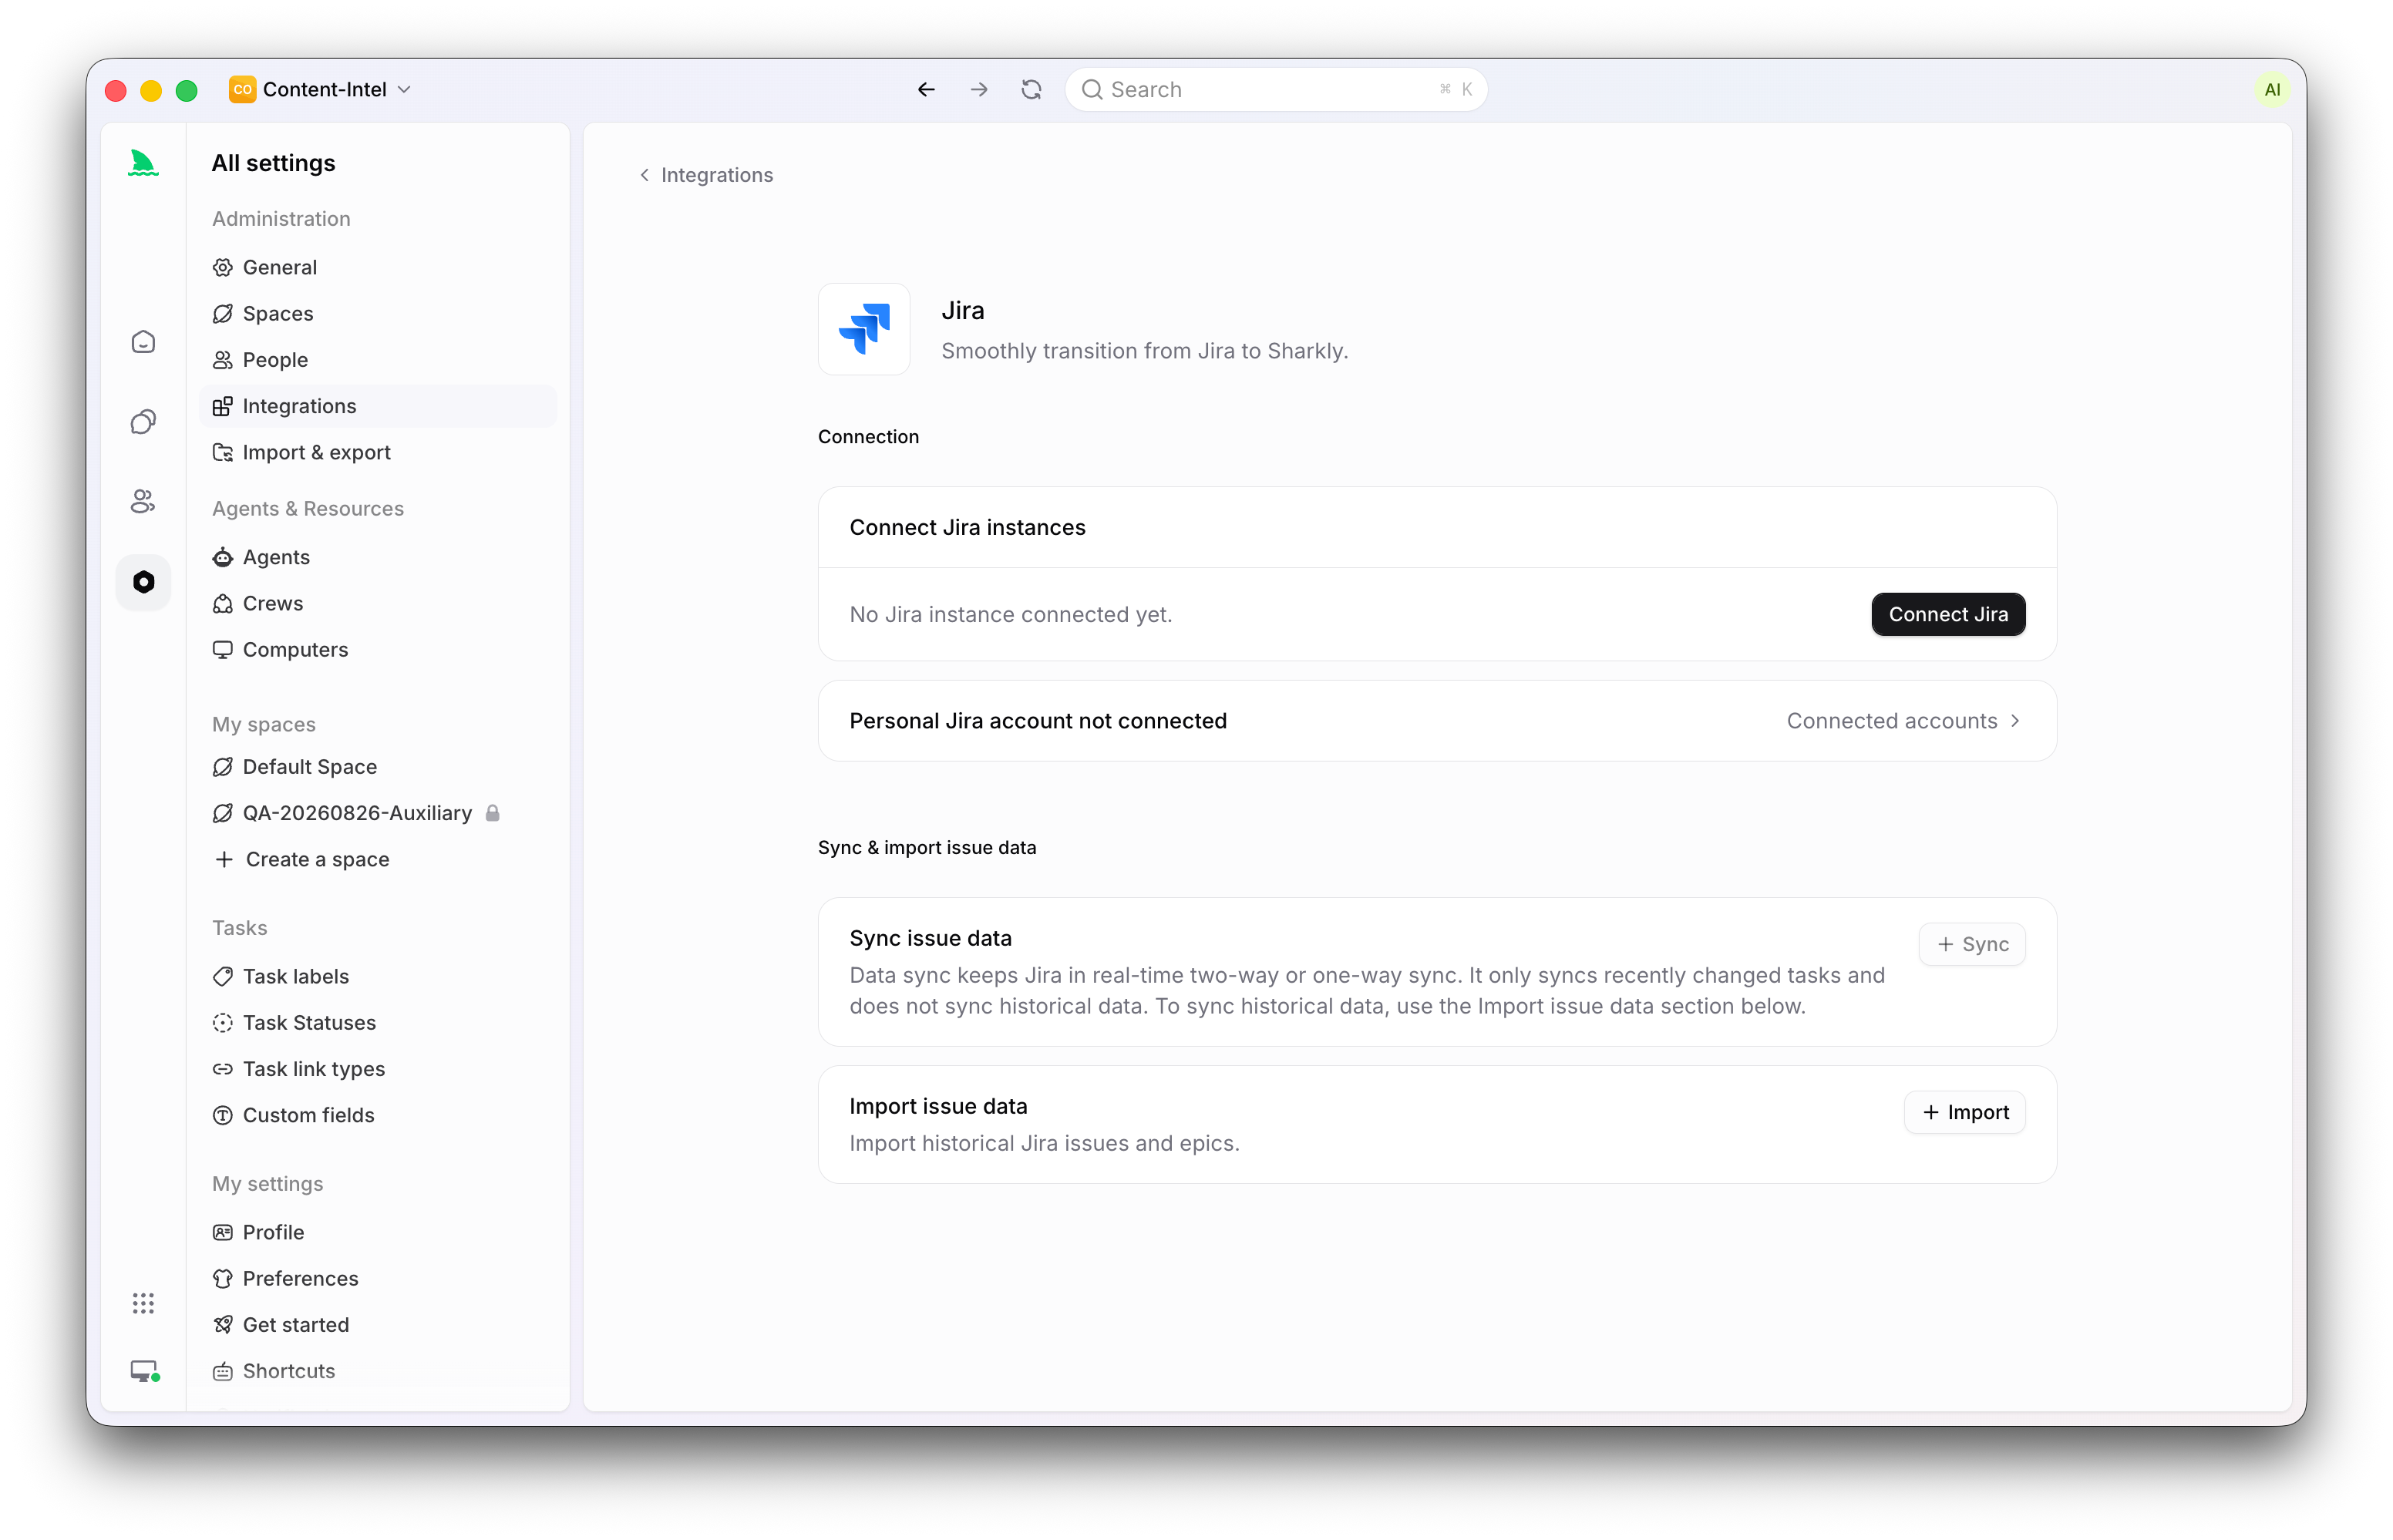
Sharklys Jira-Integration unterstützt Jira Cloud sowie Jira Server bzw. Data Center und bietet drei Modi:
- Import kopiert bestehende Jira-Daten nach Sharkly. Sinnvoll für historische Arbeit oder eine kontrollierte Migration.
- Sync verknüpft ein Jira-Projekt mit einem Sharkly Space und hält aktuelle Änderungen verbunden. Der Sync importiert historische Daten nicht von selbst.
- Import und anschließend Sync überträgt die ausgewählte Historie und kann den laufenden Sync mit den bereits im Assistenten eingegebenen Zugangsdaten aktivieren.
Eine Sync-Verknüpfung verbindet genau ein Jira-Projekt mit einem Sharkly Space. Ein Jira-Projekt kann nur eine aktive Verknüpfung haben, mehrere Jira-Projekte können jedoch auf denselben Space verweisen. Im bidirektionalen Modus werden Jira-Issues und -Epics in beide Richtungen mit Sharkly-Tasks und -Projekten synchronisiert, und neue Tasks und Projekte im verknüpften Space können Jira-Issues und -Epics anlegen. Wenn Jira die Hoheit behalten soll, legt der Modus „Jira zu Sharkly“ verknüpfte Sharkly-Datensätze an und aktualisiert sie, ohne neue Datensätze zurückzuschreiben.
Zwei praktische Hinweise, die du vorher kennen solltest. Die automatische Webhook-Installation erfordert Jira-Administratorrechte. Fehlt die Webhook-Berechtigung, blockiert das die Verbindung nicht, aber Jira-Änderungen kommen dann nicht an. Das Löschen einer Verknüpfung beendet den künftigen Sync, ohne auf einer der beiden Seiten etwas zu löschen – falls du dich dagegen entscheidest, ist das also umkehrbar.
Für den Workflow auf Ticketebene beschreibt unsere Anleitung zum Zuweisen eines Jira-Tickets an einen KI-Agent die Schleife von Anfang bis Ende.
Ein Beispiel aus der Praxis
Ein Payments-Team nutzt Jira als Unternehmensstandard. Der Support erstellt JIRA-4821: Ein Webhook-Retry-Sturm führt bei einer kleinen Zahl von Kundinnen und Kunden zu Doppelabbuchungen.
Der Tech Lead triagiert das Ticket in Jira, setzt die Priorität und verknüpft es mit dem Incident-Epic. Da der verknüpfte Space bidirektional synchronisiert, taucht dieselbe Arbeit in Sharkly als Task auf – mit intakter Beschreibung und intakten Akzeptanzkriterien.
Dort wird das Routing konkret. Die Task geht an einen Agent, der für Backend-Fixes konfiguriert ist: definierte Rolle, das Payments-Repository und Claude Code als Runtime, ausgeführt auf einem verbundenen Computer, der die Staging-Zugangsdaten und die VPN-Route bereits hat. Ein zweiter Agent kümmert sich in einem isolierten Worktree um die Testabdeckung, damit sich beide nie dieselben Dateien teilen. Unser Leitfaden zum parallelen Ausführen von Agents in isolierten Worktrees erklärt, warum diese Isolation spätestens dann zählt, wenn mehr als ein Agent arbeitet.
Der Agent liest das Issue, reproduziert den Retry-Sturm gegen ein lokales Replay, schlägt eine Änderung am Idempotency-Key vor, lässt die Testsuite laufen und meldet sich zurück. Alles, was er gelesen, versucht und woran er sich die Zähne ausgebissen hat, steht in der Task, im Trace, direkt neben den Kommentaren. Der Lead prüft das Diff, stellt eine Rückfrage in einem Task-Kommentar – was einen weiteren Lauf startet – und akzeptiert dann.
Das Ergebnis fließt zurück nach JIRA-4821, für die Leute, die Jira nie verlassen haben: Das Ticket schließt, der Sprint-Report stimmt, und der Support sieht die Lösung in dem Tool, das er ohnehin nutzt. Niemand musste umziehen.
Sharkly vs. Jira: ein fairer Vergleich
| Jira (mit Rovo Dev und zuweisbaren Agents) | Sharkly | |
|---|---|---|
| Hauptrolle | System of Record für unternehmensweite Arbeit | Ausführungs- und Review-Schicht für Menschen und Agents |
| Agent-Zuweisung | Assignee-Dropdown, Rovo-Agents und unterstützte Agents von Drittanbietern | Task, die einem Agent oder einer Crew zugewiesen wird |
| Wo Agents laufen | Von Atlassian unterstützte Umgebungen, darunter CLI, Bitbucket Cloud, GitHub, VS Code | Computer, die du verbindest: lokaler Rechner, Remote-Server, Container oder unterstützter Cloud-Host |
| Wahl der Runtime | Die Agents, die Jira unterstützt | Die auf diesem Computer erkannte Runtime, einschließlich einer selbst konfigurierten ACP-Runtime |
| Modell-Abrechnung | Über deinen Atlassian-Plan und dessen Credits | Über die Abos oder API-Keys, die in deinen Tools bereits konfiguriert sind |
| Ausführungsprotokoll | Work-Item-Historie und verknüpfte PRs | Task mit Ausführungsstatus, Trace, Ergebnis und Kommentaren |
| Plattformübergreifende Hosts | Von Atlassian verwaltet | Installer für macOS, Linux und Windows für CLI und lokalen Dienst |
| Verhältnis | Der Datensatz, über den alle berichten | Synchronisiert bidirektional mit Jira, statt es zu ersetzen |
Häufige Fehler
Das Ganze als Migration behandeln. Der häufigste Fehler ist, Agent-Ausführung als Grund zu framen, Jira zu verlassen. Finance, Support und drei weitere Teams lesen diese Reports. Synchronisieren statt verdrängen.
Das Webhook-Gespräch überspringen. Die Jira-Verknüpfung braucht Administratorrechte, um ihren Webhook automatisch zu installieren. Wenn du die nicht hast, gib das einmalige Konfigurationspaket frühzeitig an einen Jira-Administrator, statt später Stille zu debuggen.
Aus Versehen viele Jira-Projekte auf einen Space zeigen lassen. Ein Jira-Projekt kann nur eine aktive Space-Verknüpfung haben, und die Paarung lässt sich nach dem Anlegen nicht mehr ändern. Entscheide das Mapping, bevor du Verknüpfungen erstellst, denn eine Korrektur bedeutet Löschen und Neuanlegen.
Arbeit zuweisen, die nicht agent-tauglich ist. Ein Ticket mit der Beschreibung „Behebe den Payments-Bug“ führt zu einem schlechten Lauf – egal auf welcher Plattform. Die Akzeptanzkriterien machen den Unterschied, und genau diese Disziplin brauchten gute Tickets schon immer. Unser Überblick zum KI-Agent-Projektmanagement behandelt, was sich ändert, wenn der Assignee keine Person ist.
Fazit
Jira beantwortet die Frage, welche Arbeit existiert und wem sie gehört. Mit Rovo Dev und zuweisbaren Agents beantwortet es inzwischen auch einen Teil der Frage, wer die Arbeit macht – innerhalb der Umgebungen, die Atlassian unterstützt. Wenn das deinen Stack abdeckt, bist du fertig und solltest aufhören, Vergleichsartikel zu lesen.
Sharkly beantwortet eine andere Frage: Wo findet Agent-Ausführung statt, wenn sie deine Maschinen, deine Runtimes und dein Review-Gate braucht – und wie bleibt dieser Datensatz für das Team lesbar? Sharkly ersetzt weder Claude Code noch Codex, und es ersetzt auch nicht Jira. Es ergänzt die geteilte Task, den verbundenen Computer, Kontext, Kontrolle und die Review-Schicht rund um die Tools, die dein Team bereits nutzt, und syncht das Ergebnis anschließend in das Ticket zurück, das alle anderen lesen.
Wenn genau das die Lücke ist, die du spürst, fang mit Sharkly an und verbinde ein Jira-Projekt mit einem Space, bevor du irgendetwas anderes anfasst.
FAQ
Ersetzt Sharkly Jira? Nein. Es verknüpft sich über Import, unidirektionalen Sync oder bidirektionalen Sync mit Jira. Das Löschen einer Verknüpfung beendet den künftigen Sync, ohne Jira-Issues, Jira-Epics, Sharkly-Tasks oder Sharkly-Projekte zu löschen.
Kann ich Jira als Source of Truth behalten? Ja. Die Richtung „Jira zu Sharkly“ legt verknüpfte Sharkly-Datensätze an oder aktualisiert sie, ohne aus Sharkly heraus neue Jira-Datensätze zu erstellen. Unterstützte Updates an bereits verknüpften Datensätzen können trotzdem zurückgeschrieben werden.
Funktioniert das mit selbst gehostetem Jira? Jira Cloud sowie Jira Server bzw. Data Center werden beide unterstützt. Installationen von Server und Data Center bieten zusätzlich eine Proxy-Option für private Netzwerke, die Jira Cloud nicht anzeigt.
Und was ist mit den Modellkosten? Die Modellnutzung läuft weiter über die Abos oder API-Keys, die in deinen Coding-Tools konfiguriert sind. Das Modell-Kontingent hängt von den KI-Coding-Tools, Plänen und API-Konten ab, die dein Team verbindet.
Welche Agents kann Jira nativ zuweisen? Rovo-Agents sowie unterstützte Agents von Drittanbietern wie den GitHub Copilot Coding Agent, ausgewählt über das Assignee-Dropdown des Work Items. Prüfe die aktuelle Dokumentation von Atlassian, da sich die unterstützte Liste ändert.
Brauche ich zum Start beide Tools? Nein. Du kannst Sharkly zunächst mit den eigenen Spaces betreiben und Jira später anbinden. Teams, die ohnehin in Jira leben, können den Sync meist leichter rechtfertigen, sobald ein Squad eine funktionierende Agent-Schleife hat. Unser Vergleich der Jira-Alternativen für Mensch-Agent-Teams behandelt den Fall, dass Jira noch nicht fest verankert ist.


