
TL;DR: Die Orchestrierung von KI-Agenten ist die Koordination mehrerer KI-Agenten für ein gemeinsames Ziel: Wer übernimmt welche Teilaufgabe, in welcher Reihenfolge, mit welchem Kontext und wie werden die Ergebnisse wieder zusammengeführt? Fünf Muster decken die meisten Systeme ab: sequenziell, Routing, parallel, Orchestrator-Worker und Review-Schleifen. Anthropics eigenes Multi-Agenten-System verbrauchte rund 15-mal so viele Tokens wie ein Chat – der Standard sollte daher immer das einfachste Setup sein, das funktioniert. Für Teams, die Coding-Agenten einsetzen, ist Orchestrierung vor allem eine Frage des Arbeitsmanagements: Zuweisung, Isolation, Übergabe und menschliche Überprüfung.
Ein ganz normaler Dienstag im Jahr 2026: Claude Code teilt eine Migration auf drei Sub-Agenten auf. Codex lässt in einem anderen Terminal die Testsuite laufen. Die Gemini-Session eines Kollegen prüft den Pull-Request von gestern. Jedes Tool koordiniert seine eigenen Helfer reibungslos. Doch niemand koordiniert die Tools untereinander – prompt bearbeiten zwei davon dieselbe Konfigurationsdatei, und das Review prüft Code, der sich bereits wieder geändert hat.
Genau diese Lücke schließt die Orchestrierung von KI-Agenten. Der Begriff umfasst alles – von einem Python-Framework, das Agenten in einem Graphen verknüpft, bis hin zu einem Team, das entscheidet, welcher Coding-Agent welches Ticket übernimmt. Dieser Leitfaden bringt Klarheit: mit einer zitierfähigen Definition, den fünf gängigen Mustern der Tool-Anbieter, den anfallenden Kosten und den Besonderheiten, wenn Agenten Code schreiben. Für die Praxis empfiehlt sich unser Leitfaden zum parallelen Ausführen mehrerer Claude-Code-Agenten.
Was die Orchestrierung von KI-Agenten bedeutet
Die Orchestrierung von KI-Agenten ist die Koordination mehrerer KI-Agenten für ein gemeinsames Ziel: Sie legt fest, welcher Agent welchen Teil der Arbeit übernimmt, in welcher Reihenfolge, mit welchem Kontext und wie deren Ergebnisse zusammengeführt und geprüft werden. Die Definition von IBM trifft es ähnlich: „der Prozess der Koordination mehrerer spezialisierter KI-Agenten innerhalb eines einheitlichen Systems“ (IBM). Die Version von GitHub ergänzt das Ziel: autonome Agenten zu koordinieren, „damit sie gemeinsam auf übergeordnete Ziele hinarbeiten“ (GitHub).
Die entscheidende Unterscheidung liegt darin, wer die Koordinationsentscheidungen trifft. Anthropics Leitfaden Building effective agents unterscheidet zwischen Workflows – „Systemen, in denen LLMs und Tools über vordefinierte Codepfade orchestriert werden“ – und Agenten, bei denen „LLMs ihre eigenen Prozesse und die Tool-Nutzung dynamisch steuern“. OpenAIs Agents-SDK-Orchestrierungsleitfaden zieht dieselbe Grenze zwischen Orchestrierung per Code und Orchestrierung über das LLM – und ermöglicht es, beides zu kombinieren.
Die Orchestrierung über Code ist berechenbar und unkompliziert zu debuggen. Die Orchestrierung durch das Modell meistert dagegen offene, flexible Aufgabenstellungen – allerdings auf Kosten von Ausführungen, die sich nie vollkommen vorhersagen lassen. Die meisten Produktivsysteme nutzen Code für das Grundgerüst und überlassen die Entscheidungen innerhalb dieses Rahmens dem Modell.
Fünf Muster für die Orchestrierung von KI-Agenten
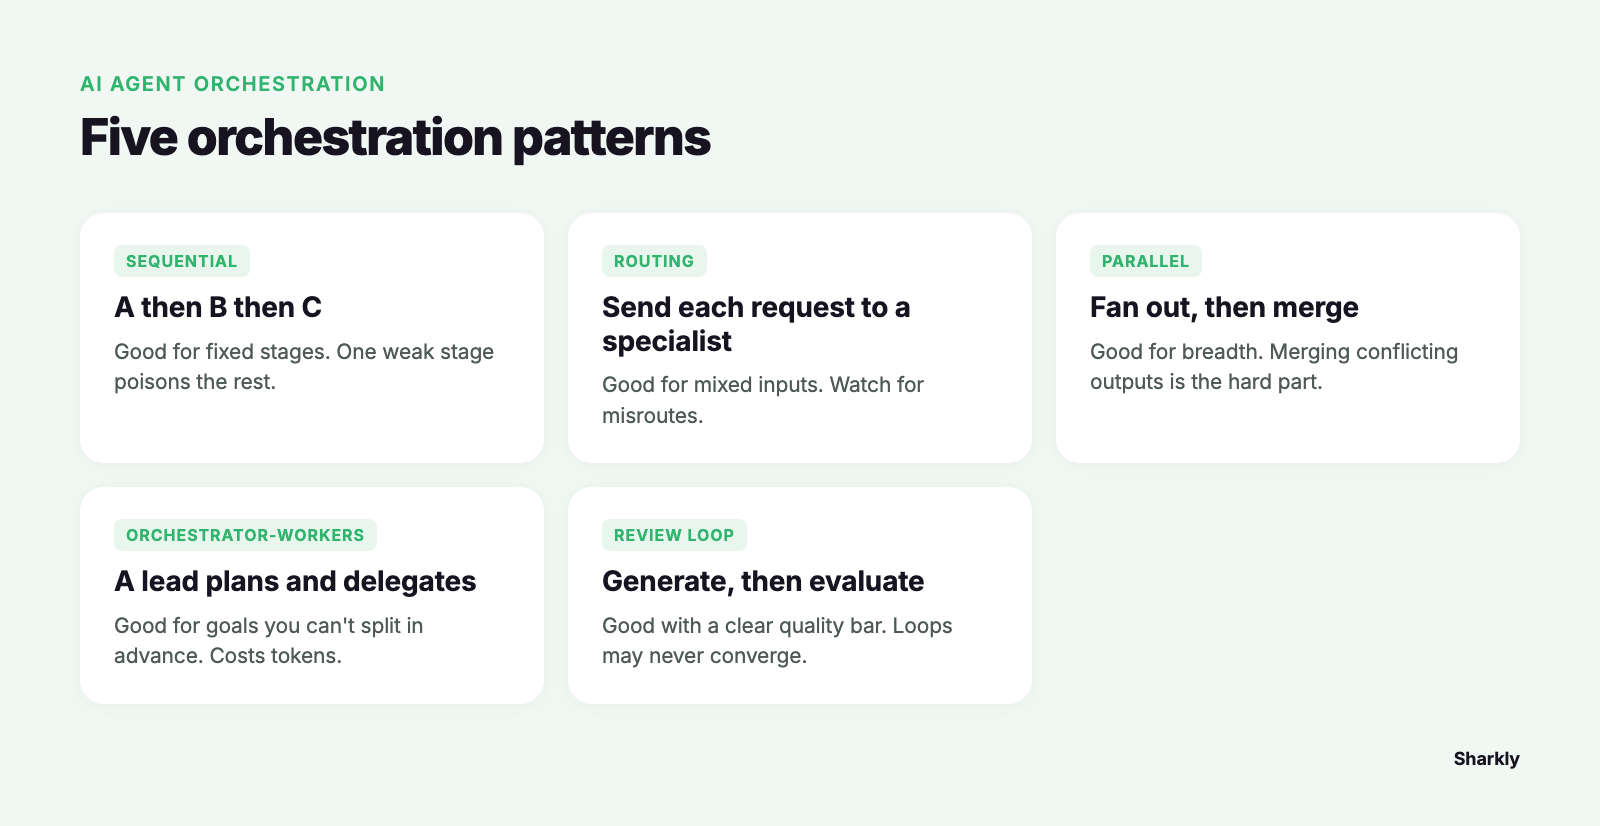
Jedes größere Framework benennt seine Muster anders, im Kern beschreiben sie jedoch dieselben Grundstrukturen. Microsofts Agent Framework, der Nachfolger von AutoGen und Semantic Kernel, bringt fünf Orchestrierungsarten mit. Googles ADK-Musterseite listet sieben auf. Einander gegenübergestellt sieht das so aus:
| Muster | Ablauf | Auch bekannt als | Ideal für | Achtung bei |
|---|---|---|---|---|
| Sequenziell | Ausgabe von Agent A geht an Agent B, danach an C | Prompt Chaining, Pipeline | Feste Phasen: Entwurf, Prüfung, Formatierung | Ein schwacher Zwischenschritt verfälscht alle Folgeschritte |
| Routing | Ein Klassifikator oder Agent leitet jede Anfrage an einen Spezialisten weiter | Handoff, Triage, Koordinator | Unterschiedliche Eingaben, die spezifisches Fachwissen erfordern | Fehlleitungen wirken oft wie das Versagen des Spezialisten |
| Parallel | Unabhängige Teile laufen gleichzeitig, Ergebnisse werden zusammengeführt | Concurrent, Fan-out/Fan-in, Sectioning, Voting | Breite Aufgaben: Recherchen, Reviews aus verschiedenen Blickwinkeln | Zusammenführung widersprüchlicher Ausgaben |
| Orchestrator-Worker | Ein Lead-Agent plant, delegiert und fasst zusammen | Supervisor, Magentic, hierarchisch | Ziele, die sich vorab nicht starr aufteilen lassen | Hohe Token-Kosten und Fehlentscheidungen des Lead-Agenten |
| Review-Schleife | Ein Agent generiert, ein anderer bewertet, anschließende Wiederholung | Evaluator-Optimizer, Generate-and-Review | Aufgaben mit klaren Qualitätskriterien | Schleifen, die nie konvergieren |
Anthropics Beschreibung des Orchestrator-Worker-Musters ist genau das, was die meisten meinen, wenn sie von „Orchestrierung“ sprechen: „Ein zentrales LLM teilt Aufgaben dynamisch auf, delegiert sie an Worker-LLMs und führt deren Ergebnisse zusammen.“ Der Gruppenchat, bei dem Agenten in einem gemeinsamen Thread diskutieren, ist eine sechste Variante, die manche Frameworks ergänzen. Microsofts Architekturleitfaden empfiehlt dafür maximal drei Agenten.
Was die Orchestrierung von KI-Agenten kostet
Die Argumente für die Orchestrierung sind überzeugend. Anthropics Multi-Agent Research System, bei dem ein Lead-Agent parallel 3 bis 5 Sub-Agenten startet, übertraf den Einzelagenten Claude Opus 4 im internen Research-Benchmark um 90,2 %, und die Parallelisierung „verkürzte die Recherchezeit bei komplexen Anfragen um bis zu 90 %“.
Derselbe Beitrag nennt jedoch auch den Preis dafür: Agenten verbrauchen etwa viermal so viele Tokens wie ein Chat, und „Multi-Agenten-Systeme nutzen etwa 15-mal mehr Tokens als Chats“. Bei BrowseComp „erklärt der Token-Verbrauch allein 80 % der Varianz“ in der Performance. Mehr Agenten bedeuten vor allem mehr Leseaufwand – das zahlt sich bei umfangreichen Recherchen aus, ist bei eng umrissenen Aufgaben jedoch reine Geldverschwendung.
Deshalb beginnen sowohl Anthropic als auch Microsoft mit demselben Ratschlag: Anthropic empfiehlt, „die einfachste mögliche Lösung zu wählen und die Komplexität erst bei Bedarf zu erhöhen“. Microsofts Leitfaden formuliert es so: „Nutzen Sie das geringste Maß an Komplexität, das Ihre Anforderungen zuverlässig erfüllt.“ Bei den meisten einzelnen Änderungen schlägt ein einzelner Agent mit einer präzise formulierten Aufgabe einen Graphen aus fünf Agenten.
So sieht die denkbar kleinste Orchestrierung in einem Coding-Tool aus: Ein Claude-Code-Sub-Agent ist eine Datei in .claude/agents/, an die die Haupt-Session delegiert:
---
name: test-writer
description: Writes missing unit tests for a module after a feature lands.
tools: Read, Edit, Bash
isolation: worktree
---
Write unit tests for the module you are given. Match the existing test style.
Run the suite and report which tests you added and whether they pass.
Das ist das Orchestrator-Worker-Muster in acht Zeilen: Die Haupt-Session fungiert als Lead, der Sub-Agent arbeitet in einem eigenen Kontextfenster sowie einem eigenen Worktree, und das Ergebnis geht zurück an den Lead.
Orchestrierung von KI-Agenten für Coding-Agenten
Coding-Agenten unterliegen Einschränkungen, die es bei Research-Agenten nicht gibt. Ihre Arbeitsergebnisse landen in einem gemeinsam genutzten Repository – zwei Agenten können also Änderungen vornehmen, die für sich genommen korrekt sind, sich gegenseitig jedoch widersprechen. Die Agent Teams von Claude Code, die experimentell und standardmäßig deaktiviert sind, bringen es auf den Punkt: „Wenn zwei Teammitglieder dieselbe Datei bearbeiten, führt das zu Überschreibungen.“
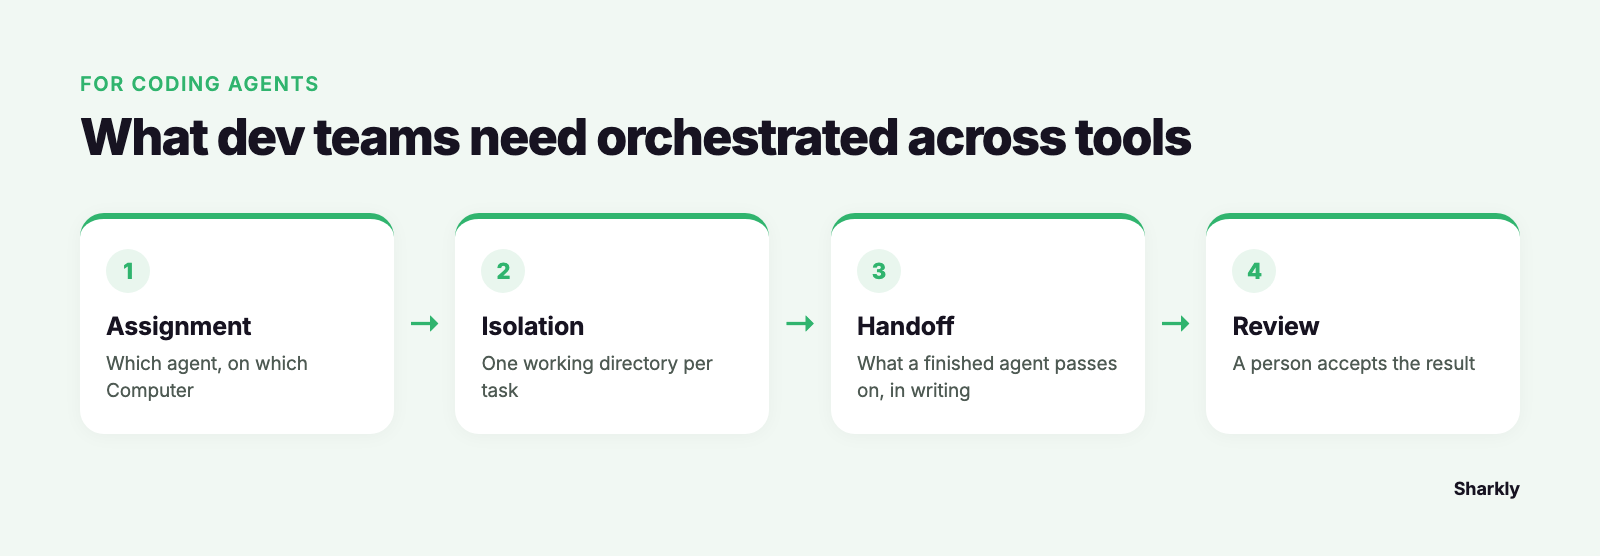
Mittlerweile orchestriert jeder Anbieter innerhalb seines eigenen Ökosystems: Claude Code bietet Sub-Agenten und Agent Teams. Codex aktiviert Sub-Agenten-Workflows standardmäßig. GitHub hat im Februar das Agent HQ angekündigt, mit der Möglichkeit, „ein Issue Copilot, Claude, Codex oder allen dreien zuzuweisen, um die Ergebnisse zu vergleichen“. Was jedoch keines dieser Tools leistet, ist die Koordination über Tool- und Personengrenzen hinweg – genau die Ebene, die Entwicklungsteams im Arbeitsalltag betrifft:
- Zuweisung: Welcher Agent auf welchem Computer übernimmt diesen Task? Unser Beitrag darüber, welcher Coding-Agent welche Aufgabe erhalten sollte, behandelt das Thema Routing.
- Isolation: Ein eigenes Arbeitsverzeichnis pro Task, damit parallele Arbeiten sich nicht gegenseitig beschädigen.
- Übergabe: Eine schriftliche Dokumentation dessen, was ein fertiger Agent übergibt. Siehe dazu unsere Handoff-Vorlagen für Coding-Agenten.
- Review: Ein Mensch prüft und akzeptiert das Ergebnis vor dem Mergen. Der Human-in-the-Loop-Review-Workflow beschreibt, an welcher Stelle dieser Kontrollpunkt platziert wird.
Nutzen Sie ein Orchestrierungs-Framework wie LangGraph, das OpenAI Agents SDK, das Microsoft Agent Framework oder ADK, wenn Sie ein Agentenprodukt entwickeln und die volle Kontrolle über jeden Einzelschritt benötigen. Setzen Sie auf eine Management-Ebene, wenn die Agenten bereits vorhanden sind – etwa als Sessions in Claude Code, Codex oder Gemini CLI – und die eigentliche Herausforderung darin besteht, deren Arbeit im gesamten Team zu koordinieren.
Die Rolle von Sharkly bei der Orchestrierung von KI-Agenten
Sharkly ist kein Framework zum Erstellen von Agenten und kein Ersatz für Claude Code, Codex oder andere Ausführungstools. Es ist die übergeordnete Management- und Orchestrierungsebene darüber. Sie nutzen bereits Coding-Agenten – Sharkly macht daraus ein eingespieltes Team.
Das Orchestrator-Worker-Muster spiegelt sich in sogenannten Crews wider: einer wiederverwendbaren Gruppe aus Menschen und Agenten, die von einem leitenden Agenten koordiniert wird. Sharklys Crews-Dokumentation liefert die Entscheidungsregel: „Weisen Sie kleine, klar definierte Aufgaben direkt einem einzelnen Agenten zu. Nutzen Sie eine Crew, wenn der Leader das Ziel interpretieren, weitere Agenten-Mitglieder einbinden und deren Ergebnisse zusammenführen muss.“ Die Ausführung erfolgt Leader-first, und ein im Backlog verbleibender Crew-Task startet den Leader nicht.
Ganz gleich, für welche Struktur Sie sich entscheiden: Der Ablauf bleibt einheitlich. Der Task definiert das Ziel, jeder Durchlauf läuft auf einem Ihrer Computer – standardmäßig in einem separaten Verzeichnis – und Status, Blocker sowie Ergebnisse fließen zurück in den Task. Agenten recherchieren, implementieren, testen und berichten. Menschen geben die Richtung vor, erteilen Freigaben und nehmen die Ergebnisse ab. Der Bereich über Crews auf der Funktionsseite zu Agenten zeigt, wie ein Leader delegiert, und der Beitrag zu Sharkly Crews führt Schritt für Schritt durch ein Beispiel.
Wenn Ihre Agenten bereits einsatzbereit sind und die eigentliche Herausforderung darin besteht, sie über Teammitglieder und Repositories hinweg zu koordinieren – genau für dieses Problem wurde Sharkly entwickelt.
FAQ
Ist die Orchestrierung von KI-Agenten dasselbe wie ein Multi-Agenten-System? Nahe dran, aber nicht identisch. Ein Multi-Agenten-System bezeichnet die Gesamtheit der Agenten. Orchestrierung ist die Koordinationslogik: Wer läuft wann, mit welchem Kontext und wie werden die Ergebnisse kombiniert? Ein System mit einem einzelnen Agenten und mehreren Tools erfordert kaum Orchestrierung.
Was ist der Unterschied zwischen KI-Agenten-Orchestrierung und allgemeiner KI-Orchestrierung? KI-Orchestrierung bezieht sich in der Regel auf die Verknüpfung von Modellen, Daten-Pipelines und Tools zu einem Workflow. Die Orchestrierung von KI-Agenten ist spezifischer: Sie koordiniert Agenten, die innerhalb einer Aufgabe eigenständige Entscheidungen treffen.
Brauche ich ein Framework wie LangGraph, um Agenten zu orchestrieren? Nur dann, wenn Sie die Agenten selbst entwickeln. Coding-Agenten wie Claude Code und Codex orchestrieren ihre eigenen Sub-Agenten bereits intern. Die verbleibende Aufgabe besteht darin, komplette Durchläufe zu koordinieren: Zuweisung, Isolation und Review. Unser Leitfaden zur Zuweisung des ersten Tasks an einen KI-Agenten setzt genau dort an.
Mit welchem Orchestrierungsmuster für KI-Agenten sollte ich beginnen? Starten Sie mit einem einzelnen Agenten und einer klar definierten Aufgabe, gefolgt von sequenziellen oder parallelen Abläufen, die Sie per Code steuern. Wechseln Sie erst zum Orchestrator-Worker-Muster, wenn sich die Arbeit vorab nicht aufteilen lässt und die anfallenden Token-Kosten den Mehrwert rechtfertigen.


