
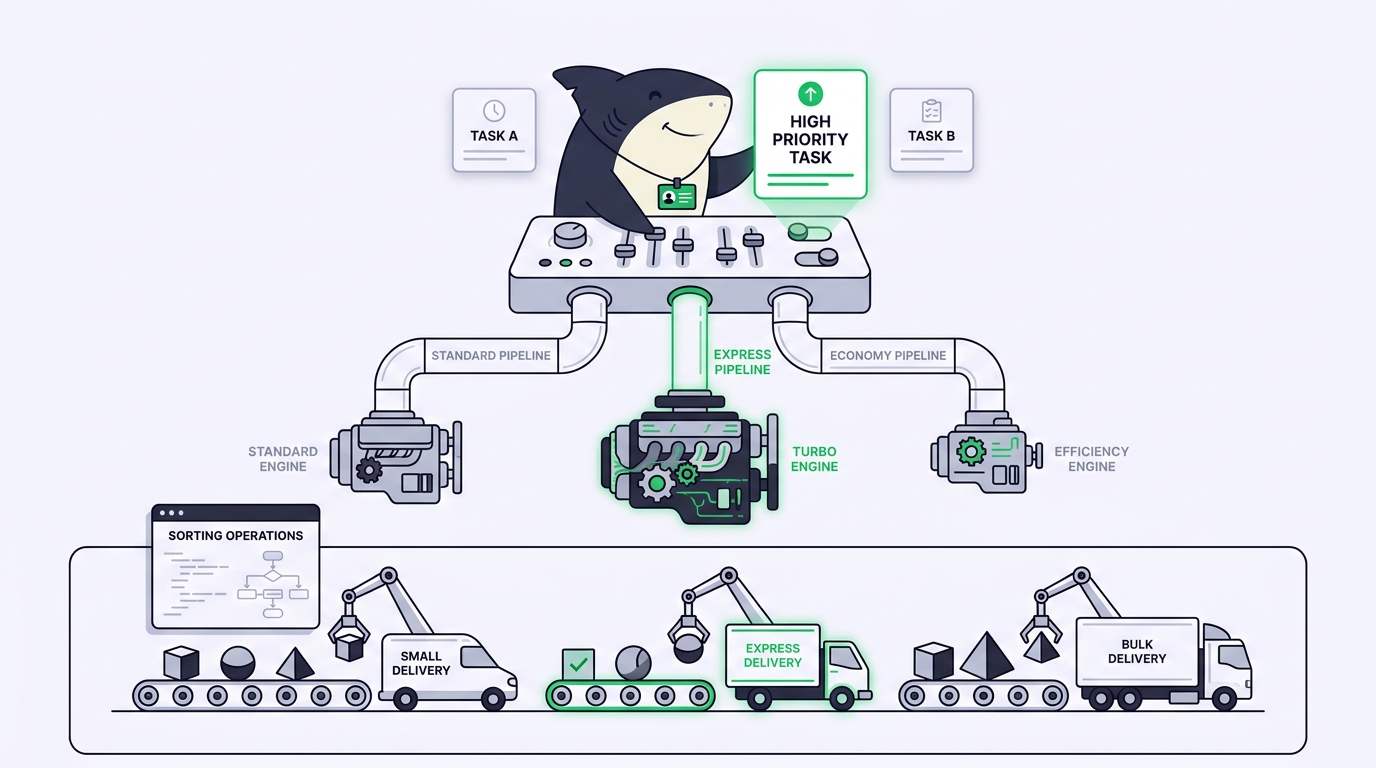
TL;DR: Hör auf, nach dem einen besten Modell zu suchen. Ordne jedes Modell der Form der Aufgabe zu, die gerade vor dir liegt: tiefes Reasoning für Architektur und dateiübergreifende Refactorings, schnell und günstig für Boilerplate und Tests, langer Kontext für Fragen zum gesamten Repository, zuverlässige Tool-Nutzung für mehrstufige Änderungen. Die Auswahl pro Terminal funktioniert bei ein oder zwei Agenten. Sobald du mehrere Aufgaben über verschiedene Repos hinweg laufen lässt, gehört dieses Mapping in einen gespeicherten Agenten – nicht in deinen Kopf. Hier kommt die Zuordnung, ein durchgerechnetes Beispiel und eine Checkliste, die du heute noch durchgehen kannst.
Du hast fünf Terminals offen. In einem läuft ein vertracktes Refactoring, eines braucht einen Schwung Unit-Tests, eines beantwortet Fragen zu einer Codebasis, an die du dich nur halb erinnerst, eines jagt einen flaky Integrationstest, und in einem wird ein Symbol über vierzig Dateien hinweg umbenannt. Jedes stellt dieselbe stille Frage: Welches Modell soll das übernehmen? Setzt du ein schwergewichtiges Reasoning-Modell auf die Umbenennung an, verbrennst du Tokens und Minuten für Arbeit, die jedes schnelle Modell sauber erledigt. Setzt du ein schnelles Modell auf die Architekturänderung an, übersieht es eine Abhängigkeit drei Dateien weiter. Die wiederkehrende Klage lautet selten „die Modelle sind schlecht“. Sie lautet: „Ich weiß nicht, welches ich nehmen soll.“
Die Lösung ist kein Leaderboard. Rankings verschieben sich alle paar Wochen, und der Sieger eines allgemeinen Benchmarks ist für deine konkrete Aufgabe oft die falsche Wahl. Der nachhaltige Ansatz ist, das Modell an die Form der Aufgabe anzupassen: wie viel Reasoning sie braucht, wie viel Kontext es halten muss, wie zuverlässig es Tools befolgen muss und wie viel du pro Durchlauf ausgibst. Diese Eigenschaften ändern sich kaum, auch wenn die Modellnamen wechseln.
Genau hier verdient sich eine Task-Ebene ihren Platz. Sharkly ist eine All-in-One-Plattform zum Steuern und Verwalten von Agenten. Sie sitzt über deinen Coding-Agenten, sodass „welches Modell für welche Aufgabe“ keine Entscheidung mehr ist, die du in jedem Terminal neu triffst. Du speicherst die Entscheidung einmal als Agenten – eine wiederverwendbare Konfiguration aus Rolle, Runtime und den zugehörigen Regeln – und weist dann die Task dem Agenten zu, dessen Form passt. Deine Coding-Agenten hast du schon. Sharkly macht daraus ein Team.
Das Modell an die Form der Aufgabe anpassen – nicht an das Leaderboard
Eine Modellentscheidung sind eigentlich vier Fragen, die in dieser Reihenfolge gestellt werden.
- Reasoning-Tiefe. Braucht die Aufgabe mehrstufige Planung über mehrere Dateien hinweg, oder ist sie eine lokale, mechanische Änderung? Architektur, knifflige Refactorings und Root-Cause-Debugging profitieren von einem stärkeren Reasoning-Modell. Umbenennungen, Formatierung und Scaffolding nicht.
- Kontextgröße. Muss das Modell ein ganzes Repository, eine lange Spezifikation oder ein riesiges Log auf einmal halten? Fragen zur gesamten Codebasis und große Migrationen profitieren von einem Long-Context-Modell, selbst wenn es etwas weniger tief reasoniert.
- Zuverlässigkeit bei der Tool-Nutzung. Mehrstufige Arbeit (bearbeiten, Tests ausführen, Ausgabe lesen, erneut bearbeiten) steht und fällt damit, wie konsequent das Modell Tools nutzt, ohne vom Skript abzuweichen. Ein Modell, das brillant reasoniert, aber vergisst, den Test auszuführen, ist hier schlechter als ein gleichmäßiger arbeitendes.
- Geschwindigkeit und Kosten. Arbeit mit hohem Volumen und geringem Risiko (Tests, Boilerplate, Docstrings) sollte an das schnellste, günstigste Modell gehen, das die Messlatte überschreitet. Spar dir das teure Reasoning für die Aufgaben, bei denen es den Ausschlag gibt.
Nutze ein schwergewichtiges Reasoning-Modell, wenn ein falscher Schritt dich einen Nachmittag Debugging kostet. Nutze ein schnelles, günstiges Modell, wenn die Aufgabe mechanisch und leicht zu überprüfen ist. An den meisten Tagen brauchst du beides – gleichzeitig, für verschiedene Aufgaben. Deshalb fühlt sich eine einzige globale Modelleinstellung falsch an: Sie zwingt Aufgaben, die unterschiedliche Antworten brauchen, eine einzige auf.
Eine grobe Zuordnung von Aufgabentyp zu Modellrolle
Die untenstehenden Aufgabennamen überleben jede konkrete Modellversion. Lies die aktuelle Model Card des Anbieters, bevor du einen Bucket an einen Namen bindest – und behalte dann den Bucket.
| Aufgabe vor dir | Optimieren für | Modellrolle |
|---|---|---|
| Architektur, dateiübergreifendes Refactoring, Design Review | Reasoning-Tiefe | Schwergewichtiges Reasoning-Modell |
| Root-Cause-Debugging, Jagd auf flaky Tests | Reasoning + stabile Tools | Schwergewichtiges Reasoning-Modell |
| Q&A zum gesamten Repo, große Migration, Arbeit mit langen Spezifikationen | Kontextgröße | Long-Context-Modell |
| Unit-Tests, Boilerplate, Docstrings, Scaffolding | Geschwindigkeit und Kosten | Schnelles, günstiges Modell |
| Mechanische Umbenennung, Formatierung, Massenbearbeitung | Geschwindigkeit | Schnelles, günstiges Modell |
| Mehrstufige Agent-Schleife (bearbeiten, testen, wiederholen) | Zuverlässigkeit bei der Tool-Nutzung | Stabiler Tool-Nutzer |
Zwei ehrliche Anmerkungen. Erstens: „Schwergewichtig“ heißt nicht „immer besser“. Bei einer Umbenennung ist ein tiefes Reasoning-Modell langsamer, teurer und nicht korrekter als ein schnelles. Zweitens: Eine Runtime wie Claude Code, Codex oder Gemini CLI bringt ihr eigenes Standardmodell mit, und die Modellnutzung läuft weiter über die Abonnements oder API-Keys, die im Tool konfiguriert sind. Deine realen Optionen sind also die Modelle, für die dein Team ohnehin zahlt – zugeordnet zu diesen Buckets. Öffentliche Aufgaben-Benchmarks wie SWE-bench sagen dir grob, in welcher Liga ein Modell spielt, nicht welches Modell deine konkrete Aufgabe braucht.
Wo die Modellwahl pro Terminal nicht mehr skaliert
Bei ein oder zwei Agenten ist Handarbeit völlig in Ordnung. Du öffnest ein Terminal, stellst das Modell ein und weißt, was wo läuft, weil es nur zwei sind. Das Setup, das heute funktioniert, besteht aus einer Person und ein paar Tools.
Probleme beginnen bei Volumen. Lässt du sechs Aufgaben über drei Repositories laufen, lebt das Mapping von Modell zu Aufgabe plötzlich in deinem Kopf: Welches Terminal ist das günstige, welches Repo hast du letzten Dienstag auf das Reasoning-Modell gesetzt, warum kriecht die Migration (du hast sie auf dem schnellen Modell gelassen). Wenn ein Teammitglied deine Arbeit übernimmt, reist das Mapping nicht mit der Aufgabe mit; es bleibt in deinem Gedächtnis, und Ergebnisse verteilen sich über private Terminals, statt irgendwo gemeinsam aufzulaufen.
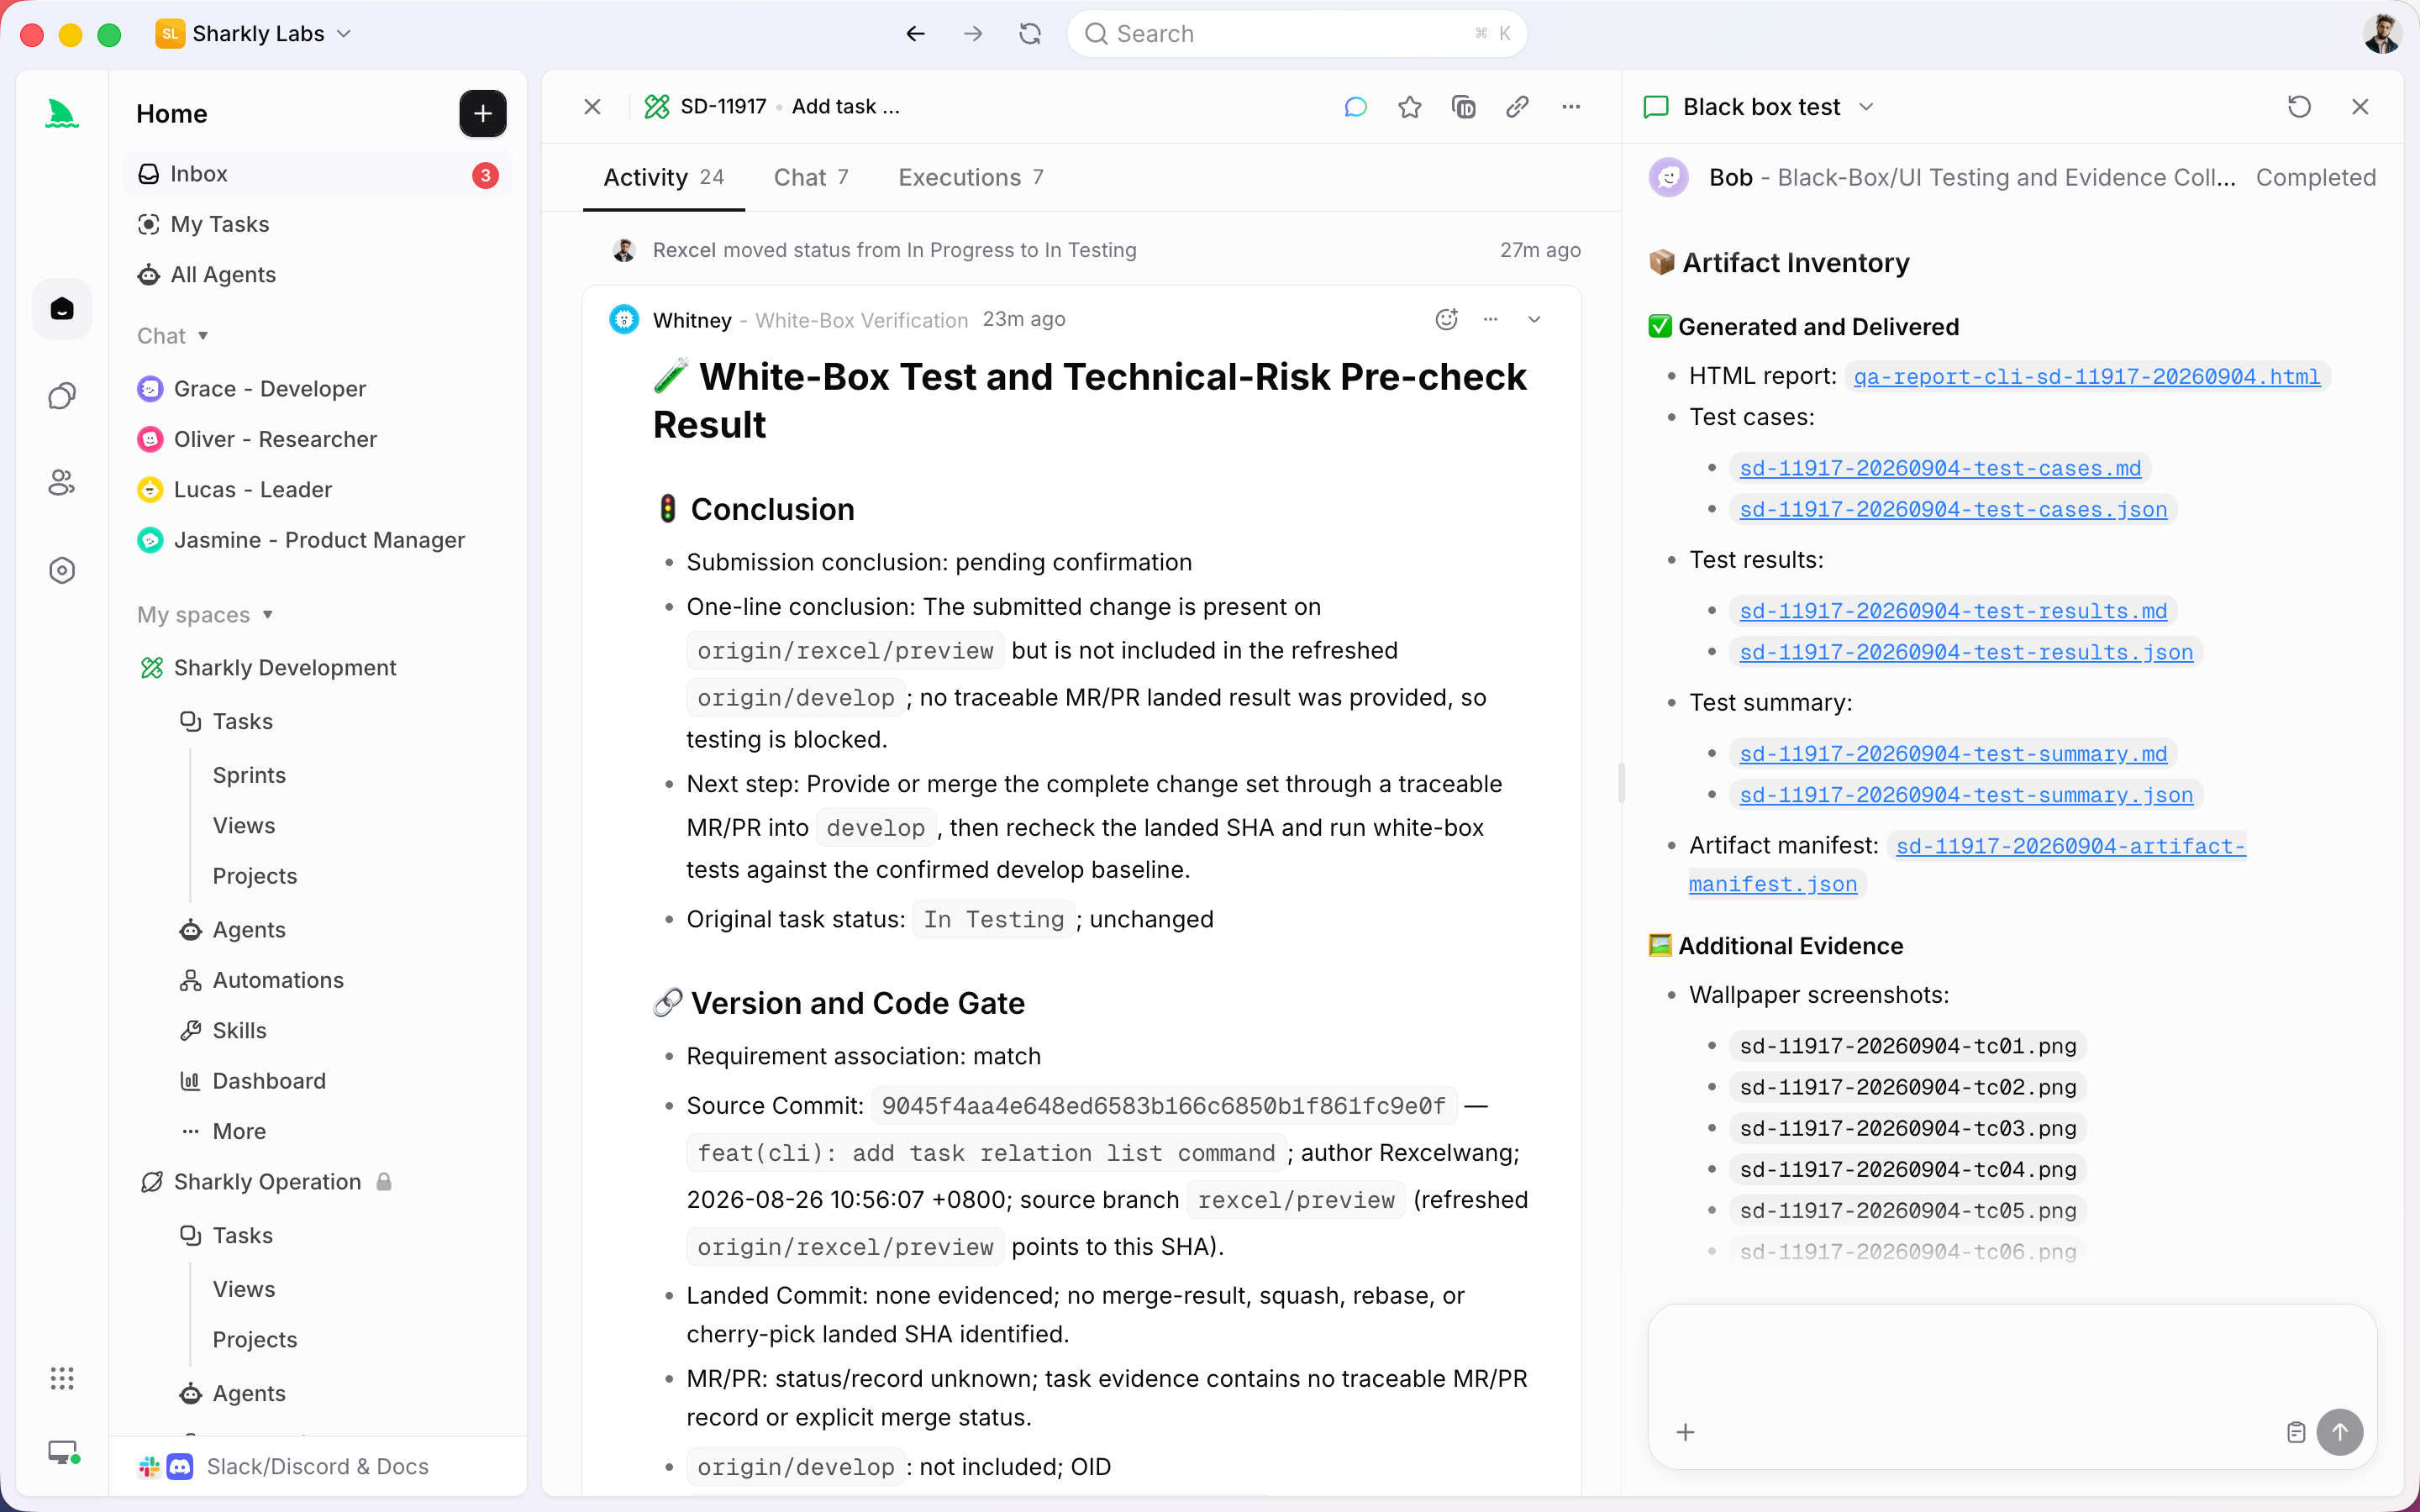
Ein Agent ist eine gespeicherte Konfiguration dafür, wie eine Art von Arbeit erledigt werden soll: eine Rolle, eine Runtime samt Modell und die dazugehörigen Regeln. Statt das Modell pro Terminal neu zu entscheiden, baust du den Agenten einmal („Test Writer“ auf einem schnellen Modell, „Refactorer“ auf einem Reasoning-Modell) und weist die Task dem Agenten zu, dessen Form passt. Die Modellwahl wird wiederverwendbar statt zum Memory-Spiel. Agenten recherchieren, führen aus, testen und berichten; Menschen geben die Richtung vor und nehmen das Ergebnis ab. Ausführung, Blocker und Ergebnisse landen wieder bei der Task, sodass die Begründung hinter jeder Modellwahl vom Request bis zum Release sichtbar bleibt statt im Scrollback zu versinken.
Sharkly ist kein Ersatz für Claude Code, Codex oder die anderen Ausführungstools. Es ergänzt die gemeinsame Task-, Kontext- und Review-Ebene rund um die Modelle, die dein Team ohnehin nutzt. Wenn du immer nur einen Agenten in einem Terminal laufen lässt, brauchst du es nicht. Sobald du mehrere Agenten parallel laufen lässt, ist die Modell-Zuordnung genau das, was es sich zu speichern lohnt.
Ein durchgerechnetes Beispiel: drei Aufgaben, drei Agenten
Angenommen, ein Sprint wirft drei Aufgaben in die Queue.
- SH-312:
UserSessionim gesamten Repo inAuthSessionumbenennen. Mechanisch, leicht zu überprüfen. Leite sie an einen „Renamer“-Agenten auf einem schnellen, günstigen Modell weiter. Er bearbeitet, führt den Type Checker aus und liefert einen sauberen Diff. Reasoning-Tokens sind hier rausgeworfenes Geld. - SH-318: Der Checkout-Flow berechnet beim Retry doppelt. Root-Cause-Debugging über mehrere Services hinweg. Leite sie an einen „Debugger“-Agenten auf einem schwergewichtigen Reasoning-Modell mit stabiler Tool-Nutzung weiter. Er muss planen, Logs lesen, eine Hypothese bilden und sie testen. Ein schnelles Modell rät hier nur und verschwendet einen Review-Zyklus.
- SH-324: die Frage „Wie gleicht unser Billing mit Stripe ab?“ aus der Codebasis beantworten. Eine Frage ans gesamte Repo. Leite sie an einen „Codebase Analyst“-Agenten auf einem Long-Context-Modell weiter, das die relevanten Dateien auf einmal halten kann.
Jeder Agent läuft in seinem eigenen isolierten Worktree, sodass drei Modelle gleichzeitig an drei Aufgaben arbeiten, ohne sich gegenseitig in die Quere zu kommen. Jedes Ergebnis kehrt zu seiner Task zurück, mit Änderungszusammenfassung und Belegen. Du prüfst drei fertige Lieferungen, nicht drei Terminals, die du aus dem Gedächtnis rekonstruieren musst. Die Automatisierung endet dort, wo dein Urteil gefragt ist: Du nimmst ab, forderst Änderungen an oder entscheidest über den Merge.
Die Checkliste, die du heute durchgehen kannst
Geh das durch, bevor du deinen nächsten Schwung Agenten-Arbeit startest.
- [ ] Benenne für jede Aufgabe zuerst ihre Form: reasoning-lastig, kontext-lastig, Tool-Loop-lastig oder mechanisch mit hohem Volumen.
- [ ] Weise das günstigste Modell zu, das die Messlatte für diese Form überschreitet. Behalte das Reasoning-Modell für Aufgaben, bei denen ein falscher Schritt echte Zeit kostet.
- [ ] Gib Long-Context-Arbeit an ein Long-Context-Modell, nicht aus Gewohnheit an deinen Lieblings-Reasoner.
- [ ] Bei mehrstufigen Loops zählt die Zuverlässigkeit bei der Tool-Nutzung mehr als der reine Benchmark-Rang.
- [ ] Schreib das Mapping einmal als wiederverwendbaren Agenten pro Rolle auf, damit du und deine Teammitglieder aufhören, es pro Terminal neu zu entscheiden.
- [ ] Halte einen Menschen bei der finalen Abnahme im Boot. Das Modell wählt den Weg; du genehmigst das Ergebnis.
Ordne das Modell der Aufgabe zu, speichere die Zuordnung als Agenten – und die Frage, mit der alles begann („Welches nehme ich?“), wird nur noch einmal pro Rolle beantwortet statt einmal pro Terminal.
Wenn du weiterhin mehrere Coding-Agenten nutzen willst, statt dich für alles auf ein einziges Modell festzulegen, ist das genau das Problem, für das Sharkly gebaut ist. Du kannst in jedem Terminal ein Modell von Hand auswählen – oder den gesamten Workflow an einem Ort verwalten und jedes Ergebnis zur Task zurückfließen lassen.
FAQ
Sollte ich einfach für alles das am höchsten gerankte Modell nutzen? Nein. Das beste Allround-Modell ist bei mechanischer Arbeit langsamer und teurer als nötig – und dabei nicht korrekter. Der Rang sagt dir, in welcher Liga ein Modell spielt; die Form deiner Aufgabe sagt dir, welche Liga du brauchst. Beides zusammenzubringen ist besser, als einfach den Leaderboard-Sieger als Standard zu nehmen.
Wie wähle ich ein Modell, wenn ich den Schwierigkeitsgrad der Aufgabe noch nicht kenne? Fang günstig an und eskaliere. Gib die Aufgabe zuerst einem schnellen Modell. Wenn es hängen bleibt, rät oder das Review nicht besteht, ist das dein Signal, dass die Aufgabe reasoning-lastig ist, und du beförderst sie zu einem stärkeren Modell. Im Human-in-the-Loop-Review-Schritt erkennst du die Fehlpaarung, bevor sie ausgeliefert wird.
Wählt Sharkly das Modell für mich aus? Sharkly wählt das Modell nicht von selbst. Du bindest eine Rolle an eine Runtime und ihr Modell, wenn du einen Agenten baust, und weist dann Tasks dem Agenten zu, dessen Form zur Arbeit passt. Die Wahl bleibt deine; Sharkly macht sie wiederverwendbar und hält das Ergebnis jedes Durchlaufs an der Task statt in einem privaten Terminal.


