
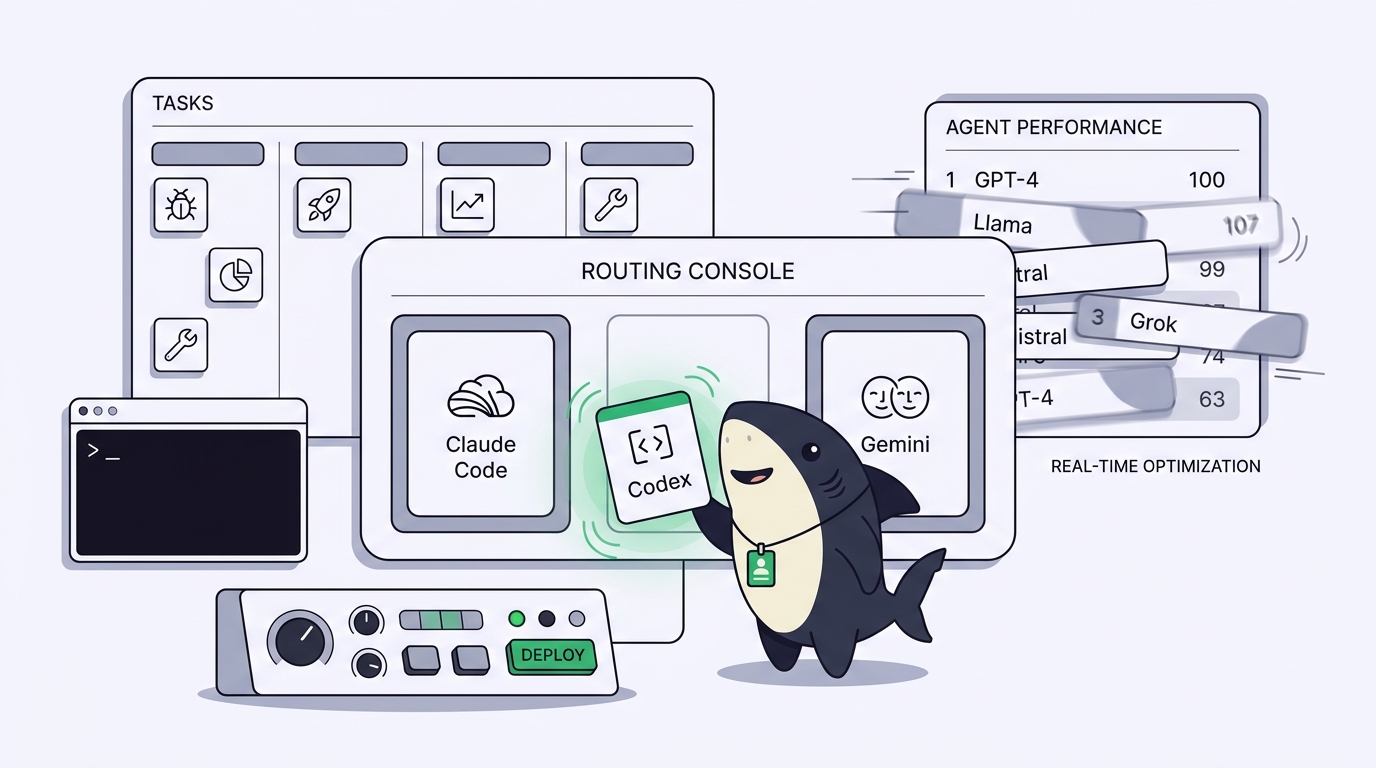
Du versuchst, den besten Coding-Agenten zu finden. Du liest das Leaderboard, verfolgst die Release-Posts, jagst denselben Prompt durch Claude Code, Codex und Gemini CLI, um zu sehen, welcher sich schärfer anfühlt. Dann erscheint ein neues Modell, das Ranking mischt sich neu, und der Agent, auf den du dich letzten Monat festgelegt hast, steht plötzlich im Mittelfeld. Also wechselst du wieder.
Hier ist der unangenehme Teil: Der Agent, den du wählst, verändert deine Woche weniger, als du denkst. Was entscheidet, wie viel du tatsächlich auslieferst, ist das, was rund um den Agenten passiert. Welcher Agent an welcher Aufgabe sitzt, was fertig wurde, was fehlgeschlagen ist, was auf dein Review wartet. Die meisten Entwickler spüren die Anziehungskraft des Rankings und merken nie, dass das Ranking nie der Engpass war.
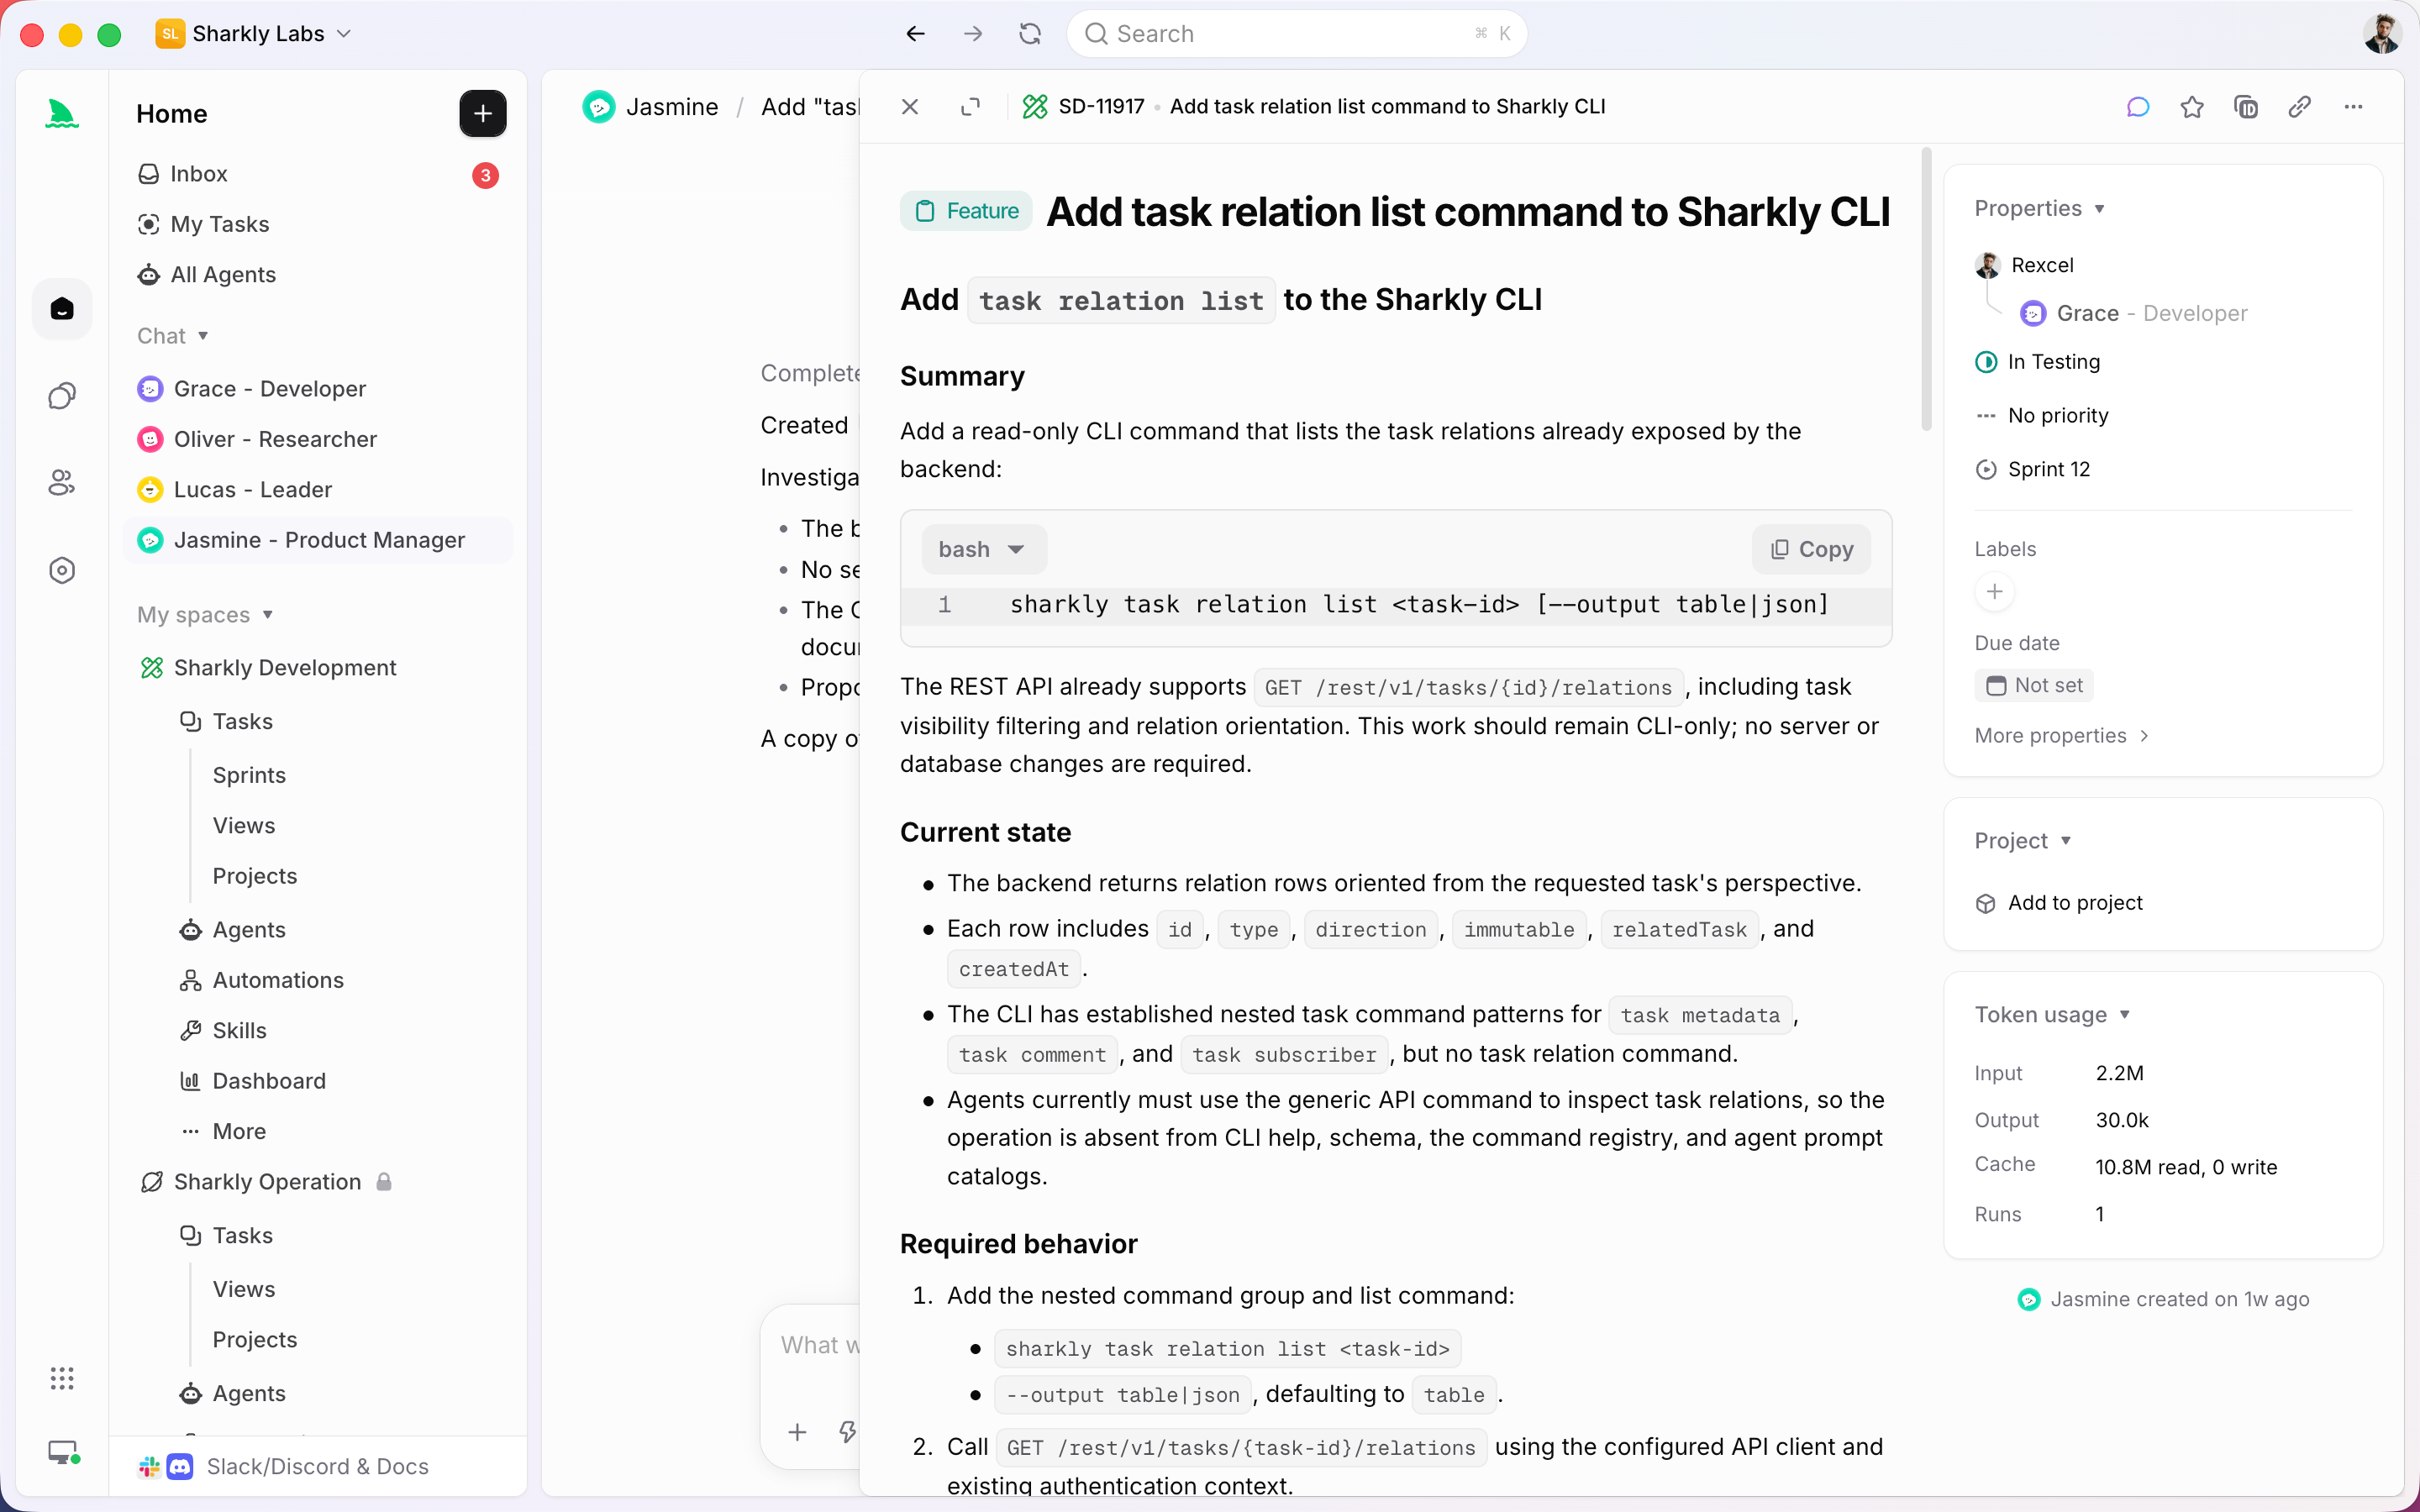
Sharkly basiert genau auf dieser Beobachtung. Sharkly ist eine All-in-One-Plattform zur Steuerung und Verwaltung von Agenten: Du verbindest deinen eigenen Computer, weist jedem Agenten, den du bereits nutzt, einen Task zu, und jeder Run liefert sein Diff, seine Testausgabe und sein Review an einer Stelle zurück. Sharkly sitzt über den Agenten, nicht neben ihnen. Dieser Artikel zeigt, warum die Management-Ebene stärker darüber entscheidet, was du auslieferst, als das Modell – und was du dieses Quartal dagegen tun kannst, statt dem nächsten Leaderboard hinterherzujagen.
Der beste Agent ist ein bewegliches Ziel
Ein Leaderboard für Coding-Agenten misst eine feste, gemeinsame Menge von Problemen zu einem festen Zeitpunkt. Beide Tatsachen veralten schnell. Die Problemmenge ist nicht deine Codebasis, und der Zeitpunkt ist nicht der nächste Monat.
Schau dir das Tempo an. Anthropic, OpenAI und Google haben im vergangenen Jahr jeweils mehrere Modell-Updates mit Coding-Agent-Fähigkeiten veröffentlicht, und das relative Ranking zwischen ihnen hat mehr als einmal gewechselt [VERIFY: genaue Release-Kadenz und aktuelles Ranking ändern sich monatlich; vor dem Zitieren von Details bestätigen]. Wenn du „nutze den besten Agenten“ als Entscheidung betrachtest, verpflichtest du dich, diese Entscheidung jedes Mal neu zu treffen, wenn ein Labor etwas ausliefert. Jeder Wechsel kostet: neue Konfiguration, neue Kontextdateien, neue Gewohnheiten, eine neue Sammlung von Fehlermodi, die dein Team erst lernen muss.
Hier ist eine Vorhersage – und ich kennzeichne sie als solche. Die Lücke zwischen den besten Coding-Agenten wird sich weiter verkleinern, nicht vergrößern. Wenn drei Agenten denselben Bug in deinem Repository beheben, geht es nicht mehr um die Frage „Welcher ist der beste?“, sondern um „Welchem übergebe ich genau diese Aufgabe, und wie sehe ich das Ergebnis?“. Das Unterscheidungsmerkmal verschiebt sich vom Modell auf den Workflow. Diese Verschiebung ist schon daran zu erkennen, wie Teams über Agenten sprechen; sie wird die Standard-Arbeitsweise sein, bevor sie zur Ausnahme wird.
Die Verteidigung gegen ein bewegliches Ziel ist kein besseres Zielen. Es ist ein Workflow, der es übersteht, dass sich das Ziel bewegt. Der Vergleich von Agenten in deiner eigenen Codebasis sagt dir, welche sich heute lohnen; er legt dich nicht auf diese Antwort für morgen fest.
Was wirklich darüber entscheidet, was du auslieferst
Rechne einmal nach, wo eine Aufgabe ihre Zeit verbringt. Der Agent erzeugt ein Diff in Minuten. Alles andere – zu entscheiden, welcher Agent die Aufgabe bekommt, seine Änderungen von den anderen vier Agenten isoliert zu halten, herauszufinden, dass er an einem Build-Schritt hängen geblieben ist, zu lesen, was er produziert hat, es anzunehmen oder abzulehnen – frisst deinen Tag. Nichts davon ist eine Eigenschaft des Modells.
Das ist das Management-Problem, und es taucht in dem Moment auf, in dem du mehr als einen Agenten laufen lässt. Welcher Agent arbeitet woran? Welcher sollte die nächste Aufgabe bekommen? Was ist fertig, was fehlgeschlagen, was muss ein Mensch sich ansehen? Wie verhinderst du, dass drei Agenten, die dasselbe Repository bearbeiten, dieselben Dateien anfassen? Je leistungsfähiger jeder einzelne Agent wird, desto mehr von ihnen lässt du gleichzeitig laufen – und desto schärfer werden diese Fragen.
Sharkly beantwortet sie als Ebene, nicht als Tool. Ein Task ist die zentrale Arbeitseinheit: Du weist ihn einem Agenten zu, der Agent läuft auf einem verbundenen Computer in einem isolierten Worktree, und Ausführung, Blocker, Ergebnisse und Folgearbeiten landen alle wieder im Task. Der Agent, der die Arbeit erledigt hat, ist eine Einstellung am Task, nicht die Architektur deines gesamten Setups. Tausche für den nächsten Task Claude Code gegen Codex aus, und sonst ändert sich nichts an deinem Prozess. Das bringt dir Anbieterneutralität: Dein Workflow überlebt, egal welcher Agent gerade vorn liegt.
Review-Kapazität ist die eigentliche Obergrenze
Ein Agent, der „fertig“ ausgibt, hat noch nichts ausgeliefert. Ein Mensch muss trotzdem das Diff lesen, die Tests prüfen und entscheiden. Dieser Review-Schritt, nicht die Codegenerierung, ist die Grenze, an die fast jedes Team zuerst stößt.
Die Rechnung ist ernüchternd. Wenn ein Agent in zwanzig Minuten einen Tag reviewbarer Arbeit produziert, produzieren fünf Agenten in denselben zwanzig Minuten fünf Tage Review – und du hast immer noch nur ein Paar Augen. Ein schnellerer oder klügerer Agent macht das schlimmer, nicht besser, weil er deine Warteschlange schneller füllt. Den besten Agenten zu wählen, optimiert den Schritt, der nie der Engpass war, und lässt den eigentlichen Engpass unangetastet. Review-Kapazität ist die wahre Grenze dafür, wie viel parallele Agentenarbeit ein Team aufnehmen kann, und kein Modell-Upgrade ändert etwas an dieser Arithmetik.
Das entscheidende Begriffspaar ist also nicht „Claude Code oder Codex“, sondern: Nutze einen schnelleren Agenten, wenn dein Engpass darin liegt, einen ersten Entwurf einer Änderung zu erzeugen. Investiere in deinen Review-Workflow, wenn dein Engpass darin liegt, zu entscheiden, ob eine Änderung korrekt ist. Bei den meisten Teams, die Agenten parallel laufen lassen, greift die zweite Grenze lange vor der ersten. Die Lösung ist, jeden Run mit Belegen auf Task-Ebene reviewbar zu machen: ein Diff, Typecheck- und Testausgabe, eine Zusammenfassung der Änderungen und die Grenzen, die der Agent selbst einräumt – alles an einer Stelle statt über Terminals verstreut.
Hier zahlt sich der Vertrag zwischen Mensch und Agent aus. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Automatisierung endet dort, wo das Urteilsvermögen des Teams gefragt ist. Ein besserer Agent erledigt mehr vom ersten Satz; vom zweiten erledigt er nichts. Die Obergrenze liegt auf deiner Seite dieser Linie.
Mach die Agent-Wahl zu einer Einstellung, nicht zu einer Architektur
Hier ist die Grenze, klar formuliert, damit niemand etwas Falsches annimmt: Sharkly ist kein Coding-Agent und kein Ersatz für Claude Code, Codex oder eine andere Runtime. Sharkly schreibt keinen besseren Code als sie. Es ergänzt die gemeinsame Task-, Computer-, Kontext- und Review-Ebene um die Tools, die dein Team bereits nutzt.
Genau darum geht es. Wenn die Agent-Wahl eine Einstellung ist, kostet dich das Ausprobieren eines neuen Agenten einen Task, keine Migration. Du verbindest die Runtime, weist ihr eine echte Anforderung zu und liest, was zurückkommt – direkt neben den Ergebnissen des Agenten, den du gestern genutzt hast. Wenn die Agent-Wahl fest in deiner Architektur verankert ist, ist jedes Experiment teuer und jedes Leaderboard-Beben eine Bedrohung.
Sei ehrlich, wann du das nicht brauchst. Wenn du nur einen Coding-Agenten nutzt und glücklich in einem einzigen Terminal lebst, reicht eine gut eingestellte Claude-Code-Session in ihrem eigenen Worktree, und die Management-Ebene ist Overhead, den du dir sparen kannst. Die Gleichung ändert sich in dem Moment, in dem du zwei oder mehr Agenten über mehr als einen Task oder ein Repository hinweg laufen lässt und die Ergebnisse in einer Form willst, die ein Teammitglied lesen kann, ohne dass du deinen Scrollback vorliest. Das ist die Schwelle, ab der Coding-Agent-Management zu einer Ebene wird, die du wirklich brauchst, statt nur eine nette Idee zu sein.
Was du dieses Quartal anders machen solltest
Hör auf, die Woche damit zu verbringen, dem Ranking hinterherzujagen. Verbringe sie damit, die Ebene zu bauen, die das Ranking zu einem Detail macht.
Drei konkrete Schritte. Erstens: Wähle deine Agenten auf die langweilige Art – lass zwei von ihnen eine echte Aufgabe aus deinem Backlog bearbeiten und behalte den, der sich in deinem Code besser liest, wohl wissend, dass du die Entscheidung überdenken wirst. Zweitens: Miss deinen Review-Durchsatz ehrlich; wenn Agenten schneller fertig werden, als du ihre Arbeit annehmen kannst, hilft dir das nächste Agenten-Upgrade nicht, ein besserer Review-Flow aber schon. Drittens: Hör auf, einen Agenten fest in deinen Prozess einzubauen. Leite Arbeit durch eine Ebene, die den Agenten als austauschbar behandelt, damit das nächste Modell-Release eine Option ist, die du ausprobierst, und kein Umbau, vor dem du dich fürchtest. Wenn du noch entscheidest, auf welches Modell du welchen Agenten richtest, ist die Zuordnung von Modellen zu Agentenrollen eine bessere Investition für einen Nachmittag als das Aktualisieren eines Leaderboards.
Wenn du weiterhin mehrere Coding-Agenten nutzen willst, statt dich auf ein Ökosystem festzulegen, ist das genau das Problem, für das Sharkly gebaut ist. Lade Sharkly herunter, verbinde einen Computer und weise zwei Agenten denselben echten Task zu. Der beste wird sich ändern. Die Art, wie du sie verwaltest, muss es nicht.


