
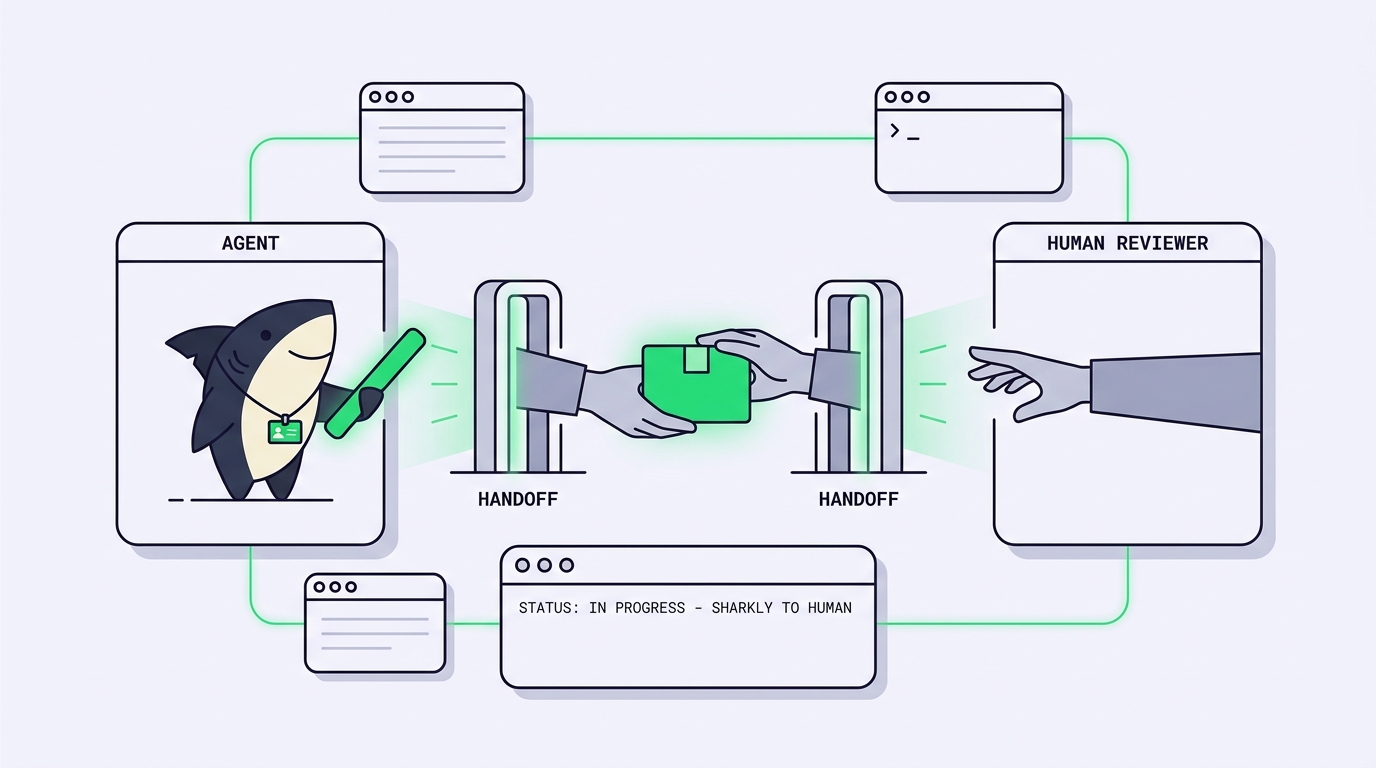
La mayoría de los flujos de trabajo multiagente no fallan en la parte más difícil. El agente escribe el código, ejecuta las pruebas y abre la pull request. Fallan en las costuras: ese instante en el que el trabajo sale de un agente y se supone que debe llegar a otro lugar. Un agente de backend termina un endpoint y el agente de frontend nunca se entera de que está listo. Una refactorización aterriza en un worktree y se queda allí, con las pruebas en verde, porque nadie le avisó a un humano para que la revise. La tarea no se rompió: lo que falló fue el handoff.
Un handoff entre agentes de IA es la transferencia de una unidad de trabajo, junto con su contexto, de un ejecutor al siguiente: de agente a agente, o de agente a humano. Cuando ejecutas un único agente de programación en una sola terminal, los handoffs son invisibles porque directamente no existen. En el momento en que ejecutas dos agentes, o un agente y un revisor, cada paso completado tiene que aterrizar en un lugar donde el siguiente trabajador pueda encontrarlo. Ese punto de aterrizaje lo es todo.
Este artículo analiza los patrones de handoff que realmente funcionan en la práctica, utilizando Sharkly como flujo de trabajo: la capa que se sitúa por encima de tus agentes de programación y mantiene visibles el contexto, el progreso, los bloqueos, los resultados y la revisión humana desde la solicitud inicial hasta el despliegue. Ya cuentas con agentes de código; el problema que resuelve este artículo es lo que ocurre en los vacíos que quedan entre ellos.
En pocas palabras
Un handoff es el punto en el que el trabajo y su contexto pasan de un trabajador al siguiente. Los handoffs entre agentes transfieren una subtarea finalizada al siguiente agente; los handoffs de agente a humano detienen el trabajo autónomo ante una compuerta de revisión. Haz que ambos sean explícitos mediante estados: los agentes mueven una tarea a Ready for review y las personas la pasan a Done. Cuando el handoff consiste en un cambio de estado en una tarea compartida y no en un simple mensaje en una terminal, nada se pierde en el olvido.
Qué es exactamente un handoff entre agentes
Un handoff consta de tres partes, y omitir cualquiera de ellas es la receta perfecta para que el trabajo se extravíe: el artefacto (el diff, la PR, la migración), el contexto (qué se pidió, qué cambió, qué sigue sin resolverse) y el destinatario (el agente o la persona específica que asumirá el siguiente paso).
Los flujos de trabajo basados en terminales conservan el artefacto, pero pierden los otros dos elementos. El commit existe, pero el razonamiento se queda en el búfer de historial que solo un agente vio, y el «quién sigue» depende de quién se pase a mirar por casualidad. Por eso, orquestar agentes consiste menos en ponerlos en marcha y mucho más en enrutar adecuadamente lo que producen.
Un handoff limpio traslada los tres elementos a la vez: el cambio, el resumen de lo que se hizo y lo que quedó pendiente, y una señal inequívoca de que es el turno del destinatario. En términos de Sharkly, la ejecución, los bloqueos, los resultados y los debates de seguimiento regresan al historial de la tarea, de modo que el siguiente trabajador consulta un único registro en lugar de tener que reconstruir tres fuentes distintas.
Dos patrones de handoff
Ambos patrones parecen similares, pero parten de supuestos opuestos por defecto. Un handoff de agente a agente debe fluir automáticamente: el siguiente agente reclama una subtarea lista y continúa el trabajo. En cambio, un handoff de agente a humano debe detenerse por defecto: el agente termina su parte y espera, porque la decisión le corresponde a una persona.
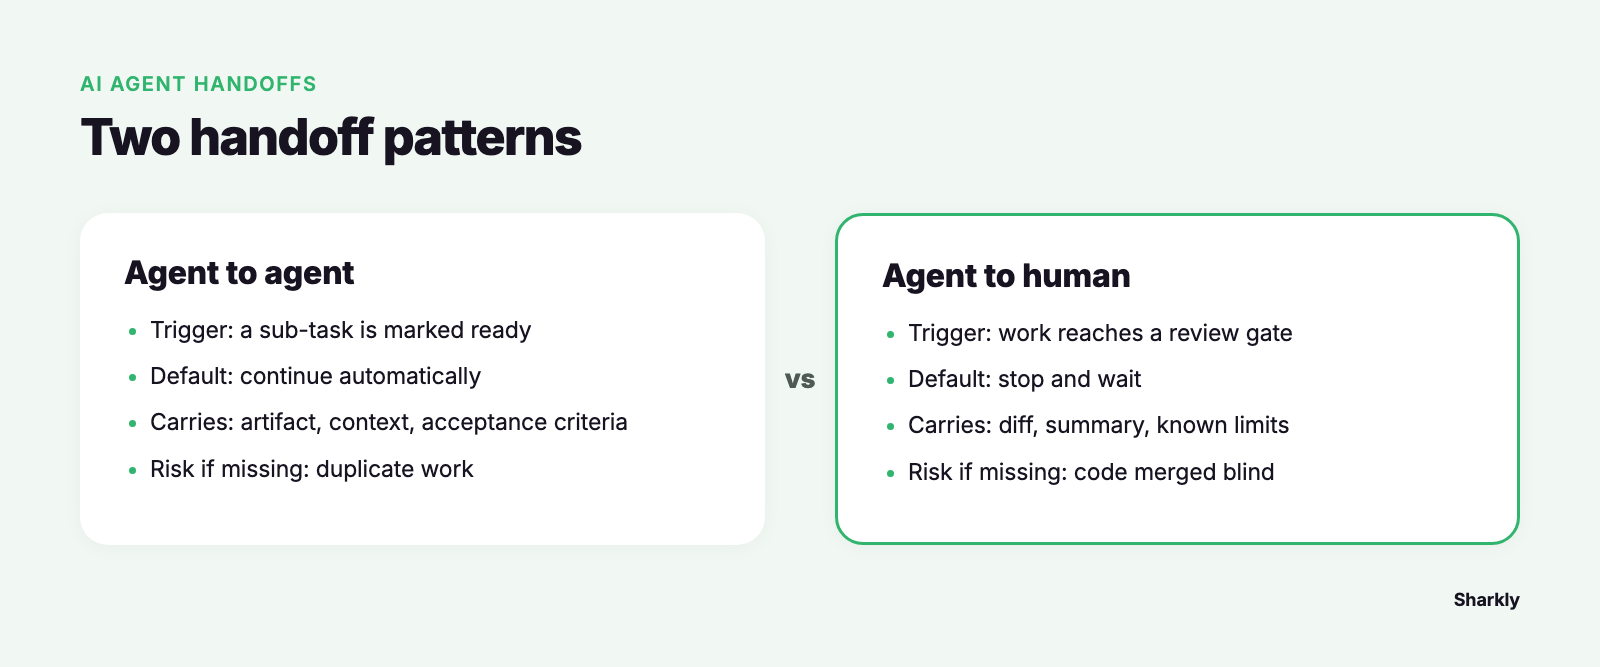
| De agente a agente | De agente a humano | |
|---|---|---|
| Activador | Una subtarea se marca como lista | El trabajo llega a una compuerta de revisión |
| Por defecto | Continuar automáticamente | Detenerse y esperar |
| Transfiere | Artefacto + contexto + criterios de aceptación | Diff + resumen de cambios + limitaciones conocidas |
| Riesgo si se omite | Trabajo duplicado o con conflictos | Fusión a ciegas de código no revisado |
Esta es la regla de decisión que te mantendrá en el camino correcto. Automatiza el handoff de agente a agente cuando el siguiente paso esté bien definido y sus criterios de aceptación ya estén establecidos: «ejecutar la suite de pruebas», «generar la migración», «actualizar la especificación OpenAPI». En cambio, fuerza un handoff de agente a humano cuando el siguiente paso requiera un criterio que el agente no pueda asumir: fusionar en main, modificar un contrato público, tocar autenticación o facturación, o dar por bueno un resultado.
El error está en tratar todos los handoffs por igual. Si automatizas todo el flujo, terminarás fusionando código sin revisar; si bloqueas cada paso con compuertas, habrás reconstruido un proceso manual lento con pasos adicionales innecesarios. Esto se relaciona directamente con saber dónde situar las compuertas de aprobación para que los agentes se detengan antes de cometer errores costosos, y no tras cada detalle trivial.
Los estados convierten el handoff en un punto de control, no en un acto de fe
El modelo operativo se reduce a cuatro verbos y a quién es responsable de cada uno: quién asigna, quién ejecuta, quién revisa y quién aprueba. Los agentes investigan, ejecutan, prueban y reportan. Las personas definen la dirección, conceden autorizaciones y aprueban el resultado. La automatización se detiene justo donde se requiere el criterio del equipo.
Los estados son el mecanismo que vuelve este contrato algo riguroso y operativo, en lugar de una simple declaración de intenciones. Cada tarea avanza por el mismo carril:
- Todo: asignada, no iniciada. Una persona o un agente líder la colocó aquí.
- In progress: un agente la ha reclamado y está trabajando en un worktree aislado.
- Ready for review: el límite del agente. Ha ejecutado la verificación de tipos, las pruebas y la compilación, ha adjuntado el resumen de cambios y las limitaciones conocidas, y se ha detenido.
- Done: el límite de la persona. Alguien ha aprobado el resultado y ha tomado la decisión de fusionar y publicar.
La regla que aporta total claridad al sistema es: los agentes mueven una tarea a Ready for review; las personas la mueven a Done. Un agente nunca marca su propio trabajo como Done, y una persona jamás tiene que adivinar si una tarea con las pruebas superadas es segura. El estado es el handoff. Cuando tienes diez agentes en ejecución, no te pones a revisar diez terminales: miras el tablero y ves con total claridad qué espera por ti, qué espera por otro agente y qué sigue en ejecución. Esa visibilidad marca la diferencia entre hacer un seguimiento de lo que completaron los agentes o cruzar los dedos para que el historial de commits te aclare las cosas más tarde.
Un ejemplo práctico: del ticket al PR fusionado
Tomemos una tarea realista, SH-312: «Añadir rate limiting a la API pública». Fíjate en los handoffs, no en el código.
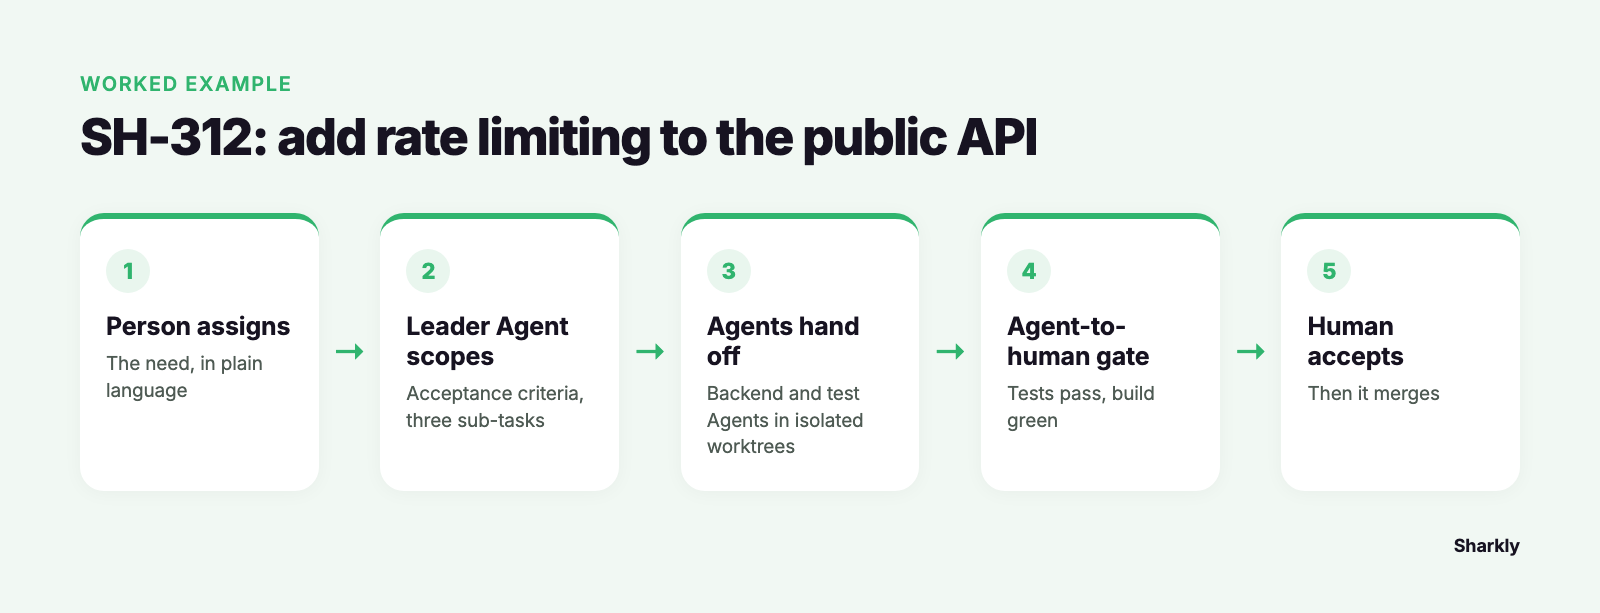
Una persona describe la necesidad en lenguaje natural y la asigna. Un agente líder investiga la base de código y las tareas históricas, redacta el alcance y los criterios de aceptación (límite por clave de API, devolver un código 429 con cabecera Retry-After y cubrir los tres endpoints con mayor tráfico), y desglosa SH-312 en tres subtareas ejecutables. Ese es el primer handoff de agente a agente: entra un objetivo, salen subtareas listas para ejecutar.
Las subtareas fluyen de manera automática. Un agente de backend asume la lógica del limitador; un agente de pruebas asume la cobertura. Dado que cada uno se ejecuta en un worktree aislado, no colisionan en los mismos archivos y cada resultado regresa a SH-312 en vez de perderse en una sesión privada. Cuando el agente de backend termina, no envía un aviso a un humano: marca su subtarea como lista y el agente de pruebas retoma la implementación real en lugar de un simulador (stub).
A continuación, el tipo de handoff cambia. Con el limitador implementado, el chequeo de tipos limpio, las pruebas superadas y la compilación en verde, el trabajo llega a la compuerta de agente a humano. El agente mueve SH-312 a Ready for review y adjunta el diff, un resumen de cambios y una limitación conocida: «El contador basado en Redis asume una única región; el soporte multirregión requiere una tarea de seguimiento». Una persona revisa todo en un único lugar, comprueba el comportamiento del error 429 y lo pasa a Done, lo que activa la fusión. Del ticket al PR fusionado, con un registro claro de quién hizo qué en cada unión. Se trata de la misma trazabilidad de requisitos a código de principio a fin.
Dónde fallan los handoffs y cómo blindarlos
Los handoffs suelen fallar de tres maneras muy predecibles, y cada una de ellas requiere una solución estructural en lugar de un simple «acordarse de hacerlo».
El contexto se evapora. El agente sabía por qué tomó cierta decisión; el revisor no. Solución: el handoff traslada el resumen de cambios y las limitaciones conocidas como parte del paso a Ready for review, y no como una ocurrencia tardía. La responsabilidad se diluye. Dos agentes toman el mismo trabajo o no lo toma ninguno. Solución: un responsable asignado (Assignee) en cada tarea y subtarea, de modo que «tu turno» sea un campo definido y no una simple intuición. La revisión nunca llega a ocurrir. El trabajo autónomo se fusiona porque nadie dio la orden de detenerlo. Solución: un estado que el agente no puede cruzar por sí solo.
Puedes construir todo esto de forma manual con worktrees, una convención de nomenclatura y mucha disciplina. Ese método funciona hasta que aumenta el número de agentes, tareas y repositorios, momento en el que la disciplina es lo primero que se pierde. Si ya estás ejecutando varios agentes, Sharkly te proporciona un lugar centralizado para gestionar sus tareas y resultados: tareas compartidas, responsables por tarea, worktrees aislados y un flujo de estados donde los agentes llegan hasta Ready for review y las personas deciden el paso a Done. Conserva los agentes de programación que ya utilizas y añade la capa que hace visibles sus handoffs. Descarga Sharkly cuando las costuras entre tus agentes empiecen a costar más que el propio trabajo.
Preguntas frecuentes
¿Qué es un handoff entre agentes de IA? Es la transferencia de una tarea, junto con su contexto y la señal de que ahora es el turno de otro ejecutor, de un trabajador al siguiente. Las dos modalidades son de agente a agente (una subtarea completada pasa al siguiente agente) y de agente a humano (el trabajo autónomo se detiene en una compuerta de revisión).
¿Cuál es la diferencia entre los handoffs de agente a agente y los de agente a humano? Los handoffs de agente a agente deben continuar de forma automática cuando los criterios de aceptación del siguiente paso ya están definidos. Los handoffs de agente a humano deben detenerse y esperar, ya que una persona debe aplicar su criterio: fusionar cambios, modificar un contrato público o dar por bueno un resultado.
¿Deberían los agentes marcar su propio trabajo como terminado? No. Permite que los agentes muevan una tarea a Ready for review tras ejecutar las pruebas y adjuntar un resumen; reserva el paso a Done y la decisión de fusionar a una persona. Separar estos dos límites es lo que evita que se envíe a producción código sin revisar. Consulta más sobre agentes de programación con intervención humana (human-in-the-loop).
¿Cómo evitan los estados que se pierda trabajo? Cuando el handoff es un cambio de estado en una tarea compartida y no un mensaje en una terminal, el siguiente trabajador ve con exactitud qué está esperando por él. Nada queda a expensas de que alguien revise el historial adecuado en el momento justo. Una bandeja de entrada de agentes saca a la superficie los elementos que requieren tu atención.
¿Necesito una herramienta específica para esto o puedo hacerlo de forma manual? Puedes gestionarlo con worktrees y un tablero compartido. Una capa dedicada compensa en cuanto coordinas varios agentes en múltiples repositorios y el seguimiento manual se convierte en un cuello de botella. Compara el modelo mental de asistentes frente a compañeros de equipo para tomar una decisión.


