
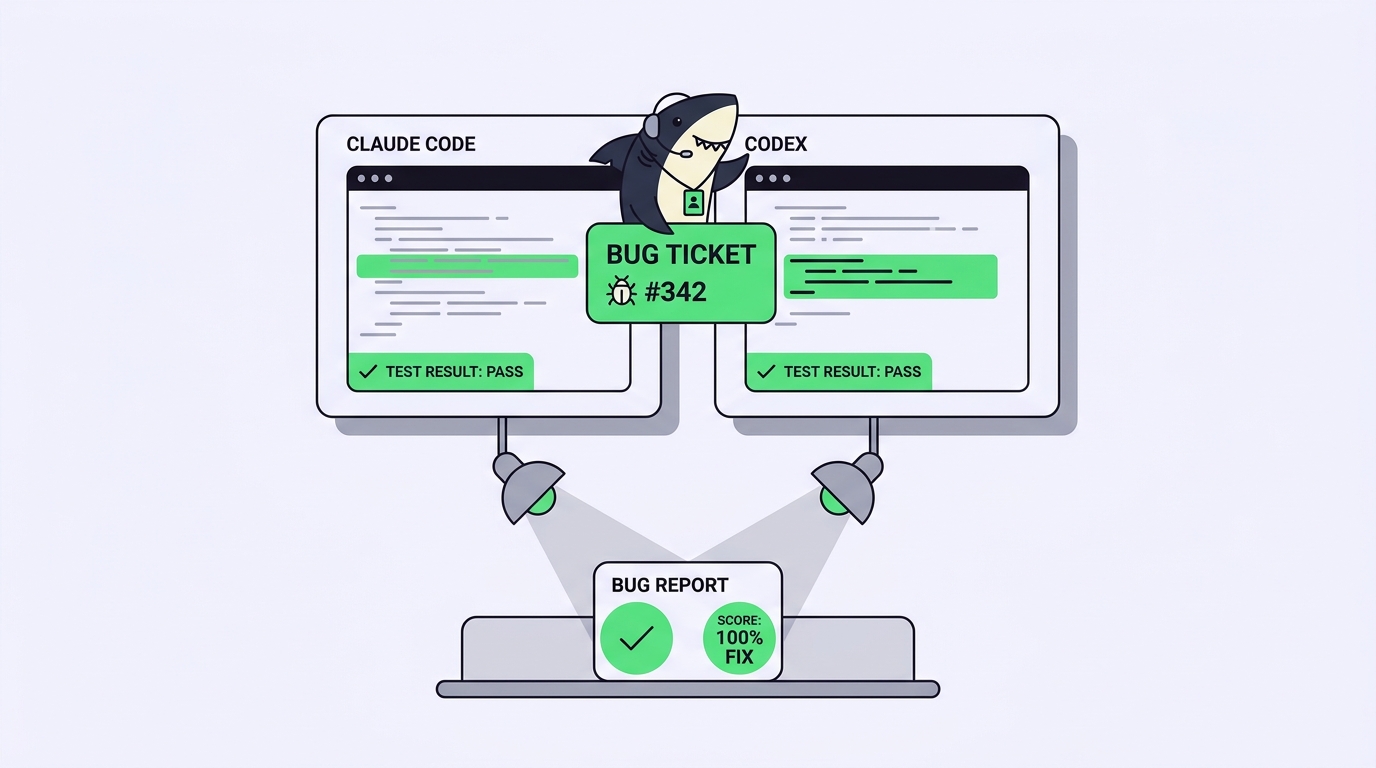
Tienes un bug real abierto y dos agentes que podrían arreglarlo: Claude Code y Codex. Las pestañas están llenas de opiniones sobre cuál es más inteligente, y ninguna te dice a cuál apuntar con este bug, en este repositorio, hoy. Los números de los benchmarks públicos tampoco. Una tabla de clasificación mide un conjunto fijo de problemas de código abierto con un entorno ajustado. Tu bug es un problema privado: tus convenciones, tu test inestable, el módulo que solo entiende una persona.
La forma honesta de responder a «¿Claude Code o Codex?» es ejecutar ambos sobre el mismo bug, en las mismas condiciones, y leer lo que devuelve cada uno. Parece sencillo y se convierte en un caos enseguida: dos agentes editando los mismos archivos, dos terminales, dos conjuntos de resultados de tests y ninguna forma limpia de compararlos lado a lado. La comparación que quieres es sobre los agentes. El trabajo que tienes delante es evitar que choquen.
Esa colisión es lo que elimina Sharkly. Sharkly es una plataforma integral de gestión y comandos de Agentes: asignas la misma Tarea a dos Agentes distintos, cada uno se ejecuta en un Ordenador conectado en su propio worktree aislado, y cada ejecución devuelve su diff, sus resultados de tests y su revisión a un único lugar. Sharkly no sustituye a Claude Code ni a Codex, y no es un entorno de benchmarks. Es la capa que hace posible un cara a cara justo sin abrir una segunda terminal. Esta guía recorre el método, una rúbrica de puntuación para un solo bug y en qué terrenos suele ganar cada agente.
La respuesta rápida
Para comparar Claude Code y Codex con honestidad, dale a ambos el mismo bug, el mismo commit inicial y el mismo test de aceptación, cada uno ejecutándose con su mejor configuración. Después puntúa lo que devuelven: ¿pasa el arreglo?, ¿el diff se mantiene dentro del alcance?, ¿cuánto tardas en revisar el cambio? El agente que gana un bug ha ganado un bug. Aplica el método a varios antes de fiarte del veredicto.
Por qué «cuál es mejor» es la pregunta equivocada
Claude Code y Codex son agentes de programación pensados para la terminal. Leen tu repositorio, editan archivos, ejecutan comandos y reportan. Se diferencian en cómo los configuras y en cómo se comportan bajo presión, pero ninguno va por delante de forma universal en el trabajo que llena un sprint normal.
Una única clasificación global esconde justo lo que te importa. «Cuál es mejor» reduce todo a un número que no sobrevive al contacto con tu base de código. «Cuál es mejor en este tipo de bug, en mi repositorio, a la hora de revisar» sí tiene respuesta, y es la única versión que merece el esfuerzo. Si aún estás decidiendo qué modelo debe ejecutar cada agente, emparejar modelos con roles de agente es una primera pregunta mejor que cualquier tabla de clasificación.
Ejecuta ambos sobre el mismo bug: un método en el que puedes confiar
Una comparación justa mantiene todo constante excepto el agente. Cuatro reglas lo garantizan.
- Elige un bug real, no un prompt de juguete. Escoge un defecto acotado de tu backlog con un test de aceptación que puedas ejecutar y un diff que puedas leer en unos minutos. Redáctalo tal como lo haría tu gestor de incidencias: una tarea como
SH-312: fix the timezone drift in the invoice export. «Crea una app de tareas» no te dice nada sobre tu código. - Da a ambos la misma entrada. La misma descripción de tarea, el mismo commit inicial, los mismos criterios de aceptación. Si Claude Code recibe un prompt más rico que Codex, estás midiendo tu prompt, no al agente.
- Ejecuta cada uno en su mejor versión. Dale a Claude Code su
CLAUDE.md, dale a Codex suAGENTS.mdy su configuración, y proporciona a cada uno los permisos y el modelo que recomienda su propia documentación. Comparar un agente bien configurado con uno básico mide a cuál te molestaste en configurar. - Aísla las dos ejecuciones. Cada agente necesita su propia copia de trabajo. Dos agentes en un mismo checkout se sobrescribirán entre sí, y pasarás la tarde desenredando un merge en lugar de leer dos intentos limpios. Para eso están los worktrees aislados.
Ejecuta los dos intentos y luego descarta la rama perdedora. Te quedas con el arreglo en el que confías y con la evidencia de por qué.
Una rúbrica de puntuación para un solo arreglo de bug
«¿Pasó?» es un solo bit de información. Un arreglo real se decide por más que eso, y escribir la rúbrica antes de mirar mantiene honesta la comparación.
| Qué puntúas | Qué pregunta responde | Por qué importa |
|---|---|---|
| Corrección | ¿Pasa el test de aceptación y no se rompe nada más? | El mínimo. Un agente que imprime «hecho» no ha pasado nada. |
| Disciplina de alcance | ¿El diff tocó solo lo que el bug necesitaba? | Un arreglo que reescribe cuatro archivos no relacionados cuesta más de revisar de lo que ahorra. |
| Calidad de los tests | ¿Añadió o actualizó el agente un test que detectaría la regresión? | Un arreglo sin test es un arreglo que volverás a hacer. |
| Tiempo de revisión | ¿Cuánto tardaste en confiar en el cambio? | A menudo es el verdadero cuello de botella, y es fácil ignorarlo hasta que te consume la tarde. |
| Honestidad | ¿Señaló el agente sus propios límites y supuestos? | La ejecución en la que puedes confiar es la que te dice qué no verificó. |
Puntúa ambos intentos con los mismos cinco criterios, sobre el mismo bug, y el ganador deja de ser cuestión de gustos. El tiempo de revisión merece un peso extra: dos agentes pueden terminar en veinte minutos y aun así costarte una hora revisar cada uno. Esa hora suele ser el verdadero límite de cuánto trabajo de agentes puede absorber un equipo.
Dónde suele ganar cada uno
Aquí no hay números inventados, solo lo que conviene observar. Claude Code se apoya en la memoria de proyecto de su CLAUDE.md y tiende a mantenerse dentro de las convenciones del repositorio en cambios que tocan varios archivos, lo que se nota en refactorizaciones que abarcan varios módulos. Codex se desenvuelve bien en un entorno con sandbox y guiado por configuración, y a menudo estructura código nuevo y sus tests con limpieza, lo que se nota en arreglos acotados. Ambos se desvían más a medida que crece el repositorio, y ambos te entregarán con toda seguridad un cambio que no pasa. Ejecuta tu propio bug antes de dar nada de esto por sentado.
Aquí viene la parte honesta que la mayoría de las comparaciones se salta. Si solo usas un agente y vives en una única terminal, no necesitas una plataforma para hacer esto. Una sesión de Claude Code bien ajustada en un worktree, o una ejecución de Codex, es suficiente, y puedes revisar el diff tú mismo a ojo. La ecuación cambia en el momento en que comparas dos agentes, en más de un bug, y quieres los resultados en un formato que otra persona pueda leer.
Ejecutar el cara a cara en Sharkly
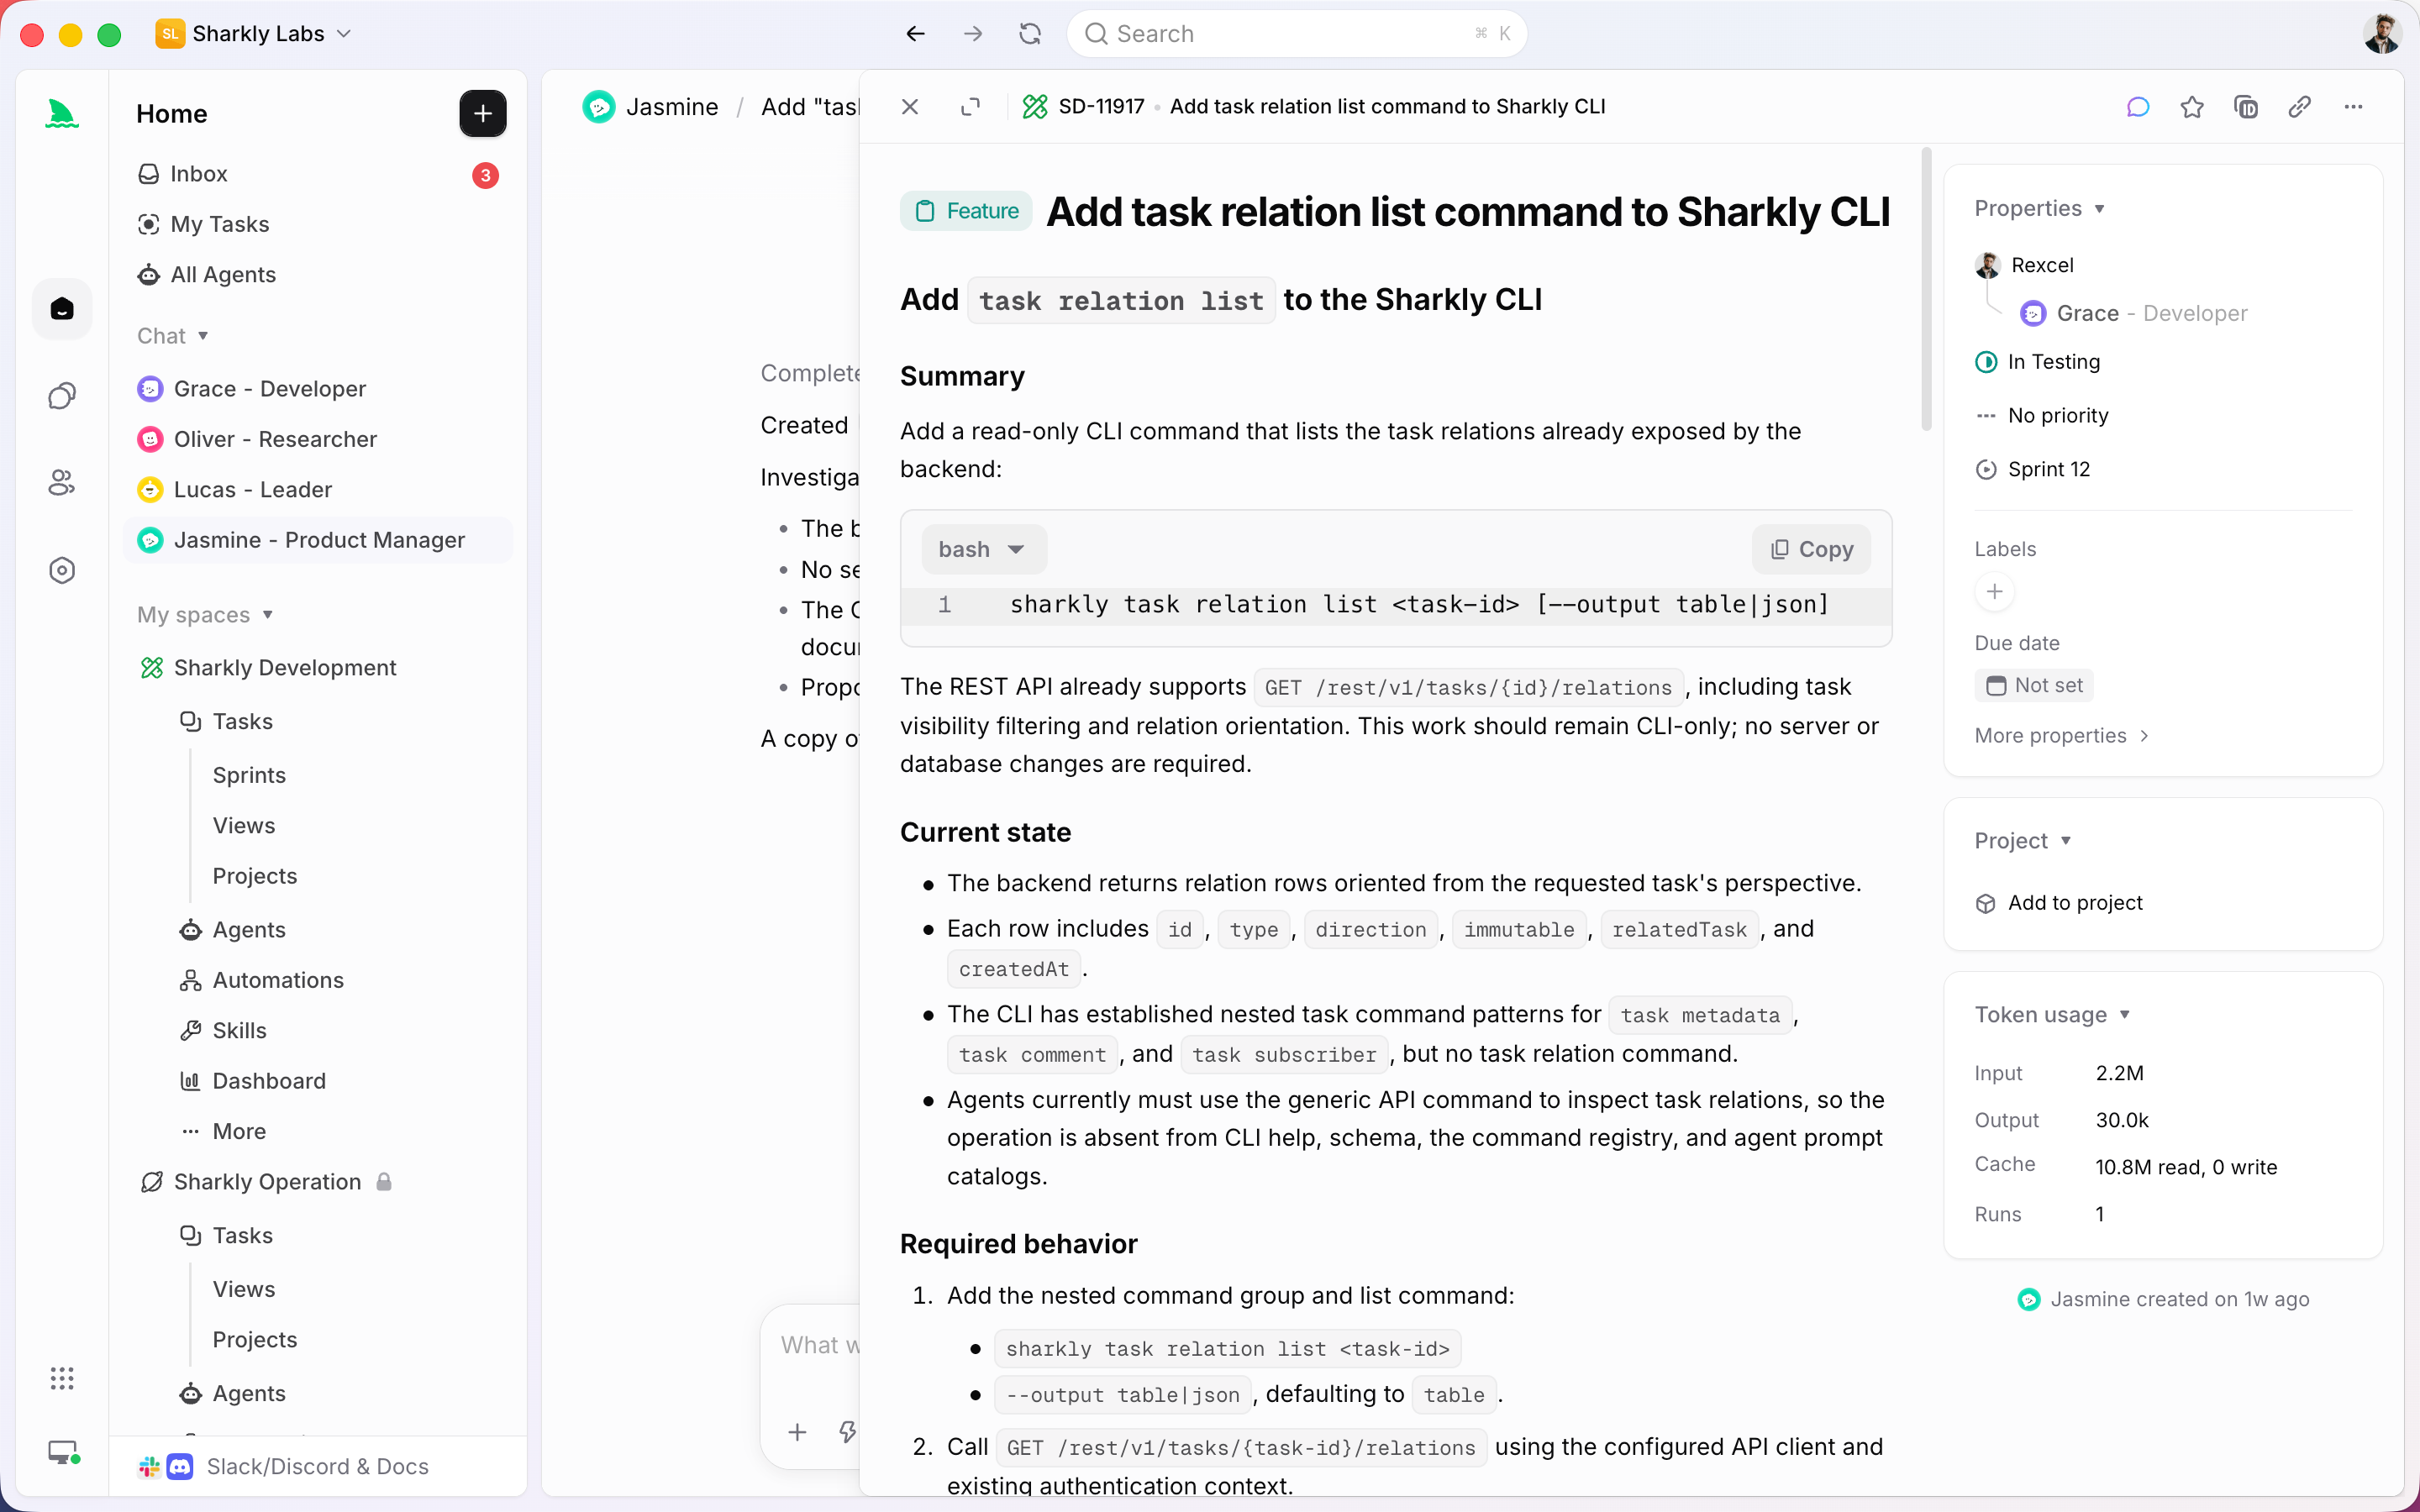
Aquí es donde Sharkly se gana su sitio. Creas una Tarea para el bug y luego la asignas tanto a un Agente de Claude Code como a un Agente de Codex. Cada Agente se ejecuta en un Ordenador conectado en su propio worktree, así que los dos intentos nunca tocan los mismos archivos. La ejecución, los bloqueos, los resultados y el resumen del cambio vuelven a la cronología de la Tarea, y lees los dos diffs y las dos ejecuciones de tests uno frente al otro en una sola vista, en lugar de recordar qué terminal tenía cada cosa.
El reparto de trabajo queda claro. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección y aceptan el resultado. La automatización se detiene donde se requiere tu criterio, y Sharkly mantiene visibles el contexto, el progreso, los bloqueos, los resultados y la revisión humana desde la petición hasta la entrega. No estás delegando la decisión en una herramienta; estás consiguiendo que ambos intentos queden expuestos para que tardes minutos. Cuando quieras conservar ambos agentes para el trabajo diario en lugar de una prueba puntual, ejecutar Claude Code y Codex juntos en una misma base de código es el mismo flujo de trabajo, convertido en rutina.
Por cuál decidirse, según el tamaño del equipo
La elección correcta depende de quién elige y de qué tiene que resistir la comparación.
| Tamaño del equipo | Qué priorizar por encima de todo | Por cuál decidirse |
|---|---|---|
| Desarrollador individual | Tiempo de revisión y ejecución en tu propia máquina | El agente que revises más rápido; eres el único lector |
| Equipo pequeño | Ejecuciones en paralelo y visibilidad compartida | Ambos, asignados a través de una sola Tarea para que todos vean la misma evidencia |
| Equipo de plataforma | Integraciones y neutralidad de proveedor | Conserva ambos; el flujo de trabajo tiene que sobrevivir al agente que lidere el próximo trimestre |
Esa última fila es la verdadera razón para hacer la comparación en lugar de elegir un favorito y defenderlo. El mejor agente de este trimestre puede no ser el mejor el próximo, y rehacer tu proceso cada vez que cambia el líder es un impuesto en sí mismo. Comparar con tus propios bugs, en un flujo de trabajo que sirva para cualquier agente, te mantiene libre para cambiar cuando cambie la respuesta.
Si quieres seguir usando varios agentes de programación en lugar de comprometerte con un solo ecosistema, ese es el problema en torno al cual está diseñado Sharkly. Descarga Sharkly, conecta un Ordenador y asigna el mismo bug real a ambos agentes. El veredicto que obtengas habla de tu base de código, que es el único que predice tu semana.
Preguntas frecuentes
¿Es Claude Code o Codex mejor arreglando bugs? Ninguno gana en general. Sobre el mismo bug, con su mejor configuración, uno suele aventajar al otro, y cuál lo hace cambia según el tipo de bug y el tamaño del repositorio. Ejecuta ambos sobre un defecto real de tu backlog y puntúa corrección, alcance, tests y tiempo de revisión.
¿Puedo ejecutar Claude Code y Codex sobre el mismo bug a la vez? Sí, siempre que cada uno tenga su propia copia de trabajo. Dos agentes en un mismo checkout se sobrescriben entre sí. Dale a cada uno un worktree aislado, o asigna la Tarea a ambos en Sharkly y deja que cada Agente se ejecute en su propio Ordenador.
¿Me dicen las puntuaciones de los benchmarks qué agente usar? Te dicen qué agentes merece la pena probar, no cómo se comporta uno en tu repositorio. Un conjunto de datos público nunca podrá contener tus librerías internas, tu configuración de lint ni tu módulo sin tests. Trata la tabla de clasificación como un filtro y luego haz la comparación que cuenta con tu propio código.
¿Sustituye Sharkly a Claude Code o a Codex? No. Sharkly es la capa de asignación, contexto y revisión alrededor de los agentes de programación que tu equipo ya usa. Los agentes se encargan de la ejecución; Sharkly gestiona la Tarea, mantiene las ejecuciones visibles y deja la aceptación en manos de las personas.
¿Cuántos bugs debería comparar antes de decidir? Un bug te habla de un bug. Aplica el método a unos cuantos tipos de defecto antes de fiarte de un patrón, y mantén la rúbrica idéntica cada vez para que los resultados se acumulen.


