
Respuesta rápida: El precio de Claude Fable 5.2 es de 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida en la API estándar de Anthropic. El modo rápido (Fast mode) cuesta 16 $ y 80 $ respectivamente. Conviene presupuestar teniendo en cuenta todo el flujo de trabajo: contexto repetido, razonamiento (thinking), reintentos, agentes de coordinación, herramientas y revisión humana. Tarifas consultadas el 10 de noviembre de 2026.
El precio por token indica lo que cuesta una llamada al modelo. Sin embargo, el presupuesto de ingeniería requiere calcular el coste por resultado aceptado. Una migración que exige tres intentos, la revisión de otro agente y una corrección humana acumula varios gastos asociados a un único entregable.
Si utilizas varios agentes de programación, Sharkly ofrece un espacio centralizado para sus Tasks y resultados. Comienza allí tu análisis de costes: define qué se considera completado antes de comparar modelos.
¿Cuánto cuesta Claude Fable 5.2?
Anthropic factura de forma independiente los tokens de entrada y de salida, con tarifas diferenciadas para almacenamiento en caché, procesamiento por lotes (Batch) y modo rápido. Un MTok equivale a un millón de tokens. Las siguientes tarifas en USD proceden de la documentación oficial de precios, consultada el 10 de noviembre de 2026. Reflejan el consumo de la API, no una suscripción fija mensual para desarrollo de código.
| Categoría de facturación | Entrada por MTok | Salida por MTok |
|---|---|---|
| API estándar | 8 $ | 40 $ |
| Modo rápido | 16 $ | 80 $ |
| API Batch | 4 $ | 20 $ |
| Escritura en caché estándar (cinco minutos) | 10 $ | No aplica |
| Escritura en caché estándar (una hora) | 16 $ | No aplica |
| Acierto de caché estándar (cache hit) | 0,20 $ | No aplica |
Las escrituras y los aciertos en caché son categorías de entrada, no descuentos en la salida. El precio del almacenamiento en caché en el modo rápido aplica los multiplicadores de caché a las tarifas de entrada del modo rápido. El procesamiento por lotes (Batch) ofrece un 50 % de descuento en entrada y salida, pero el modo rápido no se puede combinar con Batch.
Fable incluye una ventana de contexto completa de un millón de tokens con las tarifas habituales por token. Aun así, trabajar con un contexto amplio resulta costoso: las entradas no almacenadas en caché se van acumulando entre llamadas. Las plataformas en la nube operadas por partners pueden manejar precios distintos; comprueba qué endpoint factura a tu equipo.
¿Cómo calcular el presupuesto de un flujo de trabajo?
Para una llamada estándar sin caché, multiplica los tokens de entrada por 8 $ por millón y los tokens de salida por 40 $ por millón, y luego suma ambos importes. Repite este cálculo para cada llamada en cada intento. Añade los costes específicos de herramientas e infraestructura, seguidos del tiempo de revisión humana, para estimar el coste total del entregable.
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
En este cálculo, la salida representa la totalidad de los tokens de salida facturables, incluido el razonamiento cuando corresponda. No tomes la longitud visible de la respuesta como equivalente del consumo reportado por el proveedor.
Imagina que ejecutas 20 tareas con esos totales de tokens. Cinco tareas requieren un reintento idéntico. Asume que un agente coordinador añade 2 $ en total y que un revisor dedica 15 minutos con un coste interno de 80 $ por hora.
| Componente hipotético | Cálculo | Coste |
|---|---|---|
| Intentos iniciales | 20 × 1,60 $ | 32 $ |
| Intentos adicionales | 5 × 1,60 $ | 8 $ |
| Coordinador | Gasto agregado estimado del modelo | 2 $ |
| Revisión humana | 0,25 horas × 80 $ | 20 $ |
| Total | Antes de herramientas, infraestructura e impuestos | 62 $ |
Si se aceptan las 20 tareas, el coste del ejemplo es de 3,10 $ por tarea aceptada. Si solo se aprueban 16, esos mismos 62 $ suponen unos 3,88 $ por tarea aceptada. El denominador altera por completo la decisión.
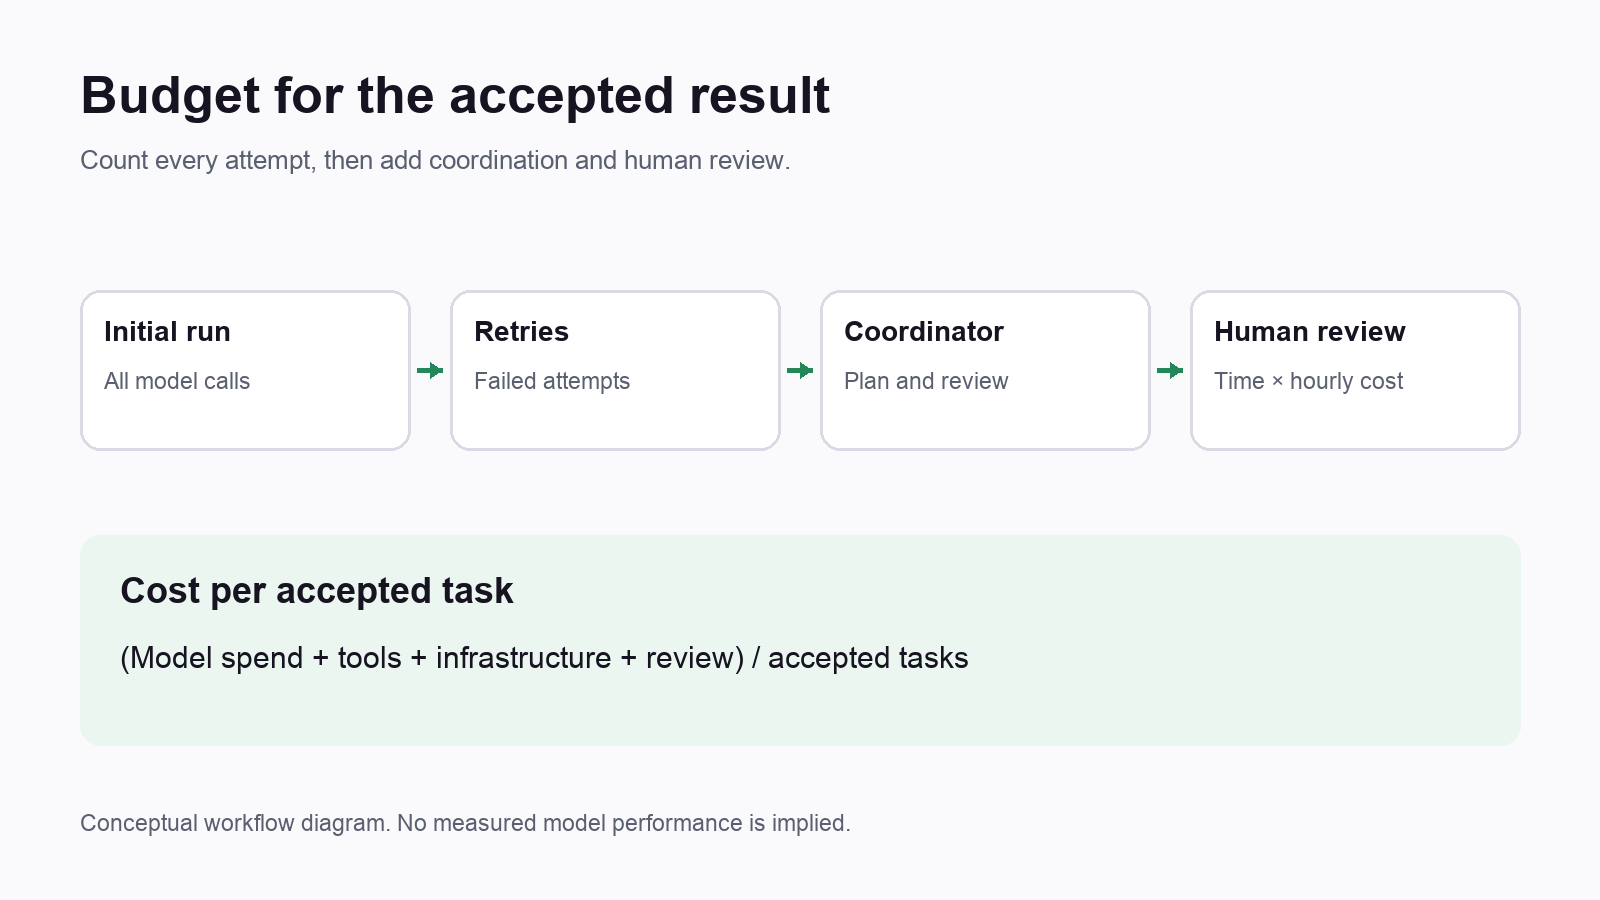
Estos supuestos sirven para planificar y no constituyen mediciones del rendimiento real de Fable. Sustitúyelos por tus recuentos reales de tokens, número de reintentos, tasas de aceptación y tiempos de revisión. Nuestra guía sobre cómo calcular el coste de los agentes por cambio aceptado explica por qué esta comparación resulta clave.
El modo rápido y el ajuste de esfuerzo afectan a costes distintos
El modo rápido incrementa el precio por token para reducir el tiempo de generación. El parámetro de esfuerzo (effort) modifica la cantidad de trabajo que efectúa el modelo, incluidas las llamadas a herramientas y el razonamiento. Deben tratarse como controles independientes: una generación más veloz no garantiza un flujo de trabajo global más corto, y un nivel de esfuerzo bajo no establece un límite fijo de gasto.
En el anuncio de lanzamiento de Anthropic se afirma que el modo rápido genera tokens hasta 2,5 veces más rápido. Se trata de una afirmación del proveedor sobre la generación, no de una garantía de que las compilaciones, las pruebas, las llamadas de red o la revisión humana vayan a finalizar 2,5 veces más rápido.
Con el mismo número de tokens, el ejemplo de 1,60 $ pasa a costar 3,20 $ en modo rápido. Conviene recurrir al modo rápido cuando el beneficio de reducir la espera compense el sobrecoste. Para tareas desatendidas donde la latencia de generación no condicione los plazos de entrega, es preferible utilizar el modo estándar.
La documentación de effort recoge los niveles Low, Medium, High, Xhigh y Max para Fable 5.2. El valor predeterminado en la API es High. El anuncio indica que Medium es el valor predeterminado en las aplicaciones de Claude y en Claude Code. Conviene registrar el producto y el ajuste explícito al realizar la comparativa.
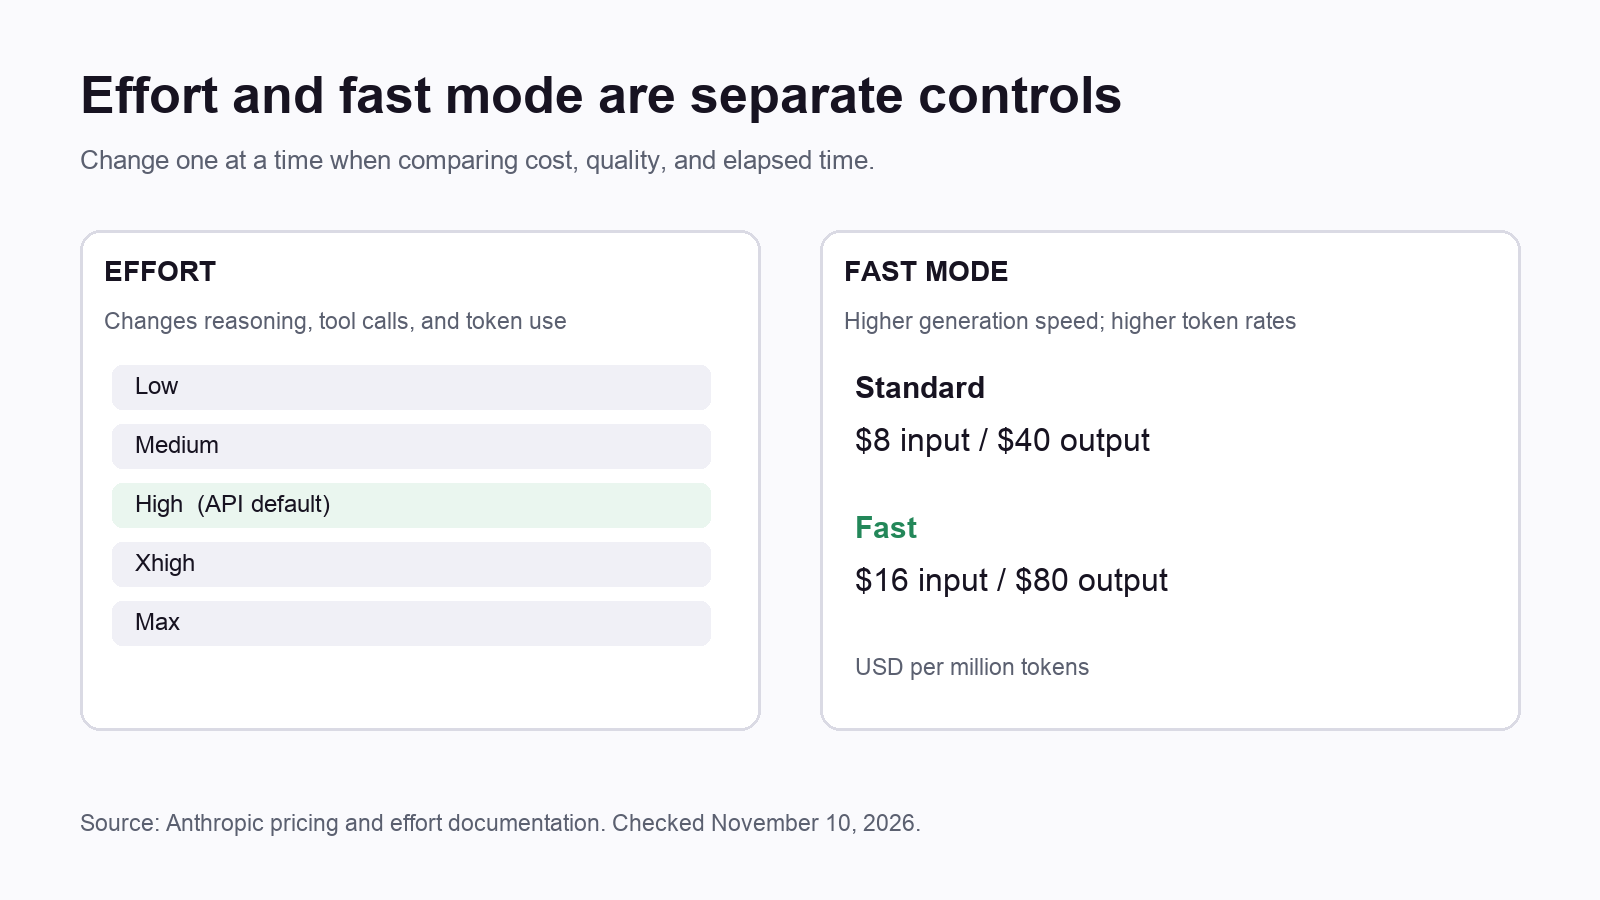
Anthropic recomienda iniciar las cargas de trabajo de la API en High, reducir el esfuerzo si las evaluaciones mantienen la calidad y subir a Xhigh cuando las tareas complejas demuestren una mejora medible. El nivel Max prioriza la capacidad sin reparar en el coste de los tokens. El parámetro de esfuerzo es un ajuste de comportamiento; los límites reales de gasto deben establecerse en la propia aplicación y en los procesos operativos.
Cómo controlar el contexto recurrente, los reintentos y la orquestación
Aplica estos seis controles antes de incrementar el número de agentes:
- Mide cada intento. Incluye los intentos fallidos o abandonados en el coste total de la misma tarea.
- Guarda en caché el contexto estable. Reutiliza las instrucciones del repositorio y los documentos que no cambien cuando la carga de trabajo permita usar prompt caching.
- Limita los reintentos. Define un número máximo de intentos y exige un diagnóstico antes de lanzar otra prueba costosa.
- Enruta según la complejidad. Escala los problemas de razonamiento que no se resuelvan en lugar de encomendar cada extracción o paso de formateo a Fable.
- Presupuesta la coordinación. Contabiliza la planificación, el envío de tareas (dispatch), los resúmenes y las llamadas de revisión junto con las llamadas de ejecución.
- Regula la llegada de revisiones. Modula el volumen de trabajo completado en función del número de cambios que tus revisores puedan evaluar.
Las definiciones y los resultados de las herramientas suman tokens de entrada al modelo. Algunas herramientas del lado del servidor conllevan cargos independientes, tal como detalla la guía de precios de Anthropic. Un comando que devuelve un registro kilométrico puede disparar el coste de contexto de las llamadas posteriores, aunque la ejecución del comando en sí apenas cueste nada.
El uso de la caché también exige medición. Para un prefijo hipotético de 100 000 tokens, una escritura estándar de cinco minutos cuesta 1 $. Un acierto posterior en caché supone 0,02 $, frente a los 0,80 $ que costaría una entrada no almacenada en caché. Estas cifras no contemplan las nuevas entradas ni las salidas. Verifica la tasa real de aciertos en caché antes de dar por seguros los ahorros.
Para definir una política de enrutamiento reproducible, consulta la vista general de modelos. Anthropic recomienda Opus 5.5 para la mayoría de las cargas de trabajo y Fable para razonamientos exigentes o proyectos a largo plazo. Es un punto de partida para evaluar, no una garantía de que dicho modelo sea el idóneo en tu repositorio.
¿Qué conviene medir en una prueba piloto?
Mantén idénticos el alcance de la tarea y las pruebas de aceptación en todas las configuraciones. Desglosa en tus registros de tiempo la espera en cola, la generación del modelo, la ejecución de herramientas y la revisión humana. De lo contrario, una batería de pruebas lenta puede camuflar las ventajas de una generación más rápida, o un lote de tareas sencillas puede hacer que una configuración cara parezca rentable.
Registra las entradas en caché de forma independiente a las no cacheadas. Conserva los datos reales de consumo facilitados por el proveedor en cada intento en vez de estimar los tokens a partir del tamaño de los archivos. Al modificar el parámetro de esfuerzo, compara tanto los resultados aceptados y el retrabajo como la primera respuesta. Una ejecución inicial más corta puede acabar dejando una factura de corrección mucho más abultada.
Fija una condición de parada antes de iniciar la prueba piloto: un tope de intentos, un umbral de gasto o un punto de control de revisión. Un modelo que continúe investigando indefinidamente puede agotar el presupuesto mientras produce avances que todavía no es posible aceptar.
Vincula el presupuesto al trabajo real
La descripción oficial del producto de Sharkly reúne Tasks, agentes de programación, Computers conectados y revisiones humanas en un único espacio de trabajo. Mantienes las cuentas de API o suscripciones de desarrollo configuradas en tus propias herramientas, y el consumo de los modelos se gestiona en las cuentas de dichos proveedores.
Aprovecha ese registro de trabajo compartido para documentar el modelo, el esfuerzo, los intentos, las evidencias y el resultado de la revisión. En una migración, pide al Agent que entregue los resultados de las pruebas y las limitaciones identificadas junto con sus cambios. A continuación, el equipo evalúa el trabajo y decide si aprobarlo o solicitar correcciones. Consulta cómo revisar código generado por IA con evidencias por tarea para adoptar una metodología de revisión eficaz.
Para una corrección puntual, basta con asignar un solo Agent. Recurre a un Crew cuando la tarea requiera coordinar a distintos especialistas. El uso de agentes adicionales implica llamadas intermedias y traspasos de contexto, de modo que conviene medir los resultados antes de convertir el trabajo en paralelo en la opción por defecto. La guía de Crews con modelos mixtos analiza a fondo estos traspasos.
Empieza con diez tareas representativas. Registra el gasto total, el tiempo transcurrido, la tasa de aceptación y los minutos de revisión en cada configuración. Conecta un Computer en Sharkly, asigna una Task acotada y solicita esas evidencias en la entrega. Escala el uso solo cuando puedas explicar con claridad el coste por resultado aceptado.
Preguntas frecuentes
¿Cuesta el doble el modo rápido de Claude Fable 5.2?
Las tarifas publicadas para tokens de entrada y salida duplican las del modo estándar. No obstante, el coste total del flujo de trabajo también depende del volumen de tokens, el almacenamiento en caché, las herramientas y los reintentos.
¿Modifica el ajuste Medium de effort el precio del token?
El parámetro de esfuerzo influye en el comportamiento del modelo y en el consumo de tokens, pero no sustituye las tarifas publicadas de entrada y salida por una tabla de precios específica según el nivel de esfuerzo.
¿Es lo mismo el presupuesto de una suscripción que el de una API?
No. En este artículo se calcula el consumo medido por API. Las condiciones y los límites de tu suscripción para desarrollo de código deben consultarse de forma independiente.
¿Puede el procesamiento por lotes (Batch) reducir la factura?
La API Batch ofrece tarifas de 4 $ en entrada y 20 $ en salida por millón de tokens en Fable. Conviene utilizar el procesamiento asíncrono cuando el flujo de trabajo admita esperas; el modo rápido no es compatible con Batch.
¿Supone un menor coste por llamada una entrega más económica?
Solo si los reintentos, la tasa de aceptación, la orquestación y la revisión conservan esa ventaja. Compara el gasto total frente a las tareas aceptadas utilizando siempre los mismos criterios de aceptación.
Recursos adicionales
Para profundizar en la planificación de flujos de trabajo, consulta los artículos sobre gestión de costes de agentes de programación y sobre capacidad de revisión humana frente a agentes en paralelo. Revisa siempre la documentación de precios y de effort enlazada de Anthropic antes de aplicar estas tarifas a un nuevo presupuesto.


