

GPT-6.2 Astra vs Fable 5.2 está más reñido de lo que sugieren los titulares. Ambos tienen un precio de lista de $8 por millón de tokens de entrada y $40 por millón de tokens de salida. Anthropic publica puntuaciones más altas de programación agéntica para Fable 5.2; OpenAI no publica ningún benchmark de programación para Astra. El precio de la caché, los recargos por contexto largo y tu propia tasa de cambios aceptados deciden el ganador para tu equipo.
OpenAI lanzó GPT-6.2 Astra el 17 de noviembre de 2026, ocho días después de que Anthropic pusiera en circulación Claude Fable 5.2. Ambos son modelos de frontera orientados a trabajo agéntico largo y exigente. Si ejecutas agentes de programación, ahora tienes dos opciones insignia al mismo precio de etiqueta.
Una tabla de clasificación no puede resolverlo por ti. Tus dependencias, tu suite de tests y tus revisores sí pueden. Esta guía compara las cifras publicadas, muestra dónde divergen las facturas y te ofrece una prueba cara a cara que puedes ejecutar en tu propio repositorio. Si ya ejecutas Codex y Claude Code en paralelo, Sharkly es donde asignas la misma tarea a ambos y mantienes los resultados juntos.
GPT-6.2 Astra vs Fable 5.2: las especificaciones, cara a cara
GPT-6.2 Astra es el modelo de frontera de OpenAI dentro de la familia GPT-6.2; GPT-6.2 Sol es su hermano más económico para el día a día. Claude Fable 5.2 es el modelo de mayor nivel de Anthropic disponible con carácter general, mientras que Mythos 5.2 se mantiene como un lanzamiento de acceso limitado. Esto es lo que publica cada proveedor, consultado el 20 de noviembre de 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Lanzamiento | 17 de noviembre de 2026 | 9 de noviembre de 2026 |
| ID del modelo de API | gpt-6.2-astra |
claude-fable-5-2 |
| Entrada, por 1M de tokens | $8 | $8 |
| Salida, por 1M de tokens | $40 | $40 |
| Entrada en caché (acierto de caché) | $0,40 | $0,20 |
| Escritura en caché | $10 (30 minutos) | $10 (5 minutos), $16 (1 hora) |
| Lote | 50 % del estándar | $4 de entrada, $20 de salida |
| Modo rápido | 2x del estándar | $16 de entrada, $80 de salida |
| Ventana de contexto | 1.050.000 tokens (922.000 de entrada máxima) | 1M de tokens con precios estándar |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Recargo por entrada larga | Por encima de 272K de entrada: las tarifas de entrada y caché se duplican, la salida x1,5 | Ninguno indicado |
| Agente de programación habitual | Codex | Claude Code |
Fuentes: la página del modelo GPT-6.2 Astra de OpenAI, la documentación de precios de Anthropic y su descripción general de modelos.
Dos filas son las más importantes para los agentes. Un agente de programación reenvía su contexto en cada turno, así que la tasa de aciertos de caché determina la mayor parte de la factura. Y un agente que ha leído un repositorio grande puede superar los 272K tokens de entrada, punto en el que cambian las tarifas de Astra.
Qué dicen los benchmarks de programación y qué no dicen
El anuncio de Fable 5.2 de Anthropic reporta un 69,9 % en FrontierSWE v2 y un 49,1 % en FrontierCode 2.0 con esfuerzo Xhigh. En esa misma tabla, la columna de comparación de OpenAI aparece etiquetada como GPT-6 Astra, la generación anterior, con un 65,5 % y un 42,8 %.
Esa tabla no incluye GPT-6.2 Astra. La página del modelo de OpenAI tampoco recoge ninguna puntuación de programación al estilo SWE. El artículo de lanzamiento de Simon Willison señala que «Astra 6.2 no obtiene puntuaciones tan altas como Fable 5.2 en varios benchmarks» y que algunos usuarios consideran que su estilo de comunicación «puede resultar confuso».
Así que una lectura honesta tiene tres partes:
- Fable 5.2 cuenta con puntuaciones publicadas de programación agéntica, ejecutadas por su proveedor, superiores a las del anterior Astra.
- Ningún proveedor ha publicado una comparación directa de programación frente a GPT-6.2 Astra.
- Todas las cifras anteriores las ha obtenido el propio proveedor del modelo, con su propio harness y con los niveles de esfuerzo que ha elegido.
Trata los benchmarks como un filtro para la lista corta. Este artículo no incluye resultados de pruebas independientes de ninguno de los dos modelos.
Dónde divergen las facturas
Precios de lista iguales no significan facturas iguales. Tres mecanismos las separan.
Aciertos de caché
Fable 5.2 cobra $0,20 por millón de tokens en un acierto de caché. Astra cobra $0,40. Para un agente que reenvía un prefijo en caché de 100.000 tokens 50 veces en una sesión, ese prefijo cuesta $1,00 en Fable y $2,00 en Astra, antes de contar la entrada y la salida nuevas. Simon Willison aun así califica el precio en caché de Astra como «una gran noticia para sesiones agénticas de mayor duración»; está muy por debajo de la tarifa de $8 sin caché.
Contexto largo
Las tarifas de Astra suben cuando una petición supera los 272K tokens de entrada. Anthropic incluye el contexto completo de 1M con tarifas estándar para Fable. Si tus agentes cargan habitualmente medio monorepo, modela ese umbral antes de comprometerte.
Esfuerzo y tokens por tarea
Ambos modelos exponen niveles de esfuerzo, y un esfuerzo mayor consume más tokens. La prueba informal de SVG de Simon muestra la dispersión con un mismo prompt: GPT-6.2 Astra costó 11,55 centavos con esfuerzo High y 88,71 centavos con Max. Se trata de un prompt de juguete, no de un benchmark de programación, pero la diferencia de 7 veces muestra por qué conviene fijar el nivel de esfuerzo antes de comparar costos.
Nuestro desglose de precios de Fable 5.2 analiza los reintentos y el tiempo de revisión; la guía de límites de velocidad de GPT-6.2 cubre el techo de tokens por minuto al que primero llegan los agentes de Astra.
Cómo ejecutar una prueba de GPT-6.2 Astra vs Fable 5.2 en tu propio repositorio
Una comparación cara a cara con tu propio código supera cualquier tabla publicada. El método que sigue se basa en nuestra guía más extensa para evaluar Fable 5.2 en tu base de código; aquí se plantea como un duelo entre dos modelos.
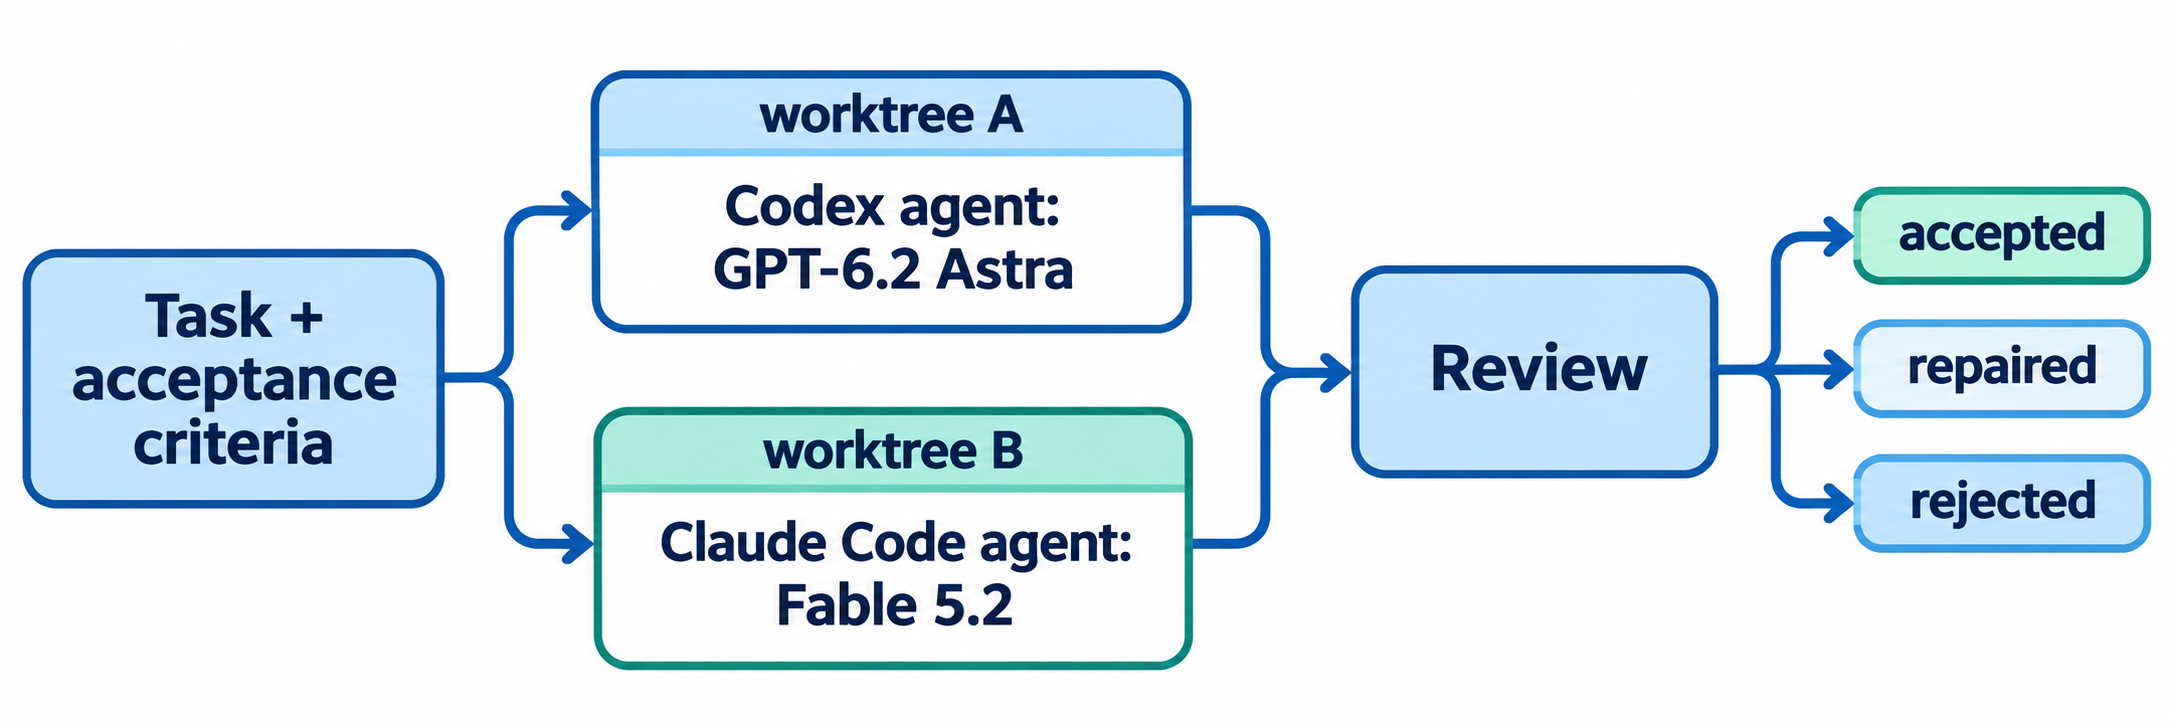
- Elige entre 10 y 12 tareas recientes de tu backlog: correcciones de bugs, pequeñas adiciones, un refactor y una investigación.
- Escribe primero los criterios de aceptación, antes de que se ejecute ninguno de los agentes, para que ningún resultado condicione el listón.
- Fija el harness. Astra funciona mejor en Codex y Fable en Claude Code, así que estarás comparando dos flujos de trabajo completos. Indícalo en tu análisis.
- Fija el nivel de esfuerzo. Elige High en ambos, o indica los ajustes exactos que usaste.
- Aísla cada intento en un worktree de git nuevo, para que ningún agente herede las ediciones del otro.
- Ejecuta cada tarea en ambos modelos, alternando cuál va primero.
- Revisa a ciegas siempre que puedas y puntúa cada resultado como aceptado, aceptado tras reparación o rechazado.
- Divide el gasto total entre los cambios aceptados, incluidos los intentos fallidos.
El costo por cambio aceptado es la cifra que decide. Un modelo que es un 20 % más barato por token pero necesita un ciclo extra de reparación por tarea es el modelo más caro para tu equipo.
Ejecuta ambos modelos como Agents en Sharkly
Sharkly ejecuta los agentes de programación que ya usas; no los sustituye. Un Agent en Sharkly es un compañero de IA configurado que ejecuta Tasks a través de un Runtime, como Codex o Claude Code, en un Computer que conectes.
Prepara el duelo con dos Agents:
- Astra Agent: un Runtime de Codex configurado para
gpt-6.2-astra. - Fable Agent: un Runtime de Claude Code configurado para
claude-fable-5-2.
Cada Agent tiene un modelo predeterminado, que se elige en Computer, Runtime y Working directory entre los modelos que reporta su Runtime. Consulta el centro de ayuda de Sharkly para conocer los ajustes actuales de los Agents.
Configura los mismos límites de ejecución en ambos Agents, para que ninguno tenga más ejecuciones en paralelo ni un presupuesto de tiempo mayor que el otro.

Usa el modo de directorio de trabajo temporal, para que cada Task tenga un directorio aislado y las ejecuciones respaldadas por un repositorio puedan preparar un worktree nuevo. Incluye los criterios de aceptación en la descripción de la Task. Cada Agent informa de su parche y de las comprobaciones en su propia Task, lo que mantiene cada intento junto al veredicto del revisor.
El uso de los modelos se mantiene en tus propias suscripciones y claves de API. Sharkly no vende tokens, y la cuota de modelos depende de las herramientas, planes y cuentas de API que conecte tu equipo.
Alternativas a elegir directamente entre Astra y Fable
No tienes por qué coronar a un único modelo.
- Divide por tipo de tarea. Usa Fable 5.2 en las categorías en las que gane en tu prueba y Astra en el resto.
- Uno lidera, el otro refuerza. Un modelo de frontera planifica y revisa; un modelo más económico se encarga de las piezas rutinarias, el patrón que se describe en GPT-6 Astra como líder de tu Crew.
- Baja un nivel. GPT-6.2 Sol tiene un precio de lista de $2 de entrada y $10 de salida por millón de tokens. Para el mantenimiento rutinario, puede superar tu listón a una cuarta parte del precio.
- Mantén ambos activos. La neutralidad respecto al proveedor es lo importante: ningún modelo se mantiene como el mejor durante mucho tiempo, como se argumenta en Argon, Astra y Opus.
Casos de uso reales
- Migraciones largas. Anthropic informa de que un equipo de agentes de Fable 5.2 migró un servicio en producción de Python a Rust. Prueba ese tipo de trabajo con tu propia porción de código antes de confiar en cualquiera de los dos modelos.
- Investigaciones en repositorios grandes. Al pasar de 272K tokens de entrada, cambian los precios de Astra. Ejecuta el modelo de costos con tu tamaño de contexto real.
- Colas de bugs en paralelo. Diez correcciones pequeñas repartidas entre ambos Agents te dan una tasa de cambios aceptados por modelo en una semana.
Conclusión
GPT-6.2 Astra y Fable 5.2 cuestan lo mismo por token sobre el papel. Fable tiene las puntuaciones de programación publicadas más altas y aciertos de caché más económicos; Astra tiene una ventana de contexto algo mayor, pero tarifas más pronunciadas por encima de 272K de entrada. Ninguno de estos datos te dice cuál entrega más código aceptado en tu repositorio.
Haz el duelo. Conecta un Computer a Sharkly, crea un Agent de Codex con GPT-6.2 Astra y un Agent de Claude Code con Fable 5.2, y asigna a ambos las mismas cinco tareas esta semana. Quédate con el modelo que gane en costo por cambio aceptado.
Preguntas frecuentes
¿GPT-6.2 Astra es más barato que Claude Fable 5.2?
No. Ambos tienen un precio de lista de $8 por millón de tokens de entrada y $40 por millón de tokens de salida. Los aciertos de caché de Fable son más económicos ($0,20 frente a $0,40), y las tarifas de Astra suben por encima de 272K tokens de entrada.
¿Cuál es mejor para programar, GPT-6.2 Astra o Fable 5.2?
Anthropic reporta puntuaciones de programación agéntica más altas para Fable 5.2 que para el anterior GPT-6 Astra. Ningún benchmark publicado compara Fable 5.2 directamente con GPT-6.2 Astra, así que prueba ambos con tus propias tareas.
¿Cuál es la ventana de contexto de GPT-6.2 Astra y Fable 5.2?
GPT-6.2 Astra indica 1.050.000 tokens con un límite de entrada de 922.000 tokens. Fable 5.2 incluye un contexto de 1M de tokens con precios estándar. Ambos limitan la salida a 128.000 tokens.
¿Puedo usar GPT-6.2 Astra en Claude Code o Fable 5.2 en Codex?
Cada modelo se suele ejecutar en el agente de programación de su propio proveedor: Astra en Codex y Fable en Claude Code. Compararlos normalmente implica comparar dos flujos de trabajo completos: modelo y harness.
¿Cómo comparo dos modelos de programación de forma justa?
Usa las mismas tareas, criterios de aceptación escritos, niveles de esfuerzo fijos y worktrees aislados. Puntúa los resultados aceptados, reparados y rechazados, y divide el gasto total entre los cambios aceptados.
¿Sharkly elige el modelo de mi Agent?
No. Tú eliges el modelo predeterminado de cada Agent entre los modelos que reporta su Runtime. Sharkly no enruta tareas entre modelos de forma automática.


