
TL;DR: Un equipo del MIT CSAIL hizo que un modelo de frontera leyera y editara los pesos de Qwen3.5-0.8B dentro de un sandbox de Python, con un presupuesto estricto de pases forward y un registro completo de cada paso. Los autores reportan que MATH-500 subió del 7,9% al 48,1%. Puedes dejar que un agente de programación edite los pesos de un modelo de la misma forma: cinco tareas en un tablero, el presupuesto escrito en cada tarea, un segundo agente en la evaluación y una persona que apruebe el archivo editado.
El 2 de noviembre de 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab publicaron Sparks of Weight-Space Programming. El modelo de su estudio, GPT-6 Astra, abrió tensores de pesos, escribió numpy y PyTorch sobre ellos, formuló una hipótesis y modificó 131.072 números en un modelo de 0,8B de parámetros.
Si lees la configuración, te resulta familiar: un sandbox, un presupuesto de herramientas, un registro de cada prompt y cada celda ejecutada. Eso es un agente de programación con un harness, y el harness es la parte que tu equipo puede copiar hoy mismo.
Lo que hizo el equipo del MIT, en cifras
La programación en el espacio de pesos significa que un LLM lee los parámetros de una red como datos y los edita directamente, sin descenso de gradiente ni entrenamiento. La publicación del MIT lo reporta en modelos pequeños, bajo límites estrictos de herramientas y con cada turno registrado.
El resultado principal es la edición de Qwen3.5-0.8B:
| Métrica (cifras de los autores) | Modelo base | Modelo editado |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Ejecuciones que alcanzaron el límite de 32.768 tokens | 93,0% | 33,1% |
Astra rastreó el hábito del modelo de entrar en bucle hasta quedarse sin tokens en una dirección escrita por los MLP de las capas 15 y 19, y luego la restó de 64 columnas de salida en cada una: 131.072 pesos, o el 0,016% del modelo. El checkpoint publicado es Apache-2.0, y su ficha indica que solo dos tensores difieren del modelo base: las matrices down_proj.weight en esas dos capas.
Por qué el harness decide el resultado
Dos hallazgos de la publicación importan más a un equipo que el titular.
El presupuesto cambió el resultado. Cada pase forward promediaba un lote de 64 secuencias. Con 10 pases, MATH-500 llegó al 12,3%. Con 25, llegó al 14,1%. Con 50, llegó al 48,1%. El mismo modelo, la misma tarea, un techo distinto en cuántas veces el agente podía probar una idea.
Las herramientas cambiaron el resultado. Con solo los pesos de dos variantes de Gemma 3 270M, Astra no pudo distinguir cuál era sicofante en ninguno de cuatro intentos. Con una herramienta que devolvía los pesos de atención sobre hasta 16 textos que él mismo escribió, identificó al sicofante en las tres parejas.
Dos palancas, entonces: en qué puede gastar el agente y qué puede mirar. Ambas deben quedar por escrito antes de que arranque la ejecución.
Los límites también son claros. Astra no pudo mejorar Gemma 3 270M en MATH-500: partiendo de una base de 6,8%, su mejor edición llegó al 7,7%. Los autores lo interpretan como una edición que elimina un obstáculo, no que añade una capacidad que el modelo no tenía. Califican los hallazgos de preliminares, y varios son ejecuciones únicas. Plantea tu propio experimento como una prueba, no como una solución definitiva.
Cómo permitir que un agente de programación edite pesos de un modelo de forma segura
Un experimento seguro en el espacio de pesos tiene cinco propiedades:
- Los pesos originales son de solo lectura para todos los agentes.
- El presupuesto de pases forward es un número en la tarea, aplicado por el sandbox.
- El conjunto de evaluación que ve el editor es distinto del conjunto de regresión que ejecuta el revisor.
- El registro de cada ejecución permanece vinculado a la etapa a la que pertenece.
- Una persona aprueba el archivo editado antes de que algo lo cargue fuera del sandbox.
Sharkly no cuenta pases forward ni inspecciona tensores. Eso lo hace tu script de sandbox, y tu entorno de ejecución (Claude Code, Codex u otro agente que ya uses) se encarga de la lectura y la edición. Sharkly sostiene el trabajo: quién es dueño de cada etapa, en qué puede gastar, qué devolvió y quién dio el visto bueno. El propio repositorio de registros del equipo del MIT mantiene una carpeta harness/ con una configuración de Codex y un script de sandbox, lo cual es una referencia útil para el lado del sandbox.
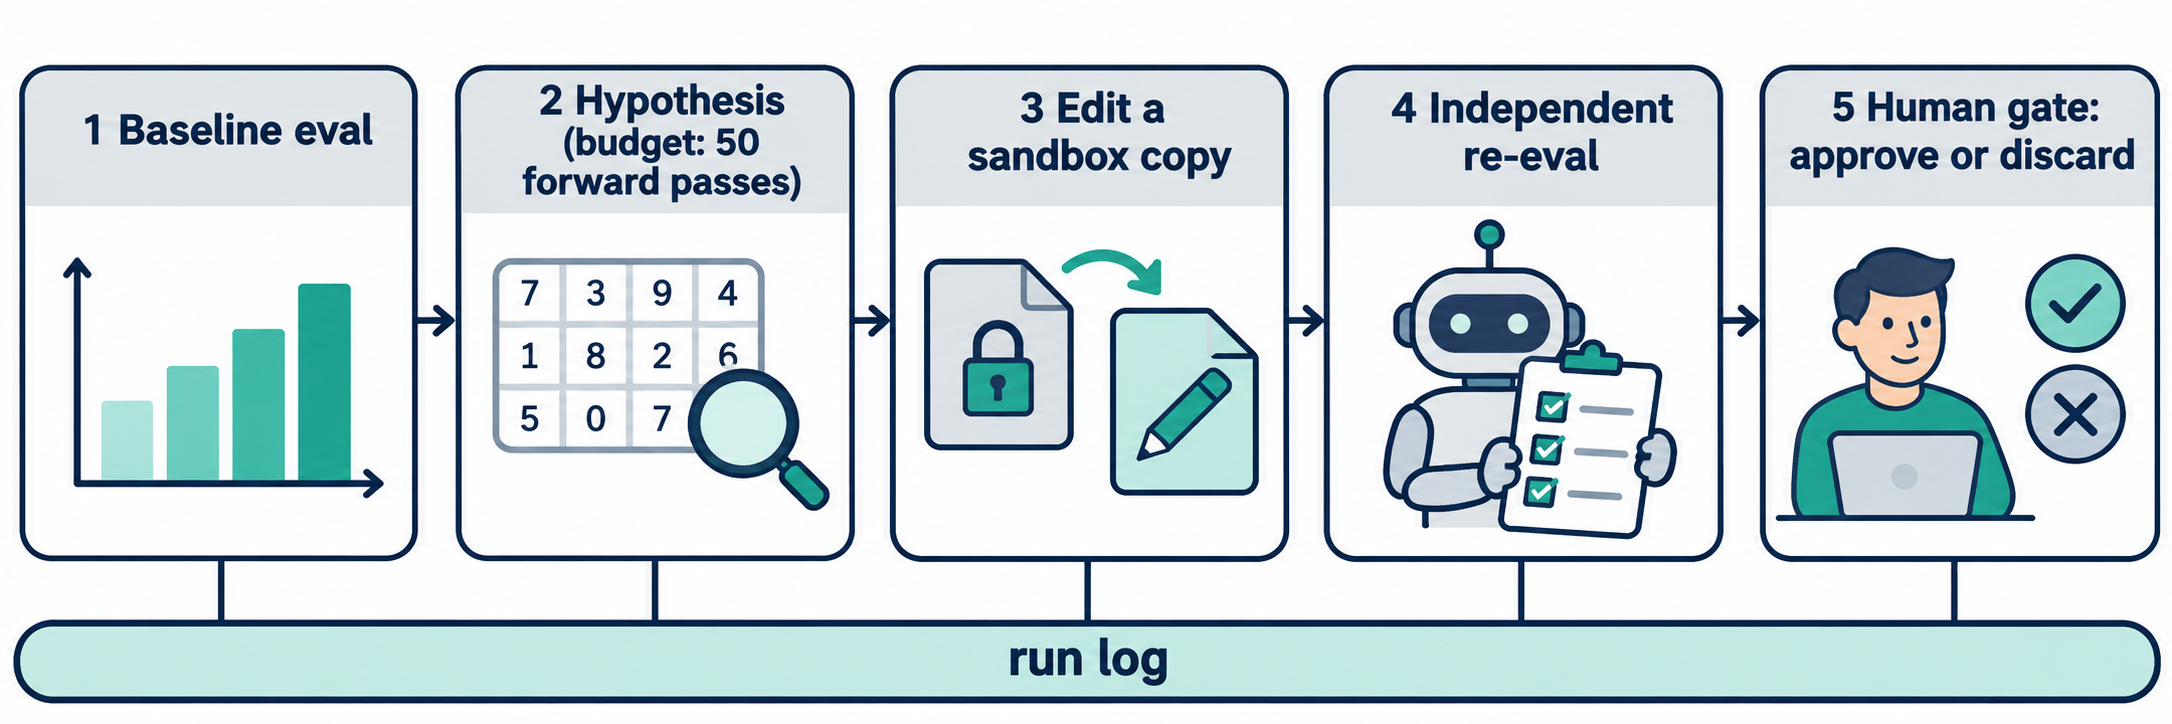
Etapa 1: Evaluación de referencia del modelo intacto
La primera tarea ejecuta tu evaluación sobre el checkpoint original y registra las puntuaciones y dónde falla el modelo. Para Qwen3.5-0.8B, el 93,0% de las ejecuciones alcanzó el límite de tokens. La tarea de hipótesis necesita esa descripción del fallo.
Etapa 2: Leer los pesos y escribir una hipótesis
Esta es la tarea con presupuesto. Pon el número en el cuerpo, en un formato que el agente no pueda malinterpretar:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
El presupuesto en la tarea es una promesa; el presupuesto en el wrapper del sandbox es la garantía. Escribe ambos, y haz que el wrapper imprima los pases usados para que el número quede en el registro de la ejecución.
Etapa 3: Hacer la edición en una copia dentro del sandbox
El agente editor modifica una copia del checkpoint y reporta el diff. Nunca obtiene acceso de escritura al original. En Sharkly, cada ejecución de tarea recibe su propio directorio aislado, y el trabajo de repositorio puede usar un worktree separado por ejecución, de modo que la etapa 3 no puede tocar lo que midió la etapa 1.
Etapa 4: Reevaluación independiente por un agente revisor
Asigna esta etapa a un agente distinto del que hizo la edición. Este vuelve a ejecutar la evaluación de la etapa 1 y añade un conjunto de regresión que el editor nunca vio. Si usas una Crew, el líder puede entregar la edición a un miembro y la reevaluación a otro. El patrón coincide con una Crew de modelos mixtos con un revisor aparte: el agente que escribió el cambio no es el agente que lo califica.
El editor optimizó contra lo que podía ver, así que una mejora que solo aparece en esos problemas demuestra poco.
Etapa 5: Compuerta humana sobre el diff
La última tarea llega a una persona con tres adjuntos: la lista de tensores modificados, la tabla de antes y después, y los resultados de regresión del revisor. Nada carga el checkpoint editado fuera del sandbox hasta que esta tarea avance.
Este breve script produce el primer adjunto. Compara dos checkpoints safetensors y lista cada tensor que cambió:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
En el checkpoint publicado, la ficha del modelo indica que deberías ver exactamente dos tensores down_proj.weight. Si tu propia edición toca tensores que la hipótesis nunca nombró, esa es la razón para descartarla.
Ejecutar el tablero en Sharkly
Este es el tablero para un experimento. Cada fila es una tarea con su propio responsable, estado e historial de ejecuciones.
| Tarea | Responsable | Presupuesto o compuerta | Completada cuando |
|---|---|---|---|
| 1. Evaluación de referencia | Agente de evaluación | Solo conjunto de evaluación | Puntuaciones y notas de fallo publicadas |
| 2. Hipótesis a partir de los pesos | Agente editor | 50 pases forward | Hipótesis publicada, pases usados registrados |
| 3. Edición en sandbox | Agente editor | Solo copia, original de solo lectura | Diff y archivo editado en el sandbox |
| 4. Reevaluación y regresión | Agente revisor | Conjunto de regresión reservado | Tabla de antes/después publicada |
| 5. Aprobar o descartar | Una persona | Compuerta humana | Decisión registrada en la tarea |
Vincula las etapas con relaciones de bloqueo para que el tablero muestre la cadena. Las relaciones entre tareas de Sharkly son honestas respecto a su alcance: una relación muestra dependencia y progreso en la tarjeta, pero no mueve una tarea ni inicia una ejecución por sí sola. Mantén cada etapa en Backlog hasta que termine la anterior. Una tarea asignada a un agente no inicia una ejecución mientras permanezca en Backlog, así que moverla de ahí es el disparador.
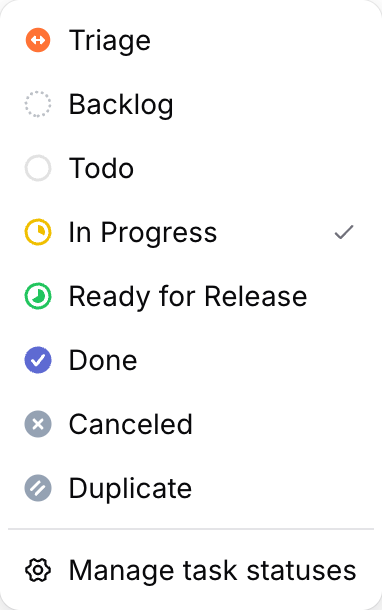
Cuando termina la etapa 4, el agente puede dejar la tarea esperando revisión humana, y la persona la ve en Inbox. El registro de ejecución guarda el inicio, el fin, las llamadas a herramientas y el disparador de cada ejecución: tu rastro de auditoría, conservado en la etapa a la que pertenece. Para más información sobre dónde detener a los agentes, consulta compuertas de aprobación para agentes de programación.
Límites prácticos antes de empezar
- Empieza en pequeño. El estudio usó modelos de 0,8B y 270M con acceso a tensores en CPU. Elige un modelo que puedas evaluar en minutos.
- No esperes mejoras en habilidades ausentes. El resultado con Gemma indica que una edición puede desbloquear un modelo, no enseñarle algo.
- Trata una sola ejecución como una anécdota. Repite el experimento con un agente nuevo antes de confiar en la edición.
Conclusión
La lección reutilizable de la publicación del MIT es el harness: un presupuesto por escrito, herramientas limitadas, un registro completo y resultados que otra persona pueda verificar. Esos son los controles que ya quieres tener alrededor de un agente de programación que edita código.
Para probarlo, crea las cinco tareas en un Space de Sharkly, asigna las etapas 1 a 4 a agentes en tu Computer conectado y reserva la etapa 5 para ti. Sharkly es gratis para empezar en sharkly.ai.
FAQ
¿Puede un agente de programación editar los pesos de un modelo?
En el estudio del MIT CSAIL, sí. GPT-6 Astra leyó los tensores de Qwen3.5-0.8B en un sandbox de Python y modificó 131.072 pesos. Los autores reportan que MATH-500 subió del 7,9% al 48,1%. El trabajo es preliminar, con modelos pequeños, y varios resultados son ejecuciones únicas.
¿Qué es la programación en el espacio de pesos?
Un LLM lee los parámetros de una red como datos y los edita directamente, sin entrenamiento. Analiza los tensores con código, formula una hipótesis, modifica los pesos y mide el efecto con un número limitado de pases forward.
¿Por qué importa el presupuesto de pases forward?
En el ablation de Qwen de los autores, 10 pases alcanzaron el 12,3% en MATH-500, 25 llegaron al 14,1% y 50 llegaron al 48,1%. El presupuesto determina cuántas ideas puede probar el agente. Escríbelo en la tarea y aplícalo en el sandbox.
¿Puede la edición de pesos añadir nuevas capacidades a un modelo?
El estudio sugiere que no. La mejor edición de Astra llevó a Gemma 3 270M del 6,8% al 7,7% en MATH-500. Los autores concluyen que la edición eliminó un obstáculo en Qwen en lugar de añadir una capacidad.
¿Cómo evito que los pesos editados lleguen a producción?
Monta el original como solo lectura, edita una copia, ejecuta una reevaluación independiente y exige que una persona apruebe el diff de tensores antes de que algo cargue el archivo fuera del sandbox.


