
El web scraping gratuito para agentes de IA ya se ejecuta en tu propio hardware. Firecrawl Local es un único binario Rust que hace scraping, crawl y map de sitios a markdown, se conecta a Claude Code, Codex, Cursor o Gemini CLI como servidor MCP y responde a la API v2 de Firecrawl en localhost. Configura FIRECRAWL_CLOUD=off y ninguna página, consulta ni URL saldrá de tu equipo.
Resumen
- Instalación:
cargo install firecrawl-local(Rust y un compilador de C). Nuestra compilación tardó 5 minutos y 55 segundos y generó un binario de 19 MB. - Conéctalo:
firecrawl-local initañade el servidor MCP a todas las herramientas de agentes compatibles que encuentre. - Coste: 0 $ para scrape, crawl, map y scrape por lotes. La búsqueda, las páginas bloqueadas y los proveedores de datos de Alexandria van a Firecrawl Cloud a menos que lo desactives.
- Interruptor de privacidad:
FIRECRAWL_CLOUD=offmantiene todo en local. - Configuración de equipo: instálalo una vez por cada Computer en el que se ejecuten tus agentes y todos los agentes de ese Computer tendrán el mismo scraper.
Qué es Firecrawl Local
Firecrawl Local es un único binario del equipo de Firecrawl que obtiene páginas web, las convierte en markdown limpio y devuelve el mismo JSON que devuelve la API alojada de Firecrawl. No necesita base de datos, cola ni contenedor. Firecrawl lo anunció el 18 de noviembre de 2026, y el crate en crates.io apareció una semana antes como versión 0.1.0.
El README describe tres formas de usarlo: una CLI, un servidor MCP para agentes y una copia local de la API v2. El código de limpieza se compila a partir de la misma fuente que usa la API alojada, así que una página en markdown generada desde tu portátil coincide con lo que devolvería la nube para una página a la que ambos pueden acceder.
La publicación de lanzamiento de Firecrawl afirma que su primitiva de scrape es 37 veces más rápida que Firecrawl autoalojado y usa 230 veces menos memoria, con 11 MB en reposo. Esos son los números de Firecrawl; el README no publica la metodología. Nosotros medimos la parte de memoria por nuestra cuenta más abajo.
Si ya ejecutas varios agentes de programación, este es el primer scraper que puedes darles a todos sin una factura por llamada. El resto de esta guía cubre la configuración, el interruptor de privacidad y cómo darle a todo un equipo de agentes la misma herramienta en Sharkly.
Por qué los agentes necesitan un scraper local
Un agente que no puede leer la web trabaja con datos de entrenamiento obsoletos. Adivina una API que no ha visto o te pide que pegues documentación en el chat.
Las API de scraping alojadas solucionan eso, pero añaden dos costes. Cada página es una llamada medida, así que un crawl de un sitio de documentación de 400 páginas es una línea en una factura. Y cada URL que abre tu agente pasa por los servidores de otra persona, lo que importa cuando el agente investiga el dominio de un cliente o la página de un competidor aún no lanzada.
Un scraper local elimina ambos. Las páginas se obtienen desde tu propia red y se limpian en tu propia CPU. La contrapartida es que tú te encargas de la instalación y de los límites que conlleva un portátil.
Instalar Firecrawl Local
Necesitas Rust y un compilador de C. En macOS, xcode-select --install cubre el compilador; en Debian o Ubuntu, instala build-essential. Obtén Rust desde rustup.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Dos extras son opcionales. Chrome o Chromium le permite renderizar páginas que necesitan JavaScript; sin ninguno, las páginas estáticas siguen funcionando y una página con mucho script vuelve con una advertencia. Se necesita Node.js 22 o superior para el servidor MCP, porque firecrawl-local mcp ejecuta el paquete npm firecrawl-mcp mediante npx.
Scrape, crawl y map desde la CLI
Tres comandos cubren la mayor parte del trabajo de los agentes.
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
Ejecutamos cada uno el 19 de noviembre de 2026, con la nube desactivada. Un único scrape de example.com terminó en 1,6 segundos. Un crawl de 10 páginas de la propia documentación de Firecrawl tardó 4,2 segundos y escribió 144 KB de markdown. map devolvió la lista de URL de la documentación en 3,9 segundos.
| Comando | Flags útiles |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (predeterminado 100), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Cualquier comando | --browser auto|never|always |
Un detalle de nuestra ejecución: en una red que solo llega a la web a través de un proxy, el primer scrape falló con un error de TLS. Configurar HTTPS_PROXY lo solucionó, así que el binario respeta las variables de proxy estándar.
Conéctalo a tu agente de IA mediante MCP
MCP (Model Context Protocol) es la forma estándar en que una herramienta de agentes carga herramientas externas. Firecrawl Local se registra como una de ellas.
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
La ejecución de prueba en nuestro Mac enumeró cinco destinos: Claude Code en ~/.claude.json, Claude Desktop, Cursor en ~/.cursor/mcp.json, Gemini CLI en ~/.gemini/settings.json y Codex en ~/.codex/config.toml. Windsurf también es compatible cuando está instalado. Reinicia cada herramienta después de init para que cargue el servidor. Usa --agent cursor para configurar solo una herramienta.
Para añadirlo a mano, registra el binario como servidor stdio:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
El agente obtiene las herramientas MCP estándar de Firecrawl. Scrape, crawl, map y scrape por lotes se ejecutan en local; el resto va a Firecrawl Cloud. El flag --public-only es un añadido nuestro, que se explica en la sección de seguridad más abajo.
Mantén la nube desactivada por privacidad
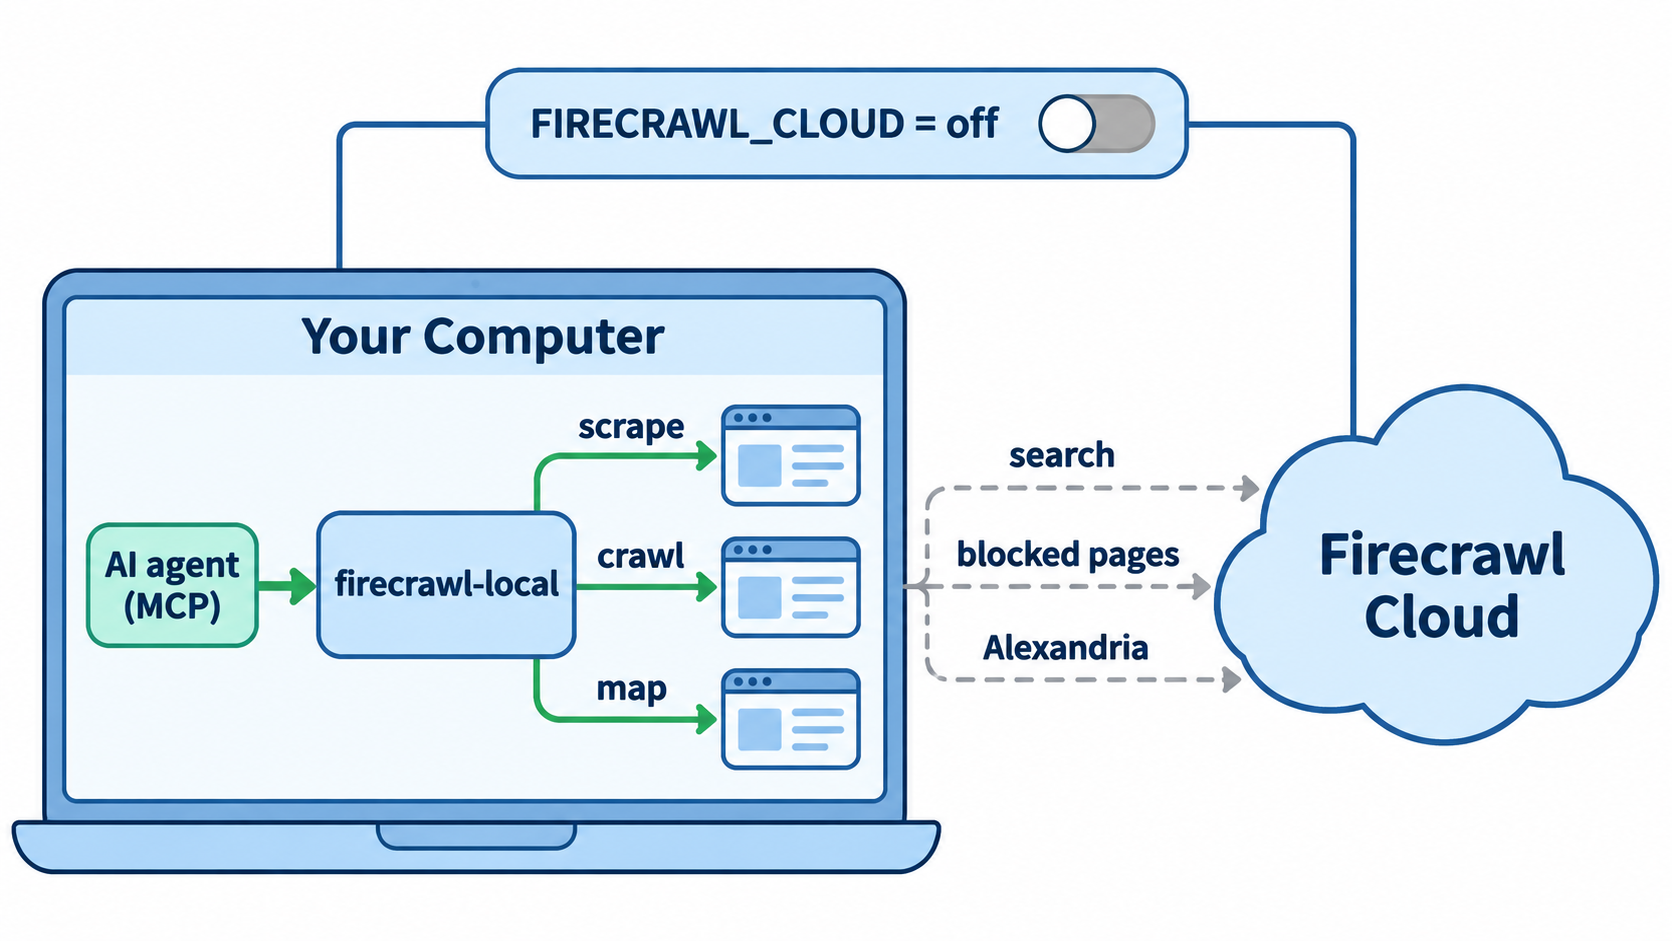
Tres tareas necesitan Firecrawl Cloud, porque un portátil no tiene índice de búsqueda ni forma de evitar un sitio que lo bloquea.
| Enviado a Firecrawl Cloud | Por qué | Cuenta |
|---|---|---|
| Consultas de búsqueda | No hay índice de búsqueda local | No; la búsqueda sin clave tiene límite de velocidad |
| URL de una página que te bloqueó | La nube la obtiene por ti | No |
| Proveedores de datos de Alexandria | Los proveedores se ejecutan en la nube | Sí, una cuenta gratuita mediante firecrawl-local login |
| Un ID de instalación aleatorio y el nombre de tu herramienta | Recuento de instalaciones | No |
La variable FIRECRAWL_CLOUD controla el traspaso. auto (el valor predeterminado) permite todo lo anterior. search envía solo consultas de búsqueda. off no envía nada, y un valor no reconocido también cuenta como off. Una página obtenida de la nube se etiqueta como "source": "firecrawl-cloud", para que puedas auditar qué salió.
Para el trabajo de agentes en sitios de clientes o investigación interna, empieza con off. Tu agente pierde la búsqueda web, así que combínalo con la herramienta de búsqueda en la que ya confíes.
Ejecuta la API de Firecrawl en local
firecrawl-local serve responde a la API v2 de Firecrawl en el puerto 3002 sin clave de API para las rutas locales. El código existente del SDK cambia cambiando una sola URL.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Las rutas locales son POST /v2/scrape, POST /v2/map, crawl y scrape por lotes con sus endpoints de estado y cancelación, y GET /health. Otras rutas /v2, como /v2/search, se reenvían a la nube; v0 y v1 no se sirven.
Medimos la memoria mientras se ejecutaba: el proceso serve se mantuvo en 10 MB residentes en reposo y 16 MB después de un scrape. Eso se acerca a la cifra de 11 MB que afirma Firecrawl. Un scrape a través de la API devolvió "creditsUsed": 0 y "engine": "local-fetch".
Valores de seguridad predeterminados que importan para los agentes
Un agente que lee una página con instrucciones ocultas puede ser dirigido a obtener una URL interna. OWASP clasifica este tipo de ataque como inyección de prompts, y un scraper es la vía obvia para ello.
servese vincula a127.0.0.1y rechaza localhost y las direcciones privadas a menos que pases--allow-private. Le pedimos que hiciera scrape de127.0.0.1:22y obtuvimosBLOCKED_TARGET.- Vincular otro host con
--hostrequiere--token. - Las direcciones link-local y de metadatos de la nube se bloquean en todos los modos, incluso después de redirecciones.
scrape,crawlymcppueden llegar a tu red privada de forma predeterminada, porque se ejecutan para la persona que está frente al teclado. Añade--public-onlycuando un agente navegue por sitios en los que no confías.- Los crawls leen
robots.txt(el estándar RFC 9309), y los propietarios de sitios pueden dirigirse al crawler comoFirecrawlLocal.
Límites a tener en cuenta
- No hay formatos
jsonnisummary, niactionsde navegador en local. Nuestra solicitud desummarydevolvió metadatos y una advertencia de que el formato se omitió. - Las capturas de pantalla necesitan Chrome.
- Los trabajos de crawl y por lotes viven en memoria, caducan una hora después de empezar y terminan cuando se detiene
serve. - Licencia: el repositorio es AGPL-3.0. Consulta con tu equipo legal antes de distribuir una copia modificada dentro de un producto alojado.
Para colas, workers y todos los formatos, la guía de autoalojamiento de Firecrawl cubre el servidor completo.
Dale a cada agente del equipo el mismo scraper
Un desarrollador con un solo agente puede parar aquí. Un equipo que ejecuta varios agentes se topa con otro problema: las herramientas de cada agente viven en la configuración del ordenador en el que se ejecuta, y nadie controla qué agente puede leer la web.
En Sharkly, un Agent se ejecuta en un Computer (un portátil, servidor o contenedor que conectas) mediante un Runtime, que es la herramienta de agentes instalada allí, como Claude Code o Codex. Instalas herramientas en el Computer igual que lo harías para usarlas directamente. Después, los ajustes de Herramientas, conocimiento y MCP del Agent enumeran los servidores MCP que hereda de Claude Code en ese Computer, incluidos los servidores stdio de configuración de usuario, el ámbito en el que escribe init.
Así que la configuración es: instala Firecrawl Local en el Computer, ejecuta init, abre los ajustes del Agent y haz clic en Check. Confirmamos que el panel enumera los servidores stdio de configuración de usuario; todavía no hemos ejecutado un scrape de Firecrawl dentro de una Task de Sharkly, así que prueba primero una Task de solo lectura.
Pon el scraper en un Computer siempre encendido
Un portátil se suspende. Un pequeño servidor Linux registrado como Computer (sharkly computer register con un token de instalación sit_, según la documentación de Computers) permanece encendido, así que cada Agent que apunte a él comparte un scraper y una política de FIRECRAWL_CLOUD. Configura la variable en el entorno del Runtime del Agent para que la política viaje con el Agent, no con quien inició sesión por última vez.
A partir de ahí, la investigación se convierte en trabajo asignable. Un líder de Crew divide «mapea la documentación de estos cinco proveedores» en Tasks, cada Agent hace crawl de su parte en local y los resultados llegan al tablero para revisión humana. Sharkly es gratis para organizaciones de hasta 5 personas hoy, y los Agents y Computers no ocupan plazas; los modelos siguen en tus propias suscripciones.
Usos reales
- Ingesta de documentación: haz crawl de la documentación de una biblioteca a markdown antes de que un agente actualice una dependencia.
- Investigación de leads: combina el scraping local con los proveedores de Alexandria, como en nuestro tutorial para crear listas de leads.
- Vigilancia de changelogs: una Task programada hace map del sitio de un proveedor a diario y marca las URL nuevas.
- Investigación privada: haz scrape de páginas de clientes o de prelanzamiento con la nube desactivada, para que nada salga de tu red. Nuestro artículo sobre por qué desactivar la búsqueda web no detiene las fugas de datos cubre las otras salidas.
Conclusión
Firecrawl Local convierte el web scraping gratuito para agentes de IA en una compilación de seis minutos y un comando init. Mantén FIRECRAWL_CLOUD=off para el trabajo privado, añade --public-only para sitios que no son de confianza y trata las afirmaciones de velocidad como de Firecrawl hasta que las midas.
Tu siguiente paso: instálalo en el Computer que ya usan tus agentes y luego conecta ese Computer a Sharkly para que cada Agent del equipo tenga el mismo scraper y las mismas reglas. Para más configuraciones a 0 $, consulta agentes de IA gratuitos para equipos.
Preguntas frecuentes
¿Firecrawl Local es gratis? Sí. Scrape, crawl, map y scrape por lotes se ejecutan en local sin clave de API, y nuestro scrape de prueba informó de 0 créditos usados. La búsqueda y Alexandria usan Firecrawl Cloud.
¿Firecrawl Local necesita Docker? No. Es un solo binario sin base de datos, cola ni contenedor. Docker es solo una opción, y la renderización de JavaScript en un contenedor necesita un perfil seccomp que permita el sandbox de Chrome.
¿Qué agentes admite firecrawl-local init? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI y Codex. Cualquier otro cliente MCP puede registrar firecrawl-local mcp como servidor stdio.
¿Puedo mantener todo el scraping fuera de los servidores de Firecrawl? Sí. Configura FIRECRAWL_CLOUD=off. Pierdes la búsqueda, el respaldo para páginas bloqueadas y Alexandria.
¿Firecrawl Local es más rápido que Firecrawl autoalojado? Firecrawl dice que es 37 veces más rápido y usa 230 veces menos memoria. Medimos 10 MB de memoria en reposo, lo que coincide con la afirmación sobre memoria; no comparamos la velocidad con un servidor autoalojado.
¿Firecrawl Local es de código abierto? El repositorio tiene licencia AGPL-3.0. Lee la licencia antes de distribuir una copia modificada como parte de un servicio alojado.


