

TL;DR: Los precios de GPT-6.2 son de 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida para Astra, y de 2 $ y 10 $ para Sol. Las lecturas de caché de entrada cuestan 0,40 $ y 0,10 $. Una tarea de agente ilustrativa de 20 turnos cuesta unos 3,23 $ en Astra y 0,81 $ en Sol con la caché de prompts funcionando, y cuatro veces eso sin ella.
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Astra es el modelo frontera para el trabajo más difícil. Sol es el modelo de uso diario, y su página de modelo indica que está diseñado para “impulsar agentes a escala”.
Un precio por millón de tokens dice poco sobre lo que gastará un equipo de agentes. Los agentes reenvían su contexto en cada turno, por lo que la factura depende de la caché, la longitud del contexto y cuántos agentes se ejecuten a la vez. Esta guía convierte la lista de precios de GPT-6.2 en cifras por tarea y por mes, y luego muestra los límites que las mantienen previsibles. Si ya ejecutas agentes de código en paralelo, Sharkly es donde puedes establecer esos límites por Agente.
Precios de GPT-6.2 para Astra y Sol
Esta es la lista de precios estándar de la API tomada de la página del modelo Astra y la página del modelo Sol, verificada el 20 de noviembre de 2026. Todos los precios son por millón de tokens.
| Precio por 1M de tokens | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Entrada | 8,00 $ | 2,00 $ |
| Entrada en caché (lecturas) | 0,40 $ | 0,10 $ |
| Escrituras en caché (retención de 30 minutos) | 10,00 $ | 2,50 $ |
| Escrituras en caché (retención de 12 horas) | 20,00 $ | 5,00 $ |
| Salida | 40,00 $ | 10,00 $ |
| Ventana de contexto | 1.050.000 | 1.050.000 |
Sol cuesta exactamente un cuarto de lo que cuesta Astra en cada línea. Ambos modelos comparten la misma ventana de contexto y los mismos límites de velocidad, así que el precio es lo que los diferencia en una factura.
Las reglas de precios que cambian el total
Cinco reglas en las páginas de los modelos mueven una factura de agentes más que la tarifa principal:
- Recargo por contexto largo. Una solicitud con más de 272K tokens de entrada paga el doble por entrada y caché, y 1,5 veces por salida, sobre toda la solicitud.
- Las escrituras en caché cuestan más. Escribir un prefijo en la caché cuesta 1,25 veces la entrada normal durante 30 minutos, o 2,5 veces durante 12 horas.
- Las lecturas de caché son baratas. En GPT-6.2 una lectura de caché cuesta 0,05 veces la entrada normal, según la guía de caché de prompts de OpenAI.
- Batch cuesta el 50 por ciento de las tarifas estándar.
- La velocidad cuesta más. El modo Fast es 2 veces la tarifa estándar. Ultrafast es 3 veces hasta el 28 de febrero de 2027, y 6 veces a partir del 1 de marzo de 2027.
GPT-6.2 no admite Flex processing. Su reemplazo es una ventana de finalización en segundo plano con descuento, que se explica más abajo.
Cuánto cuesta una tarea de agente en GPT-6.2
Toma una tarea de código ilustrativa: 20 turnos, 60.000 tokens de entrada por turno y 2.000 tokens de salida por turno. Eso hace 1,2 millones de tokens de entrada y 40.000 tokens de salida para toda la tarea. Tus cifras serán diferentes, así que sustitúyelas por las tuyas.
| Escenario | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Sin aciertos de caché | 11,20 $ | 2,80 $ |
| 90 por ciento de aciertos de caché | 3,23 $ | 0,81 $ |
| 90 por ciento de aciertos de caché, ventana en segundo plano de 8 horas | 1,94 $ | 0,49 $ |
Las filas con caché suponen que el 90 por ciento de la entrada se lee desde la caché y el otro 10 por ciento se factura como una escritura en caché de 30 minutos. Ese es el escenario pesimista, por lo que una ejecución real con caché debería situarse en estas cifras o por debajo.
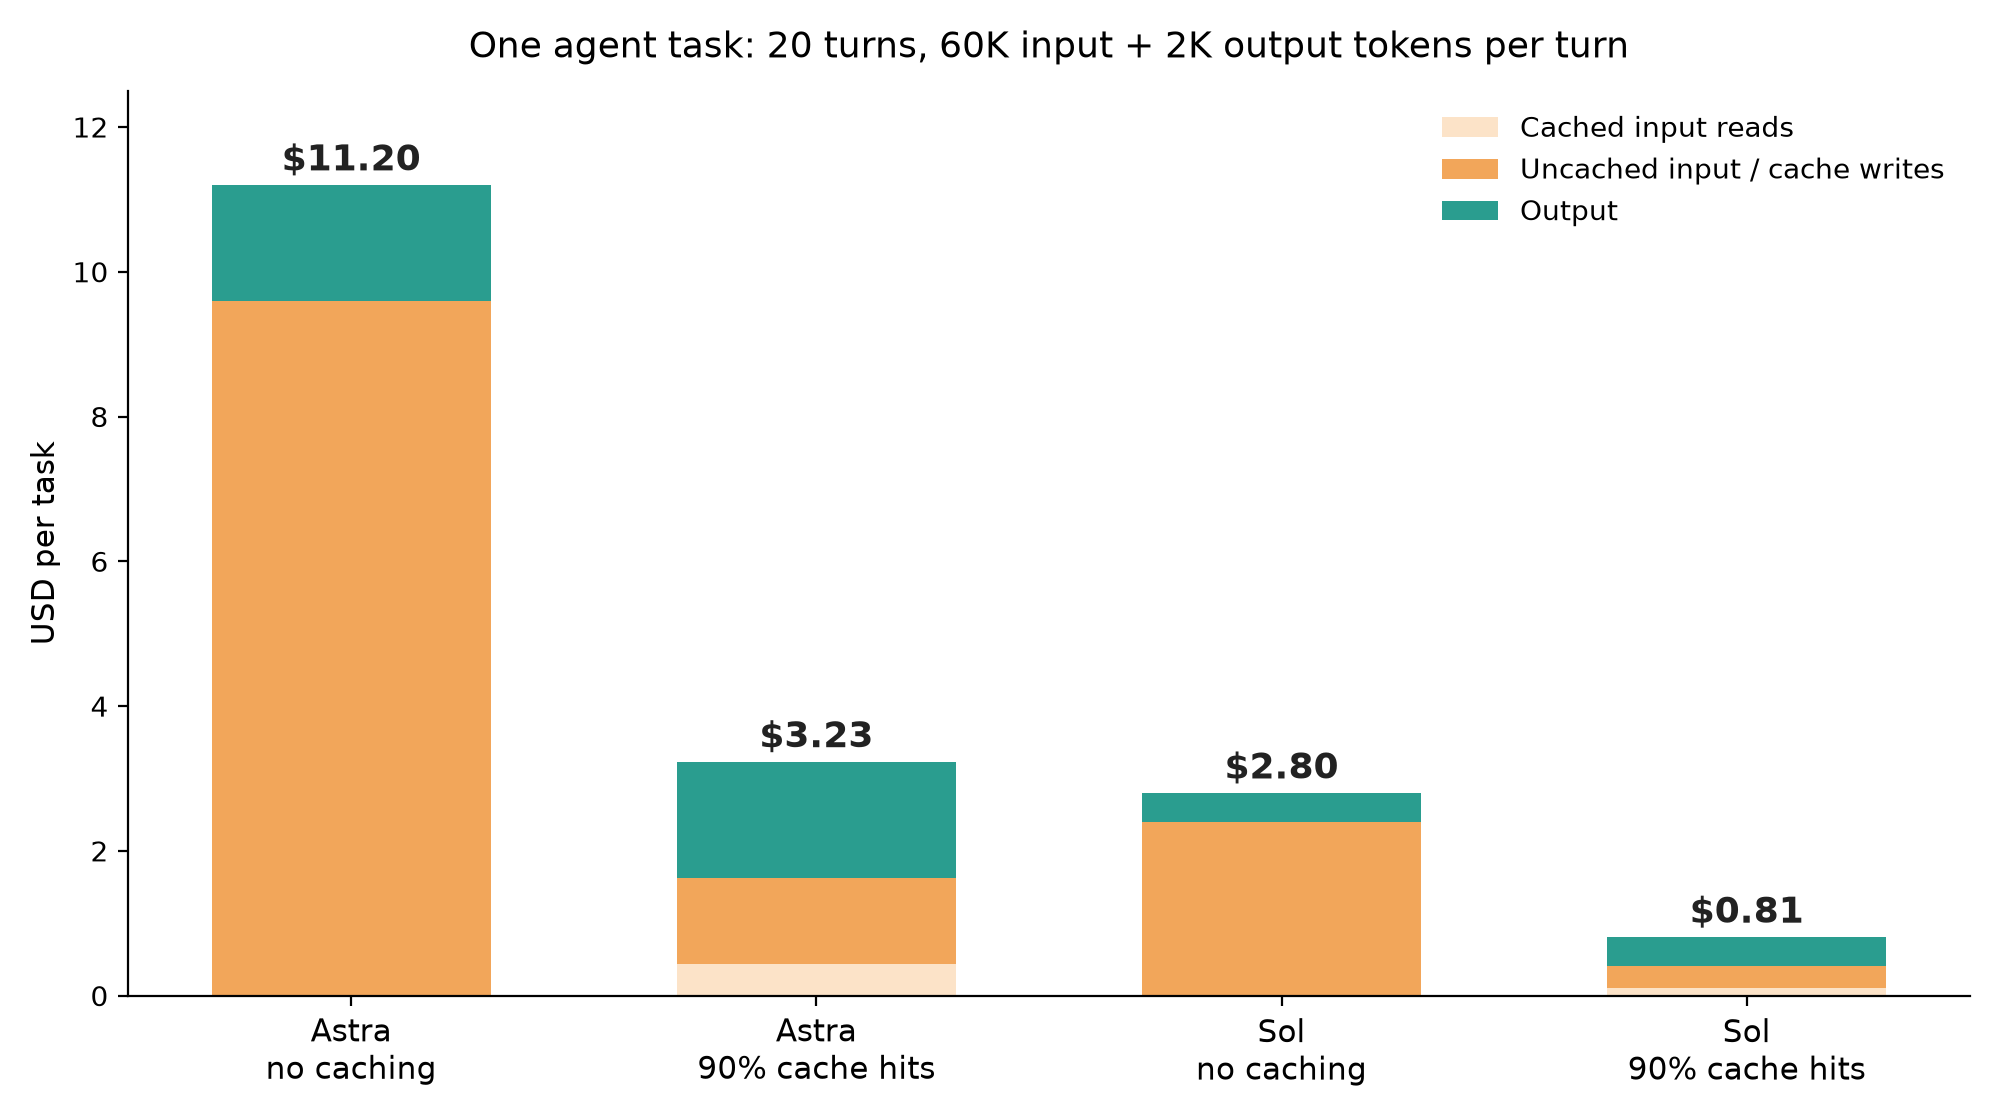
Dos cifras destacan. La caché reduce el coste de la tarea en torno al 71 por ciento en ambos modelos. Y una tarea de Astra con caché cuesta solo un poco más que una tarea de Sol sin caché. El modelo barato con una caché rota cuesta casi lo mismo que el modelo caro con una caché que funciona.
Dónde duele el recargo por contexto largo
Los agentes de código que leen media parte de un repositorio pueden superar los 272K tokens de entrada por turno. Compara dos turnos de Sol, ambos con 2.000 tokens de salida y sin caché:
- 270.000 tokens de entrada: 0,54 $ de entrada más 0,02 $ de salida, 0,56 $ en total.
- 300.000 tokens de entrada: 1,20 $ de entrada más 0,03 $ de salida, 1,23 $ en total.
Un contexto un 11 por ciento más grande cuesta más del doble. Si tu entorno de agentes compacta el contexto, mantenlo por debajo de 272K. La misma lógica hay detrás de nuestro artículo sobre por qué los modelos baratos pueden costar más: el precio por cambio aceptado importa más que el precio por token.
Coste mensual de GPT-6.2 para un equipo de agentes
Ahora escalemos las cifras con caché. Digamos que cinco agentes completan 8 tareas al día durante 22 días laborables. Eso son 880 tareas al mes.
| Configuración del equipo | Tareas por mes | Coste mensual del modelo |
|---|---|---|
| Los cinco agentes en Astra | 880 | 2.842 $ |
| Un líder en Astra, cuatro agentes en Sol | 176 + 704 | 1.139 $ |
| Los cinco agentes en Sol | 880 | 713 $ |
La configuración mixta cuesta un 60 por ciento menos que la de solo Astra. Mantiene el modelo frontera para la planificación y las revisiones difíciles, y envía el trabajo rutinario a Sol. Tratamos el rol de líder en GPT-6 Astra como líder de tu Crew, y el mismo razonamiento impulsa el mismo presupuesto, más agentes con GPT-6 Sol.
El precio es solo un límite. Los tokens por minuto detienen a un equipo de agentes antes que el dinero en los niveles de uso más bajos, algo que la guía de límites de velocidad de GPT-6.2 analiza nivel por nivel.
Planes de Codex frente a claves de API
Si tus agentes ejecutan Codex con un plan de ChatGPT, no pagas por token. Gastas una asignación. La página de precios de Codex estima de 6 a 50 mensajes locales por ventana de cinco horas para GPT-6.2 Astra en Plus y Standard Business, y de 17 a 180 para Sol. Las sesiones largas agotan la asignación más rápido, así que el cálculo de tokens anterior sigue prediciendo qué tareas se agotan primero.
Nuestra guía de GPT-6.2 Codex cubre la configuración de ambos modelos.
Cómo reducir el coste de GPT-6.2 para equipos de agentes
El orden siguiente mueve primero el dinero más importante:
- Haz que la caché funcione. Coloca las instrucciones estables en un mensaje
developeral inicio de la entrada, y nunca reescribas los turnos anteriores. Un prefijo modificado es un fallo de caché. - Usa Sol por defecto. Asciende una tarea a Astra solo cuando atraviese servicios o cuando Sol falle dos veces el mismo tipo de tarea.
- Mantente por debajo de los 272K tokens de entrada por solicitud.
- Envía el trabajo masivo a ventanas en segundo plano cuando llames a la API desde tu propio entorno.
- Usa Batch para evaluaciones y trabajos sin conexión, nunca para un agente interactivo.
- Deja Fast y Ultrafast desactivados salvo que alguien esté esperando el resultado.
Las ventanas en segundo plano con descuento reemplazan a Flex
La guía del modo en segundo plano de OpenAI enumera dos ventanas de finalización con descuento para la API de Responses, en beta pública en GPT-6.2: 2h con un 30 por ciento por debajo de la tarifa estándar y 8h con un 40 por ciento por debajo. Comparten el límite de velocidad de Batch, no tu límite de tokens en tiempo real.
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.2-sol",
    input=[
        {"role": "developer", "content": "You write unit tests for the payments service."},
        {"role": "user", "content": "Add tests for refund edge cases in refunds.py."},
    ],
    background=True,
    background_options={"completion_window": "8h"},
)
print(response.id, response.status)
Consulta el ID de la respuesta más tarde, o usa un webhook. Esto encaja con la generación de pruebas, las actualizaciones de dependencias y las pasadas de documentación que nadie necesita antes de la mañana.
Controla el gasto de GPT-6.2 por Agente en Sharkly
Sharkly no revende tokens. Cada ejecución se factura contra el plan de Codex o la clave de API ya vinculados al Runtime, por lo que tu factura de OpenAI sigue siendo la única fuente de verdad. Lo que Sharkly te ofrece es control sobre cuánto trabajo llega a esa factura.
Cada Agente tiene una fila de Modelo por defecto que muestra los modelos que su Runtime reporta. Configura tus agentes rutinarios con Sol y tu Agente líder con Astra. Cuando una tarea necesita más, la documentación de Sharkly describe una anulación por tarea: pasa el cursor sobre el Agente en el selector de asignados y elige un modelo solo para esa ejecución.
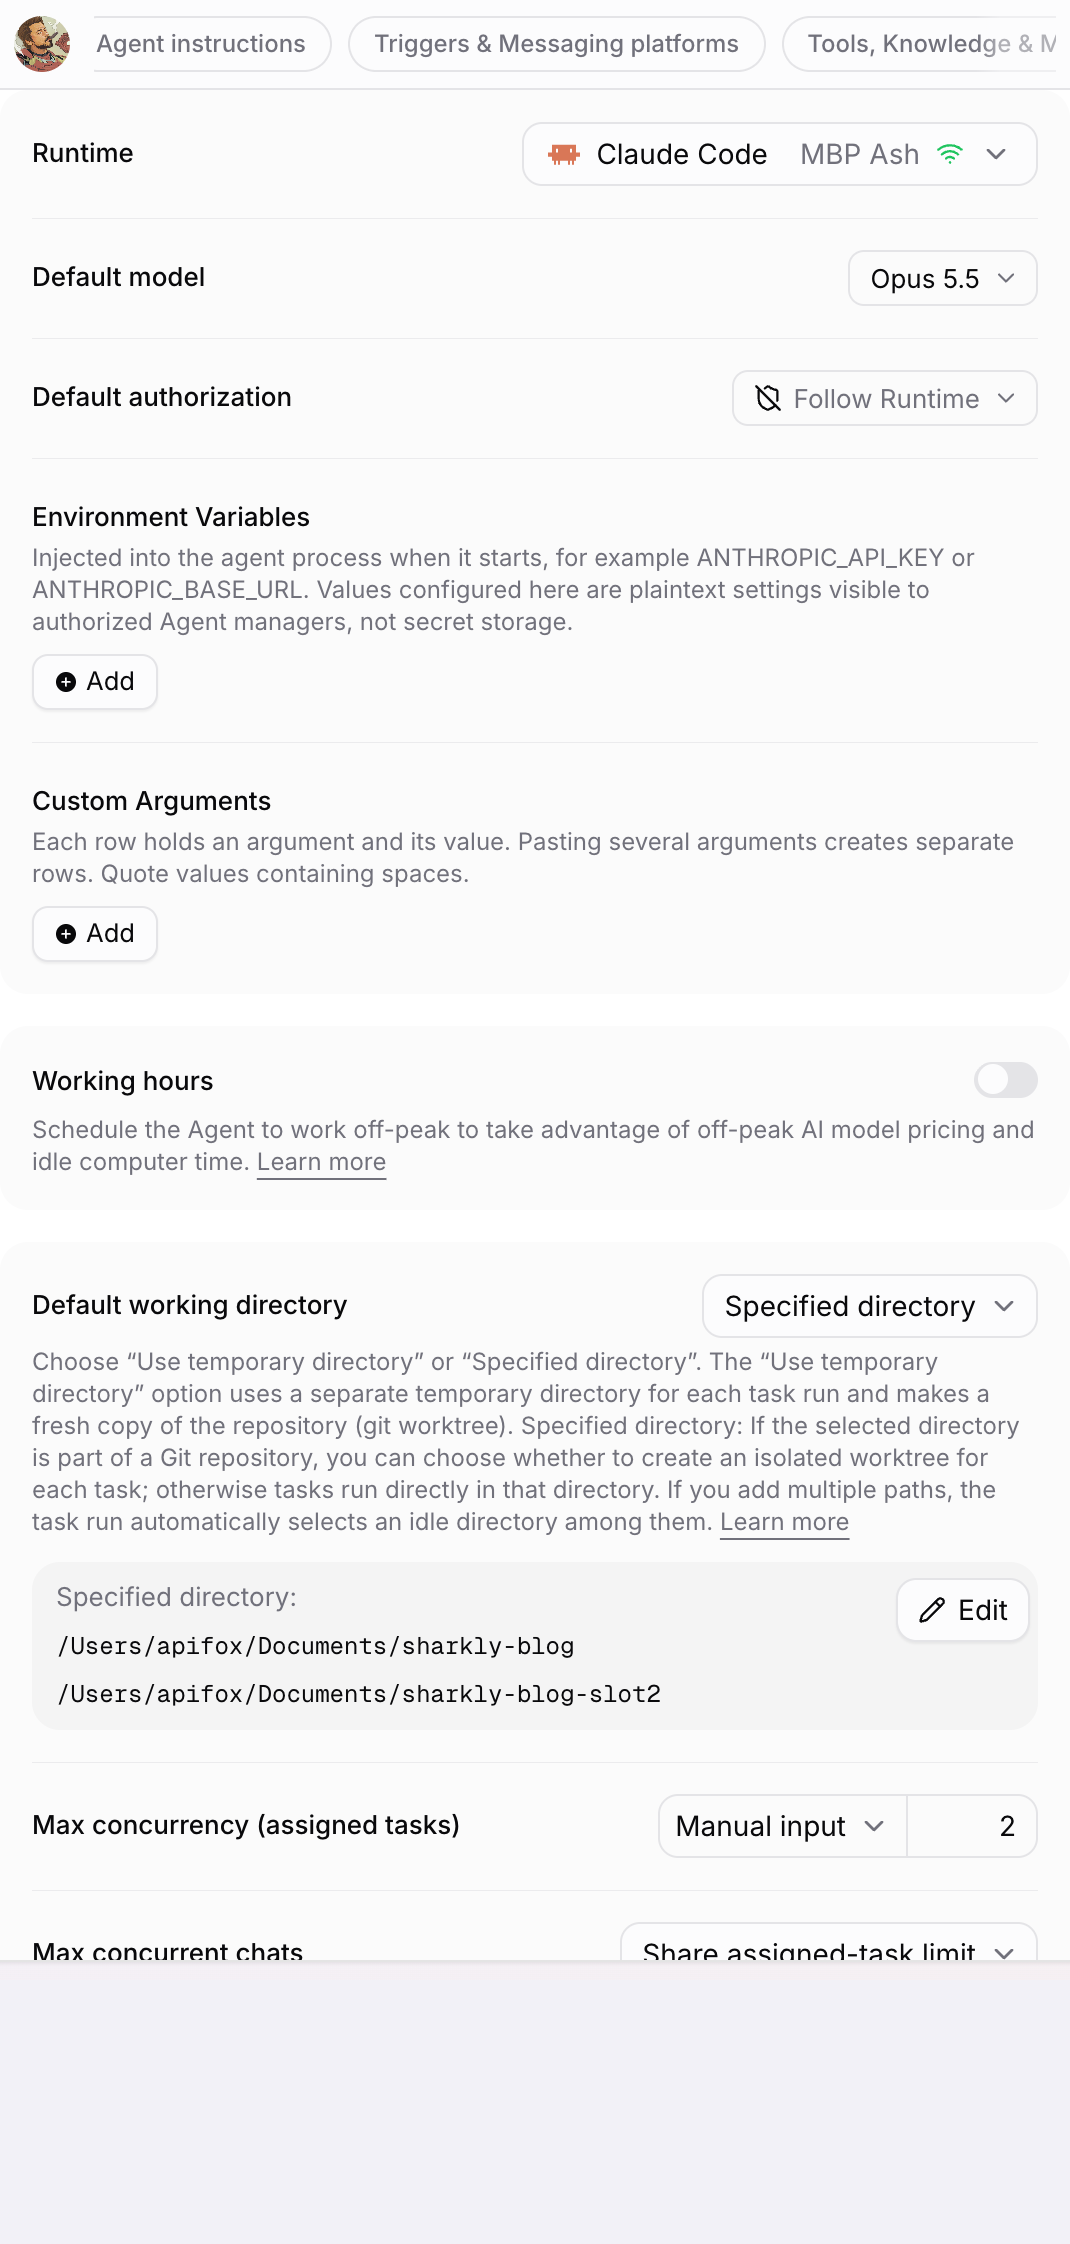
El mismo panel contiene las Variables de entorno, inyectadas en el proceso del agente al inicio. Asigna a cada grupo de Agentes una clave de API de su propio proyecto de OpenAI, y tu página de uso de OpenAI dividirá el gasto por grupo. El Horario laboral programa un Agente en ventanas fuera de las horas punta, de modo que las tareas masivas se ejecuten de noche y la capacidad diurna quede para las personas que están esperando.
El gasto también necesita un techo. La concurrencia máxima limita cuántas tareas ejecuta un Agente a la vez, la duración máxima de ejecución detiene una ejecución que entra en bucle, y el tiempo de espera de la cola descarta el trabajo que esperó demasiado.
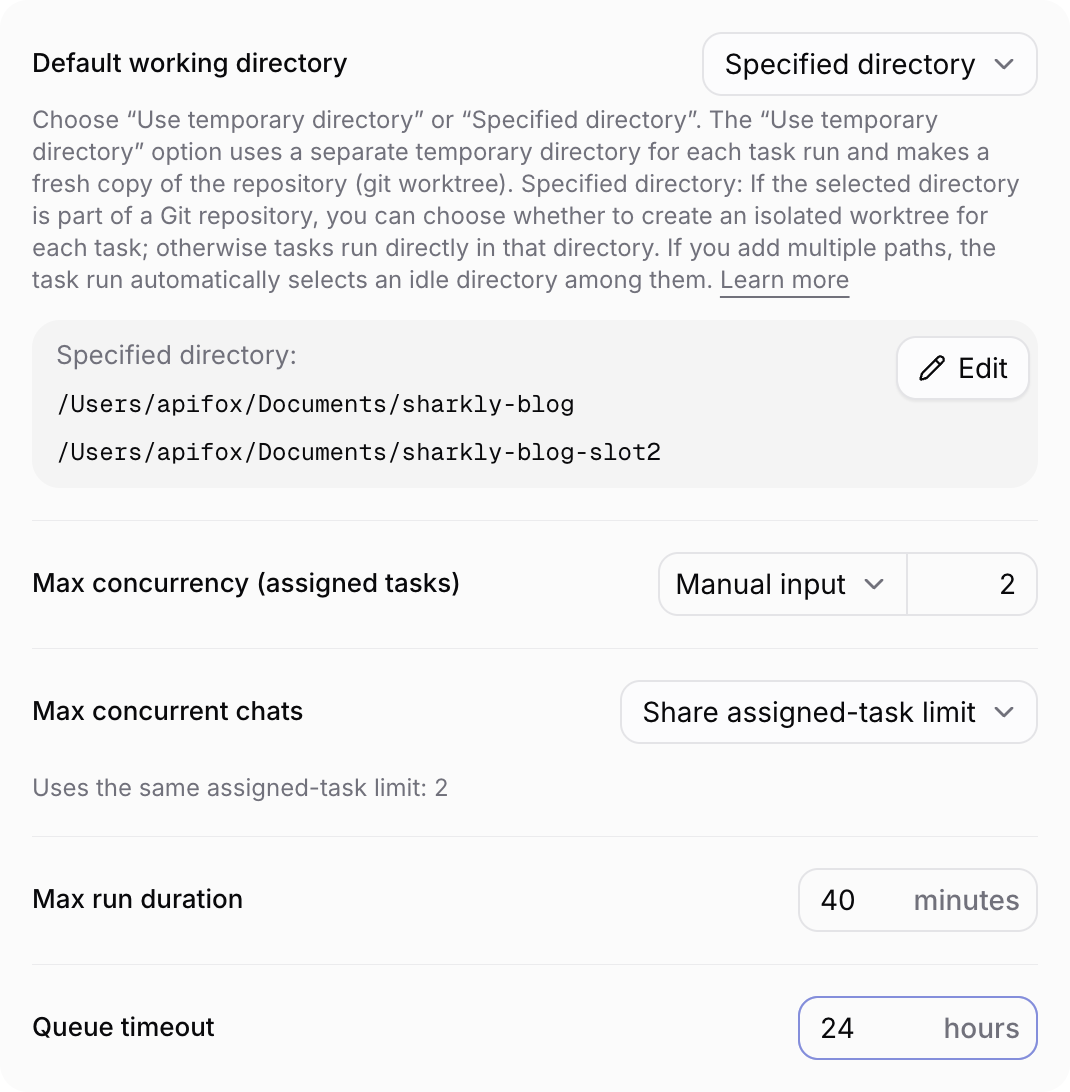
Un límite de ejecución de 40 minutos en un Agente de Sol acota el peor caso. La lista de ejecuciones de cada Agente muestra los tokens que usó cada ejecución, así que puedes detectar el tipo de tarea que consume el triple que las demás. Esa tarea necesita una descripción más ajustada o un modelo más barato.
Conclusión
Los precios de GPT-6.2 parecen simples: Astra cuesta cuatro veces Sol en cada línea. La factura de los agentes no es simple. La caché mueve una tarea en torno al 71 por ciento, el umbral de 272K puede duplicar un turno, y la concurrencia multiplica todo ello. Mide una tarea real, sube tu tasa de aciertos de caché, pon el trabajo rutinario en Sol y limita lo que se ejecuta a la vez.
Pruébalo primero en un Agente. Conecta un Computer, crea un Agente Codex con GPT-6.2 Sol, configura la concurrencia máxima en 2 y la duración máxima de ejecución en 40 minutos, y asígnale una tarea rutinaria. Luego revisa los tokens de la ejecución. Más sobre ejecutar un equipo en paralelo en cómo ejecutar 10 agentes de código con IA a la vez.
FAQ
¿Cuánto cuesta GPT-6.2?
GPT-6.2 Astra cuesta 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida. GPT-6.2 Sol cuesta 2 $ y 10 $. Las lecturas de entrada en caché cuestan 0,40 $ en Astra y 0,10 $ en Sol.
¿GPT-6.2 Sol es más barato que Astra?
Sí. Sol cuesta un cuarto de Astra en entrada, salida, lecturas de caché y escrituras en caché. Ambos comparten una ventana de contexto de 1.050.000 tokens y los mismos límites de velocidad.
¿Cuál es el precio de contexto largo de GPT-6.2?
Las solicitudes con más de 272K tokens de entrada pagan el doble por entrada y caché, y 1,5 veces por salida, sobre toda la solicitud, no solo sobre los tokens por encima del umbral.
¿GPT-6.2 admite Flex processing?
No. OpenAI orienta el trabajo de larga duración hacia ventanas de finalización en segundo plano con descuento: 2h con un 30 por ciento de descuento y 8h con un 40 por ciento, en beta pública.
¿Cuánto cuesta GPT-6.2 Batch?
Batch cuesta el 50 por ciento de las tarifas estándar en ambos modelos. Encaja con evaluaciones y trabajos sin conexión, no con agentes interactivos.
¿Sharkly cobra por los tokens de GPT-6.2?
No. Sharkly ejecuta los agentes de código que ya usas, y el uso del modelo se factura contra tu propio plan de Codex o clave de API. Sharkly controla qué modelo usa cada Agente y cuántas tareas se ejecutan a la vez.


