
El coste por tarea de Gemini 4 Neon depende de algo más que su precio de 3 $ / 15 $ por millón de tokens. Google afirma que Neon, en su nivel de pensamiento predeterminado high, cuesta un 32 % menos por tarea que Gemini 4 Carbon. Por token, Neon cuesta un 50 % más que la tarifa de lanzamiento de Carbon y un 25 % menos que la tarifa de Carbon a partir del 1 de diciembre de 2026. Cuál es más barato para tus agentes depende de los tokens por tarea y de cuántos intentos acepta tu equipo.
TL;DR
- Precio oficial de Neon: 3 $ por 1M de tokens de entrada, 15 $ por 1M de tokens de salida (pensamiento incluido), 0,15 $ por 1M de entrada en caché. Solo nivel de pago.
- Precio oficial de Carbon: 2 $ / 10 $ hasta el 30 de noviembre de 2026, y 4 $ / 20 $ a partir del 1 de diciembre.
- Afirmación de Google: un 32 % menos de coste por tarea que Carbon en
high, según un gráfico del Artificial Analysis Intelligence Index. La publicación no indica qué precio de Carbon usó el gráfico. - Qué significa: Neon solo supera el precio de lanzamiento de Carbon si completa la misma tarea con menos de dos tercios de los tokens de Carbon. A partir del 1 de diciembre gana, salvo que consuma un tercio más de tokens que Carbon.
- Qué medir: el coste por cambio aceptado, no el coste por intento.
Precios de Gemini 4 Neon frente a Carbon y Hydrogen
Gemini 4 Neon es el modelo intermedio de la familia Gemini 4 de Google, lanzado el 18 de noviembre de 2026 como gemini-4-neon. La ficha técnica del modelo lo describe como una adaptación de Carbon, diseñado para equilibrar «profundidad y eficiencia». Estas son las tarifas estándar del nivel de pago por 1M de tokens según la página de precios de la API de Gemini:
| Modelo | Entrada | Salida (incl. pensamiento) | Entrada en caché | Entrada / salida por lotes | Nivel gratuito |
|---|---|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | 0,15 $ | 1,50 $ / 7,50 $ | No |
| Gemini 4 Carbon, hasta el 30 de nov. | 2,00 $ | 10,00 $ | 0,10 $ | 1,00 $ / 5,00 $ | No |
| Gemini 4 Carbon, desde el 1 de dic. | 4,00 $ | 20,00 $ | 0,20 $ | 2,00 $ / 10,00 $ | No |
| Gemini 4 Hydrogen (nivel de pago) | 1,50 $ | 7,50 $ | 0,075 $ | 0,75 $ / 3,75 $ | Sí |
Los tres modelos utilizan únicamente la caché implícita. La guía de AI Studio de Neon indica que la caché implícita se activa en prompts de al menos 4.096 tokens y aplica un 95 % de descuento a la entrada en caché. Neon no tiene caché explícita, así que elimina cualquier campo cached_content al migrar una configuración de Carbon.
Google factura «cada token que el modelo procesa, incluidos los tokens de pensamiento, las instrucciones internas del sistema de grounding y las declaraciones de funciones». Para un agente con muchas herramientas, esas declaraciones acompañan cada turno.
Cómo mide Google el coste por tarea de Neon
El coste por tarea es el gasto total que le cuesta a un modelo completar una tarea de benchmark: los tokens que usó multiplicados por su precio. La publicación de lanzamiento de Google dice que en high, Neon «combina una puntuación alta en el Artificial Analysis Intelligence Index con un coste por tarea un 32 % menor que Carbon». El gráfico está etiquetado como «AA Index v5.01 cost per task».
Artificial Analysis es un tercero, no Google. La publicación ofrece dos afirmaciones de coste adicionales, y ninguna de ellas va sobre Carbon:
- Neon se ejecuta con «un coste por tarea aproximadamente entre un 50 % y un 80 % menor que los principales modelos frontera de la competencia», sin nombrar a los competidores.
- En
xhigh, Neon aún cuesta «un 36 % o más menos por tarea que los modelos competidores en su configuración máxima».
La publicación no revela los recuentos de tokens ni el precio de Carbon detrás del 32 %. Ese vacío importa más de lo habitual, porque el precio de Carbon se duplica menos de dos semanas después del lanzamiento de Neon.
¿Es Gemini 4 Neon más barato que Carbon? Depende de la fecha
Por token, Neon se sitúa entre los dos precios de Carbon: 1,5 veces la tarifa de lanzamiento y 0,75 veces la tarifa de diciembre. Así que el 32 % solo puede venir de que Neon use menos tokens por tarea. Veamos la afirmación por ambos caminos:
| Si el gráfico de Google preció Carbon en | Tokens de Neon implícitos frente a Carbon | Neon frente a Carbon hasta el 30 de nov. | Neon frente a Carbon desde el 1 de dic. |
|---|---|---|---|
| 2 $ / 10 $ (lanzamiento) | aprox. 45 % | 32 % más barato | aprox. 66 % más barato |
| 4 $ / 20 $ (diciembre) | aprox. 91 % | aprox. 36 % más caro | 32 % más barato |
Ambas filas asumen que los dos modelos reparten los tokens de entrada y salida en la misma proporción, lo cual es una simplificación. Sea como sea, desde el 1 de diciembre Neon es más barato por tarea según los propios números de Google. Hasta el 30 de noviembre, la respuesta depende de un detalle que Google no publicó.
Cuánto cuesta una tarea de agente al precio oficial
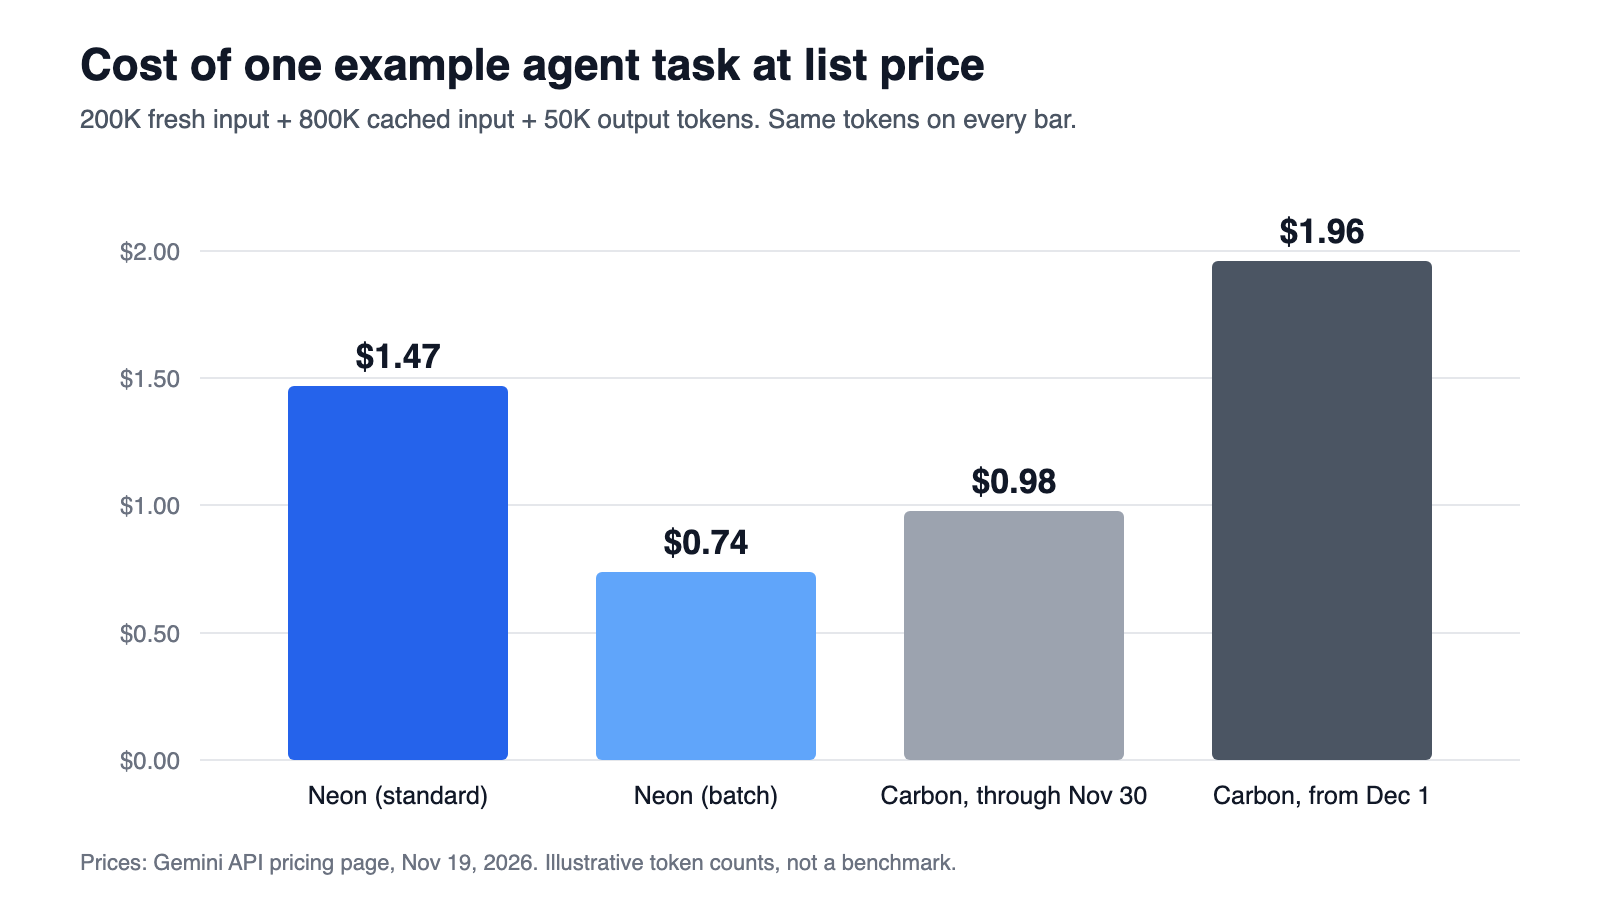
Aquí tienes un ejemplo resuelto con números redondos, no un benchmark. Imagina una sesión de un agente de código que envía 200K de tokens de entrada nuevos, obtiene 800K de tokens como aciertos de caché al volver a leer el repositorio y produce 50K de tokens de salida, incluido el pensamiento.
| Modelo | Entrada nueva | Entrada en caché | Salida | Total |
|---|---|---|---|---|
| Neon (estándar) | 0,60 $ | 0,12 $ | 0,75 $ | 1,47 $ |
| Neon (lotes) | 0,30 $ | 0,06 $ | 0,375 $ | 0,74 $ |
| Carbon, hasta el 30 de nov. | 0,40 $ | 0,08 $ | 0,50 $ | 0,98 $ |
| Carbon, desde el 1 de dic. | 0,80 $ | 0,16 $ | 1,00 $ | 1,96 $ |
Con recuentos de tokens idénticos, Neon pierde frente al precio de lanzamiento de Carbon y gana frente a su precio de diciembre. La regla del punto de equilibrio es sencilla. Frente al precio de lanzamiento, Neon tiene que terminar usando menos del 67 % de los tokens de Carbon. Frente al precio de diciembre, Neon sigue siendo más barato salvo que necesite más del 133 % de los tokens de Carbon.
En este ejemplo, la salida es la mitad de la factura de Neon, y los tokens de pensamiento se facturan como salida. Por eso el nivel de pensamiento que elijas afecta al coste más que el precio oficial.
Niveles de pensamiento: el mando detrás del coste por tarea de Neon
Neon admite cuatro niveles de pensamiento: low, medium, high (el predeterminado) y xhigh. La guía de Google es directa sobre el compromiso: xhigh «aumenta la latencia y el uso de tokens», y debes «elegir el thinking_level más bajo que cumpla tu umbral de calidad».
Un enrutamiento práctico para el trabajo de agentes sería este:
low: preguntas sobre el código base, resúmenes de diffs, notas de triaje.medium: correcciones acotadas donde la suite de tests es el verdadero juez.high: refactorizaciones, depuración y sesiones largas de llamadas a herramientas. Aquí es donde aplica la afirmación del 32 % de Google.xhigh: solo para tareas que ya hayan fallado la revisión enhigh.
Configúralo por petición en el código:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon rechaza el antiguo nivel minimal con un error e ignora temperature, top_p y top_k. Google también recomienda timeouts del cliente de al menos 15 minutos para prompts difíciles, algo que los agentes de larga duración alcanzan primero.
Por qué el coste por tarea sigue sin ser tu número
Una tarea de benchmark termina cuando el evaluador le da nota. La tuya termina cuando una persona fusiona el cambio. Los reintentos, los diffs rechazados y el tiempo de revisión se sitúan entre ambos extremos, y ningún gráfico de coste por tarea los muestra.
El número que se corresponde con tu presupuesto es el coste por cambio aceptado: el gasto total del modelo en una tarea, sumando todos los intentos, dividido entre los cambios que enviaste. Explicamos el argumento completo en cuando un modelo más barato cuesta más. La versión corta:
cost per accepted change = cost per attempt / acceptance rate
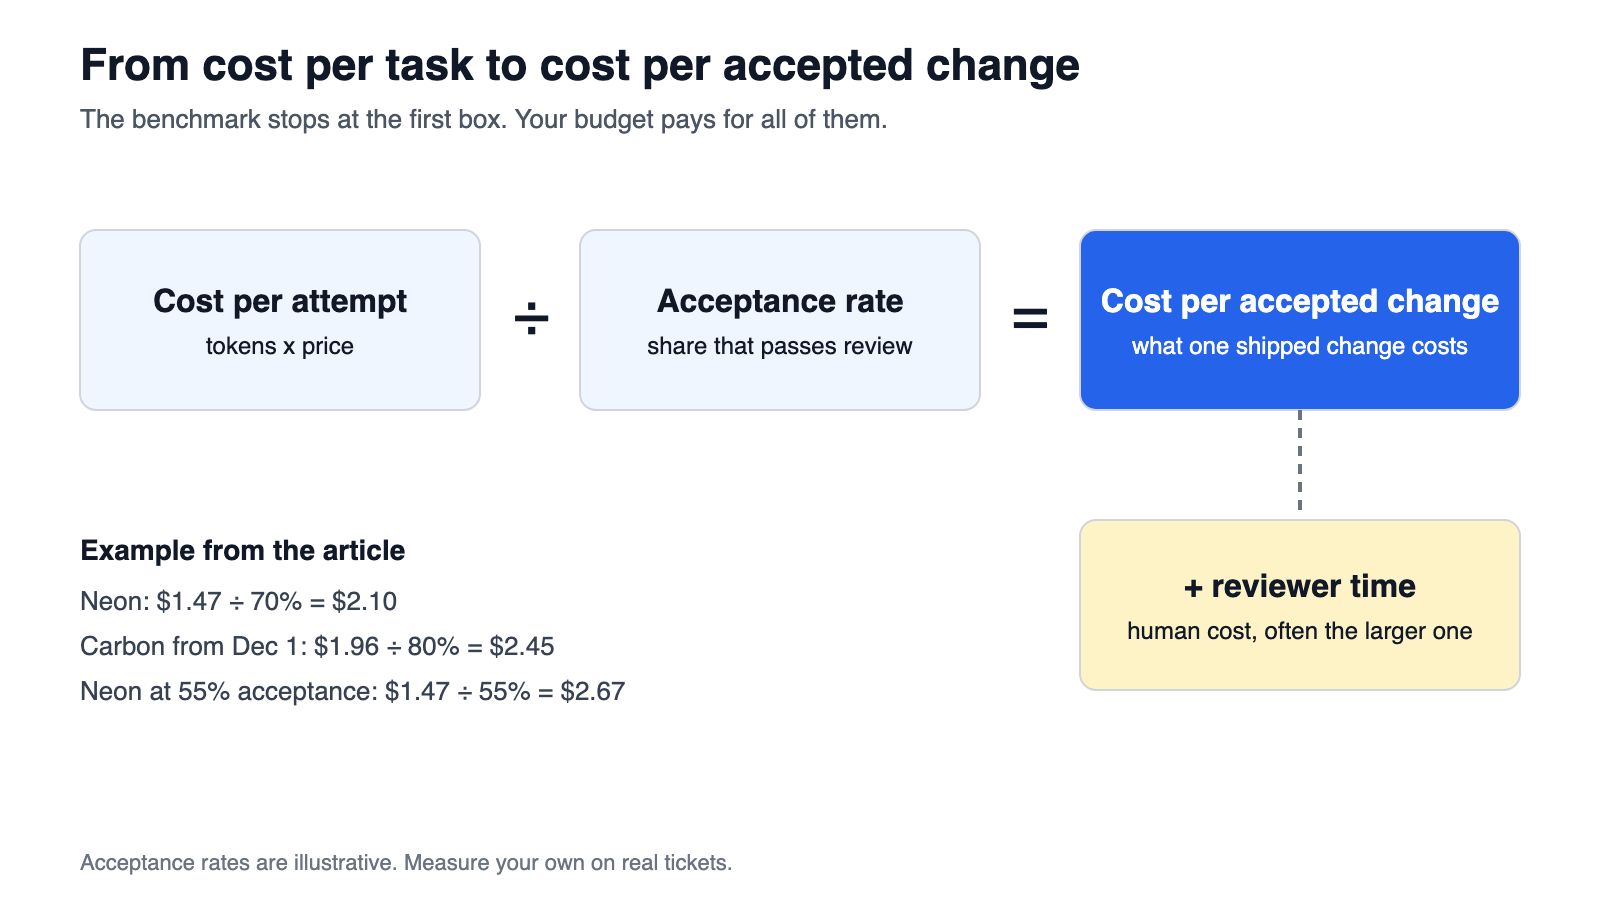
Aplica el ejemplo de arriba. Si Neon pasa la revisión en el 70 % de los primeros intentos, 1,47 $ por intento se convierte en 2,10 $ por cambio aceptado. Si Carbon, a su precio de diciembre, pasa el 80 %, 1,96 $ se convierte en 2,45 $. Neon sigue ganando. Pero si bajas Neon a un 55 % de aceptación, cuesta 2,67 $ por cambio aceptado, y Carbon gana. Tus tasas de aceptación, no el gráfico de Google, deciden el enrutamiento.
El tiempo del revisor queda fuera de esa fórmula y suele costar más que los tokens. La revisión humana es el cuello de botella para los agentes en paralelo, así que reducir los diffs rechazados ahorra la parte más cara.
Cómo probar Neon frente a Carbon en tus propias tareas
No necesitas un benchmark nuevo. Necesitas dos semanas de tickets reales y una forma de saber qué modelo hizo qué. Sharkly te ofrece ese tablero: cada tarea guarda la ejecución del agente, su resultado y su estado de revisión en un solo lugar.
- Elige de 20 a 30 tareas ordinarias de tu backlog: correcciones de errores, refactorizaciones pequeñas, adiciones de tests.
- Crea dos Agents. Un Sharkly Agent sigue el modelo predeterminado de su Runtime y no tiene selector de modelos, según la documentación de Agents. Así que apunta cada Agent a un Runtime configurado con un modelo distinto: uno con
gemini-4-neony otro congemini-4-carbon. - Reparte las tareas entre los dos Agents con una dificultad similar en cada lado.
- Registra tres números por tarea: los tokens según el uso de tu API de Gemini, los intentos hasta la aceptación y los minutos de revisión.
- Calcula el coste por cambio aceptado de cada modelo, con ambos precios de Carbon si tu prueba cruza el 1 de diciembre.
Sharkly no vende tokens de modelos. Tus ejecuciones se facturan contra la clave de la API de Gemini ya configurada en el Runtime, de modo que la comparación sigue siendo honesta: nada en la plataforma inclina el precio hacia un modelo. Para una visión más amplia, consulta por qué una plataforma de agentes no debería venderte tokens y cómo seguir el gasto entre Claude Code, Codex y Gemini.
Dónde encaja cada uno: Neon, Carbon y Hydrogen
La ficha técnica de Google ubica a Carbon en «tus proyectos más difíciles y de largo alcance» y a Hydrogen en la «ejecución cotidiana rápida», con Neon entre ambos. En cuanto a coste, eso le da a un equipo de agentes tres carriles:
- Hydrogen a 1,50 $ / 7,50 $ para trabajo de alto volumen y bajo riesgo. Consulta Gemini 4 Hydrogen para agentes de código.
- Neon en
highcomo carril predeterminado para tickets complejos, y como líder que dirige subagentes Hydrogen en paralelo. - Carbon para el trabajo de largo alcance donde Neon falla en
xhigh. Nuestra reseña de Carbon cubre dónde justifica su precio.
La guía de emparejamiento de Carbon y Hydrogen muestra un tablero de planificador y trabajadores; desde el 1 de diciembre, Neon ocupa el puesto de planificador por menos. Para enrutar entre proveedores, consulta el enrutamiento de modelos para equipos de agentes.
Conclusión
Gemini 4 Neon es más barato que Carbon por tarea desde el 1 de diciembre, según cualquier lectura de los números de Google. Antes de esa fecha, depende de qué precio de Carbon estaba detrás del gráfico del 32 %, y Google no lo dijo. De todos modos, el precio oficial nunca fue el número decisivo: los tokens por tarea, el nivel de pensamiento y la tasa de aceptación son lo que cuenta.
Haz la prueba de dos semanas en tu propio backlog y precia ambos modelos por cambio aceptado. Si ya ejecutas varios agentes de código, Sharkly te ofrece un único tablero para asignar las tareas, comparar los resultados de los Agents y mantener la revisión en una sola cola. La documentación de Sharkly explica cómo conectar un Computer y crear Agents.
FAQ
¿Cuánto cuesta Gemini 4 Neon?
3 $ por 1M de tokens de entrada, 15 $ por 1M de tokens de salida incluido el pensamiento, y 0,15 $ por 1M de tokens de entrada en caché en el nivel de pago de la API de Gemini. Los lotes y Flex reducen eso a la mitad: 1,50 $ / 7,50 $. No hay nivel gratuito de API.
¿Es Gemini 4 Neon más barato que Gemini 4 Carbon?
Por token, no hasta el 30 de noviembre (3 $ / 15 $ frente a 2 $ / 10 $), y sí desde el 1 de diciembre (3 $ / 15 $ frente a 4 $ / 20 $). Por tarea, Google informa que Neon en high es un 32 % más barato que Carbon, sin publicar qué precio de Carbon usó.
¿Tiene Gemini 4 Neon un nivel gratuito?
No. La página de precios indica «No disponible» para el nivel gratuito de Neon en todos los niveles de servicio. Gemini 4 Hydrogen sí tiene uno.
¿Se facturan los tokens de pensamiento de Gemini 4 Neon?
Sí. Google factura los tokens de pensamiento a la tarifa de salida de 15 $ por 1M, junto con las declaraciones de funciones y las instrucciones del sistema de grounding. Reducir thinking_level es la principal forma de recortar tokens.
¿Qué nivel de pensamiento es el más barato para agentes de código?
low usa la menor cantidad de tokens y xhigh la mayor. Google recomienda probar los cuatro en tu conjunto de evaluación y elegir el nivel más bajo que cumpla tu umbral de calidad. Empieza en high para cambios de código complejos.
¿Cuándo sube el precio de Gemini 4 Carbon?
El 1 de diciembre de 2026. La entrada pasa de 2 $ a 4 $ por 1M de tokens y la salida de 10 $ a 20 $, según la página de precios de la API de Gemini.


