
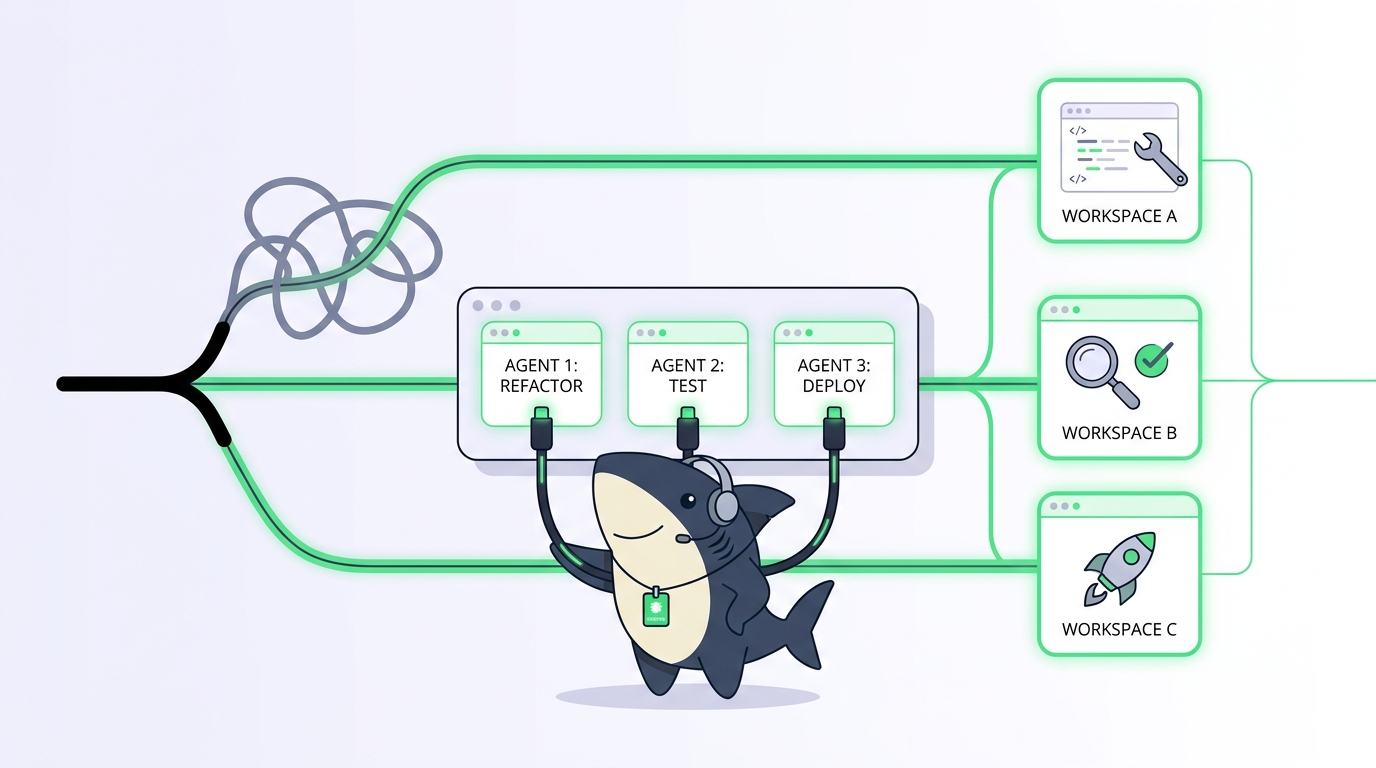
Si apuntas dos agentes de IA de programación al mismo checkout, tarde o temprano te arruinarán la tarde. Uno reescribe un archivo que el otro está editando en ese momento. Uno cambia la rama y deja al otro colgado. Ambos ejecutan npm install sobre el mismo node_modules y te dejan un lockfile que nadie escribió. El fallo es silencioso hasta que deja de serlo, y entonces te toca hacer bisect sobre un desastre que ninguno de los dos agentes sabe explicar.
Los worktrees de Git son la solución estándar. Un worktree le da a cada agente su propio directorio de trabajo y su propia rama activa sobre un único repositorio compartido, de modo que el trabajo en paralelo deja de colisionar. Esta guía repasa los comandos reales, los problemas que aparecen en la práctica y la disciplina de limpieza de la que nadie te habla. Después muestra dónde los scripts de worktrees hechos a mano dejan de escalar y cómo Sharkly ejecuta cada Task en su propio worktree automáticamente, para que los resultados vuelvan a un único registro compartido en lugar de dispersarse entre terminales.
Si solo ejecutas un agente, todavía no necesitas nada de esto. En el momento en que ejecutas dos, el aislamiento deja de ser opcional.
TL;DR
Un worktree de git es un segundo directorio de trabajo asociado al mismo repositorio, con su propia rama y su propio índice. Dale a cada agente de IA de programación su propio worktree y podrán editar, compilar y probar en paralelo sin sobrescribirse ni pelearse por la rama actual. Los comandos son sencillos; lo que crece es el coste operativo (instalaciones por worktree, limpieza, disco, coordinación). Sharkly gestiona ese coste preparando un worktree aislado para cada Task de forma automática y devolviendo cada resultado a la Task para su revisión.
Por qué un solo checkout no puede albergar dos agentes
Un checkout normal de git tiene exactamente un directorio de trabajo, un índice y un HEAD. Eso va bien para una persona haciendo una cosa. Se rompe en el instante en que dos agentes trabajan a la vez, porque esos tres elementos son estado compartido.
Imagina dos agentes sobre el mismo repositorio. El agente A está refactorizando el módulo de autenticación en una rama llamada auth-refactor. Al agente B se le pide arreglar un bug de logging y ejecuta git checkout -b fix-logging. Ese único comando mueve el HEAD de todo el checkout. Los cambios sin confirmar del agente A ahora están encima de la rama equivocada, su siguiente commit aterriza en el sitio incorrecto y su build empieza a fallar por motivos que se pasará veinte minutos «depurando». No se bloqueó nada. El estado simplemente se fue al garete sin hacer ruido.
Con los archivos es aún peor. Ambos agentes comparten un único directorio de trabajo, así que cuando el agente B regenera un archivo de configuración o vuelve a pasar el formateador, las ediciones abiertas del agente A quedan machacadas en disco. Los agentes de programación no mantienen un modelo mental de «el otro está en medio de algo». Leen el archivo, actúan y lo vuelven a escribir. Dos escritores, un archivo, ningún bloqueo. Tienes el clásico problema de actualización perdida, solo que ahora los escritores son autónomos y rápidos.
Este es el dolor por el que la palabra clave «git worktrees» no deja de aparecer. La gente no busca worktrees porque las ramas sean interesantes. Busca porque intentó ejecutar agentes en paralelo y se quemó. Si es tu caso, el lado de la ejecución en paralelo está cubierto a fondo en nuestra guía sobre ejecutar varios agentes de Claude Code en paralelo; este artículo trata la primitiva de aislamiento que hay debajo.
Qué es realmente un worktree de git
Esta es la versión de manual, la que merece la pena memorizar:
Un worktree de git es un directorio de trabajo adicional vinculado al mismo repositorio, con su propia rama activa, índice y HEAD, y que comparte una única base de datos de objetos.
Esa última parte es todo el truco. Un worktree no es un clon. Los clones duplican todo el almacén de objetos: cada commit, cada blob, cada etiqueta copiada a un segundo .git. Los worktrees comparten un único almacén de objetos y solo añaden un segundo directorio de trabajo ligero. Tus commits son visibles desde todos los worktrees en el momento en que se confirman, porque debajo solo hay una única historia. Lo que difiere en cada worktree es el checkout: qué rama está activa, qué está en el área de preparación y qué está modificado en disco.
Para los agentes, eso encaja limpiamente con el problema. Cada agente recibe un worktree. Cada worktree tiene su propia rama y sus propios archivos. No pueden sobrescribirse entre sí porque literalmente están en directorios distintos, y no pueden arrancarse la rama el uno al otro porque cada worktree fija su propio HEAD. Los conflictos se trasladan a donde corresponde: al momento del merge, a propósito, bajo revisión, en lugar de a mitad de una edición por accidente.
Los comandos de worktree que realmente vas a usar
Empieza en un repositorio normal. Todos los comandos de abajo se ejecutan desde dentro de él.
Crear un worktree con una rama nueva. Este es el que más usarás:
git worktree add -b fix-logging ../myproject-fix-logging main
Eso crea un directorio en ../myproject-fix-logging, crea una rama nueva fix-logging a partir de main y la activa ahí. Apunta un agente a ese directorio y tendrá un lugar de trabajo limpio y aislado.
Crear un worktree para una rama existente:
git worktree add ../myproject-auth auth-refactor
Listar lo que tienes abierto:
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
Una línea por worktree, con su ruta, el commit activo y la rama. Cuando tienes toda una flota de agentes en marcha, esta lista es tu fuente de verdad sobre quién está dónde.
Eliminar un worktree cuando el trabajo se ha fusionado o se ha abandonado:
git worktree remove ../myproject-fix-logging
Purgar metadatos obsoletos después de borrar manualmente un directorio de worktree (los agentes y los scripts hacen esto más de lo que te gustaría):
git worktree prune
Esa es toda la superficie. Cinco comandos. La dificultad no está en los comandos.
Los problemas que de verdad te muerden
Los comandos son sencillos. La realidad operativa es donde se van las tardes. Estos son los modos de fallo que aparecen cuando hay agentes reales trabajando en worktrees reales.
Los archivos sin seguimiento y los ignorados por git no vienen incluidos. Un worktree hace checkout de los archivos rastreados en la rama que le pidas. No copia tu node_modules, tu .env, tu venv, tu caché de build ni nada más que git ignore. Así que un worktree recién creado para un proyecto Node no es ejecutable hasta que lanzas la instalación dentro de él. Cada worktree paga su propia instalación de dependencias, su propio archivo de entorno y su propia compilación. Los agentes que dan por hecho que «el repositorio ya está configurado» fallarán su primer comando en un worktree nuevo hasta que gestiones la configuración de forma explícita.
No puedes activar la misma rama dos veces. Git se niega a tener una rama activa en dos worktrees a la vez, y hace bien. Si dos agentes necesitan la rama main activa, uno de ellos tendrá que crear una rama nueva. Esto es una característica, no una limitación, pero sorprende a quien esperaba que los worktrees fueran copias libres.
El disco crece rápido. El almacén de objetos es compartido, así que la historia sale barata. Los directorios de trabajo y sus instalaciones no. Diez worktrees de un proyecto con un node_modules de 900 MB son 9 GB de dependencias duplicadas. En un portátil con unos cuantos agentes, lo notas a la hora de comer.
Los worktrees con cambios sin confirmar se resisten a ser eliminados. git worktree remove se niega si el worktree tiene cambios sin confirmar, lo que te protege de tirar el trabajo que un agente no terminó. Cuando de verdad quieras deshacerte de él, git worktree remove --force. Pero ahora la decisión de si ese trabajo sin confirmar importaba es tuya, para cada worktree, y a mano.
Los directorios borrados dejan fantasmas. Borra una carpeta de worktree con rm -rf y git seguirá listándola hasta que ejecutes git worktree prune. Los scripts que crean worktrees más rápido de lo que los limpian acumulan entradas obsoletas, y esas entradas mantienen bloqueos que impiden reutilizar nombres de rama. La limpieza no es opcional; simplemente es fácil olvidarla hasta que git worktree list parece un cementerio.
Las cachés anidadas de los agentes no son tuyas para borrarlas. Algunos runtimes mantienen sus propias cachés de worktrees, por ejemplo en ~/.claude/worktrees. No apuntes tus propios scripts de limpieza ahí. Deja que la herramienta que es dueña de una caché la gestione.
Ninguno de estos problemas es difícil por separado. El problema es que se acumulan. Dos worktrees los gestionas a mano. Con cinco, escribes un script. Con doce agentes corriendo en dos repositorios, el script ya es un pequeño trozo de infraestructura con sus propios bugs, y tú eres el de guardia.
Dónde los scripts dejan de escalar
El recorrido honesto es así. Empiezas con una función de shell que envuelve git worktree add, mete un agente en el directorio nuevo y ejecuta la configuración. Funciona. Añades un esquema de nombres para que los directorios no colisionen. Añades un comando de limpieza. Y entonces empiezan a acumularse los requisitos.
Quieres saber qué agente está en qué worktree ahora mismo y en qué estado está su rama. Tu git worktree list no sabe de agentes; sabe de directorios. Le añades un archivo de mapeo. Quieres que las instalaciones de dependencias por worktree no te disparen el disco, así que añades lógica de caché. Quieres que la salida de un agente, su diff y sus resultados de tests lleguen a algún sitio donde una persona pueda revisarlos en lugar de quedarse atrapados en una terminal que se cierra. Ahora estás escribiendo un recolector de resultados. Quieres que dos agentes no cojan la misma tarea de la cola. Ahora estás escribiendo un bloqueo.
En algún momento has reimplementado una capa de orquestación con scripts de shell, y mantenerla no es el trabajo de nadie. Esta es exactamente la costura sobre la que vive la conversación sobre alternativas a vibe kanban, y es la razón por la que los equipos recurren a una capa de gestión de verdad cuando el número de agentes cruza un umbral. El worktree nunca fue la parte difícil. Lo difícil es coordinar muchas ejecuciones aisladas y hacer que sus resultados vuelvan a un único sitio.
Cómo Sharkly ejecuta cada Task en su propio worktree
Sharkly es una plataforma todo en uno de comando y gestión de Agentes. No sustituye a Claude Code, Codex ni a las demás herramientas de ejecución que ya usan tus agentes; añade la capa compartida de Task, Computer, contexto y revisión a su alrededor. El aislamiento por worktree está integrado en esa capa, así que dejas de hacerlo a mano.
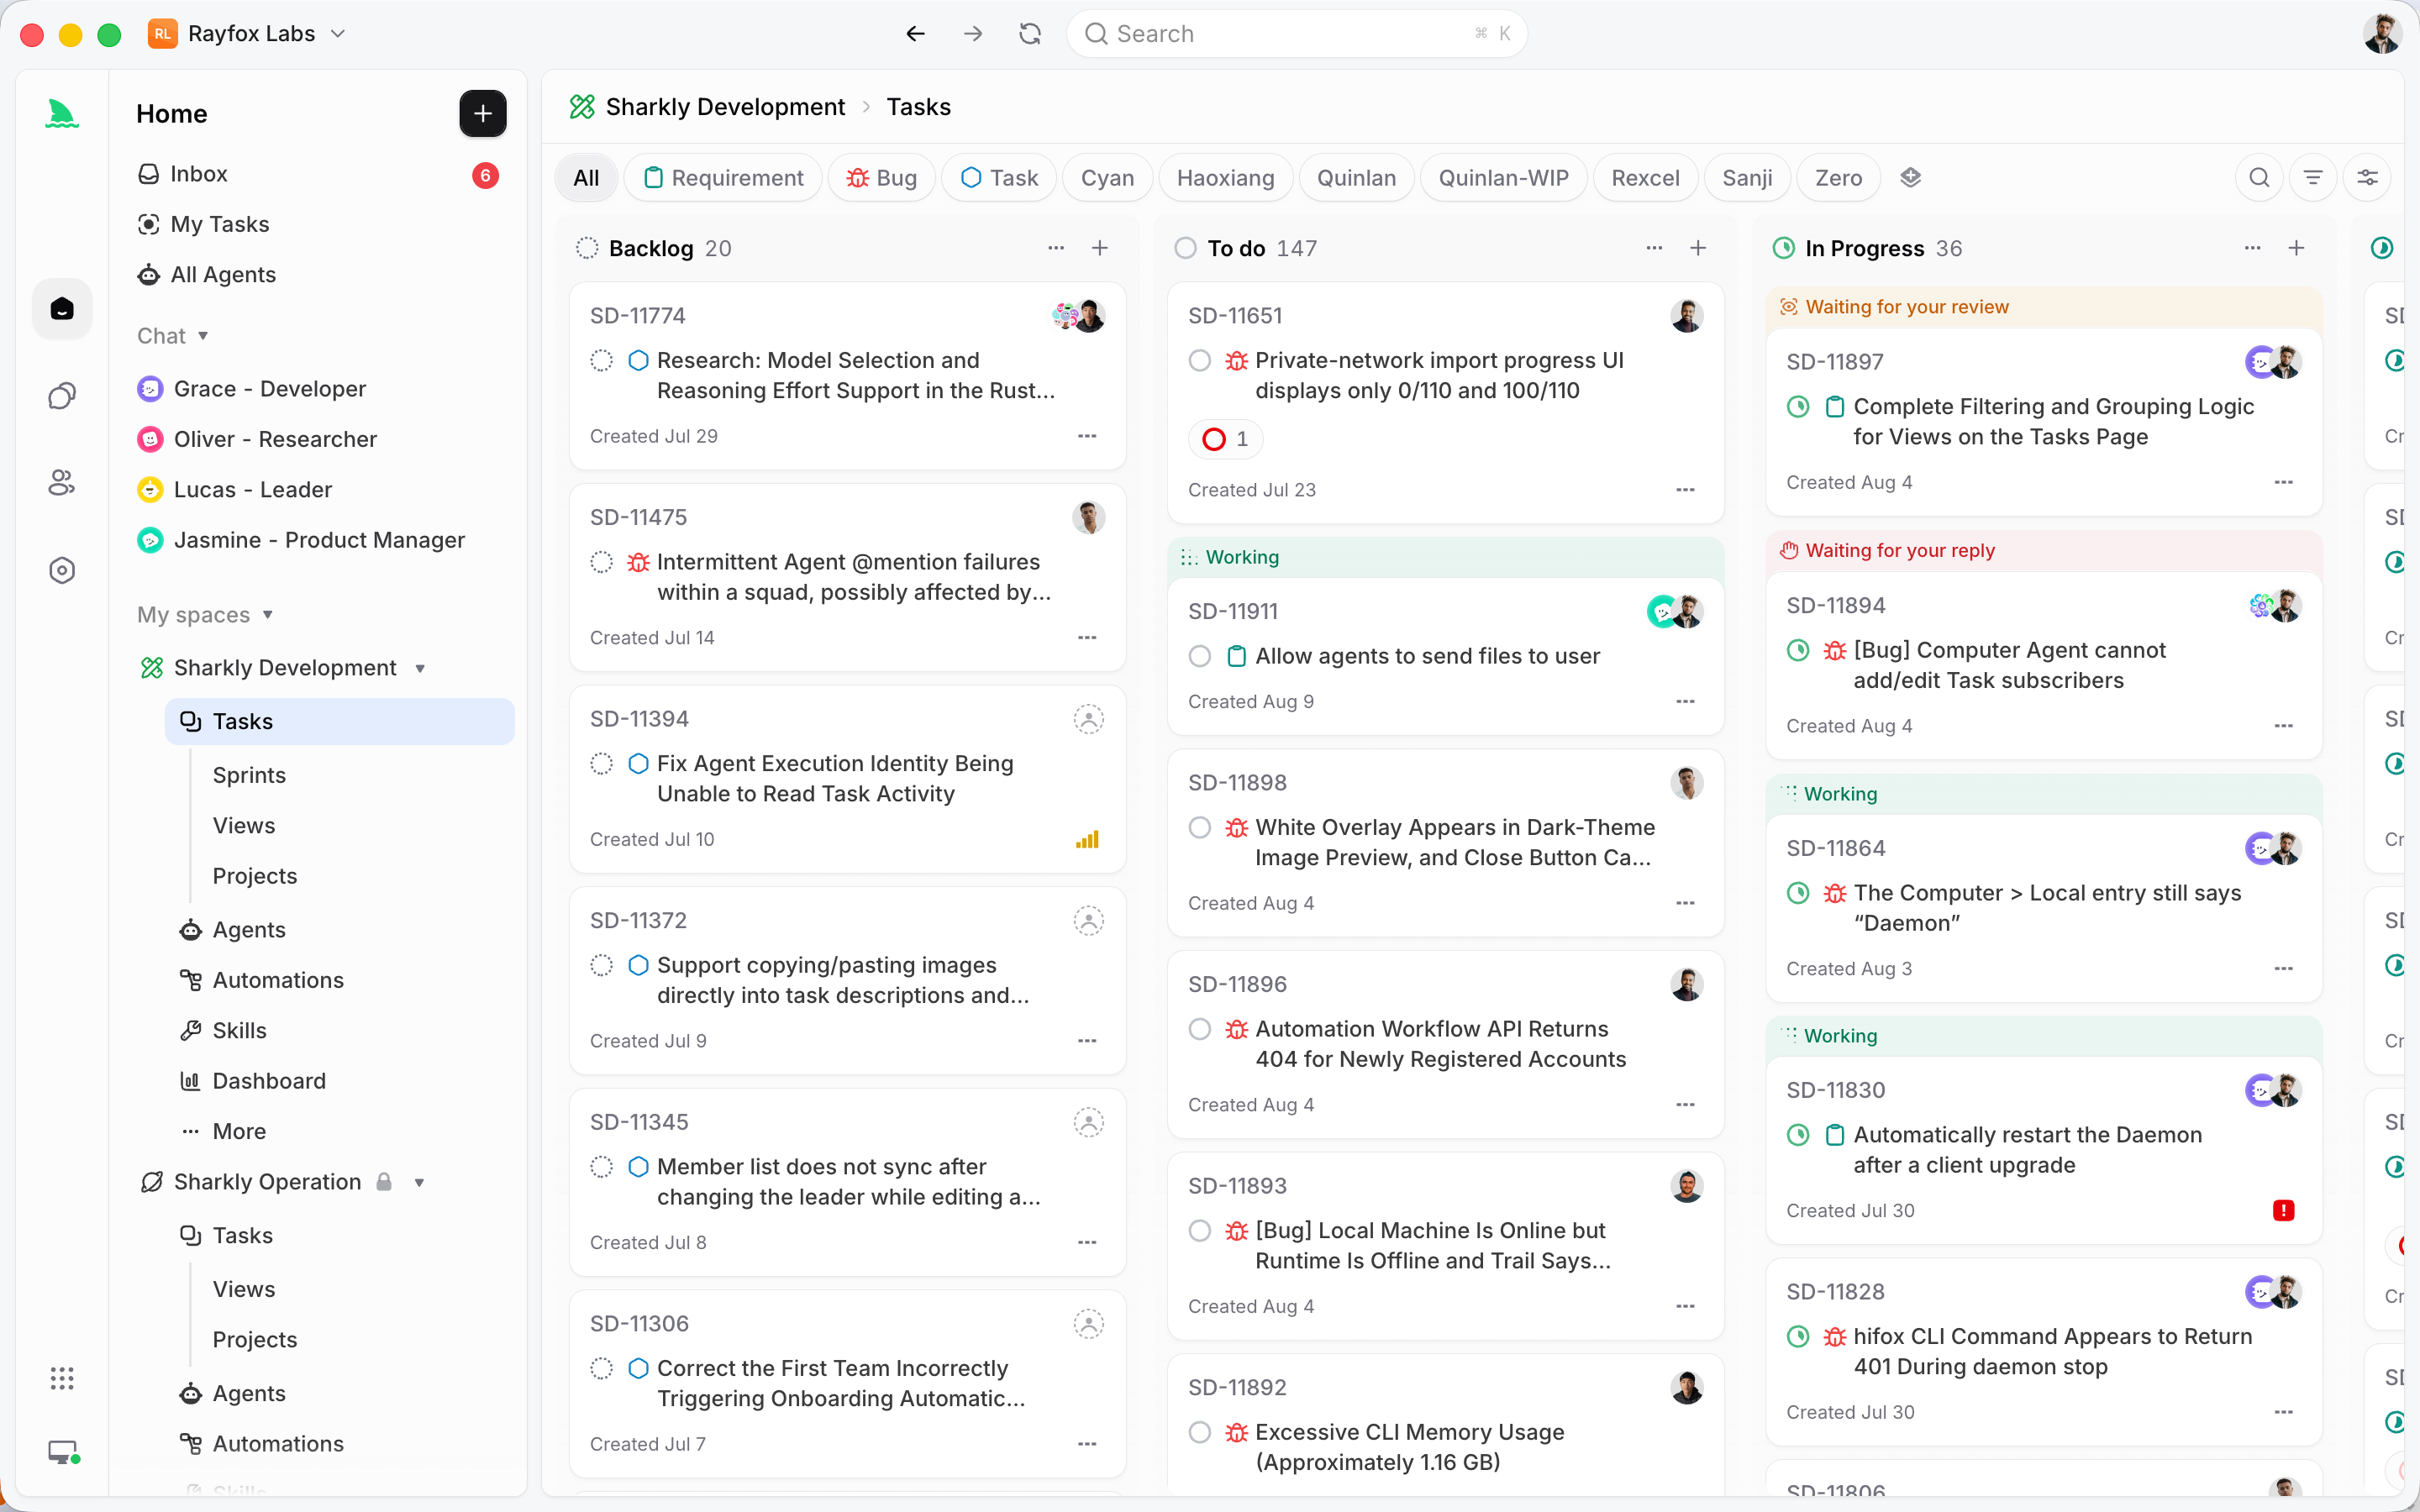
El mecanismo es directo. Cada Task recibe un directorio aislado. Para el trabajo respaldado por repositorio, Sharkly prepara un worktree nuevo por ejecución a partir de sus datos de repositorio en caché, de modo que varias Tasks pueden trabajar sobre la misma fuente sin escribir nunca en un checkout compartido. No ejecutas git worktree add. No escribes un esquema de nombres, un trabajo de limpieza ni un archivo de mapeo. Asignas una Task y el aislamiento ya está ahí.
Esta es la separación de responsabilidades que hace que todo funcione con calma. El Agente define cómo debe gestionarse el trabajo. El Computer aporta el host y los recursos locales. El Runtime realiza la sesión real del agente. La Task se mantiene como el registro compartido del equipo. Como cada ejecución está en su propio worktree, frontend, backend, un arreglo de bug y cobertura de tests nueva pueden avanzar al mismo tiempo sin pisarse, exactamente el paralelismo que buscaba el enfoque manual.
Y los resultados tienen a dónde ir. La ejecución, los bloqueos, los resultados y la discusión de seguimiento vuelven todos a la línea de tiempo de la Task. En lugar de que el diff de un agente viva en una terminal que tienes que acordarte de revisar, el resumen de cambios, la salida de verificación y los límites conocidos vuelven a la Task, donde una persona los acepta, pide cambios o decide el merge. El contexto, el progreso, los bloqueos, los resultados y la revisión humana se mantienen visibles desde la petición hasta la entrega, en un único lugar compartido en vez de repartidos entre prompts privados y sesiones de terminal. Si eres nuevo en este modelo, asignar tu primera Task a un agente de IA de programación es la vía más corta para entrar.
Conservas las herramientas que ya usas. El uso de modelos sigue funcionando a través de las suscripciones o claves de API configuradas en esas herramientas; Sharkly añade el aislamiento, la coordinación y la revisión a su alrededor.
Worktrees manuales frente a una capa de gestión
Ambos enfoques usan la misma primitiva. La diferencia es quién carga con el peso operativo.
| Preocupación | Worktrees de git manuales | Worktrees gestionados por Sharkly |
|---|---|---|
| Aislamiento por agente | Ejecutas git worktree add en cada ejecución |
Cada Task recibe un worktree nuevo automáticamente |
| Configuración por worktree | Scripts de instalación y archivos de entorno a tu cargo | Gestionada como parte de la preparación de la Task |
| Limpieza y purga | Tu responsabilidad, fácil de olvidar | Gestionada; la limpieza segura nunca toca cachés protegidas |
| Qué agente está dónde | Un archivo de mapeo que mantienes tú | Visible en la Task, sin archivo auxiliar |
| Resultados y diffs | Atrapados en cada terminal | Vuelven a la Task para su revisión |
| Reclamo de tareas / bloqueos | Escribes el bloqueo | Las Tasks se reclaman desde un plan compartido |
| Coordinación de disco | Manual | Gestionada entre los Computers conectados |
Usa worktrees manuales cuando seas un único desarrollador ejecutando uno o dos agentes y quieras control total de la shell. Esa configuración es perfectamente válida y merece la pena aprenderla, porque la mecánica te enseña qué está haciendo cualquier capa que pongas encima. Usa una capa de gestión cuando aumente el número, cuando más de una persona necesite ver el trabajo o cuando perder los resultados de un agente en una terminal cerrada te haya costado algo de verdad. Esto refleja la regla de decisión honesta de nuestra guía de orquestación de agentes de IA: no añadas maquinaria de coordinación hasta que el trabajo en paralelo sea real, y no sigas haciéndolo a mano una vez que lo sea.
El contrato humano-agente sigue vigente
El aislamiento cambia dónde ocurre el trabajo, no quién decide. Los worktrees permiten que los agentes investiguen, ejecuten, prueben y reporten en paralelo sin colisiones. Las personas siguen marcando la dirección, otorgando autoridad y aceptando el resultado. La automatización se detiene donde se requiere el criterio del equipo. Un worktree nuevo por agente es lo que hace exigible ese límite: el trabajo de cada agente llega como un cambio distinto y revisable en su propia rama, no como una edición imposible de rastrear mezclada en un checkout compartido. Revisas ramas, no caos. Para una visión más amplia de lo que este cambio supone en el día a día, nuestro explicativo sobre programación agéntica pone el contexto, y Qué es Sharkly cubre la plataforma de principio a fin.
Algunos enfoques probados para worktrees manuales
Si de momento te quedas en manual, estos hábitos evitan la mayor parte del dolor:
- Nombra los directorios de worktree según la rama o la tarea, no de forma secuencial.
myproject-auth-refactorte dice qué es;myproject-wt3no. - Mantén los worktrees como hermanos del checkout principal, no anidados dentro de él. Anidarlos confunde a las herramientas que recorren el árbol e infla tus reglas de ignore.
- Automatiza la configuración por worktree como un único script que el agente ejecute primero, para que un worktree nuevo sea ejecutable en un solo paso en lugar de fallar por una instalación ausente.
- Purga según un calendario, no según el capricho. Un
git worktree prunediario más una revisión degit worktree listmantienen a raya las entradas fantasma. - Nunca borres desde tus propios scripts una caché de runtime anidada como
~/.claude/worktrees. Deja que el runtime sea su dueño. - Haz commit o stash antes de eliminar.
--forceestá ahí para cuando estés seguro, no como opción por defecto.
Conclusión
Los worktrees de git son la primitiva de aislamiento que hace seguros a los agentes de IA de programación en paralelo. Las ideas clave merecen la pena recordarlas:
- Un checkout tiene una rama, un índice y un
HEAD, y no puede albergar dos agentes a la vez. - Un worktree añade un segundo directorio de trabajo sobre la misma historia compartida, de modo que cada agente tiene su propia rama y sus propios archivos.
- Los cinco comandos (
add,list,remove,pruney--forcecuando lo dices en serio) son sencillos. - El coste operativo (instalaciones por worktree, disco, limpieza, coordinación, recolección de resultados) es lo que crece.
- Los worktrees manuales son lo adecuado para uno o dos agentes; una capa de gestión se gana su sitio a medida que crecen el número y lo que está en juego.
- Sharkly prepara un worktree nuevo para cada Task automáticamente y devuelve cada resultado a la Task para la revisión humana.
Aprende primero los comandos manuales; te enseñan qué está haciendo cualquier capa que pongas encima. Cuando la contabilidad empiece a costar más que el trabajo, Sharkly te quita de encima el worktree, la coordinación y la revisión. Conecta un Computer, crea un Agente y asígnale algo aburrido.
FAQ
¿Qué es un worktree de git en términos sencillos? Es un segundo directorio de trabajo asociado al mismo repositorio, con su propia rama activa y sus propios cambios preparados y sin preparar. Comparte una única historia de commits con el checkout principal, así que es mucho más ligero que un clon. Para los agentes de IA, significa que cada agente tiene un lugar privado donde trabajar sin tocar los archivos de nadie más.
¿Por qué necesitan worktrees los agentes de IA de programación? Porque dos agentes que comparten un checkout acabarán sobrescribiendo los archivos del otro y cambiando la rama del otro. Un worktree por agente traslada los conflictos al momento del merge, donde son visibles y revisables, en lugar de a mitad de una edición, donde corrompen el estado en silencio. Consulta nuestra guía para ejecutar varios agentes de Claude Code en paralelo para ver la configuración paralela completa.
¿Es un worktree lo mismo que un clon? No. Un clon copia toda la base de datos de objetos a un repositorio aparte. Un worktree comparte una única base de datos de objetos y solo añade un directorio de trabajo nuevo y un checkout de rama. Los commits hechos en cualquier worktree son visibles al instante desde todos ellos, y el uso de disco es mucho menor.
¿Pueden dos worktrees activar la misma rama? No. Git se niega a activar una rama en dos worktrees a la vez, para protegerte de escrituras conflictivas sobre la misma rama. Si dos agentes necesitan esa rama como base, uno tendrá que crear una rama nueva a partir de ella.
¿Cómo limpio worktrees de forma segura? Haz commit o stash de cualquier trabajo primero y luego ejecuta git worktree remove <path>. Si borraste un directorio de worktree a mano, ejecuta git worktree prune para limpiar los metadatos obsoletos. Nunca apuntes scripts de limpieza a la caché propia de un runtime, como ~/.claude/worktrees.
¿Cuándo debería dejar de gestionar worktrees a mano? Cuando estés coordinando más de un par de agentes, cuando más de una persona necesite ver el trabajo o cuando un resultado perdido en una terminal cerrada te haya costado tiempo. En ese punto, una capa de gestión que aísle y haga seguimiento de cada ejecución se paga sola. Nuestra guía de orquestación de agentes de IA cubre cuándo dar ese salto.


