
En resumen: Para darle voz a tu agente de IA, coloca GPT-Live-1.1 de OpenAI delante de él como interfaz de voz y deja el trabajo real en los agentes que ya tienes en funcionamiento. GPT-Live escucha mientras habla y traslada el razonamiento y las llamadas a herramientas a un backend mediante delegación. En modo de delegación de cliente, tu aplicación captura cada traspaso, inicia una Automatización de Sharkly a través de su webhook y comunica el resultado de vuelta por voz.
¿Qué es GPT-Live-1.1?
GPT-Live-1.1 es el modelo de voz dúplex completo de OpenAI para conversaciones multilingües: puede escuchar mientras habla, así que las personas pueden interrumpirlo como interrumpirían a un colega. Funciona sobre el endpoint v1/live/sessions, admite function calling y streaming, y puede delegar el razonamiento y el uso de herramientas en un agente backend en lugar de hacer ese trabajo por sí mismo.
Según la página del modelo GPT-Live-1.1 de OpenAI, transcribe el habla con más precisión que GPT-Live-1 y mantiene un acento y una voz más consistentes entre idiomas. La entrada y la salida son audio y texto. No acepta imágenes directamente.
La parte que importa a los equipos de agentes es la delegación. El modelo de voz está hecho para conversar, no para ejecutar una refactorización de 20 minutos. Ese trabajo lo entrega a otra cosa y mantiene la conversación activa mientras espera.
Si tu equipo ya asigna trabajo a agentes de código en un tablero compartido, Sharkly puede ser esa "otra cosa". El resto de esta guía muestra cómo conectarlo.
Por qué un agente de voz necesita un equipo backend
Una interfaz de voz tiene un presupuesto de latencia muy ajustado. Las personas esperan una respuesta en aproximadamente un segundo, y un silencio más largo da la impresión de que algo falló. El trabajo real de un agente no cabe en esa ventana: leer un repositorio, ejecutar tests o priorizar una cola de tareas lleva minutos.
Así que un agente de voz que intenta hacerlo todo por sí mismo falla de una de dos maneras. O responde rápido y superficial, o se queda callado mientras piensa. Ninguna opción es útil cuando vas caminando a una reunión y quieres saber si las ejecuciones de los agentes de anoche pasaron.
La solución es una división que quizá ya uses con texto: un frontend rápido que gestiona la conversación y un backend más lento que hace el trabajo. GPT-Live incorpora esa división en la API. Si leíste nuestro artículo sobre traspasos entre agentes y de agente a humano, se trata del mismo patrón con un micrófono añadido.
Cómo funciona la delegación de GPT-Live
GPT-Live tiene dos modos de delegación, que se eligen al crear la sesión. Para cambiar de modo, debes iniciar una nueva sesión.
| Delegación Responses | Delegación de cliente | |
|---|---|---|
| Quién ejecuta el backend | OpenAI, mediante la Responses API | Tu aplicación |
| Configuración | delegation.type: "responses" más model, instructions, tools |
delegation.type: "client" |
| Modelo backend | Uno que tú configuras, por ejemplo gpt-6-luna |
Cualquiera que puedas llamar |
| Cómo regresan los resultados | Lo gestiona OpenAI por ti | session.commentary.append o session.thinking.append |
| Ideal para | Consultas y llamadas a herramientas que OpenAI puede ejecutar | Trabajo que vive en tus propios sistemas |
La delegación Responses es el camino corto. Nombras un modelo backend y OpenAI lo ejecuta con las herramientas que indiques. La guía de delegación sugiere empezar con gpt-6-luna y probar gpt-6-sol para tareas backend más complejas.
La delegación de cliente es el camino para los agentes que ya tienes en marcha. Cuando el modelo de voz decide que necesita ayuda, tu aplicación recibe un evento session.delegation.created con un ID de delegación. Ese evento no incluye las palabras del usuario, así que tu aplicación reconstruye la petición a partir de los eventos de transcripción y su propio estado. Cuando el trabajo termina, envías el resultado de vuelta con el mismo ID de delegación y GPT-Live lo parafrasea en voz alta.
El patrón: GPT-Live habla, tu equipo de agentes trabaja
Esta es la estructura de una interfaz de voz sobre Sharkly. Sharkly se sitúa por encima de tus agentes de código (Claude Code, Codex, Gemini CLI y otros) como la capa donde se asigna el trabajo, se ejecuta en Computers conectados y se revisa. El modelo de voz nunca toca un repositorio. Pide trabajo, y el tablero lo registra.
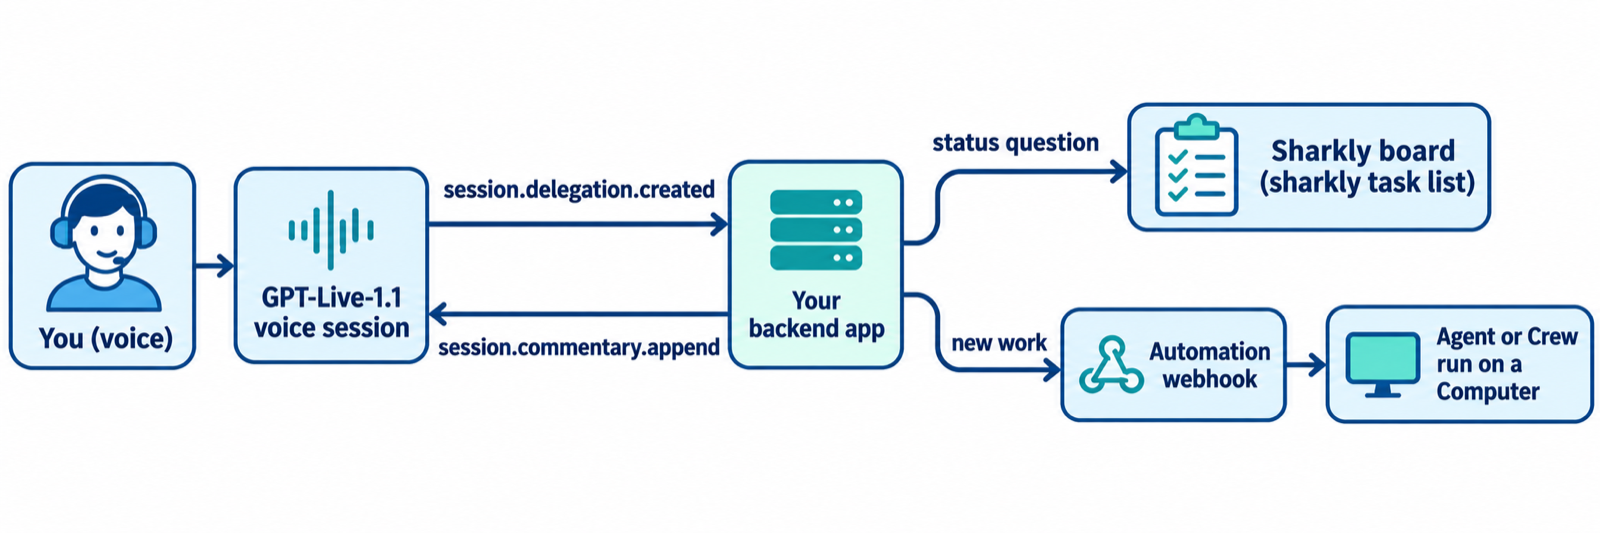
Tres tipos de peticiones cubren la mayoría de lo que la gente pregunta a un agente de voz sobre su equipo de agentes:
- Preguntas de estado ("¿Pasó la ejecución nocturna de tests?"). Tu backend consulta el tablero con la CLI de
sharklyy responde en segundos. - Trabajo nuevo ("Que un agente revise el test de login inestable"). Tu backend llama al webhook de una Automatización de Sharkly y un Agent o Crew inicia una ejecución.
- Decisiones ("Fusiona los cambios"). Tu backend se niega e indica a la persona dónde revisar. La voz es un mal lugar para aprobar cambios.
Esa tercera regla es una decisión de diseño, no una limitación de ninguno de los dos productos. Un "sí" hablado es fácil de confundir y difícil de auditar. Mantén las aprobaciones donde están las evidencias, algo que nuestra guía sobre agentes de código con supervisión humana cubre a fondo.
Dale voz a tu agente de IA: configuración paso a paso
Paso 1: Crea la Automatización y su activador de webhook
En Sharkly, una Automatización es una definición propiedad de un Space para trabajo repetible de un Agent o Crew: instrucciones, un responsable, activadores e historial de ejecuciones. Un activador de webhook crea una URL secreta que acepta peticiones POST de un servicio externo. La documentación de Automations señala que la URL completa se muestra una sola vez, al crear o regenerar el activador, así que guárdala como secreto de inmediato.
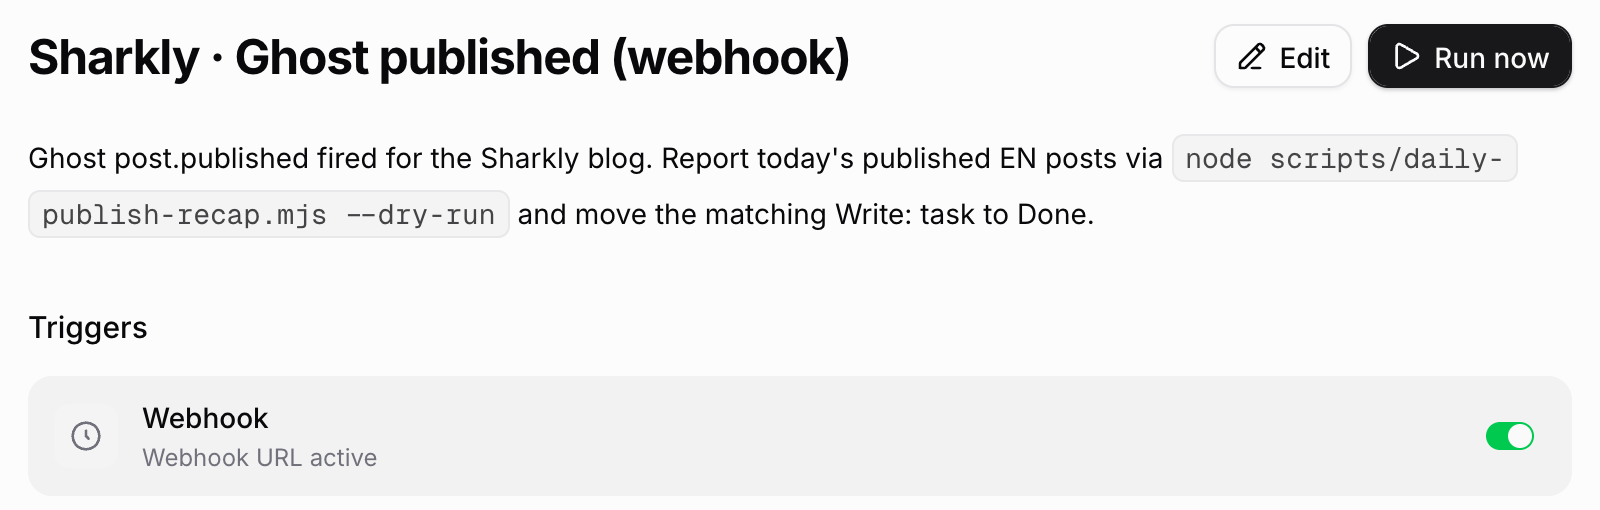
Escribe las instrucciones de forma que el Agent lea la petición del payload del activador y registre su resultado como comentario en la tarea. Especifica qué puede cambiar y cuándo debe decidir una persona. Después usa Run now para probar el Agent y su Computer antes de conectar cualquier tráfico de voz. Nuestra guía sobre las Automations en Sharkly muestra más tipos de activadores.
Paso 2: Crea una sesión GPT-Live en modo cliente
La configuración de tu sesión define el modelo de voz y activa la delegación de cliente. El ajuste acknowledgement_delay_ms da tiempo a tu aplicación para enviar su propia actualización antes de que GPT-Live pronuncie un acuse de recibo genérico.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
OpenAI recomienda WebRTC para audio en apps de navegador, móviles y servidores, con WebSockets como alternativa admitida. La guía de inicio de GPT-Live cubre la configuración de la conexión.
Paso 3: Enruta cada delegación hacia Sharkly
Cuando llega session.delegation.created, guarda el ID de delegación, reconstruye la petición a partir de la transcripción y decide qué camino toma. Este esquema en Node envía el trabajo nuevo al webhook de la Automatización y responde las preguntas de estado consultando el tablero.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Fíjate en lo que promete la respuesta de voz. Dice que una ejecución se ha iniciado, no que el trabajo está terminado. La guía de OpenAI hace la misma advertencia sobre las reservas: envía el resultado solo después de que la acción haya tenido éxito.
Paso 4: Consulta los resultados en el tablero, no de oído
Las ejecuciones de agentes llevan minutos, y una sesión de voz puede terminar antes que el trabajo. Por eso el tablero es el registro. El Agent publica su resultado en la tarea, el historial de ejecuciones muestra el payload del activador y la salida, y una persona lo revisa allí. La próxima vez que preguntes "¿qué pasó con el test inestable?", el camino de estado te leerá ese resultado.
Costes y límites que conviene tener en cuenta
| Concepto | GPT-Live-1.1 (docs de OpenAI, 2026-11-20) |
|---|---|
| Endpoint | v1/live/sessions |
| Sesión activa | 0,05 $ por minuto |
| En espera | 0,02 $ por minuto (sesiones WebRTC mientras la inferencia está pausada) |
| Facturación | Por duración; la página de precios de OpenAI indica que GPT-Live se factura por segundo |
| Sesiones concurrentes | Límites independientes de los de GPT-Live-1; consulta la página de límites de tu organización |
| Llamadas backend | Facturadas a las tarifas normales del modelo configurado |
Una revisión de estado de 10 minutos cuesta 0,50 $ en tiempo de voz a la tarifa activa, antes de cualquier llamada backend. Como referencia, la página del modelo GPT-Live-1 indica 50, 300 y 500 sesiones concurrentes en los niveles Build, Launch y Grow, y sin acceso en el nivel Free. GPT-Live-1.1 tiene sus propios límites.
Las ejecuciones de agentes del lado de Sharkly se facturan contra el plan de Claude Code, Codex o API ya vinculado a cada Runtime. Sharkly no vende tokens. Si enrutas las preguntas de estado hacia un modelo backend barato, nuestras notas sobre ejecutar agentes GPT-6 Luna en Sharkly se aplican directamente.
Salvaguardas que conviene añadir desde el primer día
- Las interrupciones no cancelan el trabajo. La guía de OpenAI indica que interrumpir la conversación hablada no detiene el trabajo backend. Si alguien dice "olvídalo", tu backend tiene que gestionarlo, o la ejecución continúa.
- Trata la URL del webhook como una contraseña. La documentación de Sharkly la describe como un secreto de tipo bearer por defecto. Añade un secreto de firma y regenera la URL si se filtra.
- Limita el alcance de la Automatización. Empieza con trabajo observable y reversible, como aconseja la documentación de Sharkly, y revisa varias ejecuciones antes de ampliarla.
- Mantén la delegación a Crews dentro de Sharkly. Si una petición necesita varios agentes, apunta el webhook a un Sharkly Crew y deja que su líder divida el trabajo.
Cuándo una interfaz de voz no es la herramienta adecuada
Renuénciala cuando la petición necesite un diff, un log o una captura de pantalla para cobrar sentido. La voz no puede mostrarte un test que falla. Tampoco es el canal adecuado para nada que requiera una firma: las aprobaciones, los despliegues y los cambios de acceso pertenecen a la tarea donde están las evidencias.
La voz gana su sitio para comprobaciones de estado rápidas, para lanzar ejecuciones bien definidas y para momentos en los que tienes las manos ocupadas. Piensa en ella como un mando a distancia para tu tablero de agentes, no como un sustituto del tablero.
Conclusión
GPT-Live-1.1 se encarga de la parte de un agente de voz que es difícil de construir por tu cuenta: la conversación dúplex completa con interrupciones. La delegación entrega todo lo demás a un backend. Pon tu equipo de agentes existente detrás de ese backend, y podrás preguntar por las ejecuciones e iniciar otras nuevas hablando en voz alta, mientras cada resultado sigue quedando en un tablero que una persona revisa.
Tu siguiente paso: crea una Automatización con un activador de webhook en Sharkly, pruébala con Run now y luego apunta una sesión GPT-Live en modo cliente hacia ella. La documentación de Sharkly cubre Agents, Computers y Automations en detalle.
FAQ
¿Cómo le doy voz a mi agente de IA?
Coloca un modelo de voz como GPT-Live-1.1 delante del agente y deja que delegue. El modelo de voz se encarga de escuchar y hablar, y tu backend ejecuta el agente y devuelve un resultado breve para que el modelo de voz lo pronuncie.
¿Está GPT-Live-1.1 disponible en la API?
Sí. OpenAI ofrece gpt-live-1.1 con el endpoint v1/live/sessions, function calling y streaming. No admite v1/realtime ni v1/responses directamente.
¿Cuánto cuesta GPT-Live-1.1?
OpenAI indica 0,05 $ por minuto para sesiones activas y 0,02 $ por minuto en espera. Las llamadas al modelo backend hechas mediante delegación se facturan por separado a sus tarifas normales.
¿Cuál es la diferencia entre la delegación Responses y la delegación de cliente?
En la delegación Responses, OpenAI ejecuta un modelo backend que tú configuras. En la delegación de cliente, tu aplicación recibe cada petición y devuelve los resultados con session.commentary.append o session.thinking.append.
¿Puede GPT-Live-1.1 ejecutar agentes de código directamente?
No. Delega. Tu backend decide qué se ejecuta, por ejemplo llamando al webhook de una Automatización de Sharkly que inicia una ejecución de un Agent o Crew en un Computer conectado.
¿Qué pasa si interrumpo al agente de voz a mitad de una tarea?
La conversación se detiene, pero el trabajo backend no. Gestiona la cancelación en tu backend, por ejemplo pausando la ejecución o comentando la tarea.


