
Cuatro agentes de programación terminan en la misma hora y abren cuatro pull requests. Uno toca una ruta de reintento de facturación, otro renombra un helper de pruebas, otro añade una migración y otro corrige una errata del README. El cuello de botella no es el código ni las pruebas. Es la pregunta que una persona responde antes de leer un solo diff: ¿cuál de estos miro primero? Ya hemos argumentado que la revisión humana es el cuello de botella cuando los agentes se ejecutan en paralelo. Este artículo aborda la parte mecánica de ese problema, ordenar la cola, y cómo un modelo de decisión como Jev puede quitárselo de encima al revisor sin quitarle la revisión.
Qué es Jev
Jev es un System One Model de TypeSafe AI: le envías un fragmento de estado y un conjunto de preguntas tipadas, y devuelve una respuesta para cada pregunta con una probabilidad calibrada, nunca texto libre. Para que quede claro con el nombre: este es Jev, el modelo de TypeSafe, no el youtuber ni la vacuna contra la encefalitis japonesa. El artículo de lanzamiento de TypeSafe lo describe como «estado no estructurado de entrada, decisiones probabilísticas tipadas de salida». La API es un único endpoint, POST https://api.typesafe.ai/v1/systemone, clave Bearer, modelo jev-latest, tres tipos de pregunta: noul (probabilidad de sí/no), choice (una elección entre hasta 255 opciones) y score (una posición en una rúbrica de 2 a 10 niveles). Solo texto, 64k tokens por petición con 32k para el estado, 0,042 $ por millón de tokens de entrada, la salida no se cobra. Nuestro artículo hermano sobre Jev como capa de decisión para agentes de programación cubre el modelo en general; aquí lo usamos para una única tarea.
Las tres preguntas de la revisión
Cada PR que abre un agente de programación plantea las mismas tres preguntas, y cada una se corresponde con una primitiva. El estado es el mismo para las tres: un resumen del diff, el resultado de las pruebas y las rutas tocadas. No el diff completo. Un resumen mantiene la llamada dentro del presupuesto y hace que el modelo responda a la pregunta de enrutamiento en lugar de volver a revisar el código.
¿Hace falta una persona antes del merge? Un noul. Este es el filtro. Decide si un PR entra en la cola humana o si espera en un carril de baja prioridad.
¿Qué revisor o qué cola? Un choice entre las colas que tu equipo realmente utiliza. La respuesta incluye la opción elegida y la distribución completa, así que un reparto de 0.48 / 0.44 entre dos colas te indica que el PR está a caballo entre dos límites de propiedad, algo que en sí mismo merece la pena saber.
¿Cuánto riesgo conlleva? Un score sobre una rúbrica ordenada. El resultado es una posición ponderada por probabilidad, así que un cambio puede situarse en 2.6, entre «cambio de lógica cubierto por pruebas» y «toca autenticación, facturación o datos». Ese número es la clave de ordenación de la cola.
Una sola petición responde a las tres:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
La respuesta son tres respuestas tipadas bajo las mismas claves. Para SH-418, cabe esperar un needs_human cercano a 0.9, un queue que elija payments y un risk cerca de lo más alto de la rúbrica. Una corrección del reintento de facturación con las pruebas en verde sigue yendo al frente de la cola de pagos, porque las pruebas en verde no responden a «¿debería leer esto una persona?».
Los umbrales y qué hace cada banda
Una probabilidad solo es útil cuando el código la convierte en una acción. Las bandas que aparecen a continuación son un punto de partida, no una recomendación para tu repositorio; ajústalas tras una semana de ejecuciones.
needs_human |
Acción |
|---|---|
| 0.85 o más | Al frente de la cola humana, ordenados por risk de forma descendente |
| De 0.15 a 0.85 | Cola humana, ordenados por risk, después de la banda anterior |
| Por debajo de 0.15 | Carril de baja prioridad; una persona sigue haciendo el merge, cuando le venga bien |
Dos reglas mantienen esto honesto. Primero, un risk en lo más alto de la rúbrica siempre promociona un PR a la banda frontal, diga lo que diga needs_human. Un modelo que solo tiene un 0.12 de confianza en que una migración de esquema necesita revisión ha visto un resumen de diff impecable, no producción. Segundo, un choice cuyas dos opciones principales estén a menos de 0.1 entre sí se enruta a ambas colas, no a ninguna. La ambigüedad sobre la propiedad es motivo para que dos personas echen un vistazo a un cambio, no para que no lo haga nadie.
Fíjate en lo que sigue en manos de la persona en todas las bandas: el merge. Las bandas cambian el orden y la profundidad de la lectura. Nunca cambian quién decide.
Usa Jev para la cola, no para el veredicto
Usa Jev cuando la pregunta tenga un conjunto fijo de respuestas, el estado sea un resumen fiel y quieras invertir la atención de una persona en un orden mejor: quién lee esto, cuándo y en qué cola. Esas preguntas surgen en todos los PR y, a este precio, son lo bastante baratas como para planteárselas en cada ejecución.
Recurre a una persona, o a un modelo de lenguaje capaz de mostrar su razonamiento, cuando la pregunta sea si el cambio es correcto. Una probabilidad de que un cambio necesite revisión no es una revisión. Jev no tiene compilador, ni ejecutor de pruebas, ni acceso al archivo que puntúa: solo dispone del resumen que le enviaste. Un 0.96 en «seguro para hacer merge» es un motivo de peso para poner ese PR al principio de la lista de alguien, nunca un motivo para saltarse a ese alguien. La puerta de aprobación está después del modelo, y el modelo no tiene forma de abrirla.
Lo que construyó la comunidad
A los pocos días del lanzamiento, un desarrollador publicó jev-review, que su README describe como «un pequeño flujo de trabajo de revisión de código construido con TypeSafe Jev». Revisa un diff de Git o un código base completo, examina la corrección, la seguridad, la fiabilidad, la compatibilidad y la cobertura de pruebas, selecciona regiones de código antes de puntuar el impacto, aplica umbrales y políticas de flujo de trabajo en código y muestra los resultados en un panel local. El README es cuidadoso con el alcance: llama al proyecto «un experimento de composición de juicios tipados rápidos en un flujo de trabajo de revisión» y afirma que «todavía no integra diagnósticos del compilador, analizadores estáticos, indexación del repositorio ni explicaciones generadas».
Hay dos cosas de ese diseño que merece la pena copiar: la orquestación vive en el código y Jev solo responde a preguntas acotadas, y el trabajo está por etapas, primero se elige una región y luego se puntúa, en lugar de lanzar una única pregunta gigante sobre todo el diff. Jev también está disponible en Vercel AI Gateway como typesafe-ai/jev a través de experimental_evaluate en AI SDK 7; la documentación del Gateway señala que solo está disponible mediante el AI SDK.
Cómo encaja esto con Sharkly
Sharkly no llama a Jev por ti, y no es un modelo de decisión. Es la capa compartida de tareas, Computer, contexto y revisión en torno a los agentes de programación que tu equipo ya ejecuta. Lo que una cola clasificada necesita de esa capa es un lugar donde ejecutarse y un lugar donde aterrizar.
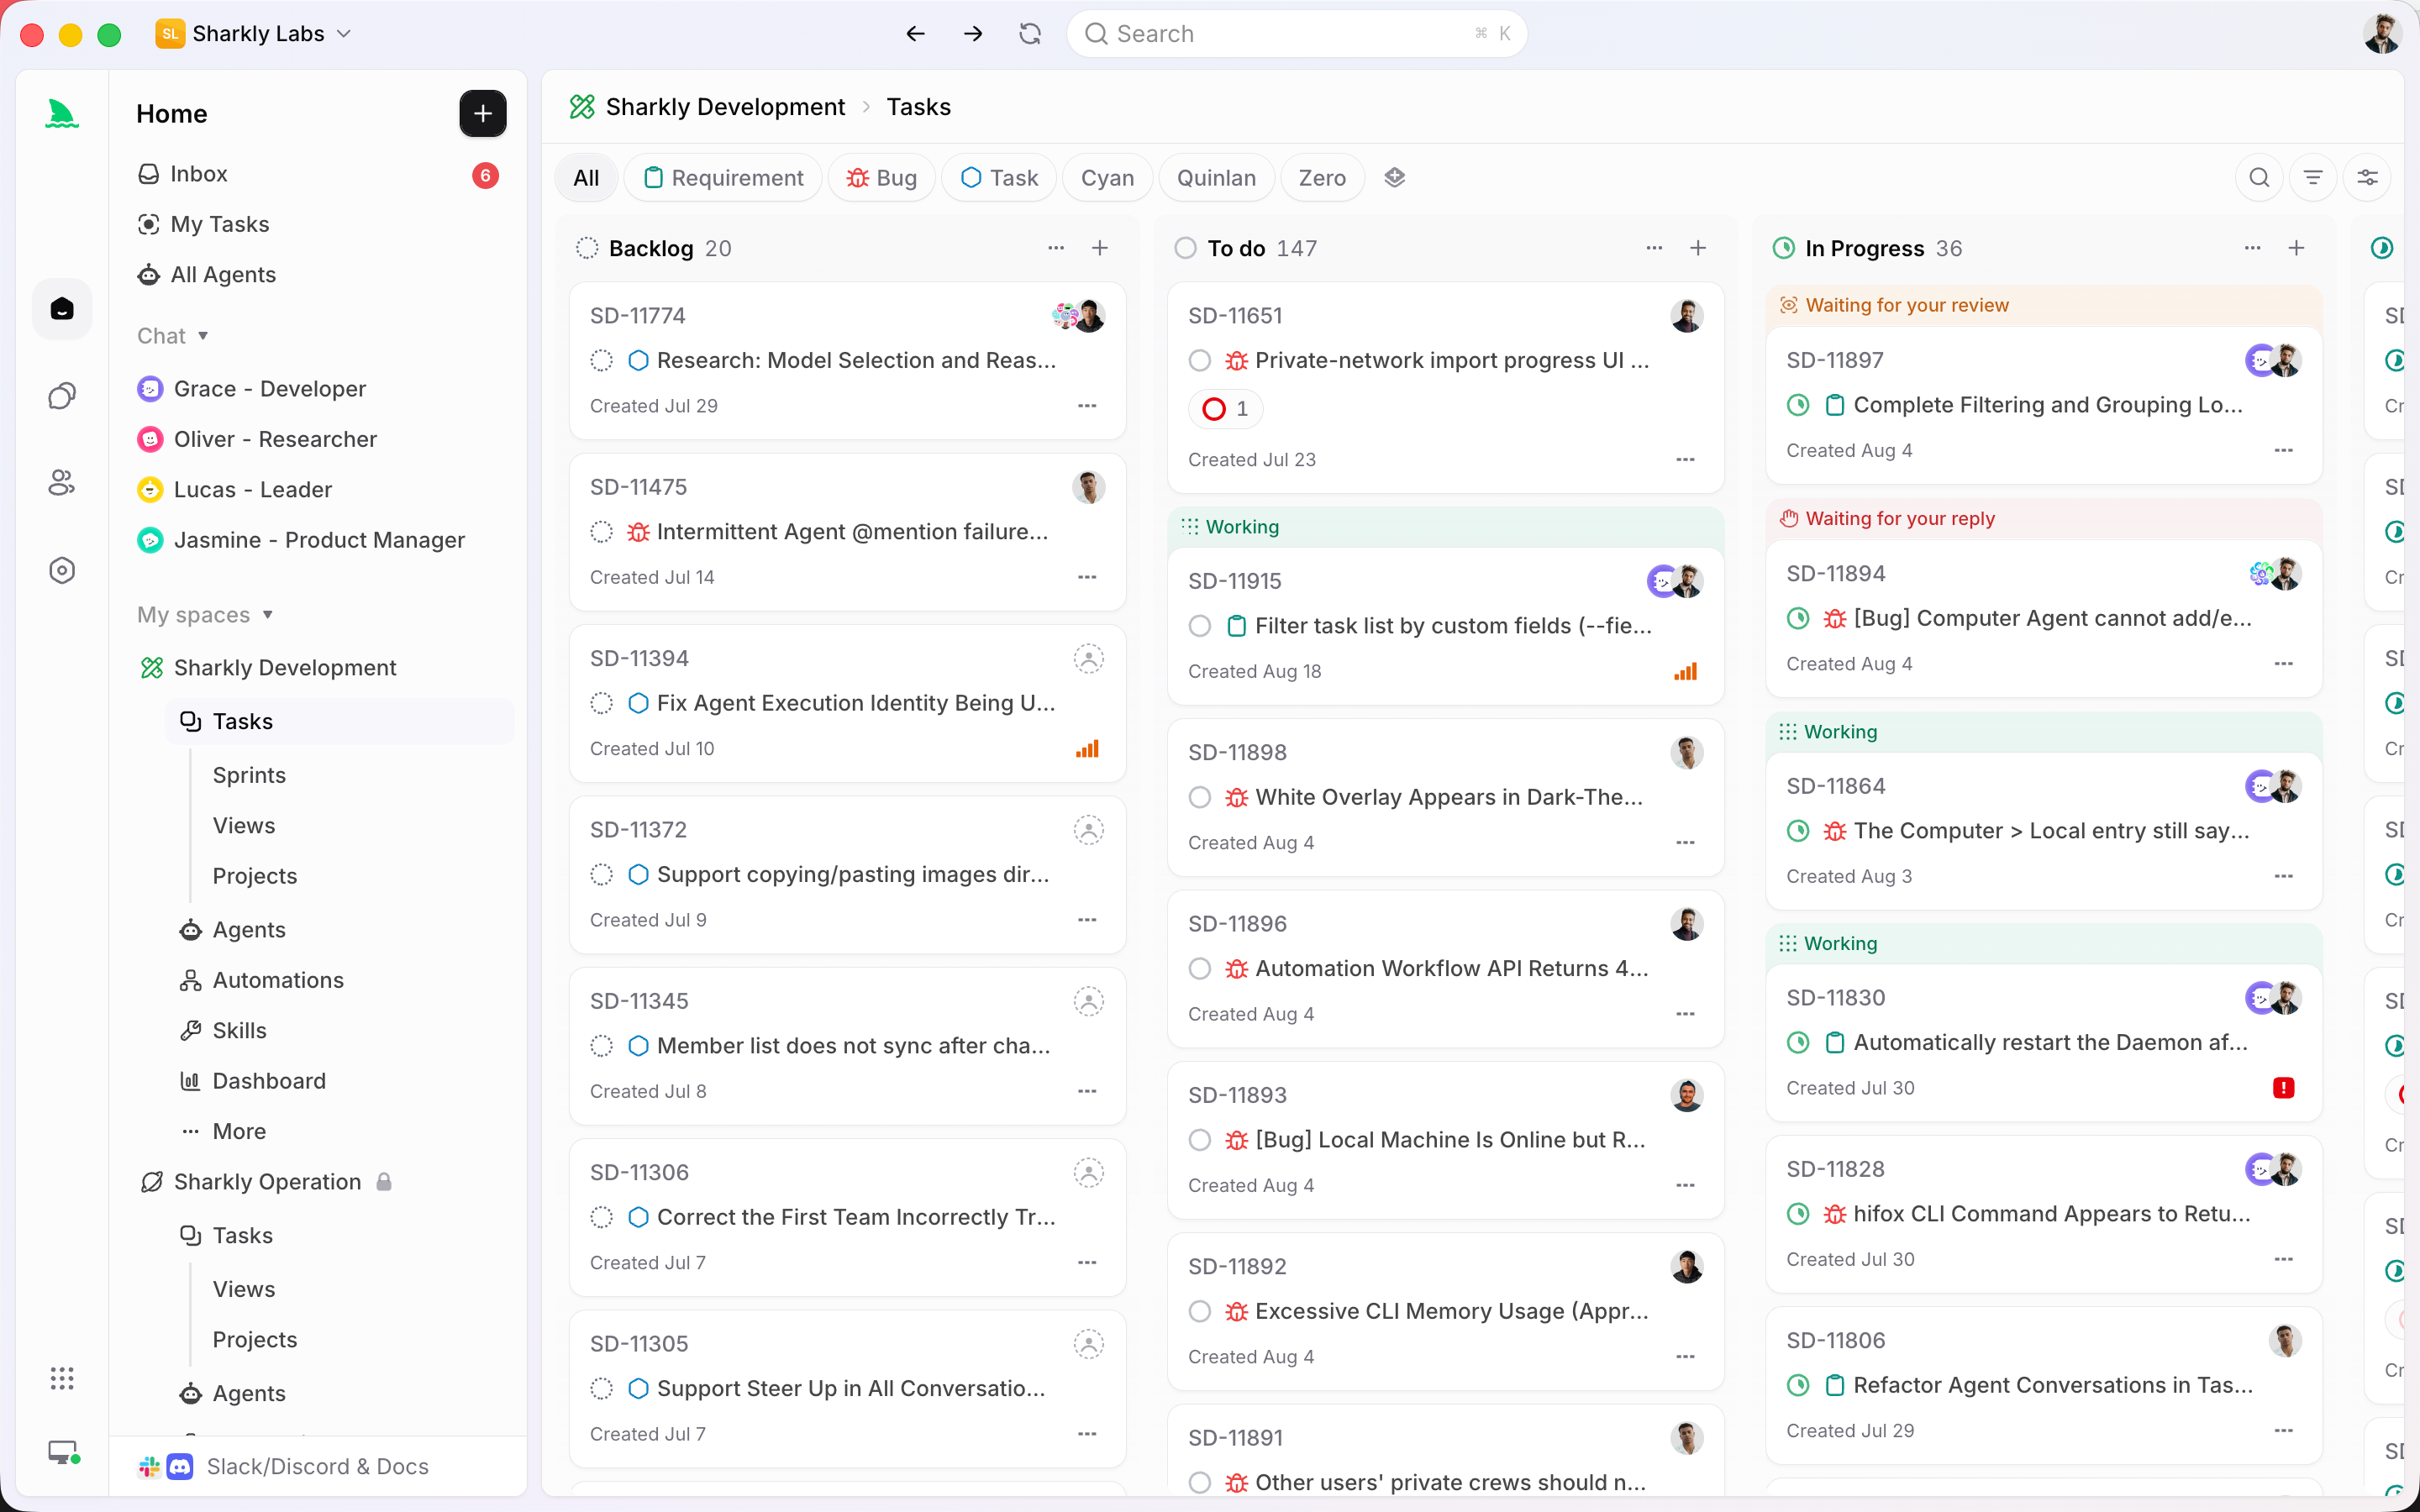
El lugar donde ejecutarse es una Automation: una regla propiedad de un Space que inicia un Agent con un conjunto de instrucciones ante un disparador, y uno de esos disparadores es una tarea que pasa a un estado concreto. Apúntala al estado al que llegan tus Agents cuando hay un PR abierto, y las instrucciones pasan a ser: lee el resumen del diff, el resultado de las pruebas y las rutas tocadas de la Task; llama a Jev con las tres preguntas; escribe las respuestas y la banda como comentario en la Task; asigna una etiqueta para la cola. La documentación es explícita en que una ejecución completada «no es una promesa de que todos los resultados de negocio posteriores fueran correctos», que es justo el mismo límite que trazan las bandas de revisión.
El lugar donde aterrizar es la propia Task. La banda, la cola y la puntuación de riesgo vuelven a la Task, allí donde el revisor ya mira, junto al resumen de cambios y los resultados de verificación de la ejecución. Una persona abre el tablero ordenado por riesgo y ve por qué cada PR ocupa el lugar que ocupa. Los agentes abren el pull request, ejecutan las pruebas e informan. Las personas leen en el orden que sugiere la cola y aceptan o rechazan. El orden vino de una probabilidad; la decisión, no.
Si ya ejecutas varios agentes y lo que te duele es la cola de revisión, ese es el flujo de trabajo que configura empezar con Sharkly: un Computer, un Agent y una Task con la evidencia que necesita una clasificación.
Preguntas frecuentes
¿Puede Jev leer el diff completo en lugar de un resumen?
Admite hasta 32k tokens de estado, así que un diff pequeño cabe. Aun así, envía un resumen: los diffs de los agentes superan con creces el presupuesto, y un resumen mantiene la pregunta en el plano del enrutamiento. El diff completo es lo que lee la persona, con la evidencia a nivel de tarea al lado.
¿Y si el resumen del diff lo escribió el propio agente?
Entonces el resumen puede estar sesgado a favor del agente, y la clasificación hereda ese sesgo. Es preferible un resumen generado a partir del diff en un paso aparte, y deja siempre que una puntuación de risk en lo más alto anule un needs_human bajo. Aquí se aplican los límites de la revisión de código con IA: el modelo puede clasificar lo que se le muestra, pero no puede verificar lo que no ve.
¿Una banda baja significa que el PR se hace merge automáticamente?
No. Una banda baja significa que una persona le hace merge más tarde, cuando le venga bien, sin leerlo primero en la cola. La propiedad del merge, y del trabajo que produjo el agente, sigue recayendo en una persona con nombre y apellidos en todas las bandas.
¿Jev es gratis a través de Sharkly?
Sharkly no revende Jev ni ningún otro modelo; tú aportas tu propia clave de TypeSafe o de Gateway, del mismo modo que las ejecuciones se facturan contra las suscripciones asociadas a tus Runtimes. Sharkly en sí es gratuito por ahora para organizaciones de hasta 5 personas.


