
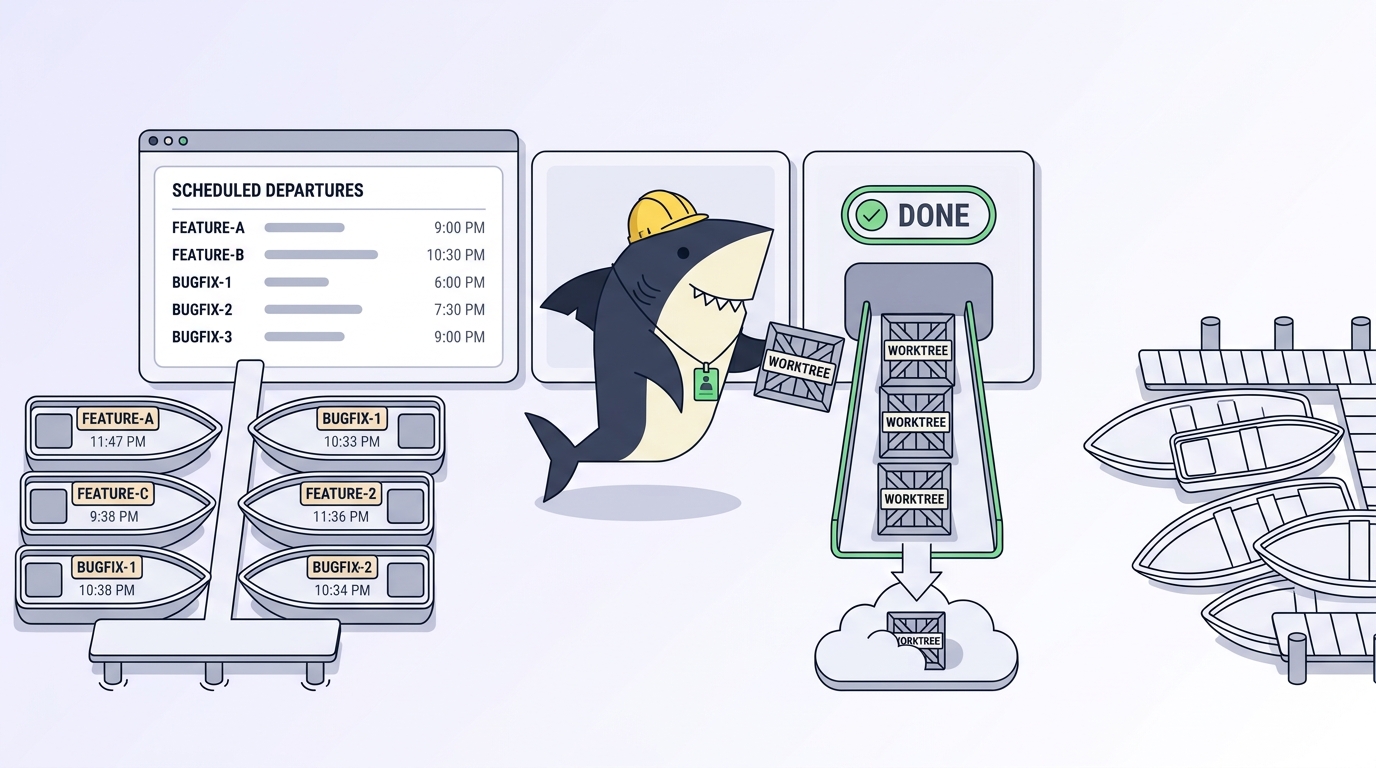
Los worktrees son fáciles de crear y fáciles de olvidar. Levantas uno para que un agente trabaje en una rama de forma aislada, el agente termina, revisas el diff y el directorio se queda ahí, sin más. Una semana después, git worktree list se sale de la pantalla, du -sh sobre el repositorio marca doce gigabytes y tres de esos directorios apuntan a ramas que ya se fusionaron y se borraron hace días. Nadie decidió conservarlos. Se acumularon porque crearlos era un solo comando y limpiarlos era una molestia.
Esta es la parte del trabajo con agentes en paralelo de la que nadie te avisa. La primitiva de aislamiento está bien documentada; nuestra guía sobre git worktrees para agentes de IA que programan cubre en profundidad la mecánica de crear y ramificar. El dolor está en el ciclo de vida posterior al "ya está", y empeora muy rápido cuando quien crea los worktrees es un agente capaz de abrir cinco en un minuto y sin ningún instinto de ordenar nada. Este artículo trata de esa segunda mitad: la disciplina de limpieza, los comandos exactos, el modo de fallo que acecha en cada paso y el punto en el que un script casero deja de ser suficiente.
Sharkly es una respuesta al problema de "quién limpia esto": ejecuta cada Task en su propio worktree y trata ese worktree como parte del ciclo de vida de la Task en lugar de como un directorio que tienes que recordar. Llegaremos a eso. Primero, la mecánica, porque conviene entender la versión manual antes de decidir dejar de hacerlo a mano.
TL;DR
Un worktree de git es un segundo directorio de trabajo vinculado a un mismo repositorio, con su propia rama, su propio índice y su propio HEAD. Los agentes los acumulan porque cada ejecución quiere aislamiento y ninguno limpia lo que deja atrás. El circuito de limpieza son cuatro comandos: git worktree list para ver qué existe, git worktree remove para borrar uno que ya terminó, git worktree prune para eliminar metadatos obsoletos y git worktree lock para proteger uno que quieras conservar. Cada uno tiene un modo de fallo que, si te saltas un paso, deja directorios huérfanos, trabajo perdido o ramas bloqueadas. La versión manual funciona con un puñado de worktrees. Más allá de eso, vincula cada worktree a un registro de tarea para que la limpieza tenga un responsable, que es justo lo que hace Sharkly de forma automática.
Por qué los worktrees se acumulan más rápido con agentes
Un worktree tiene un ciclo de vida que una persona gestiona de forma natural: lo creas, trabajas, fusionas y lo borras. El paso de borrar depende de que alguien se acuerde. Los agentes rompen esa suposición por dos vías a la vez.
Primero, el volumen. Un desarrollador que ejecuta cuatro agentes en paralelo está creando cuatro worktrees por hora, no uno al día. Nuestro artículo sobre ejecutar varios agentes de Claude Code en paralelo explica por qué esa cifra sube tan rápido. Segundo, no existe instinto de limpieza. Un agente lee la tarea, hace el trabajo, escribe el resultado y se detiene. No se plantea "la rama ya se fusionó, así que este directorio ya solo estorba". Así que los directorios sobreviven a su propia utilidad, y los supervivientes son el problema: checkouts obsoletos de ramas ya borradas, experimentos a medio terminar que el agente abandonó y árboles de node_modules duplicados ocupando disco en cada uno de ellos.
El coste no es abstracto. Cada worktree es un checkout completo más todo lo que el agente haya instalado dentro. Diez worktrees en un repositorio JavaScript de tamaño medio son diez directorios node_modules. El disco se llena, git status se vuelve más lento en todo el conjunto y la siguiente persona que ejecute git worktree list no sabrá distinguir qué directorios son trabajo vivo y cuáles son restos.
El circuito de limpieza, paso a paso
Aquí tienes todo el ciclo de vida en cuatro comandos. Ejecútalos en este orden y los modos de fallo se mantendrán a raya.
Mira qué existe. Empieza siempre la ronda de limpieza por aquí:
git worktree list
# /repo              a1b2c3d [main]
# /repo-auth-refactor 4d5e6f7 [auth-refactor]
# /repo-fix-logging   8g9h0i1 [fix-logging]
El modo de fallo si te lo saltas: borras el directorio equivocado. Dos agentes con ramas de nombre parecido generan rutas de worktree de nombre parecido, y eliminar el que está vivo te cuesta trabajo sin commitear. Lee la lista antes de tocar nada.
Elimina uno que ya terminó. Cuando la rama de un worktree ya esté fusionada y hayas confirmado que no hay nada sucio dentro:
git worktree remove /repo-fix-logging
El modo de fallo: remove se niega a actuar si el worktree tiene cambios sin commitear o archivos no rastreados, y ese es el comportamiento seguro por defecto. Lo peligroso es echar mano de --force para que el error desaparezca. Forzar sobre un worktree sucio borra trabajo real que un agente produjo y nunca llegó a commitear. Si remove se queja, ve a mirar el directorio primero; normalmente la queja tiene razón.
Poda los metadatos obsoletos. Si un directorio de worktree se borró con rm -rf en lugar de con git worktree remove, git todavía conserva un registro administrativo de él. Ese es el huérfano clásico:
git worktree prune
git worktree prune --dry-run   # preview first
El modo de fallo: saltarse el prune deja entradas fantasma en git worktree list y, peor aún, git puede negarse a reutilizar una rama que cree que sigue teniendo un checkout en algún sitio. prune limpia esa contabilidad. Ejecuta --dry-run primero para ver qué va a descartar antes de que lo descarte. La documentación de git worktree detalla exactamente qué considera obsoleto el prune.
Bloquea los que quieras conservar. Un worktree en un disco externo lento, o uno que contiene un experimento de larga duración, no debería caer víctima de un script de limpieza agresivo:
git worktree lock /repo-experiment --reason "release repro, keep until 2.0 ships"
El modo de fallo: sin bloqueo, una tarea nocturna de limpieza que pode todo lo "obsoleto" puede eliminar un worktree que habías aparcado a propósito. El bloqueo más una cadena de motivo son la diferencia entre un script de limpieza en el que confías y uno que acabas desactivando después de que se coma algo importante.
Dónde deja de escalar el script de limpieza
Puedes automatizar los cuatro pasos. Un cron job que liste los worktrees, compruebe cada rama contra el historial de fusiones y elimine las ya fusionadas son treinta líneas de shell. Funciona, y para un desarrollador en solitario que ejecuta unos cuantos agentes es suficiente. Usa el script cuando el número de worktrees sea bajo y una sola persona sea la dueña del repositorio.
Deja de escalar por el criterio, no por el rendimiento. Un script puede saber que una rama se fusionó. No puede saber que un worktree contiene trabajo sin commitear de un agente que aún no has revisado, ni que una rama "obsoleta" es en realidad una tarea pausada que alguien piensa retomar. En el momento en que la limpieza exige conocer la intención de un worktree, una regla que solo ve el estado de git acabará borrando algo que importaba. El otro techo es la coordinación: en una máquina compartida, el script de limpieza de una persona no sabe qué están haciendo los agentes de otra, y "¿es seguro eliminar esto?" deja de tener respuesta solo con git worktree list. Para profundizar en ese problema de la máquina compartida, consulta nuestra recopilación de herramientas para gestionar agentes de IA que programan en paralelo.
Qué aporta un tablero de tareas
La solución es darle a cada worktree un responsable que sobreviva a la sesión de shell. Vincula cada worktree a un registro de tarea y la limpieza deja de ser "qué directorios parecen obsoletos" para convertirse en "qué tareas están terminadas y revisadas".
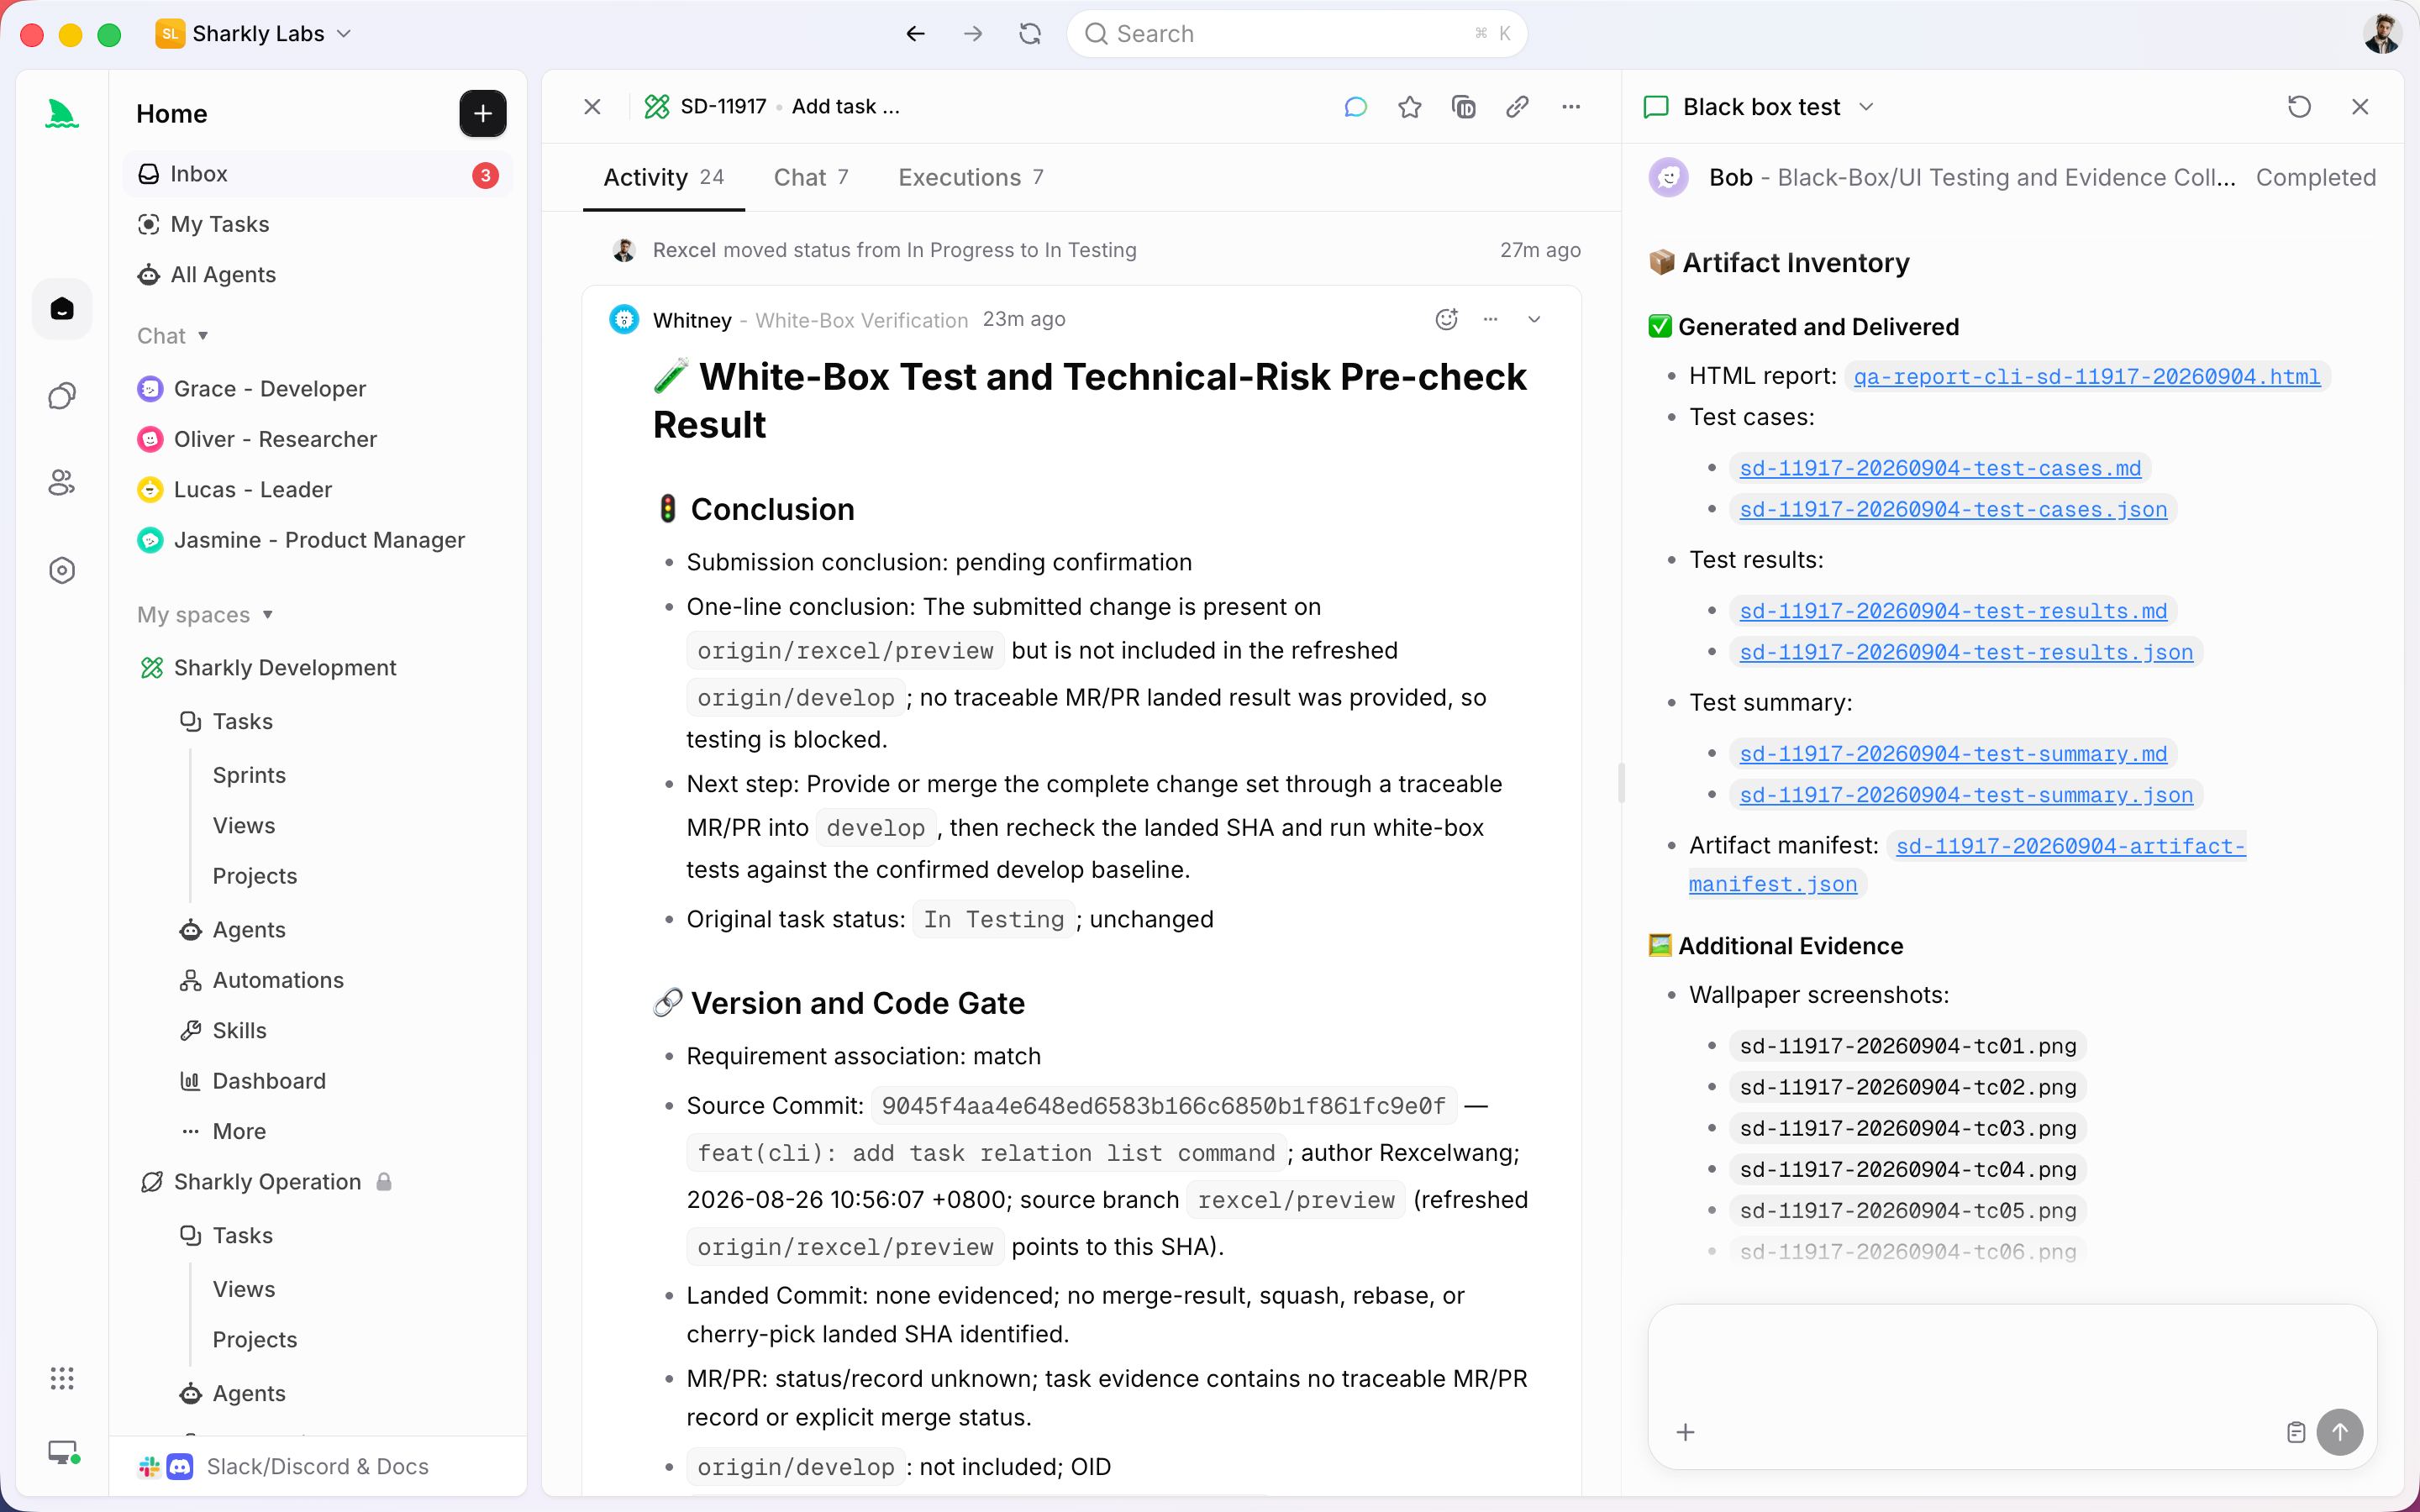
Esta es la capa en la que se sitúa Sharkly. Ya tienes agentes que programan; Sharkly los convierte en un equipo haciendo que cada ejecución sea una Task. Cuando arranca una Task, el servicio local del Computer conectado prepara un worktree aislado para ella. Cuando el resultado de la Task vuelve para revisión y una persona lo acepta, el ciclo de vida del worktree termina junto con la Task en lugar de quedarse por ahí como un directorio que nadie recuerda. La pregunta de la limpieza tiene respuesta porque el worktree nunca fue anónimo.
El reparto de trabajo se mantiene honesto. Los agentes reclaman tareas, trabajan en worktrees aislados, ejecutan tests y devuelven el diff. Las personas marcan la dirección y deciden el paso de fusión y publicación. Sharkly no sustituye a Claude Code, Codex ni a los comandos de git de arriba; añade el registro compartido para que aislamiento, progreso, resultados y limpieza sigan visibles desde la petición hasta la publicación, en lugar de dispersarse por terminales. Si ejecutas un solo agente y limpiar a mano te lleva diez segundos, todavía no lo necesitas. Cuando la lista de worktrees se sale de la pantalla, el problema real es el de la gestión, y nuestra nota sobre mantener a las personas en el bucle entre ejecuciones de agentes cubre la parte de revisión.
La lista de comprobación que puedes ejecutar hoy
Pasa esta ronda por cualquier repositorio en el que hayan estado trabajando agentes:
git worktree listy léela entera antes de eliminar nada.- Para cada worktree terminado: confirma que la rama se fusionó, comprueba que el directorio está limpio y luego
git worktree remove(nunca--forcesobre un árbol sucio). git worktree prune --dry-run, revisa el resultado y despuésgit worktree prunepara limpiar los metadatos huérfanos.git worktree locken cualquier worktree que quieras conservar a propósito, con una cadena de motivo.- Revisa el disco:
du -shsobre todo el conjunto de worktrees y borra las instalaciones de dependencias duplicadas de los árboles muertos. - Si haces esto más de una vez al día, deja de automatizar la limpieza y dale a cada worktree un responsable de Task.
Puedes quedarte con los cuatro comandos y ejecutarlos a mano, o ejecutar tus agentes de programación actuales a través de Sharkly para que el worktree se cree, se siga y se retire junto con la Task a la que pertenece.


