
La publicación de lanzamiento de Muse Wonder por parte de Meta describe un comportamiento que denomina Active Focus: el modelo sigue trabajando para alcanzar un objetivo difícil, prueba enfoques alternativos, supera bloqueos y, en palabras de Meta, pide aclaraciones cuando es necesario y realiza consultas antes de acciones importantes. Meta también recomienda la confirmación humana antes de acciones de gran impacto, y su guía de coding-agents incluye Muse Code con aprobaciones y un entorno de sandbox activados desde la primera ejecución.
Es el diseño correcto. Sin embargo, también plantea una pregunta que cualquier equipo que ejecuta agentes en paralelo ya conoce: cuando el modelo se detiene a preguntar, ¿quién está ahí para responder, con qué rapidez y con qué contexto? Una consulta de confirmación que llega a una terminal que nadie está mirando es una ejecución estancada. Una consulta que llega a un Inbox compartido, vinculada a la Tarea de la que proviene, es un paso de revisión. Esta publicación trata sobre cómo construir la segunda opción.
Lo que produce Active Focus
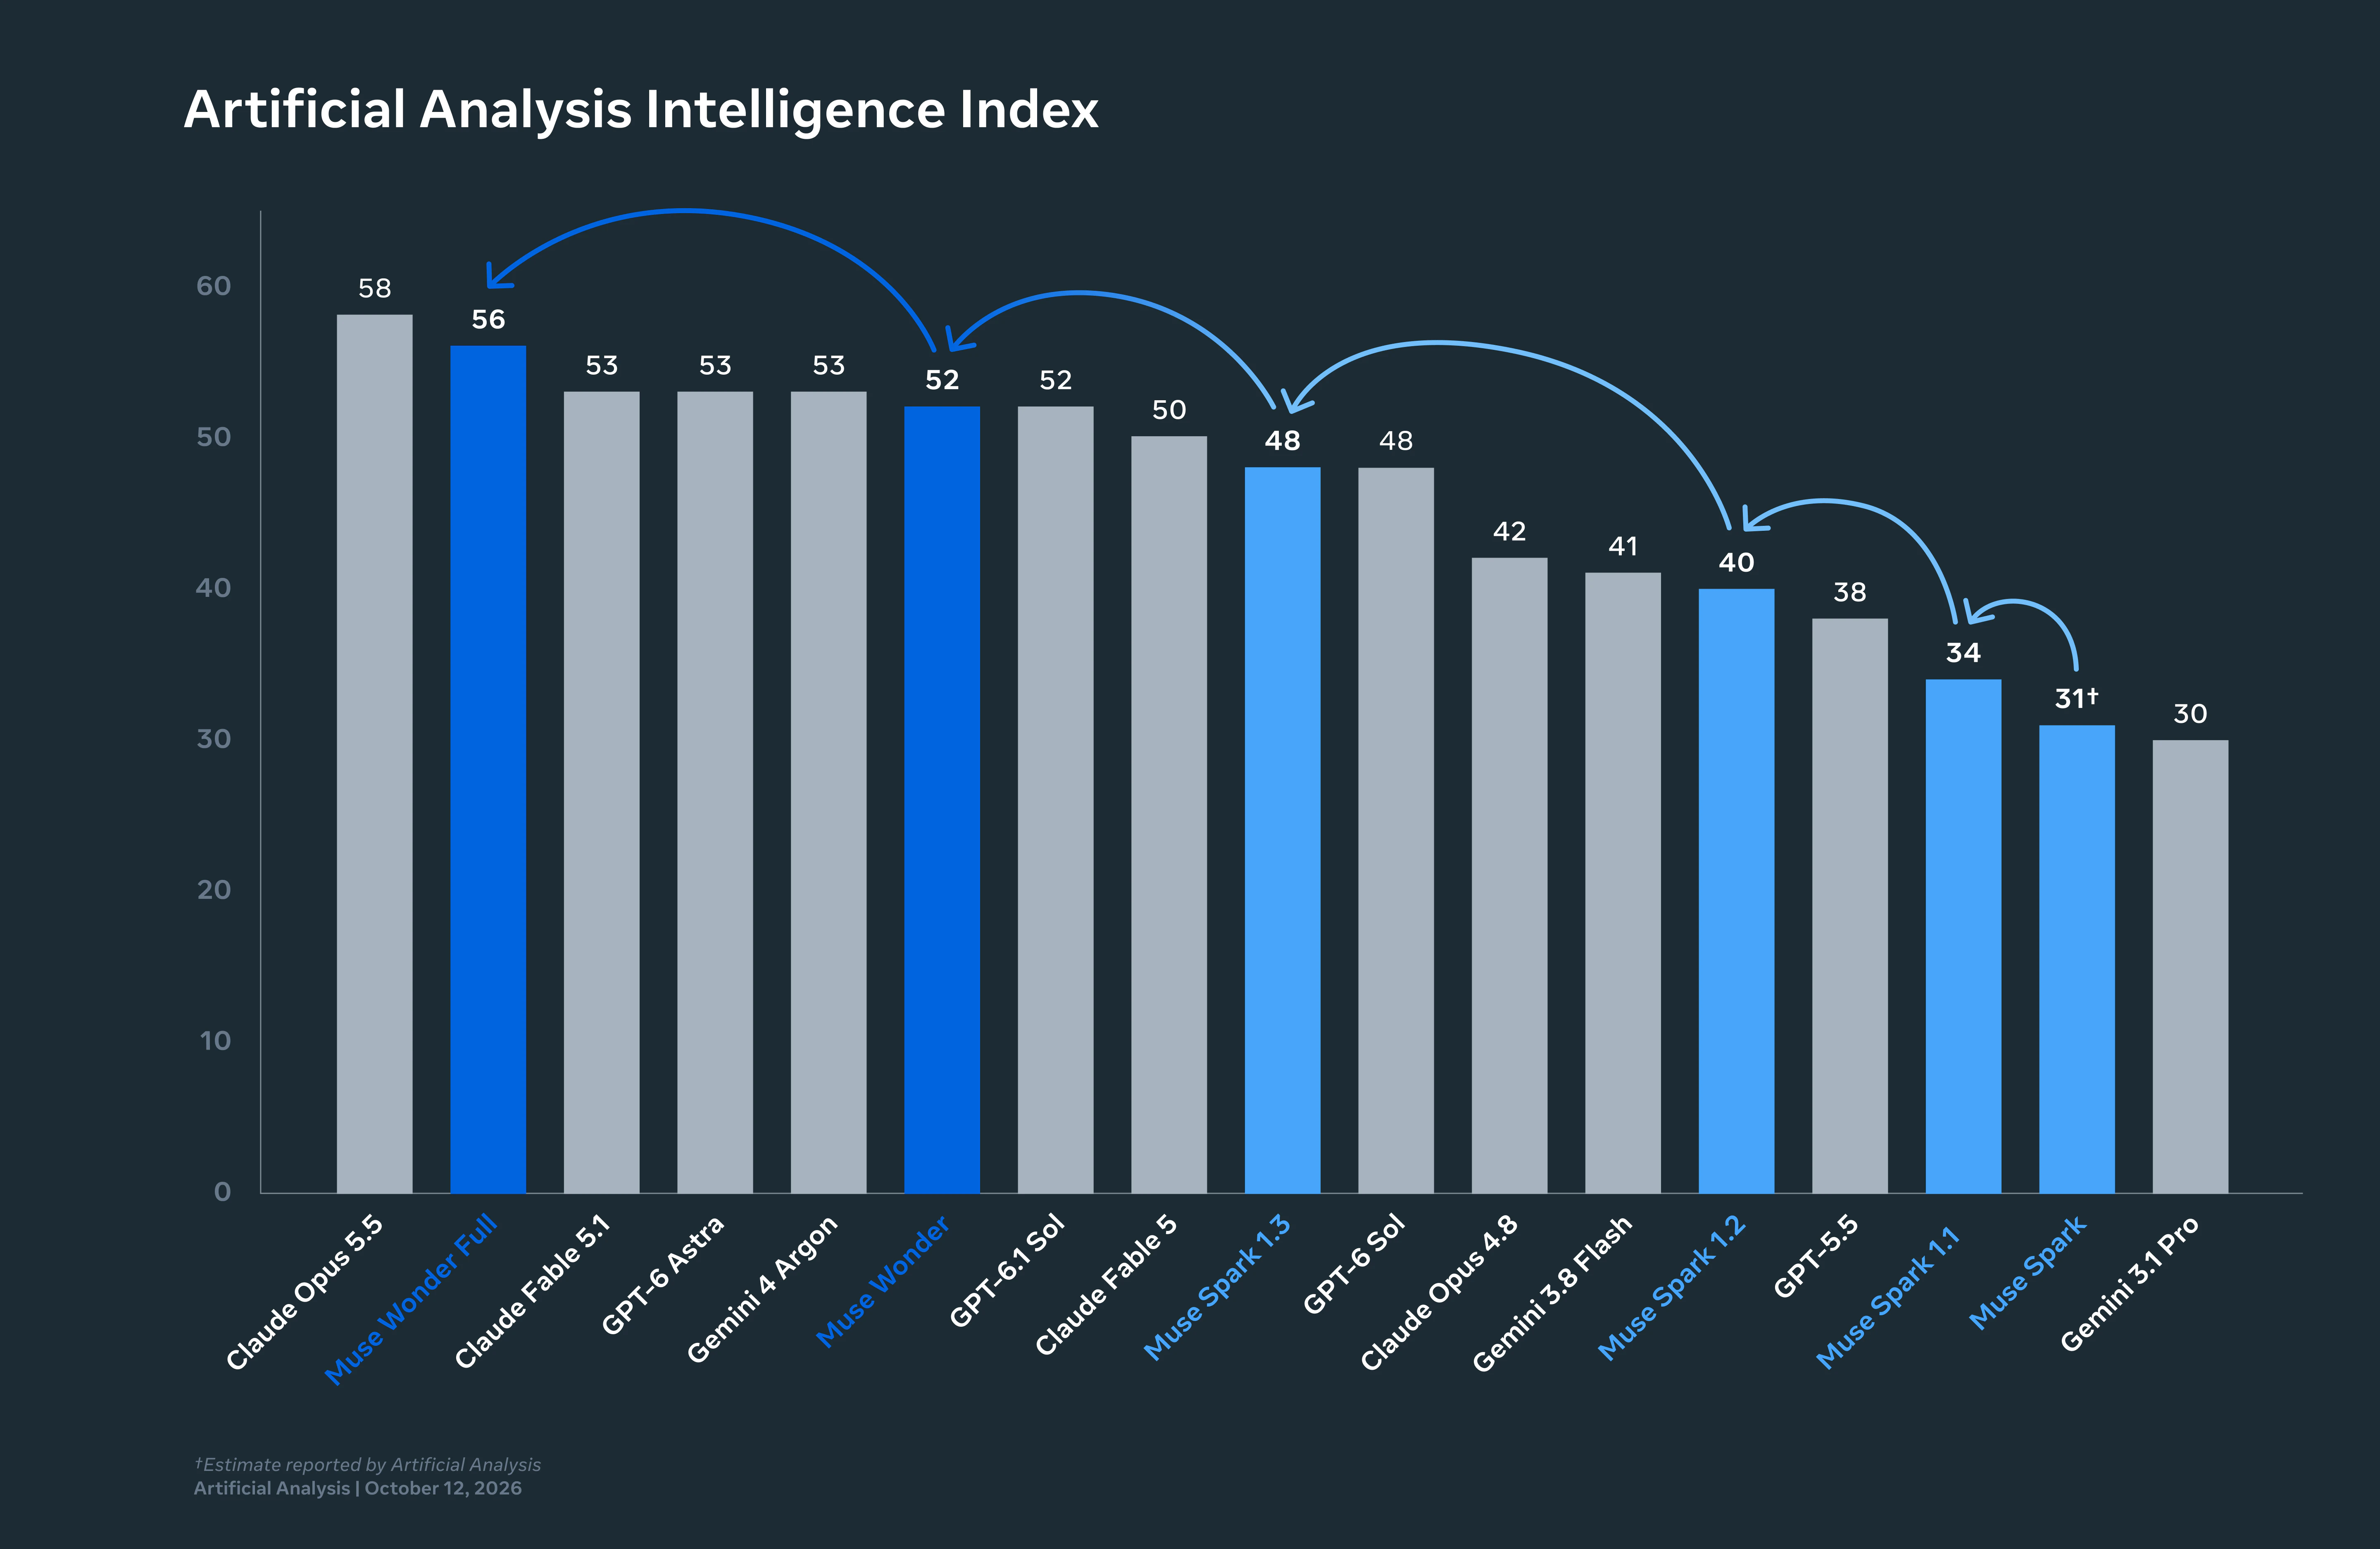
Meta entrenó el modelo para tres comportamientos y los evalúa en un benchmark interno que denomina FocusBench, donde Muse Wonder Full lidera con un 54,2 % y la versión de Wonder disponible vía API se sitúa en un 44,9 %, por detrás de GPT-6 Astra y Claude Opus 5.5. Dejando a un lado las puntuaciones, los comportamientos son lo que realmente importa para un tablero:
- Persistencia. El modelo sigue adelante a pesar de los fallos. En SWE-Marathon, el benchmark de programación de larga duración, Wonder obtiene 53,1 frente a los 46,3 de Opus 5.5. Ejecuciones más largas, más intentos y más material para revisar.
- Aclaración. El modelo pregunta cuando la Tarea es ambigua en lugar de suponer. En un tablero, esto es un comentario en la Tarea; en una terminal, es un aviso a la espera de que se pulse una tecla.
- Consultas de confirmación. El modelo hace una pausa antes de una acción que considera importante. La propia recomendación de Meta es requerir confirmación humana para cualquier acción de consecuencias significativas.
Cada uno de ellos cambia la dinámica de la cola de revisión. La persistencia añade volumen por Tarea. Las aclaraciones añaden interrupciones. Las consultas de confirmación introducen decisiones que bloquean la ejecución hasta que alguien las resuelva.
Dónde aterriza la consulta
En Muse Code, aparece un aviso de aprobación en la terminal del suscriptor y la ejecución se detiene a la espera. Las ejecuciones desatendidas (muse exec) no cuentan con una interfaz interactiva, por lo que la documentación de Meta recomienda elegir una política capaz de completarse sin supervisión o asumir que las acciones retenidas quedarán sin resolver. Esa es la compensación real: o hay una persona frente al teclado, o el modelo se ejecuta sin aprobaciones, o la acción espera para siempre.
En un tablero de Sharkly, la ejecución es una Tarea asignada a un Agente en un Computer. Cuando el Agente se detiene a preguntar, la consulta regresa a la Tarea en forma de comentario y se enruta al Inbox. La Tarea conserva todo el contexto: qué se preguntó, qué ha hecho el Agente hasta el momento y el registro de ejecución de llamadas a herramientas y eventos del Runtime. Quien la tome responde en la Tarea, y la ejecución cuenta con un punto de referencia para reanudarse. La consulta sigue siendo una decisión humana, pero una decisión con un registro, una cola y más de una persona capacitada para tomarla.
Esa es la diferencia entre un mecanismo de seguridad y una paralización. El comportamiento del modelo es idéntico. Es el sistema que lo rodea el que determina si una confirmación cuesta un minuto o un día entero.
Cómo configurar el Agente para que las consultas sean útiles
Una consulta de confirmación solo es tan buena como la pregunta que formula. Establece el estándar para formularla bien en las instrucciones del Agente:
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
La primera regla traza el límite. El modelo de Meta decide por sí mismo qué considera importante; la instrucción le enseña lo que importa al equipo. La segunda regla permite que cualquier persona que no haya seguido la ejecución pueda responder al comentario en treinta segundos. La tercera regla evita que el modelo consulte sobre cada detalle, que es el modo de fallo que convierte a un agente precavido en uno insoportable. El artículo sobre guardrails para Opus 5.5 aborda este mismo límite desde la perspectiva de la inyección de prompts: el filtro de revisión es el mecanismo de control, al margen de lo que prometa el modelo.
Dimensionar la cola
Una mayor persistencia implica más revisión por Tarea, no menos. Planifícalo.
| Carril | Ejecución típica | Lo que llega a la cola |
|---|---|---|
| Muse Wonder en una Tarea larga | Muchos pasos, varios enfoques revertidos | Un diff más extenso, un registro más largo y de cero a tres consultas de confirmación |
| Opus 5.5 en la misma Tarea | Menos pasos, más resolutivo | Un diff más breve o una Tarea devuelta a medio terminar |
| Cualquier modelo, desatendido durante la noche | Lo que haya permitido la política | Acciones retenidas o acciones que nadie confirmó |
Tres prácticas mantienen la cola en movimiento. Enruta las consultas de confirmación a un revisor designado por carril en lugar de enviarlas a todos, para que una pregunta no quede esperando a un grupo. Configura el tiempo límite (timeout) por Tarea del Agente para que una ejecución bloqueada por una consulta falle visiblemente en vez de quedarse en estado activo durante horas. Y lee el registro, no solo el diff, en las ejecuciones de Wonder: el recorrido a través de tres enfoques fallidos es la parte que añade un modelo persistente, y es ahí donde residen los errores sutiles. Agentes de programación mientras estás fuera analiza el caso de ejecuciones nocturnas, y la revisión humana es el cuello de botella explica por qué nada de esto se vuelve más económico con un modelo mejor.
Cómo se ve una buena consulta en el tablero
Esta es la estructura que generan las instrucciones anteriores, en forma de un comentario en la Tarea sobre el cual un revisor puede actuar desde un teléfono móvil:
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
Cuatro líneas, una decisión, ambas ramificaciones planificadas previamente. El revisor escribe «sí» o «no, consérvala» en la Tarea, la ejecución se reanuda y el registro guarda quién tomó la decisión. Compara eso con un mensaje en la terminal que muestra Allow? [y/N] a alguien que no presenció los cuarenta pasos anteriores.
Dos ajustes una vez que el carril lleve funcionando una semana: si un revisor responde a la mayoría de las consultas, asigna al Agente de ese carril un segundo revisor designado para que una reunión vespertina no congele todas las ejecuciones largas. Y si el Agente pregunta repetidamente sobre el mismo tipo de acción, ese criterio debe trasladarse a las instrucciones como un sí o un no permanente, no a la cola.
El caso del computer use
Meta incluye computer use entre las capacidades de Wonder: interactuar con navegadores, escritorios y aplicaciones móviles. Ahí es donde las consultas de confirmación cobran más importancia y donde un aviso de terminal resulta menos adecuado, ya que la acción consiste en hacer clic en una pantalla que el revisor no puede ver. Se aplican las mismas pautas del artículo sobre computer use en Astra: el Agente se ejecuta en un Computer elegido por el equipo, la consulta especifica la pantalla y la acción, y la persona responsable puede consultar el registro de la Tarea antes de dar el visto bueno. Un modelo que pide autorización para pulsar Submit solo es seguro si alguien puede entender qué hace Submit.
Lo que esto no es
Active Focus es un comportamiento de modelo, y los comportamientos de modelo no son garantías. La propia documentación técnica de Meta señala que los modelos pueden cometer fallos en tareas desconocidas de múltiples pasos, y su informe completo de seguridad aún no se ha publicado. La consulta de confirmación es una característica que perfecciona un buen sistema de revisión; no lo reemplaza. Cualquier equipo que entienda «realiza consultas antes de acciones importantes» como una invitación a trabajar sin supervisión lo ha interpretado mal. Un equipo que acompaña cada consulta de una Tarea, un revisor y un tiempo de espera ha construido aquello para lo que realmente se diseñó esta funcionalidad.
Nada de esto repercute en la factura de Sharkly. El uso del modelo se canaliza a través de la clave de Meta configurada en el Computer. El modelo se actualizó el 12 de octubre. El contexto, el progreso, los bloqueos, los resultados y la revisión humana permanecieron visibles desde la solicitud hasta el despliegue final. Puedes construir esto manualmente mediante worktrees o apoyarte en Sharkly para gestionar el flujo de trabajo.


