
¿Argon o Carbon? Ejecuta la mayoría de las tareas de agentes en Gemini 4 Argon y reserva Gemini 4 Carbon solo para las más complejas. La propia Google lo dice: Argon se mantiene como la opción predeterminada para la mayor parte de la ingeniería de software, mientras que Carbon está pensado para el trabajo más exigente. Ambos cuestan 2 $ de entrada y 10 $ de salida por millón de tokens hasta el 30 de noviembre de 2026, pero Carbon consume más tokens por tarea.
En resumen (TL;DR)
- Empieza por lo económico, escala con evidencias. Inicia cada tarea en el modelo rápido. Escálala únicamente cuando cumpla una regla verificable de complejidad o cuando ya haya fallado una vez.
- Mismo precio por token no significa mismo coste por tarea. Carbon lee más, razona durante más tiempo y realiza más comprobaciones, por lo que una sola tarea consume más tokens.
- Cuatro señales identifican una tarea compleja: horizonte largo, múltiples archivos, impacto en la seguridad o un primer intento fallido.
- Mide dos métricas por tarea: coste y tasa de aprobación en la revisión. Enruta basándote en ellas, no en las tablas de clasificación.
- Convierte el modelo en una configuración, no en una decisión que tomas en cada prompt. En Sharkly, cada agente tiene un modelo predeterminado, y puedes anularlo para una ejecución puntual al asignar la tarea.
Por qué preguntarse «cuál es el mejor modelo» es un error
Gemini 4 Carbon alcanzó la disponibilidad general (GA) el 10 de noviembre de 2026 bajo el ID de modelo gemini-4-carbon. La publicación de lanzamiento de Google hace algo poco habitual en este tipo de anuncios: aconseja no utilizar su modelo más reciente para la mayoría de los trabajos: «Argon sigue siendo la opción ideal para la mayor parte de la ingeniería de software y el trabajo de conocimiento».
Según el mismo artículo, Carbon está «diseñado para tareas que ponen a prueba los límites de la inteligencia de un modelo» y utiliza «más tokens que Argon para explorar a fondo, razonar en profundidad y ejecutar ciclos de verificación más amplios».
Este enfoque encaja a la perfección con la forma en que un equipo gestiona agentes. Tienes una cola de tareas con distintos niveles de dificultad, y cada una merece el modelo más económico capaz de superar la revisión. Elegir un único «mejor modelo» para todo el equipo supone pagar de más en tareas sencillas o quedarse corto en las complejas.
Si primero quieres conocer todos los detalles sobre Carbon, nuestro artículo sobre Gemini 4 Carbon para agentes de programación explica qué ofrece, mientras que la guía de Gemini 4 Argon analiza el modelo predeterminado.
La regla de enrutamiento: empieza por lo económico, escala en lo complejo
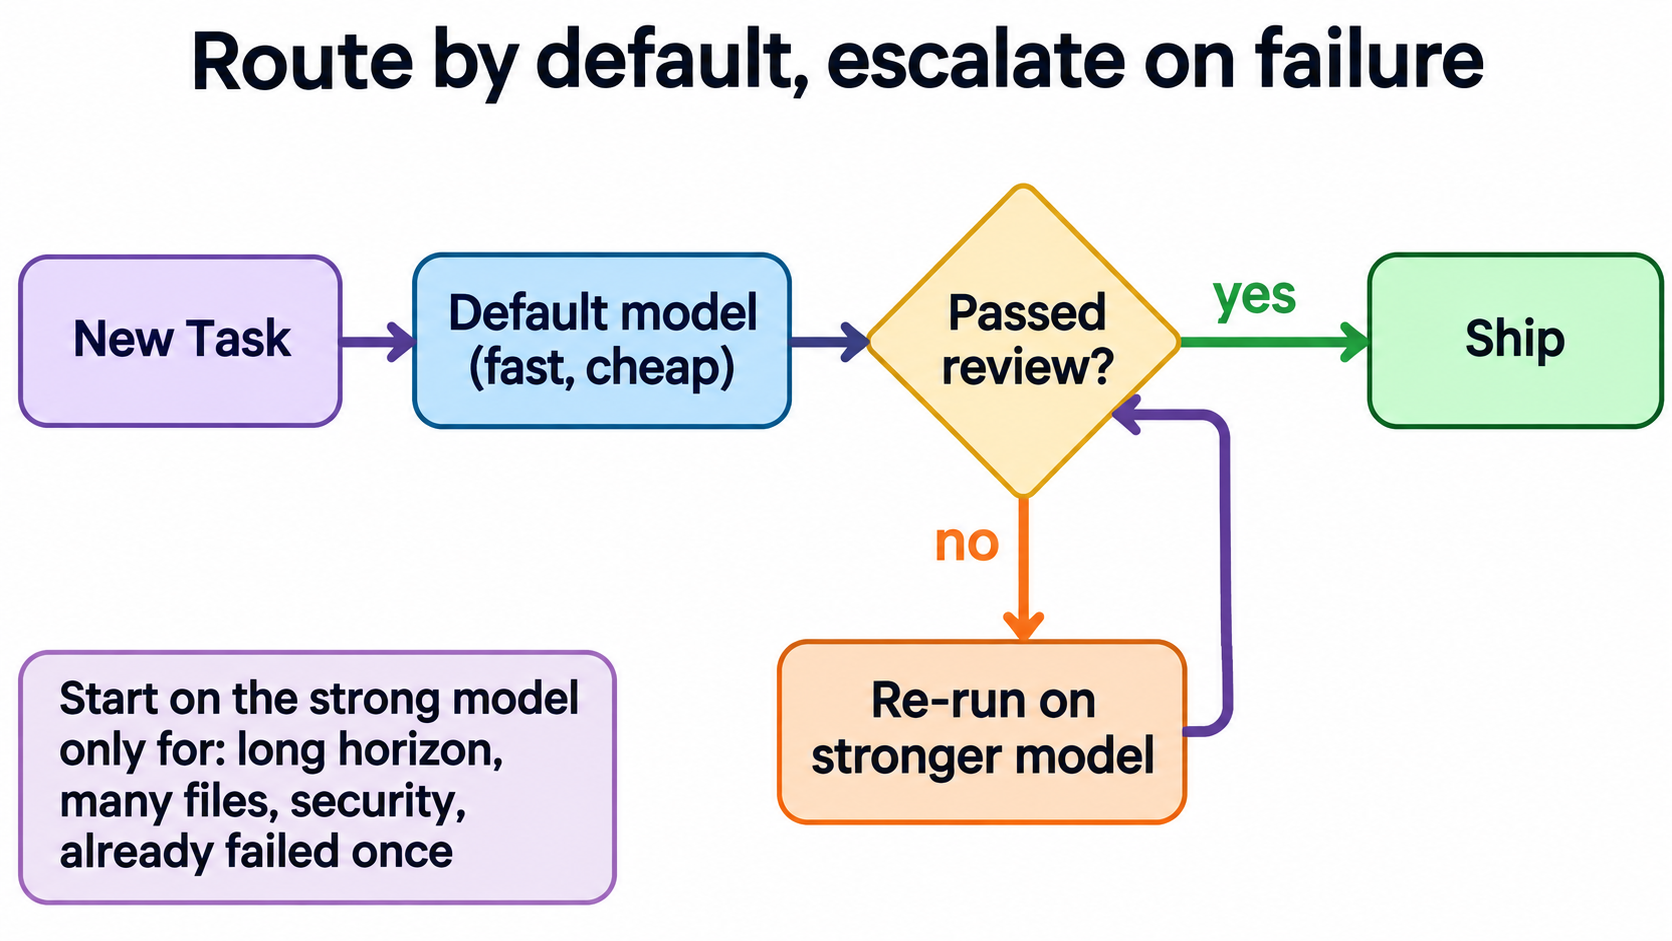
El enrutamiento de modelos para agentes de programación consiste en elegir el modelo por tarea en lugar de por equipo. La regla se resume en una sola línea: cada tarea comienza en el modelo predeterminado y solo pasa al modelo más potente cuando una señal explícita indica que es compleja o cuando el modelo por defecto ya ha fallado.
Dos principios hacen que esta regla funcione:
- Un modelo predeterminado rápido y suficiente para la mayoría de las tareas. Para un equipo que usa Gemini, ese modelo es Argon, según las propias recomendaciones de Google.
- Una ruta de escalado con un detonante auditable. «Parecía difícil» no es un detonante válido; «modifica código de autenticación», sí.
Cómo identificar una tarea compleja
Necesitas señales objetivas que cualquiera pueda identificar en una tarea antes de ejecutarla. Estas cuatro cubren la mayoría de los casos.
Horizonte largo
Una tarea que requiere muchos pasos sucesivos, como una migración con diez cambios dependientes entre sí, ofrece a un modelo más modesto más oportunidades de desviarse. Los ciclos de verificación adicionales de Carbon están diseñados específicamente para estos escenarios. Señal: la descripción de la tarea enumera más de cinco pasos, o una ejecución anterior de un trabajo similar superó el tiempo estimado.
Múltiples archivos
Los cambios transversales obligan al modelo a retener una mayor parte de la base de código en memoria a la vez. Señal: el cambio afecta a varios paquetes o a más de diez archivos.
Impacto en la seguridad
La autenticación, los pagos, la gestión de secretos y las comprobaciones de permisos no perdonan una respuesta incorrecta dada con aparente seguridad. El artículo de GA de Google señala que Carbon lidera SEC-bench Pro y CWE-bench v1 cuando se accede mediante su programa Fairwind para defensores de ciberseguridad. Señal: la tarea modifica una ruta que has marcado como confidencial o sensible.
Ya ha fallado una vez
Esta es la señal más económica y la más certera. Si la ejecución del modelo predeterminado no superó la revisión, tienes pruebas directas de que la tarea supera su capacidad. Vuelve a ejecutarla en el modelo más potente adjuntando los comentarios del revisor.
Una tabla de enrutamiento para empezar
Utiliza esto como punto de partida y adáptalo tras dos semanas a partir de tus propias tasas de aprobación.
| Tipo de tarea | Empezar con | Escalar a | Motivo |
|---|---|---|---|
| Corrección tipográfica, cambio de textos, actualización de dependencias | Nivel rápido (un modelo Flash o mini) | Argon | Diff pequeño, fácil de revisar |
| Corrección de errores con un test fallido | Argon | Carbon | El test proporciona una señal clara de éxito |
| Nueva funcionalidad en un solo módulo | Argon | Carbon | El modelo recomendado por Google para la mayoría de tareas de ingeniería |
| Refactorización en múltiples archivos | Carbon | Fable 5.2 o un revisor humano | Horizonte largo, muchos archivos |
| Autenticación, pagos, permisos | Carbon | Siempre revisión humana | Impacto en la seguridad |
| Cualquier tarea que haya fallado una revisión | Subir un nivel | Revisor humano | Los hechos superan a las suposiciones |
Claude Fable 5.2 tiene una tarifa de 8 $ de entrada y 40 $ de salida por millón de tokens, cuatro veces el precio de lanzamiento de Carbon, por lo que se sitúa por encima de este como un último escalón automatizado, no como una opción por defecto. El precio del propio Carbon subirá a 4 $ y 20 $ a partir del 30 de noviembre de 2026, según la nota a pie de página de Google, lo que reducirá esa brecha. Consulta las cifras actualizadas en la página de precios de la API de Gemini antes de definir tus presupuestos.
Escala ante el fallo, no por anticipado
Los equipos suelen enviar por defecto al modelo más potente todo aquello que «suene difícil». Esto transmite seguridad, pero resulta muy costoso, ya que muchas de esas tareas se habrían resuelto correctamente con el modelo estándar.
Escalar tras un fallo supone pagar el coste del modelo pequeño en cada tarea y el del modelo grande solo cuando la tarea demuestra que realmente lo necesita. Una ejecución económica fallida suele costar mucho menos que una ejecución costosa innecesaria.
Hay dos excepciones a esta regla, ambas contempladas en la tabla anterior. Las tareas de seguridad empiezan arriba porque un primer intento defectuoso podría fusionarse en la rama principal si la revisión lo pasa por alto. Las refactorizaciones extensas y con múltiples archivos también empiezan arriba porque un intento fallido consume una hora, no un minuto.
Por otra parte, una ejecución fallida solo aporta información si la revisión la detecta. Los modelos a veces encuentran atajos para pasar las pruebas, así que combina el escalado con las comprobaciones descritas en cómo detectar trampas en tests por parte de agentes de programación.
Mide el coste y la tasa de aprobación por tarea
Enrutar sin datos empíricos convierte las decisiones en meras opiniones. Registra dos métricas en cada tarea:
- Coste por tarea: tokens de entrada y salida multiplicados por el precio de ese modelo, sumando todas las ejecuciones que requirió la tarea, incluidas las fallidas.
- Tasa de aprobación en la revisión: ¿se aprobó en el primer intento, o necesitó una nueva ejecución o una corrección manual?
A continuación, divide. El coste por cambio aceptado es la métrica definitiva para decidir el enrutamiento. Un modelo económico que falla la mitad de las veces puede terminar costando más que uno avanzado que acierta al primer intento, como se explica en cuándo un modelo más barato sale más caro.
Los datos de terceros apuntan en la misma dirección. Artificial Analysis indica que ejecutar su Intelligence Index costó 7,76 $ en Gemini 4 Carbon (high) frente a 26,54 $ en Claude Fable 5.2 (max), con una puntuación de 65 para Fable frente a 60 para Carbon. Pagar 3,4 veces más por una diferencia de cinco puntos solo se justifica en tareas donde esos cinco puntos cambien de verdad el resultado.
Un registro sencillo es suficiente para empezar:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
En este caso, COIN-213 falló en Argon, se escaló y superó la revisión en Carbon. La tarea costó 1,29 $ en total, y esa fila indica con claridad si las tareas similares deberían iniciarse directamente en Carbon la próxima vez.
Gestiona el enrutamiento por tarea en un tablero
La regla es fácil de formular, pero difícil de aplicar cuando cada desarrollador elige el modelo por su cuenta en su terminal. Centraliza el enrutamiento donde residen las tareas.
Asigna un modelo fijo a cada agente
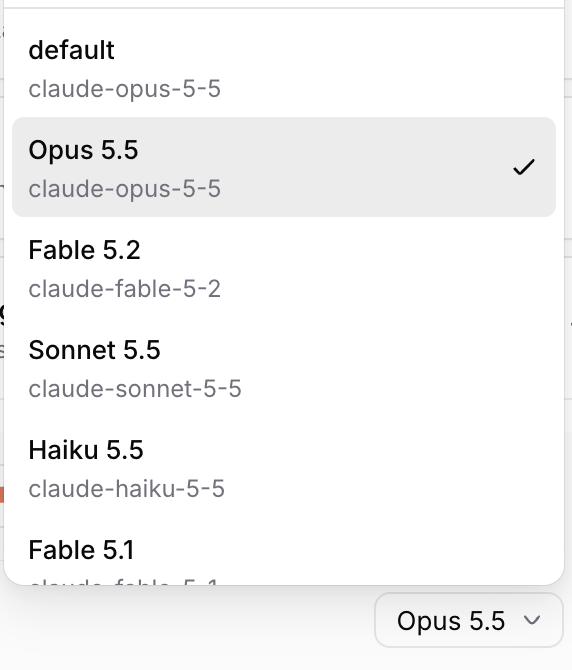
En Sharkly, los agentes adoptan de forma predeterminada el modelo de su Runtime, pero la opción Model en los ajustes del agente permite elegir cualquier otro del catálogo de ese Runtime, así como la profundidad de razonamiento (thinking depth) si el modelo la ofrece. La documentación sobre agentes lo detalla. De este modo dispones de un agente por nivel: uno predeterminado con el modelo rápido y otro de escalado con el modelo avanzado.
Escala una ejecución puntual
Al asignar una tarea, puedes elegir un modelo específico para esa ejecución puntual, anulando la configuración por defecto del agente solo para ese caso. Así se aplica el escalado por fallo en un único paso: el revisor devuelve la tarea y la nueva ejecución se lanza en Carbon sin modificar el agente que utiliza el resto del equipo.
Centraliza el registro en un único lugar
Cada ejecución conserva su registro de actividad, de modo que la tabla de costes y tasas de aprobación se obtiene a partir de tareas completadas reales y no de estimaciones de memoria. Si utilizas Crews que dividen el trabajo por roles en vez de por dificultad, consulta enrutamiento de modelos para Crews de agentes. En cuanto a la supervisión, el artículo quién frena a tus agentes aborda los mecanismos de control que permanecen en manos de tu equipo. Puedes empezar a usar Sharkly gratis.
Alternativas al enrutamiento por tarea
- Un único modelo para todo. Válido para desarrolladores individuales, pero ineficiente y costoso en cuanto la complejidad de las tareas varía.
- Un modelo enrutador automático. Un modelo ligero clasifica cada prompt y selecciona el destino. Esto oculta la toma de decisiones y es incapaz de anticipar un fallo en la revisión.
- Modos de equipo de agentes. La vista previa de /swarm de Google en Antigravity asigna a Carbon la planificación y auditoría mientras modelos más ligeros trabajan en paralelo. Se trata de un enrutamiento por roles dentro de un mismo trabajo, un complemento ideal al enrutamiento por tarea.
Conclusión
Google ya proporcionó la regla de enrutamiento en su propio anuncio de lanzamiento: Argon por defecto y Carbon cuando la tarea lo justifique. Define tus cuatro señales de complejidad, empieza todo lo demás con el modelo económico, escala tras una revisión fallida y registra el coste y la tasa de aprobación por tarea. En dos semanas, tus propios datos reescribirán la tabla con mucha mayor precisión que cualquier benchmark.
Siguiente paso: configura dos agentes en Sharkly, uno con tu modelo predeterminado y otro con el de escalado, y enruta las tareas de esta semana a través de ellos.
Preguntas frecuentes
¿Debería usar Gemini 4 Carbon o Argon para agentes de programación?
Utiliza Argon para la mayoría de las tareas y reserva Carbon para las más complejas. La publicación de GA de Google señala que Argon «sigue siendo la opción ideal para la mayor parte de la ingeniería de software» y que Carbon está destinado a tareas que desafían los límites del modelo.
¿Es Gemini 4 Carbon más caro que Argon?
Por token, no: ambos cuestan 2 $ de entrada y 10 $ de salida por millón de tokens hasta el 30 de noviembre de 2026. Por tarea, por lo general sí, ya que Google indica que Carbon consume más tokens para explorar y verificar.
¿Qué ocurrirá con el precio de Gemini 4 Carbon después del 30 de noviembre?
La nota a pie de página de Google especifica que el precio introductorio finaliza el 30 de noviembre de 2026, momento en el que Carbon pasará a costar 4 $ por millón de tokens de entrada y 20 $ por millón de tokens de salida.
¿Qué es el enrutamiento de modelos para agentes de IA?
El enrutamiento de modelos consiste en seleccionar el modelo adecuado para cada tarea según su nivel de dificultad, con el objetivo de lograr el menor coste por cambio aceptado.
¿Cómo saber cuándo escalar una tarea a un modelo más potente?
Escala cuando la tarea tenga un horizonte largo, abarque muchos archivos, afecte a código crítico de seguridad o ya haya fallado la revisión con el modelo predeterminado.
¿Puedo configurar un modelo diferente para cada agente en Sharkly?
Sí. Cada agente cuenta con una opción de Model en su configuración para elegirlo del catálogo de su Runtime, y además puedes anular dicho modelo para una ejecución concreta al asignar la tarea.


