
La mayoría de los equipos que ejecutan varios agentes de programación acaban fijando en algún momento un techo mensual para el gasto en modelos, normalmente después de una mala semana. Se elige una cifra, se limita la concurrencia hasta que la factura se mantiene por debajo y se revisa al trimestre siguiente. El 22/09/2026, esa cifra dejó de significar lo que significaba, casi sin que nadie se diera cuenta.
OpenAI lanzó GPT-6 Sol a 2 $ por millón de tokens de entrada y 10 $ por millón de salida, con el id de API gpt-6-sol, y publicó algo más útil que una tarifa por token: el coste por tarea. En AutomationBench 1.0.6, Sol con esfuerzo de razonamiento extra alto obtiene un 33,2 % a 0,27 $ por tarea. Claude Opus 5 con esfuerzo máximo obtiene un 26,9 % a 11,1 veces el coste por tarea de Sol en el mismo harness.
Así que calcula qué compra tu límite ahora mismo, antes de subirlo. La respuesta para la mayoría de los equipos es que ya compra más ejecuciones terminadas de las que nadie es capaz de leer. Lo cual significa que el límite nunca estaba protegiendo el presupuesto. Estaba protegiendo a tus revisores, por accidente, y está a punto de dejar de hacerlo.
TL;DR
El coste por cambio aceptado es lo que tu equipo gasta en inferencia de modelos por cada diff que una persona lee y acepta de verdad, y es la única cifra de coste de agentes que se conecta con el trabajo entregado. A las tarifas publicadas, todo el rendimiento revisable mensual de un equipo con cuatro revisores cuesta aproximadamente 136 $ de GPT-6 Sol. La restricción limitante se ha desplazado de la factura al paso de aceptación, y ningún lanzamiento de modelo toca eso. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, conceden autoridad y aceptan el resultado.
Las cifras que OpenAI publicó de verdad
OpenAI informa de la puntuación junto al coste por tarea, algo inusualmente honesto y mucho más útil que una lista de precios.
| Modelo, con el nivel de esfuerzo que usó OpenAI | AutomationBench 1.0.6 | Coste por tarea |
|---|---|---|
| GPT-6 Sol, extra alto | 33,2 % | 0,27 $ |
| GPT-6 Astra, bajo | 30,3 % | 3,9x Sol |
| Claude Opus 5, máximo | 26,9 % | 11,1x Sol |
| Fable 5.1 con fallback a Opus 5, máximo | 31,4 % | más de 8,9x Sol |
El propio resumen de OpenAI sobre la primera y la tercera fila: Sol en extra alto supera a Opus 5 al máximo por alrededor del 9 % del coste por tarea de Opus 5. El mismo patrón aparece en otros puntos de su publicación. En Agents’ Last Exam V1, Sol al máximo obtiene un 56,4 %, por encima del mejor resultado de Opus 5, con un coste por tarea un 60 % menor. En DeepSWE 1.1, Sol al máximo obtiene un 68,8 %, a 1,1 puntos porcentuales de Fable 5 en extra alto (69,9 %), y alrededor de un 80 % más barato por tarea.
Hay dos matices que acompañan a esas cifras y que rara vez viajan con ellas. El titular de OpenAI es que Sol y Luna son cada uno un 50 % más baratos que el precio promocional de GPT-5.6, y “promocional” es palabra de OpenAI: la comparación se hace contra una tarifa con descuento. Y OpenAI hizo el benchmark contra Claude Opus 5, porque Claude Opus 5.5 salió unas horas después a 4 $ y 20 $ por millón, frente a los 5 $ y 25 $ de Opus 5. La columna de Opus 5 es la última comparación publicada, no la actual.
Convertir un presupuesto en ejecuciones
Multiplica 0,27 $ por 11,1 y Opus 5 al máximo se sitúa cerca de 3,00 $ por tarea en ese harness. Esa aritmética es nuestra, a partir de las dos cifras de OpenAI. Divide un límite mensual entre cada una de ellas y obtienes la tabla que cambia cómo se lee ese límite.
| Presupuesto mensual de modelos | Tareas con Sol, extra alto | Tareas con Astra, bajo | Tareas con Opus 5, máximo |
|---|---|---|---|
| 250 $ | unas 925 | unas 240 | unas 83 |
| 1.000 $ | unas 3.700 | unas 950 | unas 330 |
| 5.000 $ | unas 18.500 | unas 4.750 | unas 1.660 |
El coste por tarea de un benchmark no es tu coste por tarea. Las tareas de AutomationBench tienen forma de benchmark: acotadas, cortas y nada parecidas a un ticket real en un repositorio con años de historia. Tus propias tareas pueden consumir diez o cien veces más tokens. Lo que viaja entre el benchmark y tu repositorio es la proporción entre modelos, no el importe absoluto en dólares. Trata la tabla como la forma del cambio, y después mide tu propio coste por ejecución entre agentes y reescala.
Hay una segunda corrección, y va en sentido contrario. El coste por tarea es por intento, no por éxito. Con el 33,2 % del propio benchmark, aproximadamente dos de cada tres intentos no llegan a buen puerto, así que Sol cuesta unos 0,81 $ por éxito en el benchmark y Opus 5 al máximo unos 11,15 $. De nuevo es cálculo nuestro, y aproximado, porque una tasa de aprobados de un benchmark no es la tasa de aceptación de tu equipo. Lo que importa es la dirección: el coste de intentarlo dos veces ahora es tan bajo que la estrategia de reintentos es una decisión de diseño y no una decisión de presupuesto.
Dónde está ahora el techo
Pongamos el lado de la revisión en la misma página. Un revisor que lee bien un diff, entiende qué eligió el agente y asume la responsabilidad del resultado saca adelante cierto número de cambios en una jornada de trabajo. Digamos seis, y ajústalo a tu equipo.
| Revisores | Cambios aceptados al mes | Coste con Sol a 0,27 $ | Coste con Opus 5 al máximo a 3,00 $ |
|---|---|---|---|
| 1 | unos 126 | 34 $ | 378 $ |
| 2 | unos 252 | 68 $ | 756 $ |
| 4 | unos 504 | 136 $ | 1.512 $ |
| 8 | unos 1.008 | 272 $ | 3.024 $ |
Seis cambios aceptados por revisor y día durante 21 días laborables: ese es nuestro supuesto y nuestra aritmética. Mete tus propias cifras y la conclusión se mantiene: todo lo que un equipo de ingeniería normal puede aceptar de verdad en un mes cuesta unos cientos de dólares de inferencia, incluso en el extremo caro. Un límite de 1.000 $ en un equipo de cuatro personas no es una restricción. Es alrededor de siete veces más producción de agentes de la que el equipo puede absorber.
Eso es lo esencial del recorte de precios para un equipo que revisa su trabajo. No aumentó tu producción. Eliminó la última excusa para que la cola fuera corta y dejó a la vista un cuello de botella que siempre fue el paso de revisión humana.
El gasto interno de OpenAI es el contraejemplo útil, no una contradicción. Su investigador mediano ejecuta más de 600 $ al día de inferencia de agentes de programación a precios de API, y el percentil 90 ejecuta 7.000 $ al día. Son cifras reales y empequeñecen la tabla anterior, porque ese trabajo tiene otra forma: un abanico enorme, puntuación automatizada y ningún paso en el que una persona con nombre y apellidos acepte cada resultado en una rama de producción. Si tu proceso tiene ese paso, tu factura de modelos seguirá siendo pequeña y tu cola no.
En qué gastar el margen disponible
Cuando el presupuesto ya no es limitante, la pregunta deja de ser cuántas ejecuciones comprar y pasa a ser en qué gastar la diferencia. Hay dos respuestas que reducen el trabajo que llega al revisor en lugar de aumentarlo.
Compra esfuerzo, no volumen. El esfuerzo de razonamiento es un dial de coste, y la propia tabla de OpenAI usa niveles distintos para benchmarks distintos. La cifra de 0,27 $ es la fila de extra alto, así que el sobrecoste de una ejecución más cuidadosa ya está dentro de un número que es el 9 % de la alternativa. Pagarlo con el mismo número de tareas cuesta casi nada y produce diffs que se tardan menos en revisar.
Compra caché, no tokens. GPT-6 aplica un 90 % de descuento a las lecturas de entrada en caché, mantiene por defecto tasas de acierto más altas y ya no invalida la caché cuando cambias el esfuerzo de razonamiento o la disponibilidad de herramientas. Los puntos de corte explícitos te permiten decidir dónde termina un prefijo en caché. OpenAI menciona que GitHub ve más de un 50 % menos de tokens de prompt que necesitan procesarse desde cero en miles de millones de peticiones. Para un Crew, esta es la diferencia entre el primer agente en un repositorio y el décimo: reenvían casi el mismo prefijo de estructura, reglas internas y convenciones, y ese prefijo es exactamente para lo que sirve una caché. El coste en tokens del contexto del repositorio es donde vive de verdad la factura de una flota.
El par de decisiones honesto: sube el número de ejecuciones concurrentes cuando las ejecuciones extra confluyen en un único resultado que una persona acepta, como tres intentos de una misma migración en los que una suite de tests elige al ganador. No lo subas cuando cada ejecución produce su propio diff, su propio resumen y su propia decisión de aceptación, por baratas que se hayan vuelto las ejecuciones. En el segundo caso, la factura es lo único que ha escalado bien.
Haz que el nuevo techo se pueda contar
El presupuesto era un mal indicador de la capacidad, pero tenía una virtud: era un número que alguien vigilaba. Sustitúyelo por el número que ahora es limitante, que son las ejecuciones completadas esperando a una persona.
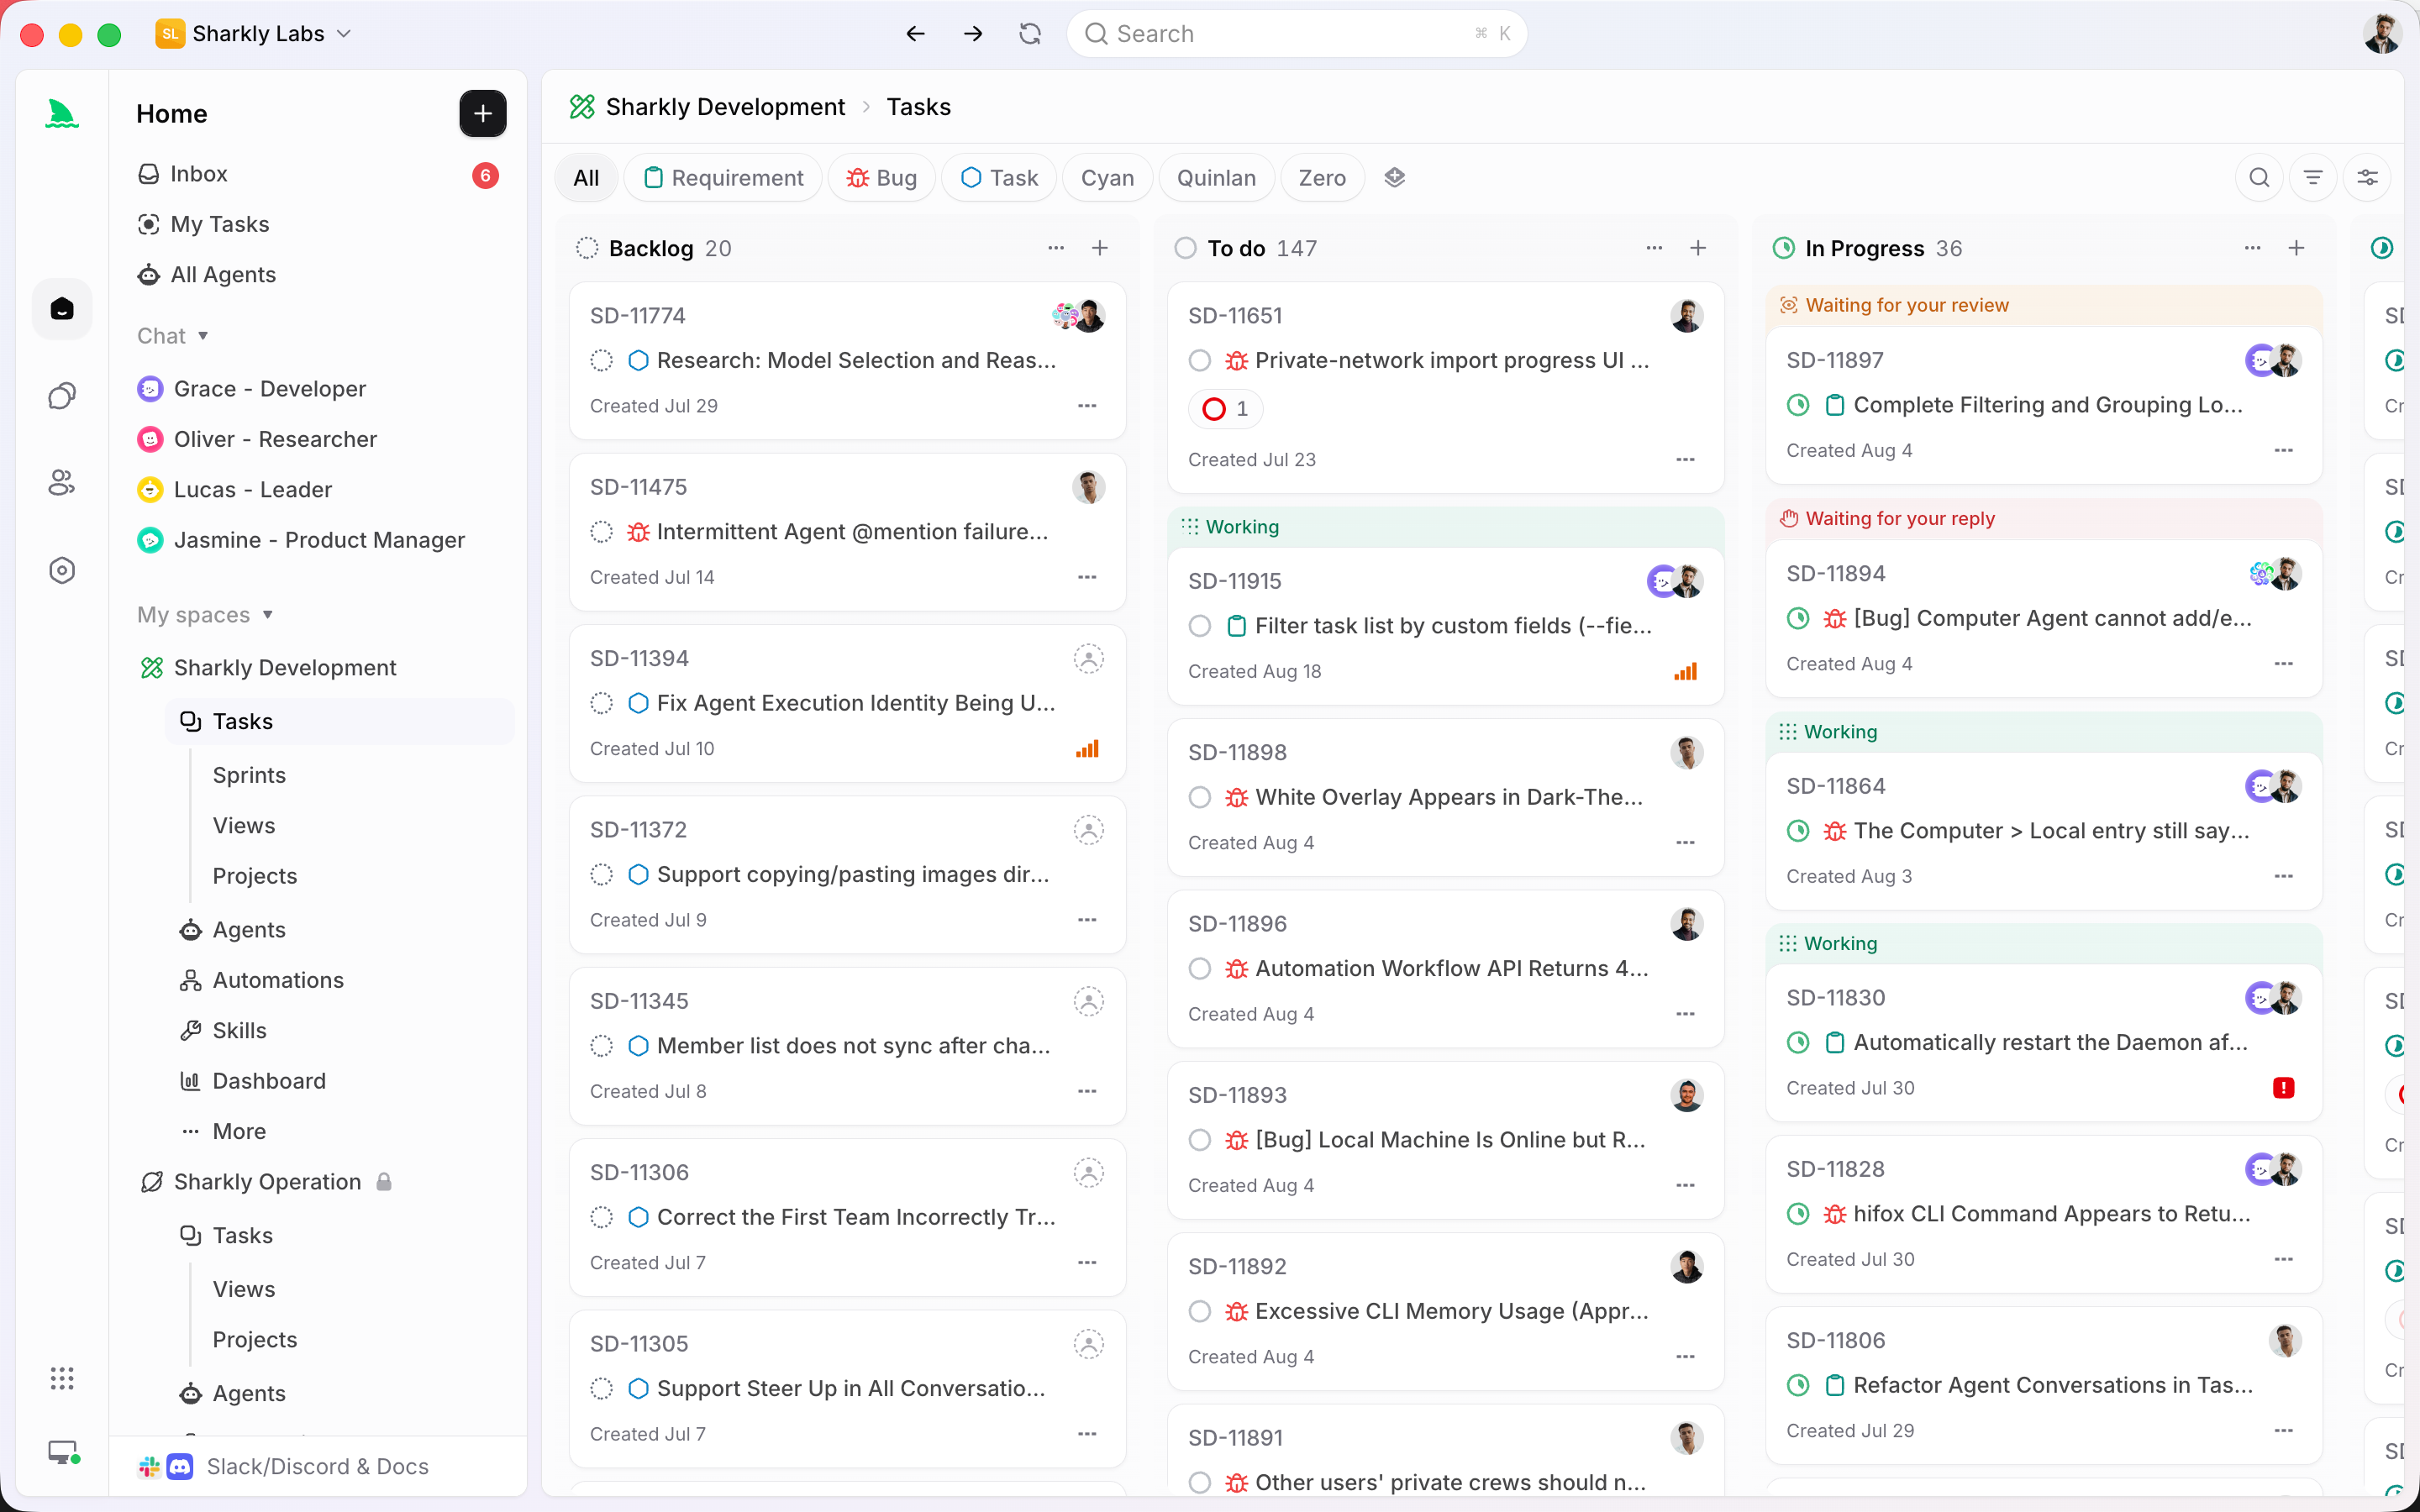
Eso solo es medible si las ejecuciones dejan de vivir en terminales privadas. Sharkly no sustituye a Codex, Claude Code ni a las demás herramientas que ejecutan estos modelos. Es la capa que las rodea, donde el contexto, el progreso, los bloqueos, los resultados y la revisión humana permanecen visibles desde la petición hasta el lanzamiento. La ejecución y los bloqueos vuelven a la Task, de modo que “esperando a una persona” se convierte en un estado que puedes contar en un tablero, en lugar de una sensación que te llega un viernes por la tarde. La aritmética de la capacidad de revisión solo funciona si puedes ver la cola.
Si ya ejecutas varios agentes de programación, el movimiento de esta semana no es subir el límite. Es averiguar cuántas ejecuciones terminadas acepta tu equipo en una semana normal, fijar la concurrencia en función de eso y gastar el presupuesto sobrante en ejecuciones que resulten más fáciles de aceptar.


