
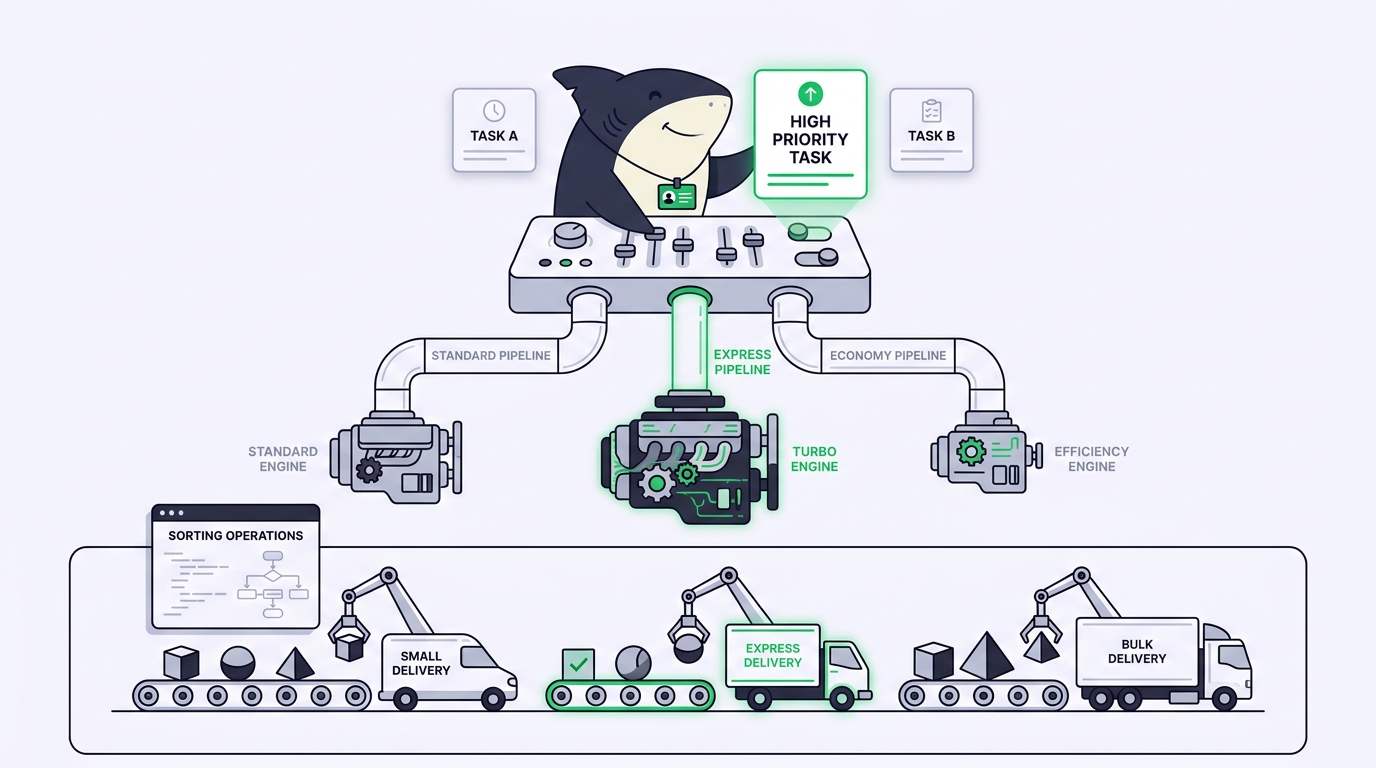
TL;DR: Deja de empeñarte en encontrar el único modelo que sea el mejor. Ajusta cada modelo a la forma de la tarea que tengas delante: razonamiento profundo para arquitectura y refactorizaciones que tocan varios archivos, rapidez y bajo coste para código repetitivo y pruebas, contexto largo para preguntas sobre todo el repositorio, y un uso constante de herramientas para ediciones de varios pasos. Elegir el modelo terminal por terminal funciona con uno o dos agentes. Cuando ya ejecutas varias tareas en distintos repositorios, esa correspondencia debe vivir en un Agente guardado, no en tu cabeza. Aquí tienes el mapa, un ejemplo práctico y una lista de comprobación que puedes aplicar hoy mismo.
Tienes cinco terminales abiertas. En una hay un refactor enrevesado, otra necesita un lote de pruebas unitarias, otra responde preguntas sobre un código que recuerdas a medias, otra persigue una prueba de integración inestable y otra renombra un símbolo en cuarenta archivos. Cada una te plantea la misma pregunta silenciosa: ¿qué modelo debería encargarse de esto? Lanza un modelo de razonamiento pesado al renombrado y quemarás tokens y minutos en un trabajo que cualquier modelo rápido termina sin manchar nada. Lanza un modelo rápido al cambio de arquitectura y se le escapará una dependencia que está tres archivos más allá. La queja recurrente casi nunca es “los modelos son malos”. Es “no sé cuál usar”.
La solución no es una tabla de clasificación. Las posiciones cambian cada pocas semanas y el ganador de un benchmark general suele ser la elección equivocada para tu tarea concreta. Lo que perdura es ajustar el modelo a la forma de la tarea: cuánto razonamiento necesita, cuánto contexto debe manejar, con qué fiabilidad tiene que seguir instrucciones de herramientas y cuánto vas a gastar en cada ejecución. Esas propiedades apenas se mueven, aunque los nombres de los modelos sí lo hagan.
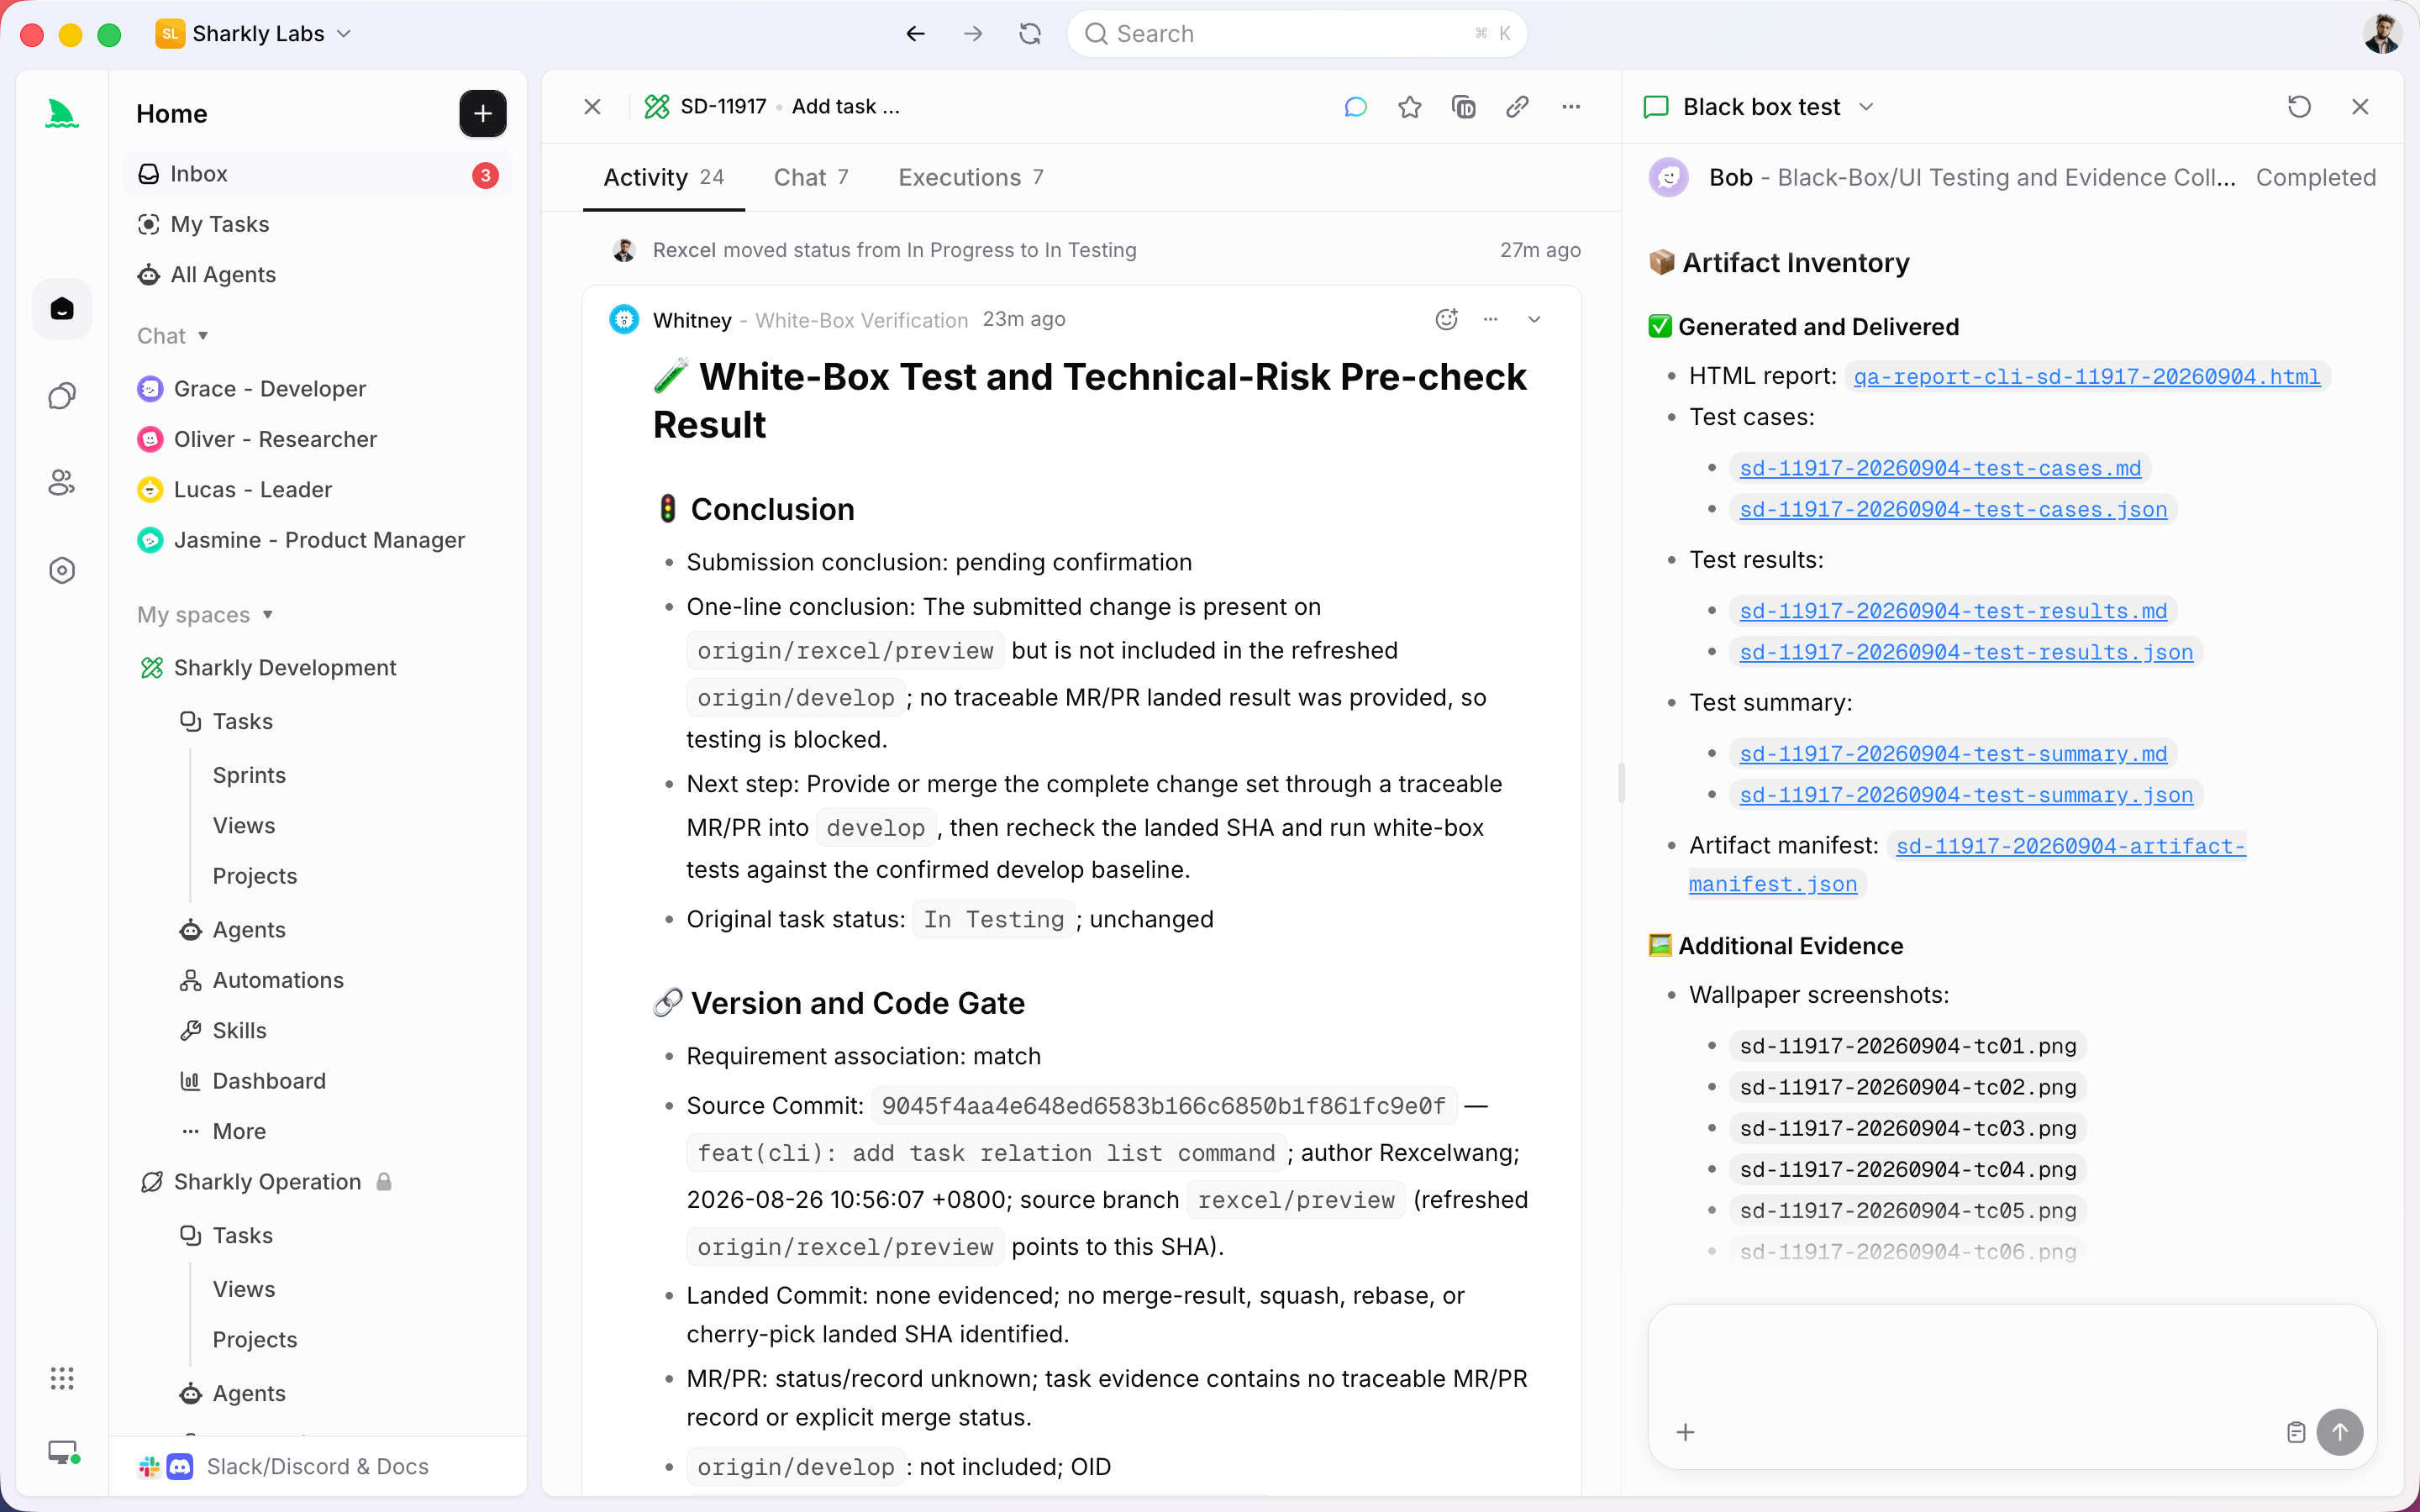
Aquí es donde una capa de tareas se gana su sitio. Sharkly es una plataforma todo en uno para dirigir y gestionar Agentes. Se sitúa por encima de tus agentes de programación, de modo que “qué modelo para qué tarea” deja de ser una decisión que vuelves a tomar en cada terminal. Guardas la decisión una sola vez como un Agente —una configuración reutilizable de un rol, un entorno de ejecución y sus reglas— y luego asignas la Tarea al Agente cuya forma encaje. Ya tienes agentes de programación. Sharkly los convierte en un equipo.
Ajusta el modelo a la forma de la tarea, no a la tabla de clasificación
Elegir un modelo se reduce en realidad a cuatro preguntas, planteadas en orden.
- Profundidad de razonamiento. ¿La tarea exige planificación de varios pasos entre archivos o es un cambio local y mecánico? La arquitectura, los refactors delicados y la depuración de causas raíz se benefician de un modelo de razonamiento más potente. Los renombrados, el formateo y el scaffolding, no.
- Tamaño del contexto. ¿El modelo necesita manejar de una vez todo un repositorio, una especificación larga o un log gigantesco? Las preguntas sobre todo el código base y las migraciones grandes se benefician de un modelo de contexto largo, aunque razone un poco menos.
- Fiabilidad en el uso de herramientas. El trabajo de varios pasos (editar, ejecutar pruebas, leer la salida, editar de nuevo) depende de lo constante que sea el modelo al usar herramientas sin salirse del guion. Un modelo que razona de maravilla pero se olvida de ejecutar la prueba es peor aquí que uno más constante.
- Velocidad y coste. El trabajo de gran volumen y bajo riesgo (pruebas, código repetitivo, docstrings) debería ir al modelo más rápido y barato que supere el listón. Reserva el razonamiento caro para las tareas que de verdad lo necesitan.
Usa un modelo de razonamiento pesado cuando un paso en falso te cueste una tarde de depuración. Usa un modelo rápido y barato cuando la tarea sea mecánica y fácil de verificar. La mayoría de los días necesitas ambos, en tareas distintas y al mismo tiempo. Por eso una única configuración global de modelo resulta equivocada: obliga a dar una sola respuesta a tareas que piden respuestas diferentes.
Un mapa aproximado del tipo de tarea al rol del modelo
Los nombres de tareas que aparecen a continuación sobreviven a cualquier versión concreta de un modelo. Lee la ficha actual del proveedor antes de asignar un nombre a cada categoría; después, quédate con las categorías.
| Tarea que tienes delante | Optimiza para | Rol del modelo |
|---|---|---|
| Arquitectura, refactor entre archivos, revisión de diseño | Profundidad de razonamiento | Razonador pesado |
| Depuración de causa raíz, caza de pruebas inestables | Razonamiento + herramientas constantes | Razonador pesado |
| Preguntas y respuestas sobre todo el repositorio, migraciones grandes, trabajo con especificaciones largas | Tamaño del contexto | Modelo de contexto largo |
| Pruebas unitarias, código repetitivo, docstrings, scaffolding | Velocidad y coste | Modelo rápido y barato |
| Renombrado mecánico, formateo, edición masiva | Velocidad | Modelo rápido y barato |
| Bucle de agente de varios pasos (editar, probar, repetir) | Fiabilidad en el uso de herramientas | Usuario constante de herramientas |
Dos apuntes honestos. Primero, “pesado” no significa “siempre mejor”. En un renombrado, un modelo de razonamiento profundo es más lento, más caro y no más correcto que uno rápido. Segundo, un entorno de ejecución como Claude Code, Codex o Gemini CLI trae su propio modelo predeterminado, y el uso del modelo sigue dependiendo de las suscripciones o claves de API configuradas en la herramienta, así que tus opciones reales son los modelos que tu equipo ya paga, emparejados con estas categorías. Los benchmarks públicos de tareas como SWE-bench te indican a grandes rasgos en qué nivel se sitúa un modelo, no qué modelo necesita tu tarea exacta.
Dónde deja de escalar la elección de modelo terminal por terminal
Con uno o dos agentes, elegir a mano está bien. Abres una terminal, configuras el modelo y recuerdas qué hay dónde porque solo hay dos. La configuración que funciona hoy es una persona y un par de herramientas.
El problema empieza con el volumen. Ejecuta seis tareas en tres repositorios y la correspondencia entre modelos y tareas pasa a vivir en tu cabeza: cuál terminal es la barata, a qué repositorio le pusiste el razonador el martes pasado, por qué la migración avanza a paso de tortuga (la dejaste con el modelo rápido). Cuando un compañero retoma tu trabajo, la correspondencia no viaja con la tarea: se queda en tu memoria, y los resultados se dispersan entre terminales privadas en lugar de volver a un espacio compartido.
Un Agente es una configuración guardada de cómo debería abordarse un tipo de trabajo: un rol, un entorno de ejecución con su modelo y las reglas que lo acompañan. En lugar de volver a decidir el modelo en cada terminal, creas el Agente una sola vez (“Escritor de Tests” con un modelo rápido, “Refactorizador” con un razonador) y asignas la Tarea al Agente cuya forma encaje. La elección del modelo pasa a ser reutilizable, no un juego de memoria. Los Agentes investigan, ejecutan, prueban e informan; las personas marcan el rumbo y aceptan el resultado. La ejecución, los bloqueos y los resultados vuelven a la Tarea, de modo que el razonamiento que hay detrás de cada elección de modelo es visible desde la solicitud hasta la entrega, y no queda enterrado en el historial de una terminal.
Sharkly no sustituye a Claude Code, Codex ni a las demás herramientas de ejecución. Añade la capa compartida de tareas, contexto y revisión alrededor de los modelos que tu equipo ya utiliza. Si solo ejecutas un agente en una terminal, no lo necesitas. Cuando ya estás ejecutando varios agentes en paralelo, la decisión de qué modelo encaja con qué es justo lo que merece la pena guardar.
Un ejemplo práctico: tres tareas, tres Agentes
Imagina que un sprint deja tres tareas en la cola.
- SH-312: renombrar
UserSessionaAuthSessionen todo el repositorio. Mecánica y fácil de verificar. Envíala a un Agente “Renombrador” con un modelo rápido y barato. Edita, ejecuta el comprobador de tipos y devuelve un diff limpio. Gastar tokens de razonador aquí no aporta nada. - SH-318: el flujo de pago cobra dos veces al reintentar. Depuración de causa raíz entre servicios. Envíala a un Agente “Depurador” con un razonador pesado y un uso constante de herramientas. Necesita planificar, leer logs, formular una hipótesis y comprobarla. Un modelo rápido aquí hace conjeturas y desperdicia un ciclo de revisión.
- SH-324: responder a “¿cómo concilia nuestra facturación con Stripe?” a partir del código base. Pregunta sobre todo el repositorio. Envíala a un Agente “Analista de código base” con un modelo de contexto largo capaz de manejar a la vez los archivos relevantes.
Cada Agente se ejecuta en su propio worktree aislado, así que tres modelos trabajan en tres tareas a la vez sin pisarse entre ellos. Cada resultado vuelve a su Tarea con un resumen de cambios y las evidencias. Revisas tres entregas terminadas, no tres terminales que tienes que reconstruir de memoria. La automatización se detiene donde hace falta tu criterio: aceptas, pides cambios o decides la fusión.
La lista de comprobación que puedes aplicar hoy
Pásala antes de tu próximo lote de trabajo con agentes.
- [ ] Para cada tarea, define primero su forma: con mucho razonamiento, con mucho contexto, con muchos bucles de herramientas o mecánica de gran volumen.
- [ ] Asigna el modelo más barato que supere el listón para esa forma. Reserva el razonador para las tareas en las que un paso en falso cuesta tiempo real.
- [ ] Pon el trabajo de contexto largo en un modelo de contexto largo, no en tu razonador favorito por costumbre.
- [ ] En los bucles de varios pasos, da más peso a la fiabilidad en el uso de herramientas que a la posición bruta en un benchmark.
- [ ] Deja la correspondencia por escrito una sola vez como un Agente reutilizable por rol, para que tú y tus compañeros dejéis de decidirlo en cada terminal.
- [ ] Mantén a una persona en la aceptación final. El modelo elige el camino; tú apruebas el resultado.
Ajusta el modelo a la tarea, guarda ese ajuste como un Agente y la pregunta con la que empezaba todo (“¿cuál uso?”) se responderá una sola vez por rol en lugar de una vez por terminal.
Si quieres seguir usando varios agentes de programación en lugar de comprometerte con un único modelo para todo, ese es el problema en torno al cual está construido Sharkly. Puedes elegir el modelo a mano en cada terminal o gestionar todo el flujo de trabajo en un solo sitio y dejar que cada resultado vuelva a la Tarea.
Preguntas frecuentes
¿Debería usar simplemente el modelo mejor clasificado para todo? No. El mejor modelo general es más lento y más caro de lo necesario en trabajo mecánico, y en ese terreno no es más correcto. La clasificación te dice en qué nivel se sitúa un modelo; la forma de tu tarea te dice qué nivel necesitas. Hacer coincidir ambas cosas es mejor que quedarte por defecto con el ganador de la tabla.
¿Cómo elijo un modelo cuando todavía no sé la dificultad de la tarea? Empieza barato y ve subiendo. Dale la tarea primero a un modelo rápido. Si se atasca, hace conjeturas o no pasa la revisión, esa es la señal de que la tarea exige mucho razonamiento, y entonces la promocionas a un modelo más potente. El paso de revisión con intervención humana es donde detectas el desajuste antes de que llegue a producción.
¿Sharkly elige el modelo por mí? Sharkly no elige el modelo por su cuenta. Tú vinculas un rol a un entorno de ejecución y su modelo cuando creas un Agente, y luego asignas Tareas al Agente cuya forma encaje con el trabajo. La elección sigue siendo tuya; Sharkly la hace reutilizable y mantiene el resultado de cada ejecución en la Tarea en lugar de en una terminal privada.


