
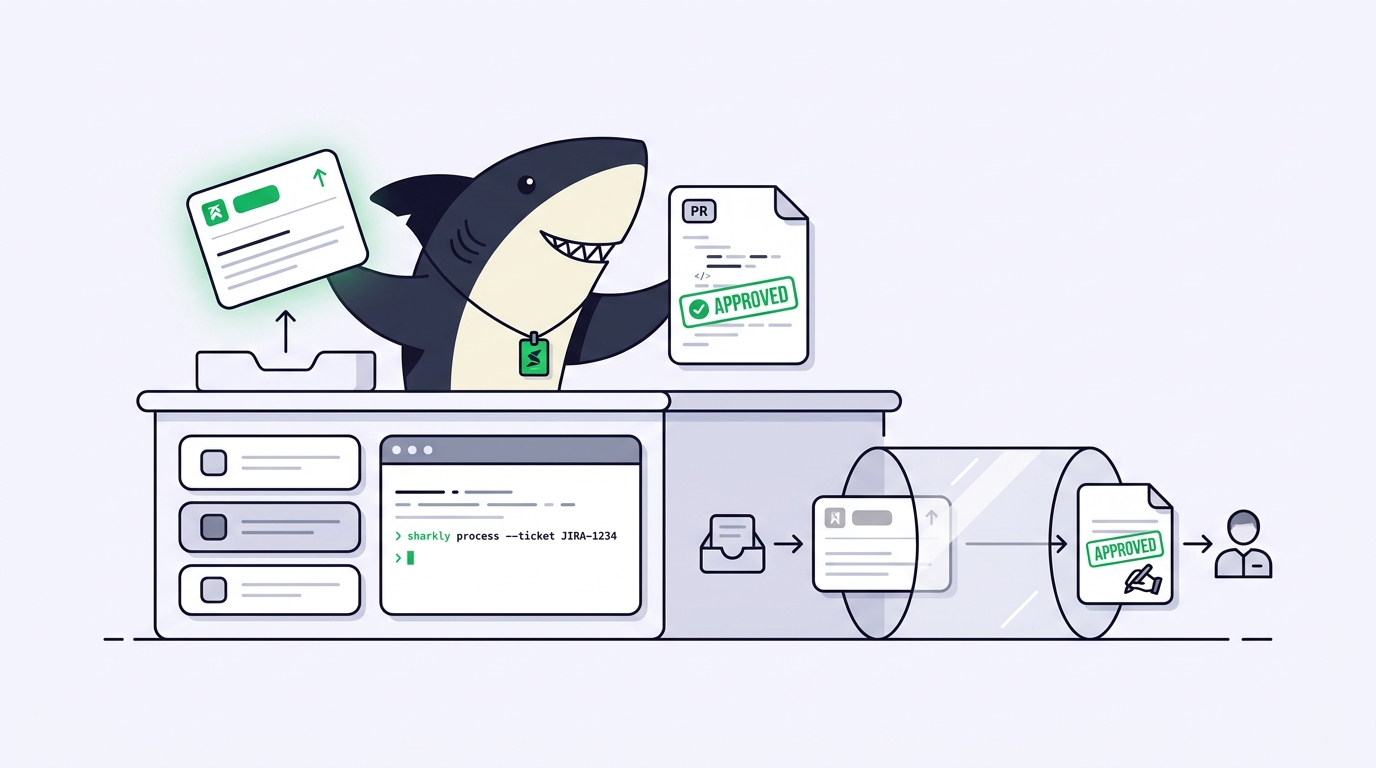
Le ticket est déjà rédigé. Il a un titre, une description, des critères d’acceptation et une place dans le sprint. La seule chose qui le sépare d’un diff, c’est une personne qui ouvre un terminal, colle le ticket dans un agent de codage, surveille l’exécution, puis recopie le résultat à la main dans Jira. Le travail et sa trace vivent dans deux fenêtres différentes, et les garder synchronisées occupe tout un après-midi.
Assigner un ticket Jira à un agent IA, c’est combler cet écart : le ticket devient une unité de travail qu’un agent peut prendre en charge, exécuter sur votre dépôt et restituer sous forme de modification vérifiable, sans quitter l’outil de suivi sur lequel votre équipe travaille déjà. Vous ne faites pas migrer l’équipe hors de Jira. Vous ajoutez une couche où le ticket peut réellement être traité.
Cette couche, c’est Sharkly, une plateforme tout-en-un de commande et de gestion d’agents. Elle se connecte à Jira, transforme les tickets en Tasks assignables, les route vers vos agents de codage (Claude Code, Codex, Gemini et autres outils en ligne de commande), exécute chacun en isolation et renvoie le résultat dans la Task. Ce guide parcourt toute la boucle : le ticket entre, l’Agent est assigné, le travail se fait dans un worktree isolé, puis la pull request et les échanges reviennent dans l’historique.
La boucle en une phrase
Une Task Sharkly est l’historique partagé d’un travail, et lorsque vous connectez Jira, chaque ticket Jira devient l’une de ces Tasks. À partir de là, le contrat est simple : les Agents font la recherche, exécutent, testent et rendent compte ; les humains donnent la direction, accordent l’autorité et acceptent le résultat. Tout le reste de cet article n’est que la mécanique de cette phrase.
Gardez Jira, ajoutez la couche d’exécution
Sharkly ne remplace pas Jira. Il ajoute la couche de Task partagée, de Computer connecté, d’exécution et de revue autour de l’outil de suivi que votre équipe utilise déjà. Personne n’a besoin d’apprendre un nouveau tableau ni de migrer un backlog pour se lancer.
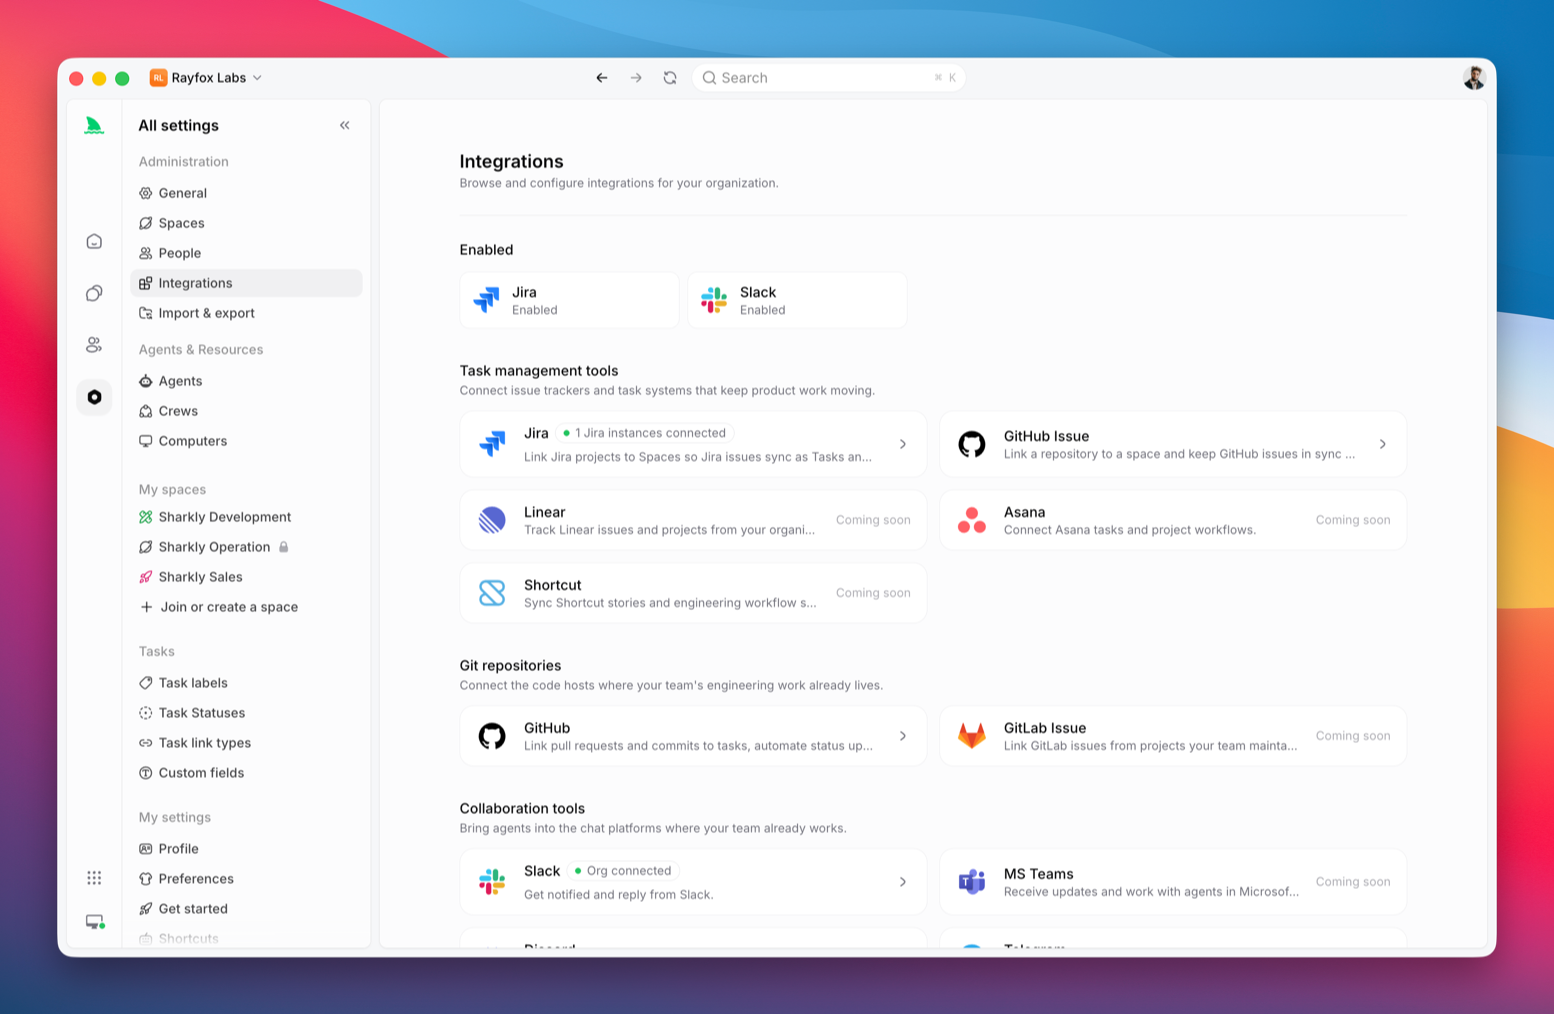
Vous reliez les deux avec un lien de synchronisation. Ouvrez l’intégration Jira, connectez le compte (Jira Cloud utilise votre hôte *.atlassian.net, l’e-mail du compte et un jeton d’API Atlassian ; Server et Data Center utilisent l’URL de base, le nom d’utilisateur et un jeton d’accès personnel), puis associez un projet Jira à un Space Sharkly. Les correspondances principales sont celles que vous imaginez :
- Un ticket Jira devient une Task Sharkly
- Une épopée Jira devient un Projet Sharkly
- Assigné, statut, commentaires et pièces jointes sont transférés
Voici le vrai choix à faire. Utilisez la synchronisation lorsque vous voulez qu’un projet actif reste connecté, afin que les changements circulent entre Jira et Sharkly à partir de maintenant. Utilisez l’import lorsque vous voulez copier des tickets historiques pour une migration maîtrisée ; la synchronisation seule ne récupère pas le passé d’un projet. La plupart des équipes qui débutent se contentent d’un lien de synchronisation bidirectionnel sur un projet actif, et c’est tout. La configuration complète, y compris l’étape de webhook que l’administrateur Jira réalise une seule fois, se trouve dans la documentation Sharkly.
Assignez le ticket à un Agent
Une fois le projet lié, le ticket apparaît comme une Task dans le Space. L’assigner à un Agent fonctionne exactement comme l’assigner à un collègue : vous choisissez l’Agent au lieu d’une personne.
Un Agent, ce n’est pas qu’un choix de modèle. Ses instructions, son Runtime, ses dépôts et ses paramètres d’exécution définissent sa façon de travailler, tout comme une fiche de poste façonne le travail d’une nouvelle recrue. Le Runtime est le moteur sous le capot : Claude Code, Codex ou l’agent en ligne de commande que votre équipe utilise déjà. L’usage des modèles continue de passer par les abonnements ou les clés d’API configurés dans ces outils : votre accès aux agents et votre code restent sur votre propre matériel. Sharkly coordonne l’assignation ; il ne prend pas la garde de vos identifiants.
S’il s’agit de votre première exécution, gardez un périmètre réduit et des limites explicites. Rédiger une tâche qu’un agent peut réellement exécuter est une compétence à part entière, et cela vaut la peine de la maîtriser avant de pointer un Agent sur quoi que ce soit de critique. Un ticket bien cadré, avec une définition claire de ce qui est terminé, produit un diff bien cadré ; un ticket vague produit un diff vague.
L’exécution dans un worktree isolé
Quand l’Agent démarre, l’exécution a lieu sur un Computer connecté, dans son propre worktree isolé. C’est cette isolation qui rend l’opération sûre à répéter. Chaque exécution dispose d’un répertoire de travail neuf : deux Agents qui traitent deux tickets sur le même dépôt n’écrasent jamais les fichiers de l’autre et ne se disputent pas une branche. C’est la même discipline que vous appliqueriez à la main avec les git worktrees pour les agents de codage IA, mais prise en charge pour vous et reproductible sur chaque Task.
C’est aussi ce qui permet au flux de dépasser le stade d’un seul ticket. Dès que l’isolation est automatique, faire tourner plusieurs agents en parallèle cesse d’être un numéro de jonglage, car ce qui casse d’ordinaire (l’état partagé sur le disque) est éliminé par conception. Si tout ce modèle est nouveau pour vous, assigner votre première tâche à un agent IA est une rampe d’accès plus douce avant de brancher Jira.
Ramenez la PR dans l’historique
Le travail de l’Agent revient dans la Task : la conversation, les journaux d’exécution, les blocages et la modification obtenue atterrissent tous au même endroit au lieu de se disperser entre un terminal et un fil de discussion. Quand l’Agent ouvre une pull request, vous la reliez à la Task en inscrivant l’ID de la Task dans le nom de la branche, le titre de la PR ou le corps de la PR. L’intégration GitHub de Sharkly repère cet ID, associe la pull request à la Task et peut laisser un commentaire de renvoi pour que quiconque suit le ticket puisse accéder directement au code.
Comme le lien de synchronisation Jira est bidirectionnel, cette activité remonte aussi vers le ticket d’origine. La personne qui a créé le ticket voit le travail avancer sans ouvrir le moindre terminal. C’est le bénéfice de faire passer le travail par une Task partagée plutôt que par un prompt privé : contexte, avancement, blocages, résultats et revue restent visibles de la demande à la mise en production.
La limite assumée : c’est un humain qui accepte
Rien ne fusionne tout seul. C’est délibéré, et il vaut la peine de le dire clairement car un lecteur pourrait penser le contraire : fusionner une pull request ne change pas le statut de la Task, et cela ne se produit jamais automatiquement. L’automatisation s’arrête là où le jugement de l’équipe est nécessaire.
La répartition des rôles tient jusqu’au bout. L’Agent exécute le travail, ouvre la PR et rend compte de ce qu’il a fait, de ce qu’il a vérifié et de ce qui lui laisse un doute. Une personne lit le diff au regard des critères d’acceptation d’origine, demande des modifications ou accepte, et prend la décision de fusion et de mise en production. Un agent comblera volontiers le silence par sa propre initiative : l’étape de revue n’est donc pas une formalité, c’est le garde-fou qui rend la partie automatique digne de confiance. Les décisions finales d’acceptation et de mise en production restent aux mains des humains.
Voilà la boucle complète. Un ticket Jira entre, un Agent le prend en charge, le travail s’exécute en isolation et revient dans l’historique sous forme de pull request que vous pouvez lire, et c’est vous qui décidez si elle part en production. Pour une vision plus large de la façon dont cela s’applique à une équipe d’agents plutôt qu’à une seule exécution, voyez ce que signifie l’orchestration d’agents IA pour les équipes de dev, ou la présentation de Sharkly pour l’ensemble de la plateforme.
Pour l’essayer sur un vrai ticket : téléchargez Sharkly, connectez-vous sur app.sharkly.ai, connectez un Computer et liez un projet Jira à faible risque.
Questions fréquentes
Sharkly remplace-t-il Jira ? Non. Sharkly ajoute la couche d’exécution et de revue autour de Jira. Vos tickets, épopées, statuts et workflows restent là où ils sont ; le lien de synchronisation les maintient connectés pendant que les Agents font avancer le travail.
Quelles versions de Jira sont compatibles ? Les deux. Jira Cloud se connecte avec votre hôte, l’e-mail du compte et un jeton d’API Atlassian. Jira Server et Data Center se connectent avec l’URL de base, le nom d’utilisateur et un jeton d’accès personnel.
Dois-je d’abord migrer mon backlog ? Non. Un lien de synchronisation connecte un projet actif et fait circuler les changements à venir sans importer l’historique. Lancez un import distinct uniquement si vous voulez vraiment copier les tickets passés.
La fusion de la pull request va-t-elle fermer le ticket ? Non. Fusionner une PR ne change pas le statut de la Task, par conception. Une personne accepte le résultat et décide de l’étape de fusion et de mise en production. Voir assigner votre première tâche à un agent IA pour comprendre le fonctionnement de la boucle de revue.
Où résident mon code et mon accès aux modèles ? Sur votre propre matériel. Les Agents s’exécutent sur un Computer que vous connectez, en utilisant les abonnements ou les clés d’API déjà configurés dans vos outils de codage. Sharkly coordonne l’assignation, le contexte et la revue ; il n’héberge ni votre dépôt ni votre quota de modèles.


